








筛选结果
44 篇排序
 25:50EN → 简体中文
 Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 12:14EN → 简体中文Matthew Berman· 2026年10月14日Gemini 4 Argon 实测:3D 演示、电子表格原型与基准成绩Matthew Berman · Forward FutureMatthew Berman 用游戏和视觉项目测试 Google 模型,并比较公布的编程与智能体基准。
 10:36EN → 简体中文Matthew Berman· 2026年10月13日Meta Muse Wonder 实测:基准成绩强劲,演示表现不一,额度限制影响体验Matthew Berman · Forward FutureMatthew Berman 测试 Meta 模型的浏览器演示,并分析公开的基准成绩、使用方式和成本。
 21:29EN → 简体中文Matthew Berman· 2026年10月7日Mistral Large 4 预览版:欧洲开放权重、网络安全基准与设置障碍Matthew Berman · Forward FutureMatthew Berman 回顾模型公布的规格和基准,并在智能体编程工作流中进行测试。
 16:59EN → 简体中文Matthew Berman· 2026年9月29日Claude Sonnet 5.5 实测:游戏、3D 场景与更便宜的 Opus 替代选择Matthew Berman · Forward FutureMatthew Berman 展示生成的项目,并比较 Sonnet 与 Opus 公布的基准成绩和 API 价格。
 31:59EN → 简体中文Matthew Berman· 2026年9月23日Claude Opus 5.5:基准、成本与 Anthropic 对放缓的看法Matthew Berman, Thariq · Forward FutureMatthew Berman 回顾发布内容,并与 Anthropic 的 Thariq 讨论日常工作流、评测和智能体框架。
 16:57EN → 简体中文Matthew Berman· 2026年9月22日Grok 4.7 对比:编程、知识工作与每项任务成本Matthew Berman · Forward FutureMatthew Berman 分析公布的基准和价格,同时指出遗漏的竞争模型及有限的亲自测试。
 16:50EN → 简体中文Matthew Berman· 2026年9月3日Gemini 3.8 Flash:基准、成本与编程实测Matthew Berman · Forward FutureMatthew Berman 结合视觉生成和网页制作实例,评估 Google 2026 年 9 月发布的模型。
 13:09EN → 简体中文Matthew Berman· 2026年8月14日AI 新闻:超高速推理、Claude 水印与新模型Matthew Berman · Forward FutureMatthew Berman 回顾超高速编码预览、文本水印、Grok Bot、开放权重模型和 Computer History。
 12:12EN → 简体中文Matthew Berman· 2026年7月18日Kimi K3:编程基准、成本与开放权重 AI 竞争Matthew Berman · Forward FutureMatthew Berman 考察 Kimi K3 的早期基准成绩、单任务成本和一个魔方模拟器,并讨论这些结果的局限。
 17:03EN → 简体中文Matthew Berman· 2026年5月27日DeepSWE:用长流程软件任务测试编程智能体Matthew Berman · Forward FutureMatthew Berman 解读 Datacurve 的基准、验证器审计,以及使用统一 harness 比较模型的权衡。
 31:22EN → 简体中文Matthew Berman· 2026年5月26日Cursor Composer 2.5 与编程模型的经济账Matthew Berman, Sundar Pichai · Forward FutureMatthew Berman 分析编程基准、模型成本与企业预算,并讨论 Cursor 与 SpaceX 的合作及 Anthropic 的算力需求。
 15:08EN → 简体中文Matthew Berman· 2025年8月8日GPT-5 发布回顾:路由、编程、基准测试与可靠性Matthew Berman · Forward FutureMatthew Berman 回顾 OpenAI 2025 年发布的 GPT-5、统一的 ChatGPT 使用体验、基准测试结果及模型评估的局限。
 1:43:51EN → 简体中文Matthew Berman· 2025年8月8日GPT-5、Cline 与 SWE-bench:如何评判 AI 编码智能体Matthew Berman, Matt Wolfe, Ray Fernando, Saoud Razwan, Nick, Ofir, Carlos, John, Kilian · Forward FutureMatthew Berman 和嘉宾讨论 GPT-5 的初步体验、Cline 的成本与商业模式,以及编程基准结果为何取决于评估设置。
 40:32EN → 简体中文Matthew Berman· 2025年8月7日Mark Chen 谈 GPT-5、合成数据与 AI 研究的未来Matthew Berman, Mark Chen · Forward Future2025 年 8 月,OpenAI 研究负责人接受 Matthew Berman 采访,讨论训练、智能体、开放权重发布与评估。
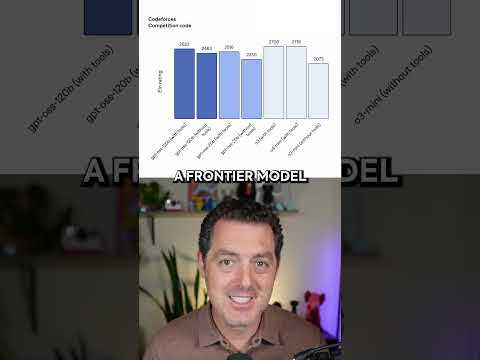 1:01EN → 简体中文Matthew Berman· 2025年8月5日OpenAI 发布 gpt-oss 与一项编程基准Matthew Berman · Forward FutureMatthew Berman 介绍两个开放权重模型,并解读发布时的 Codeforces 比较。
 6:53EN → 简体中文Matthew Berman· 2025年7月24日Qwen3-Coder:开放权重的编程模型及其命令行智能体Matthew Berman · Forward FutureMatthew Berman 介绍 Qwen 在 2025 年 7 月发布的编程模型、训练方法和基准测试结果,并用其命令行工具制作贪吃蛇游戏。
 22:05EN → 简体中文Matthew Berman· 2025年6月9日Apple《思考的幻觉》:谜题实验的局限与代码辅助测试Matthew Berman, Ilya Sutskever · Forward FutureMatthew Berman 回顾 Apple 的推理模型实验,并用生成的代码测试另一种解决汉诺塔问题的方法。
 10:09EN → 简体中文Matthew Berman· 2025年5月30日DeepSeek R1 0528:基准提升与两次编程测试Matthew Berman · Forward FutureMatthew Berman 评析 DeepSeek 在 2025 年 5 月推出的推理模型更新,将公布的基准提升与自己的魔方和贪吃蛇编程测试作比较。
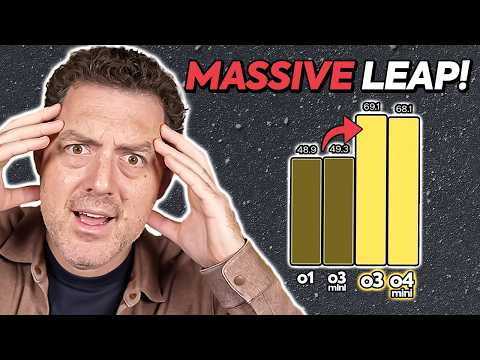 15:46EN → 简体中文Matthew Berman· 2025年4月16日OpenAI o3 与 o4-mini:工具使用、基准测试和首版 Codex CLIMatthew Berman · Forward FutureMatthew Berman 回顾 OpenAI 2025 年 4 月发布的推理模型、科学图像分析演示,以及终端编程智能体的首次亮相。
 21:16EN → 简体中文Matthew Berman· 2025年4月14日GPT-4.1、Mini 与 Nano:编程、长上下文及 2025 年 API 价格Matthew Berman · Forward FutureMatthew Berman 回顾 OpenAI 于 2025 年 4 月发布的模型、部分编程基准与演示,以及 Box 赞助的评估。
 19:32EN → 简体中文Matthew Berman· 2025年2月28日GPT-4.5 发布:对话风格、基准测试与成本Matthew Berman · Forward FutureMatthew Berman 解析 OpenAI 于 2025 年 2 月推出的研究预览版,以及精选演示、公布的评测结果和较高的发布价格。
 9:35EN → 简体中文Matthew Berman· 2025年2月25日Claude 3.7 Sonnet 与 Claude Code:早期编程测试Matthew Berman · Forward FutureMatthew Berman 解读 Anthropic 2025 年发布时的基准,构建由 AI 控制的贪吃蛇游戏,并测试数学和近期信息。
 13:24EN → 简体中文Matthew Berman· 2025年2月18日Grok 3 的 2025 年发布:基准、推理与 DeepSearchMatthew Berman, Elon Musk · Forward FutureMatthew Berman 解读 xAI 的发布图表、历史用户偏好排行榜和早期产品演示。
加载更多已显示 24 篇,共 44 篇