30 秒看懂
Matthew Berman 分析 Anthropic 公布的 Opus 5.5 基准成绩、token 价格、推理强度和安全说法。Anthropic 技术团队成员 Thariq 加入,讨论模型选择、AI 辅助开发、放缓、评测及 Claude Code 框架的变化。
- 1公布的编程成绩Anthropic 表格显示 Terminal-Bench 成绩提高,FrontierCode 和 CursorBench 结果也很强。
- 2价格与任务成本Berman 比较 token 价格,并解释总成本为何取决于用量和推理强度。
- 3AI 帮助构建 AIThariq 将 Claude 的贡献描述为有人参与的许多小改进。
- 4放缓与部署Thariq 区分了未发布前沿能力的工作与广泛提供既有能力。
- 5调整框架Claude Code 团队缩短系统提示,并为较新模型推出插件评测。
要点建议
- Anthropic 报告 Opus 5.5 的编程和知识工作成绩强劲,典型任务成本更低;解读时需要注意评测条件。
- token 单价与每项完成任务的成本不同,更高推理强度并不总能得到更好的基准结果。
- Thariq 将 AI 辅助开发描述为许多逐步累积的贡献,而不是突然实现完全自主的过程。
- 他区分了放缓最新前沿模型与普及既有能力,并表达 Anthropic 对部署的看法。
- 随着模型能力变化,智能体框架、工具和插件也需要调整。
按章节阅读整理后的全文
基准与价格
Berman 回顾 Anthropic 公布的编程、知识工作和计算机操作成绩,比较 token 价格、速度和任务成本。
Claude Opus 5.5 是 Anthropic 呼吁放缓前沿模型推进后发布的首个重大模型。我认为它对编程和知识工作很重要。视频后半段,Anthropic 技术团队成员 Thariq 加入讨论,介绍模型在产品线中的位置,以及配套工具如何变化。
Anthropic 表示,Opus 5.5 在大多数任务上达到 Fable 5.1 的水平,典型工作负载成本低于 Opus 5。Berman 认为其速度、价格和基准表现的组合令人瞩目,尤其是在公司公开讨论放缓前沿发展之后。
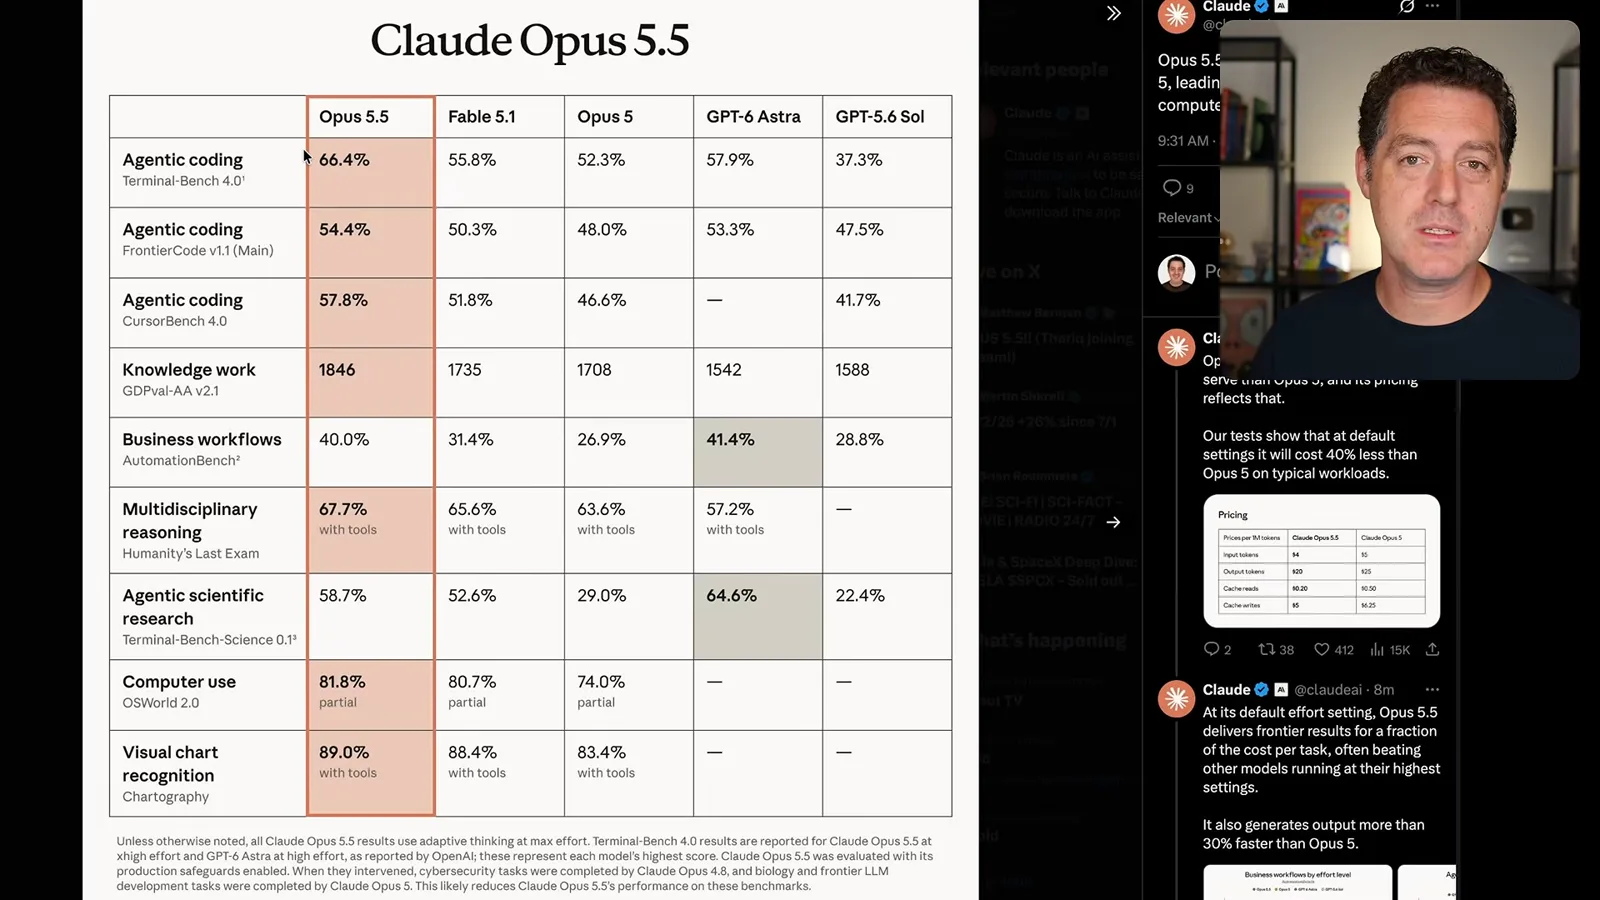
在 Anthropic 的表格中,Opus 5.5 的 Terminal-Bench 4.0 得分为 66.4%,GPT-6 Astra 为 57.9%,Fable 5.1 为 55.8%。它在展示的 FrontierCode 和 CursorBench 比较中也领先。Berman 猜测它可能更小或经过蒸馏,但明确表示自己并不确定。
在知识工作评测 GDPval-AA 上,展示的分数为 1846 Elo,Fable 5.1 为 1735,Astra 为 1542。Berman 强调这一跃升,因为基准涵盖文档、演示文稿和数据工作等任务。这些是公司在特定评测条件下公布的比较。
Opus 并非在表格的每项测试中都领先:Astra 在 AutomationBench 和 Terminal-Bench Science 上得分更高。展示的 OSWorld 部分得分为 81.8%,略高于 Fable 的 80.7%。Berman 说团队越来越多地用计算机控制操作视频编辑器和 Unreal Engine 等创作工具。
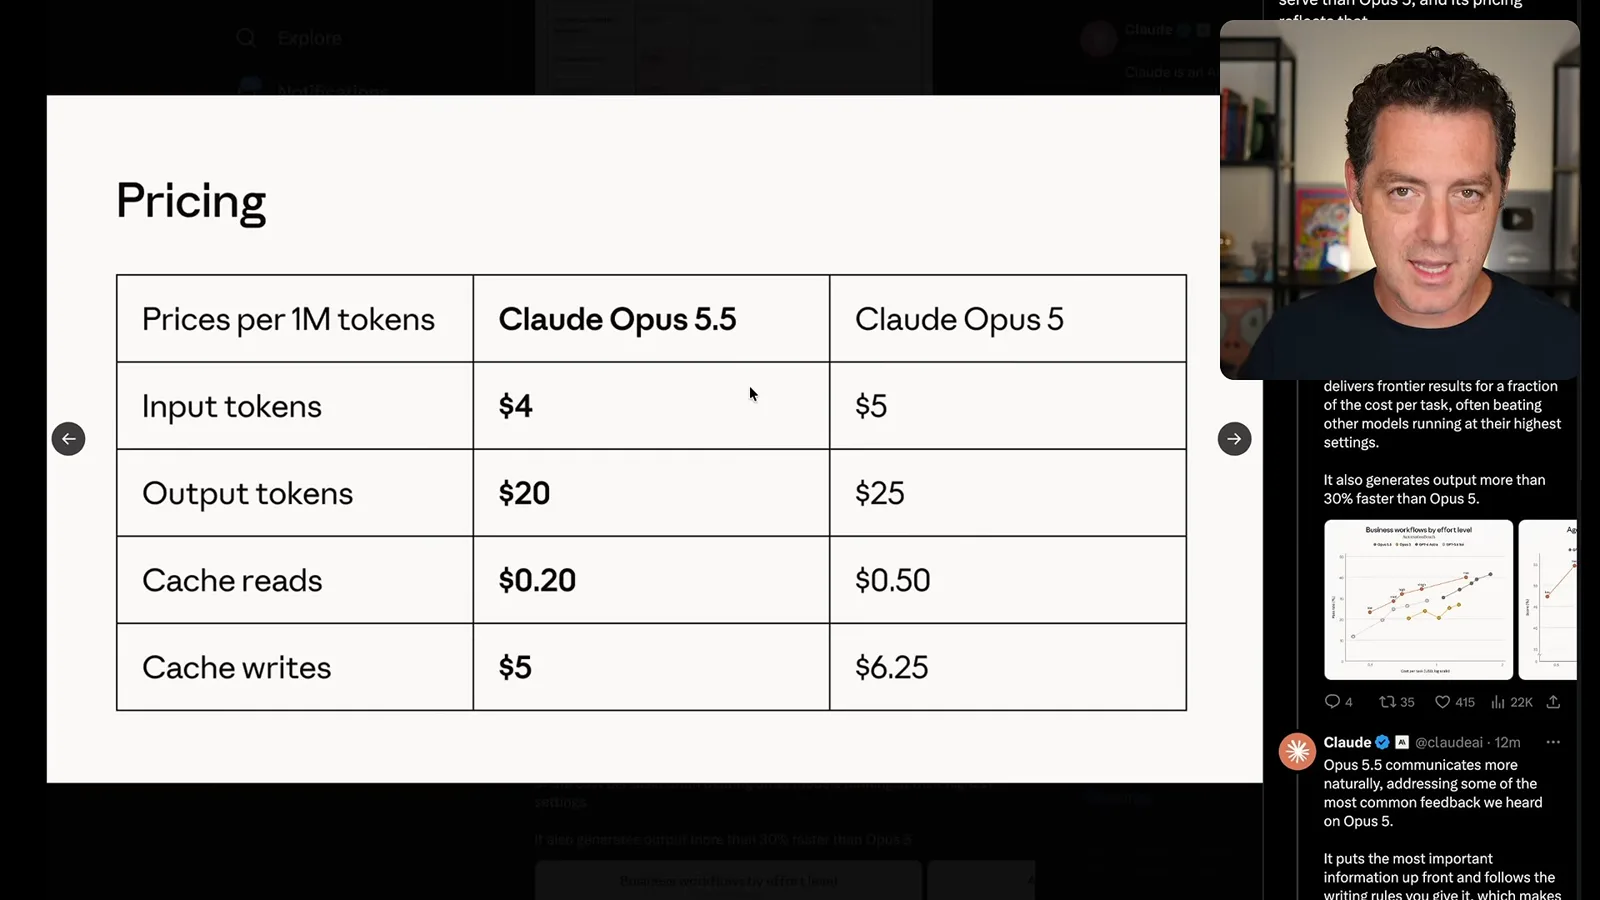
引用的 Opus 5.5 价格为每百万输入 token 4 美元、每百万输出 token 20 美元;Opus 5 分别为 5 美元和 25 美元。缓存读取分别为 0.20 美元和 0.50 美元,缓存写入分别为 5 美元和 6.25 美元。Anthropic 还表示输出速度比上一代快超过 30%。
Berman 认为,仅看 token 单价不够:即使单价低,如果一个模型完成任务要花更多 token,总成本仍可能更高。他研究通过率或质量与每项任务成本的关系,寻找能以更低总成本取得更好结果的设置。
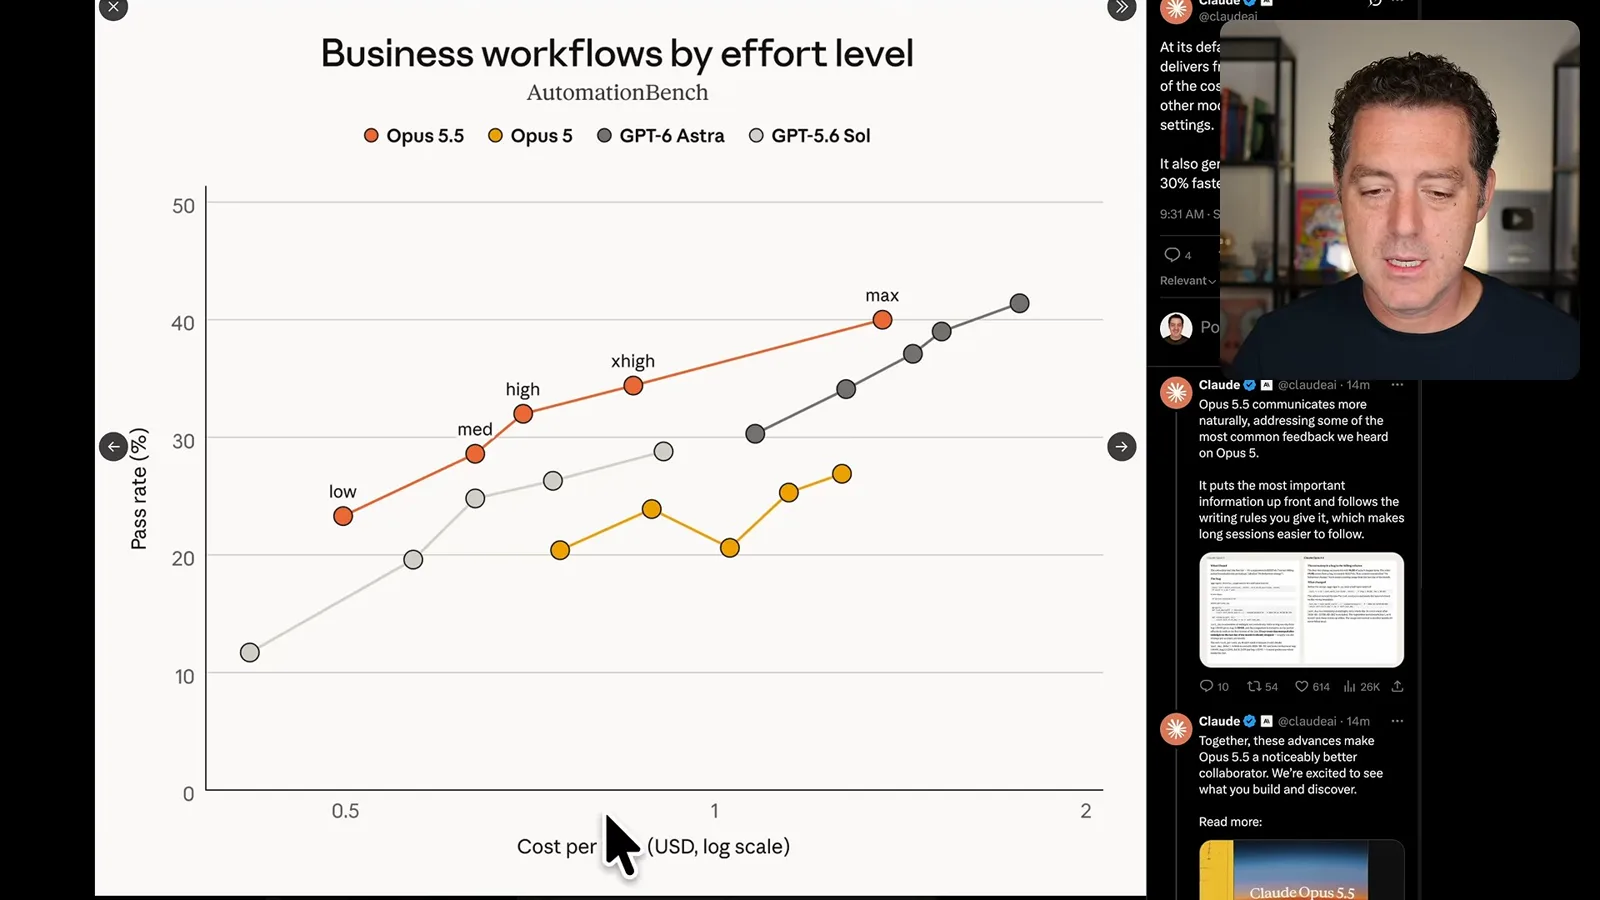
展示的 FrontierCode 图表中,Opus 5.5 的中等推理强度得分高于最高强度,每项任务成本却低得多。Berman 据此认为,更高推理强度并不总是适合每个工作负载。用户应根据自己的任务测试设置。
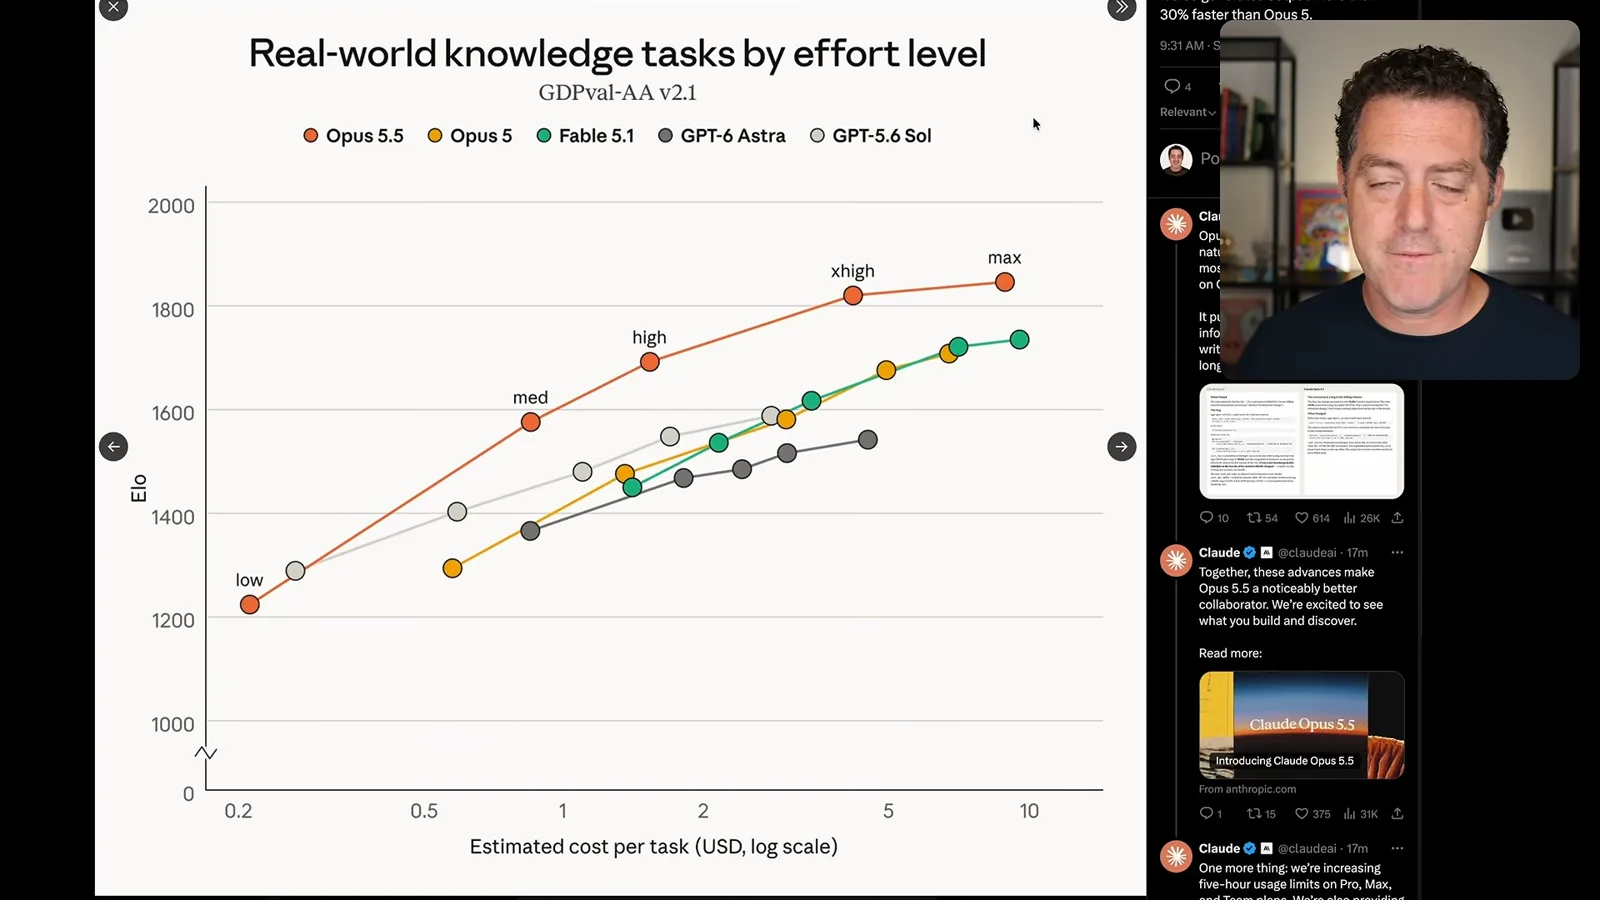
GDPval 和 Terminal-Bench 的成本图也显示 Opus 5.5 在多个强度下表现强劲。Berman 认为展示的 Terminal-Bench 比较中,中等或高强度可能是有吸引力的选择。这些是特定基准的估算,并非所有任务的通用成本。
交流、安全与效率
他讨论更简短的模型回复和公司的安全说法。Anthropic 的典型工作负载节省估算不同于 token 单价降幅。
Anthropic 表示模型交流更自然、先给出重要信息,并遵循写作指令。Berman 认为,在多个编程智能体之间切换时,简短解释很有价值,但他希望进一步测试后再评价其创意写作能力。
Berman 回顾 Anthropic 的安全说法:公司报告其自动行为审计成绩强劲,并扩大了对长任务和不可能任务的测试。公司称,模型在生物学和网络安全领域部署了与 Fable 5.1 相当的防护。Berman 将公司的说法与自己对先前事件的猜测区分开来。
Anthropic 估计,默认设置下典型工作负载的成本比 Opus 5 低 40%。Berman 解释,这与公布的输入和输出 token 单价约下降 20% 不同:任务总成本还取决于使用了多少 token。40% 是公司的工作负载估算。
Berman 查看 Artificial Analysis 的综合指数,报告 Opus 5.5 在展示的图表中领先。他认为这显示出重大进步,但综合指标仍取决于纳入的评测和设置。
Thariq 谈模型与放缓
Thariq 解释自己如何选择模型,介绍 AI 辅助开发,并讨论评测与放缓。
Thariq 加入对话,将 Opus 5.5 描述为更便宜、更有能力的日常主力模型。他说 Fable 5.1 仍适合规划、头脑风暴、审查或出错代价很高的安全工作。他最近重做个人网站时则全程使用了 Opus 5.5。
被问到 AI 如何帮助构建 AI 时,Thariq 说 Claude 会帮助构建 Claude,包括编写代码。他将其描述为许多小改进随时间累积,而不是模型突然完成全部自身开发。这是他对工作流程的描述,并非没有人类参与的自主自我改进。
谈到效率和质量,Thariq 描述了一种模式:先开发前沿能力,再让它更容易获得、成本更低。他预计这种模式会反复出现:最初出现在昂贵模型中的能力,随着时间推移可能更广泛地可用。
Berman 问,“5.5”这个名字是否像过去的半版本发布一样代表拐点。Thariq 提醒不要过度解读版本号,同时表示团队对该模型非常兴奋。他回忆早期 Sonnet 和 Opus 发布是重要的编程里程碑。
谈到放缓,Thariq 区分了对最新、通常尚未发布的前沿模型进行评估,与以更低成本普及既有能力。他说,沙箱逃逸等困难评测仍需要工作;同时 Anthropic 认为已发布模型的分类器和回退机制稳健。这是 Anthropic 对自身部署的立场。
Berman 问,内部获得模型到公开发布的间隔是否正在增长。Thariq 说增加评估方需要时间,但他无法判断总间隔会如何变化。对他而言,关键是公司与第三方评估方认为模型可以安全发布。
评测与智能体框架
对话转向视觉设计、剩余局限,以及 Claude Code 的工具和插件如何适应新模型。
Thariq 说,模型在他的博客上改进了视觉设计中的小细节,速度也快到让他保持工作状态。炫目的游戏和 3D 演示令人印象深刻,但他预计响应速度、效率和工具使用在日常软件工程中同样重要。
两位对谈者都认为评估越来越困难。Thariq 说,模型可能推理出了正确答案,却在评测中没有最终选定它。他希望帮助用户从现有智能中获得更好的结果,尤其是在更多人能够使用前沿级能力的时候。
被问及仍需改进什么时,Thariq 提到计算机和浏览器操作,以及帮助模型稳定发挥评测中展现的能力。他还希望系统能使用上下文和记忆,在合适时提出有用的反对意见,而不至于打扰用户。
关于智能体框架,Thariq 说底层模型不断变化,因此 Claude Code 团队必须跟上。团队最近删除了大量系统提示,并推出插件评测,帮助作者更新技能和插件,避免不必要地限制新模型。
Thariq 对更好的工具调用和云端托管智能体感到兴奋,但表示产品团队仍需努力,才能充分利用模型智能。他介绍团队增删了部分工具,并继续调整框架。Berman 最后表示自己还需要进行更多测试。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 45:08EN → 简体中文
 12:14EN → 简体中文
 10:36EN → 简体中文
 17:37EN → 简体中文