30 秒看懂
Berman 考察 Claude 3.7 Sonnet 的推理模式和公司报告的基准,随后用 Claude Code 逐步构建贪吃蛇游戏。他的历史测试还涉及数学和界面似乎无法获取当前网络信息的问题,证据仅来自少量示例。
- 1模型与编程工具Claude 3.7 Sonnet 和 Claude Code 是此次发布中的两个独立产品。
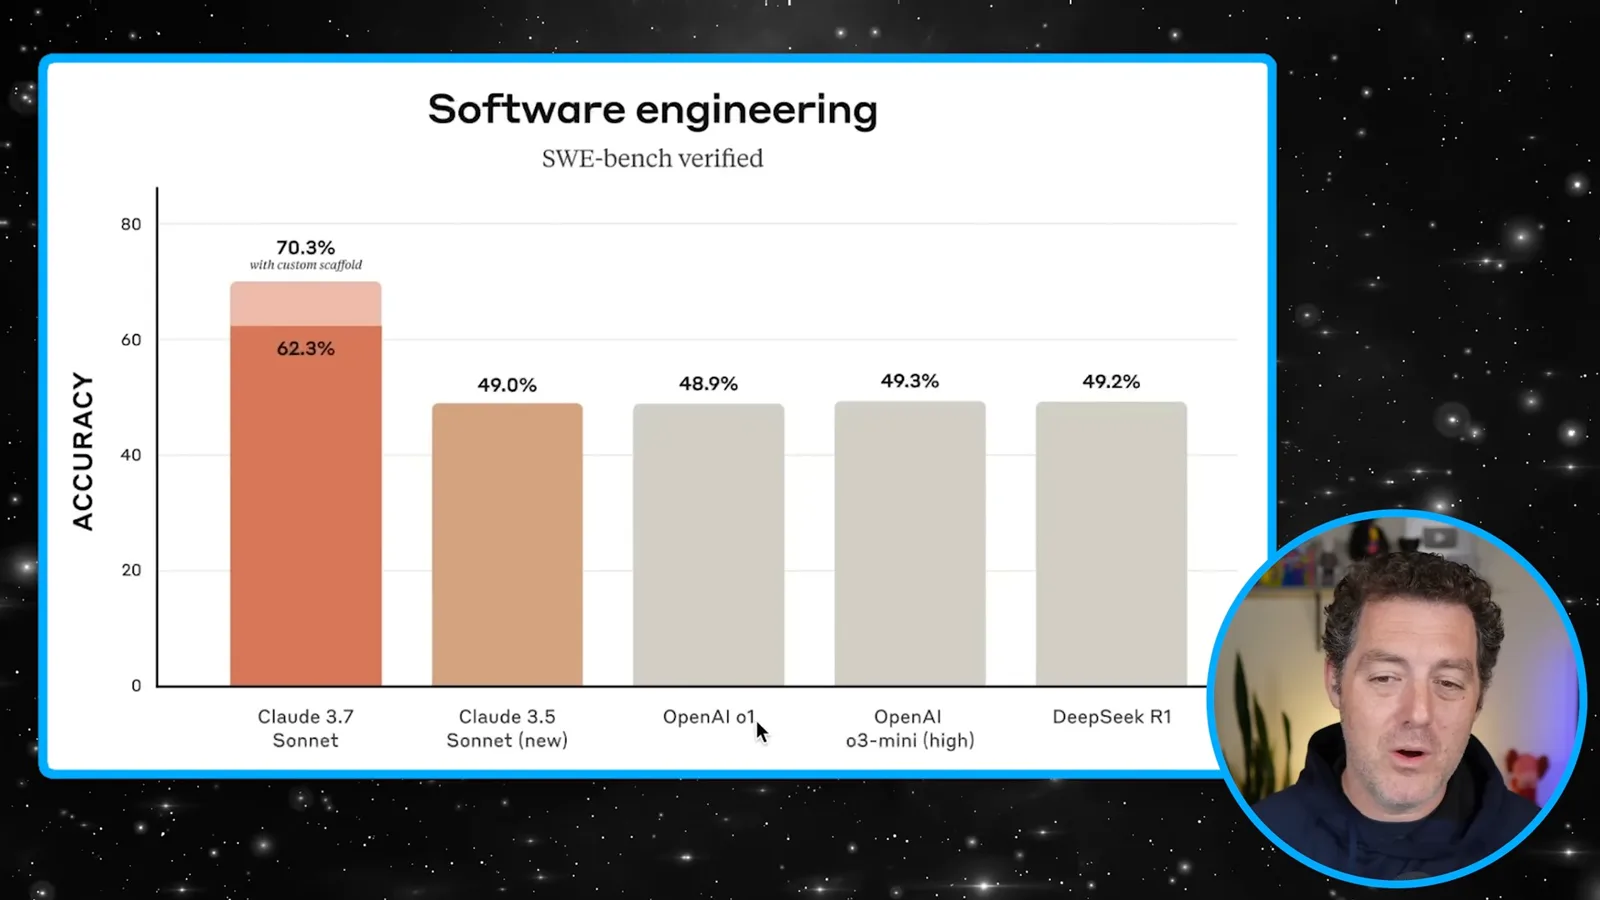
- 2基准背景SWE-bench 的 70.3% 结果使用了自定义脚手架。
- 3两条 AI 贪吃蛇主持人从基础游戏逐步增加竞争玩家和移动障碍物。
- 4近期信息视频中测试的界面没有回答一个时事问题。
要点建议
- Claude 3.7 Sonnet 在发布时结合了标准回答和扩展思考模式。
- 展示的 Anthropic SWE-bench Verified 结果中,70.3% 的分数使用了自定义脚手架。
- 生成的贪吃蛇演示可运行两个 AI 玩家,但不是全面的软件测试。
- 模型对积分结果达成一致,并不能证明答案正确。
- 发布时期的网络访问测试不能说明后续产品的能力。
按章节阅读整理后的全文
2025 年的发布
Berman 介绍混合推理模型、编程工具和公司基准图表。结果针对的是展示的特定配置。
2025 年 2 月,我解读 Claude 3.7 Sonnet 和 Claude Code 研究预览版,然后测试编程与数学任务。我逐步构建了一个由 AI 控制玩家的贪吃蛇游戏;视频是早期上手体验,而非受控比较。
Anthropic 将 Claude 3.7 Sonnet 描述为混合推理模型,既能给出标准回答,也能使用扩展思考。Claude Code 是独立的命令行智能体编程工具。这里描述的产品功能与访问情况反映的是发布时期。
我介绍了可见的思考展示,以及 API 用户设置思考预算的能力。不能自动认为这一展示涵盖了每一步内部过程;token 预算、输出限制和上下文窗口也是不同的设置。
Anthropic 的 SWE-bench Verified 图表显示,Claude 3.7 Sonnet 得分为 62.3%,使用自定义脚手架时为 70.3%,所列此前配置约为 49%。这些是公司在特定设置下报告的结果;有了脚手架,这就不再只是原始模型之间的比较。
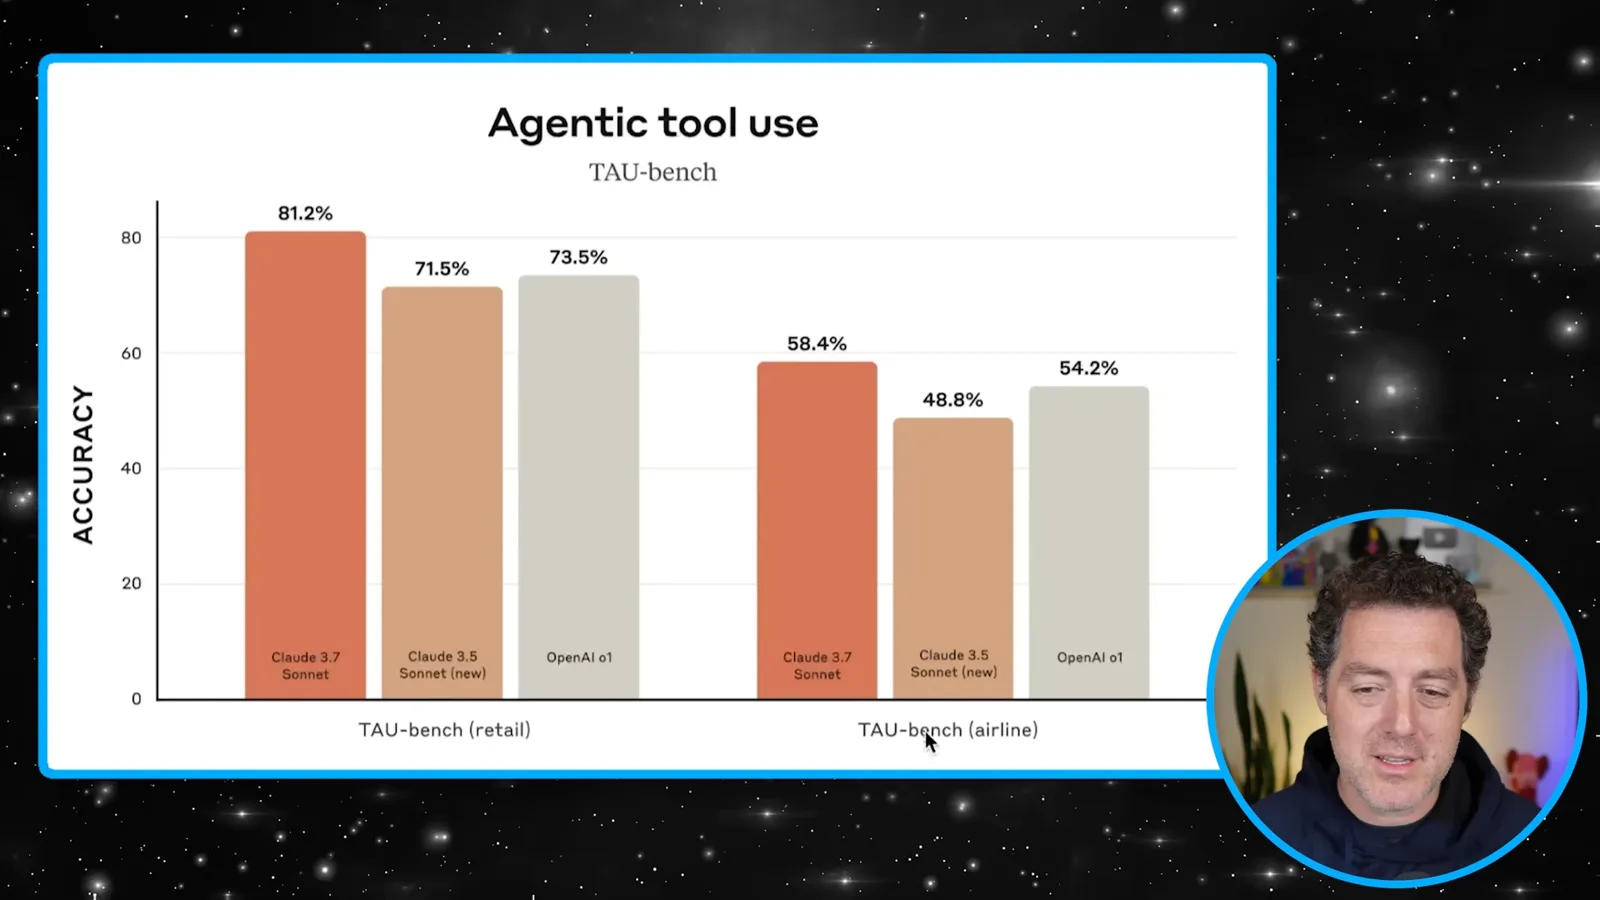
另一张 TAU-bench 图表显示,新模型在零售和航空工具使用任务中领先于图中列出的其他模型。我还讨论了数学、科学和视觉推理基准,但这些精选评估不能保证它在所有工作流程中都表现良好。
用 Claude Code 构建贪吃蛇
他创建游戏,并添加 AI 玩家和移动障碍物。简短测试展示了游戏运行。
我决定更新旧的测试标准,因为较新的推理模型在上面表现很好。我指出此前对 Grok 3 的测试本可以更有挑战性,因此这里的非正式示例不应被视为完全受控的模型比较。
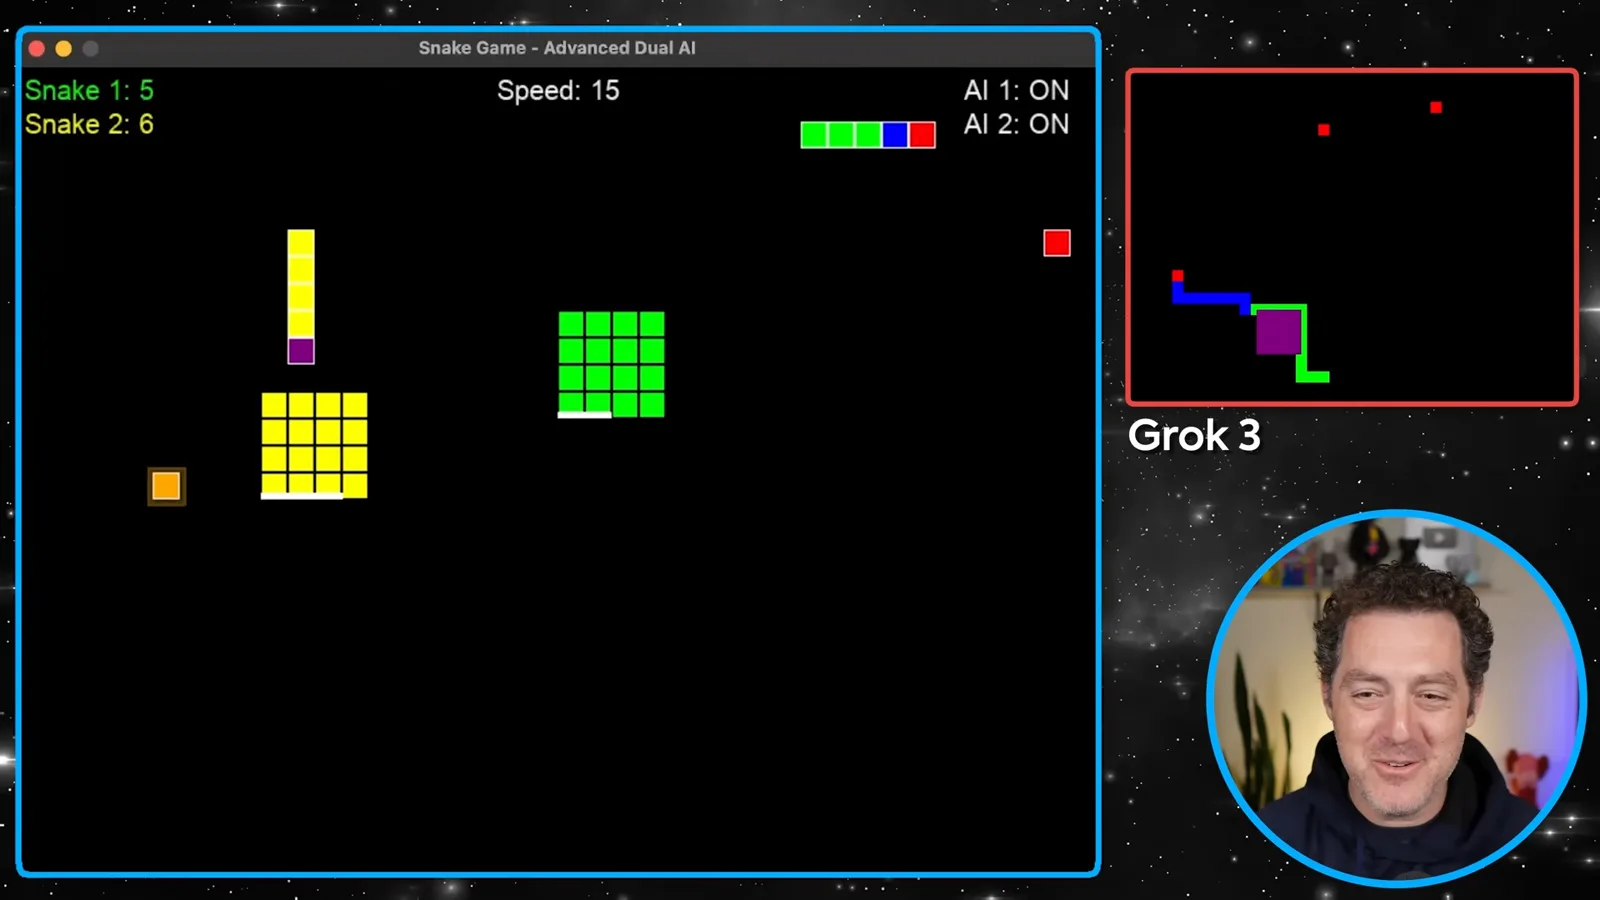
在演示中,Claude Code 很快生成了一个基础贪吃蛇游戏。接着我要求加入 AI 控制;应用生成的修改后,我可以切换智能体和调整速度,蛇使用 A* 寻路方式寻找食物。
AI 控制的蛇最终犯错并输了。我要求加入第二条自动控制的蛇,随后添加多个食物和能够击败另一条蛇的临时移动障碍物。展示中的游戏确实运行了,但简短演示不能验证每条规则或所有边界情况。
数学与近期信息
他比较数学回答并询问近期事件,最后给出有保留的早期印象。
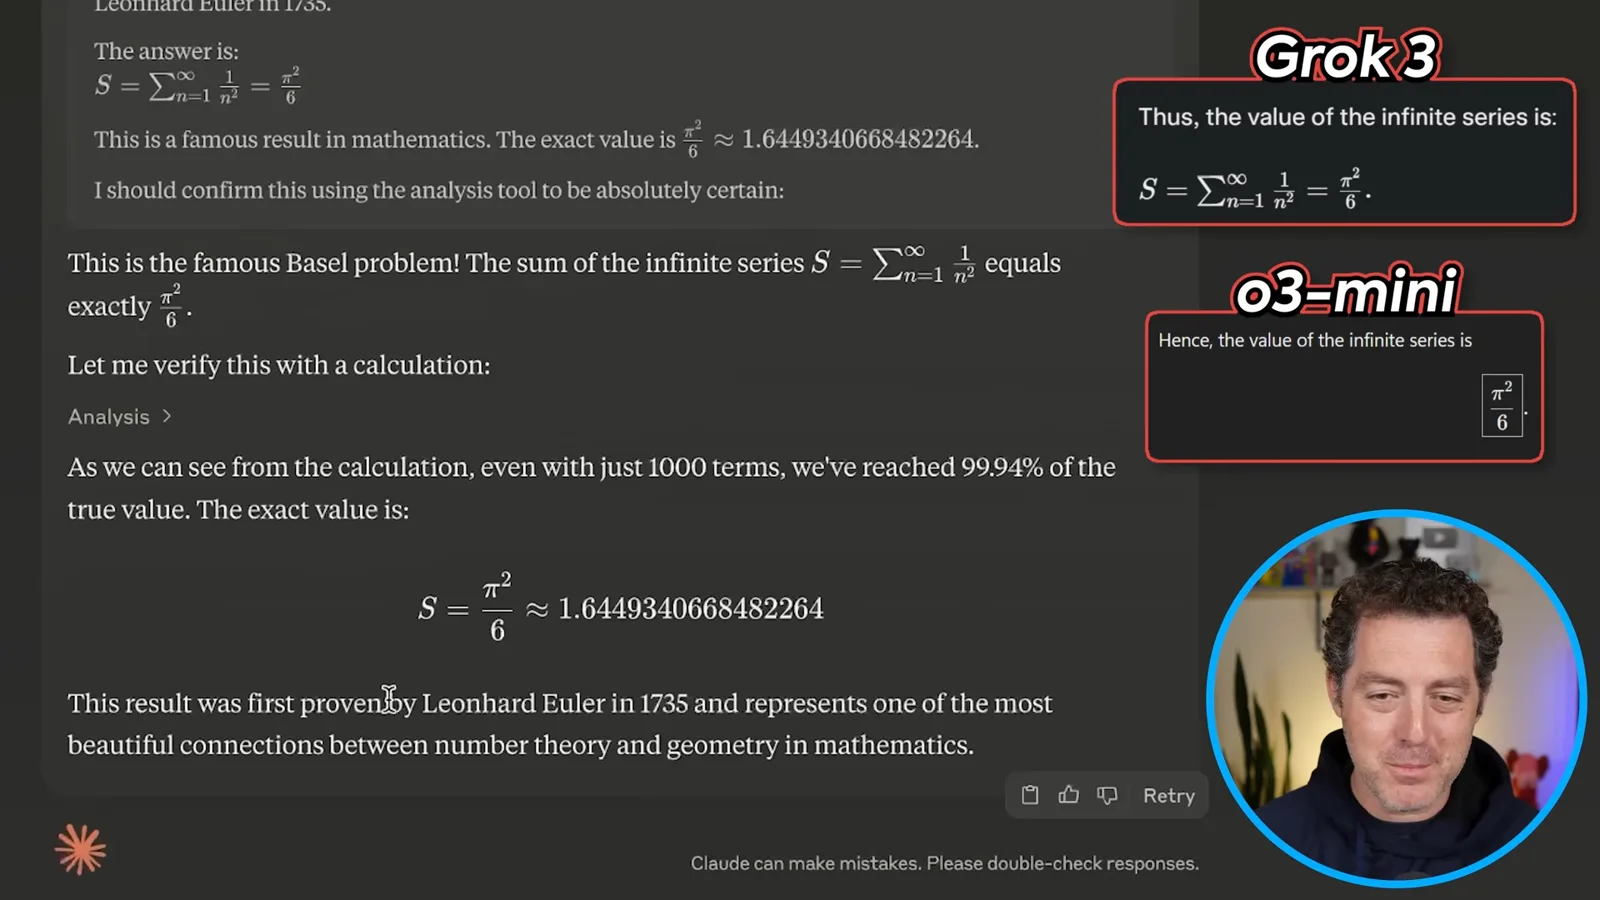
对于一个困难的积分,Grok 3 和 Claude 给出了不同答案。我将 Claude 的结果与 o3-mini 比较,并暂时倾向相信一致的结果,但模型之间的意见一致本身并不是数学证明。
我使用扩展思考尝试巴塞尔问题。Claude 给出熟悉的结果:平方倒数之和为 π²/6;我随后要求逐步解释。得到一个著名结果本身并不能证明推导过程正确。
最后,我询问 Apple 的一项近期公告,发现测试中的界面没有用当前信息回答。我把这次 2025 年测试中似乎缺少实时网络访问视为一个缺点;视频不能证明后续版本目前具备或不具备什么能力。
我的早期印象是,这个模型在编程示例中表现良好,但也存在局限。这些实验只是发布时期少量的演示,因此关于可靠性的更广泛结论需要进一步测试。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 1:03:37EN → 简体中文
 0:53EN → 简体中文
 0:22EN → 简体中文
 45:08EN → 简体中文