30 秒看懂
Matthew Berman 回顾 Grok 4.7 的发布说法、编程和知识工作基准对比、价格与上下文窗口。他指出该模型在某些任务上表现强劲,在其他任务上落后,并强调每项任务成本同时取决于 token 单价和用量。他的评价仍属初步判断。
- 1CursorBench 与成本展示的得分随推理强度上升;Berman 提醒读者注意 xAI 拥有 Cursor。
- 2遗漏的比较公司的 DeepSWE 表格没有列出 Astra,Berman 在另一张图中补充了它。
- 3不同任务,不同结果展示的终端和法律基准显示出不同的相对优势。
- 4token 价格视频引用每百万输入 token 2 美元、每百万输出 token 6 美元。
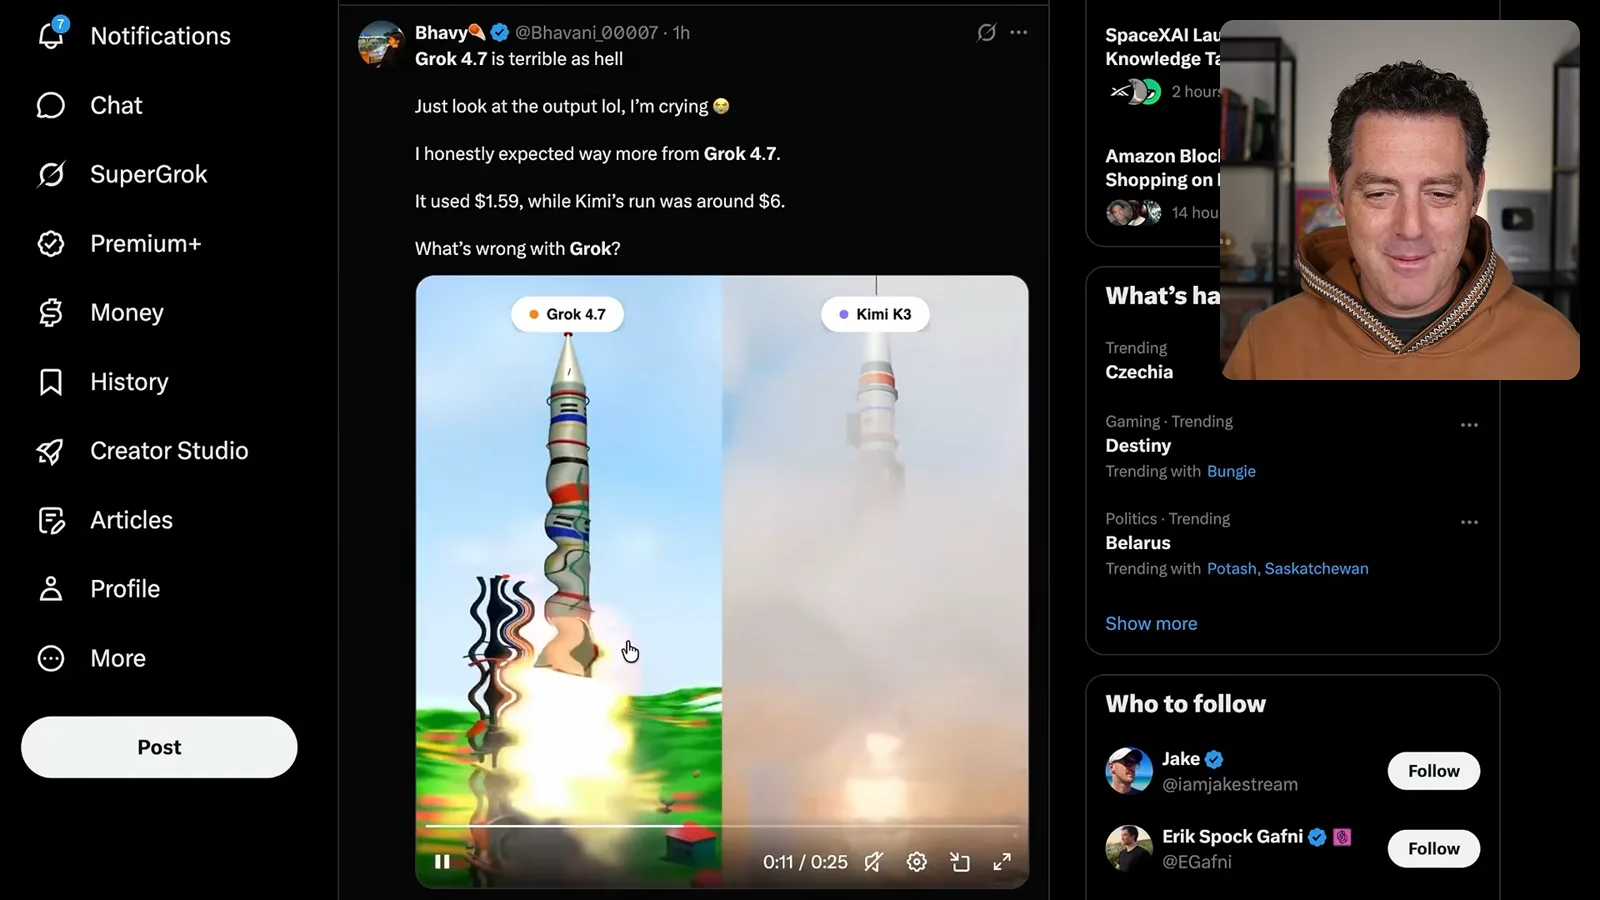
- 5实际限制第三方视觉演示的设置不清楚,而更高的 token 用量可能改变任务成本。
要点建议
- Grok 4.7 在公布的多项编程和知识工作测试中有竞争力,但在其他测试中落后于领先模型。
- 基准图表纳入的模型和设置不同,可能给人不同印象。
- 每项任务成本既取决于 token 消耗,也取决于 token 单价。
- Berman 尚未充分亲自测试该模型,整体评价仍是初步判断。
按章节阅读整理后的全文
发布与编程比较
Berman 回顾 xAI 的说法和 CursorBench 成绩,再比较公布的编程分数与成本。
Grok 4.7 已经发布,我想将它与马斯克此前预测的“大致与 Opus 5 相当”作比较。发布信息称,它在与 Grok 4.6 相同的价格和速度下改进了编程和知识工作。我还没有充分测试,因此这次评价很大程度上基于公布的基准。
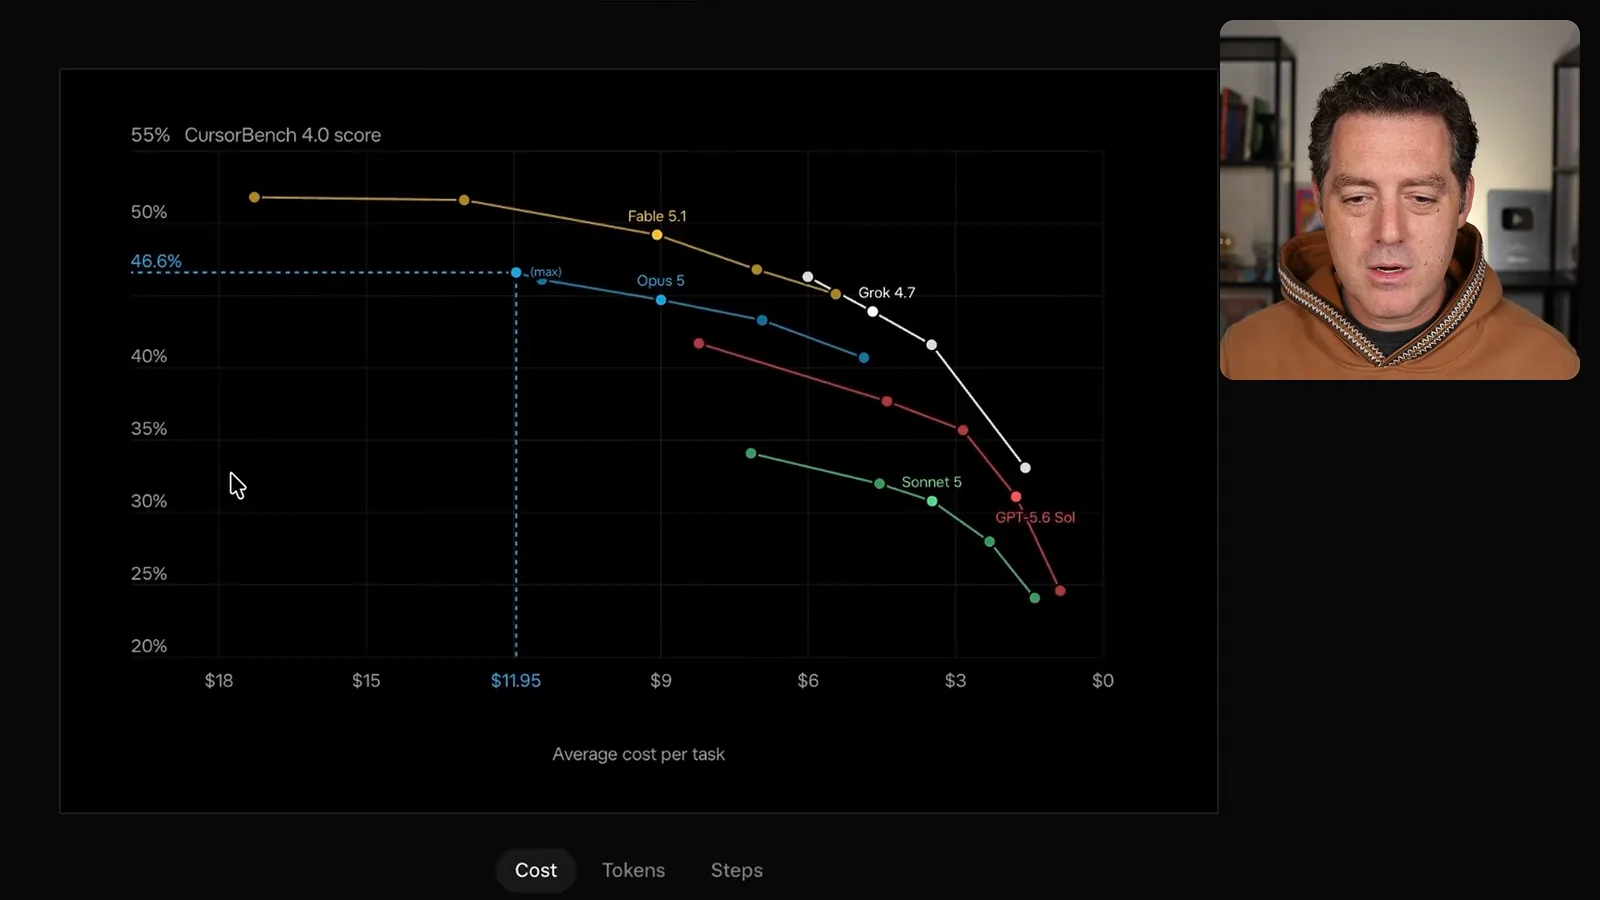
CursorBench 图表将得分与每项任务平均成本作比较。xAI 拥有 Cursor,解读这项比较时需要记住这一关系。图中 Grok 4.7 从低推理强度的大约 33% 提升到超高强度的 46.3%;展示的最高设置接近但低于 Opus 5。
图表还比较每项任务输出的 token 数量和步骤数。成本同时取决于 token 用量和单价,因此用更多 token 的模型如果单价更低,仍可能更便宜。在展示的编程比较中,Fable 5.1 得分更高,但价格也高得多。
展示的 DeepSWE 1.1 表格中,Grok 4.7 得分 71%,GPT-5.6 Sol 为 72.7%,Fable 5.1 为 70%。我注意到这张公司表格没有列出 GPT-6 Astra,尽管它出现在发布材料的其他地方。图表选择展示哪些模型,会影响读者的印象。
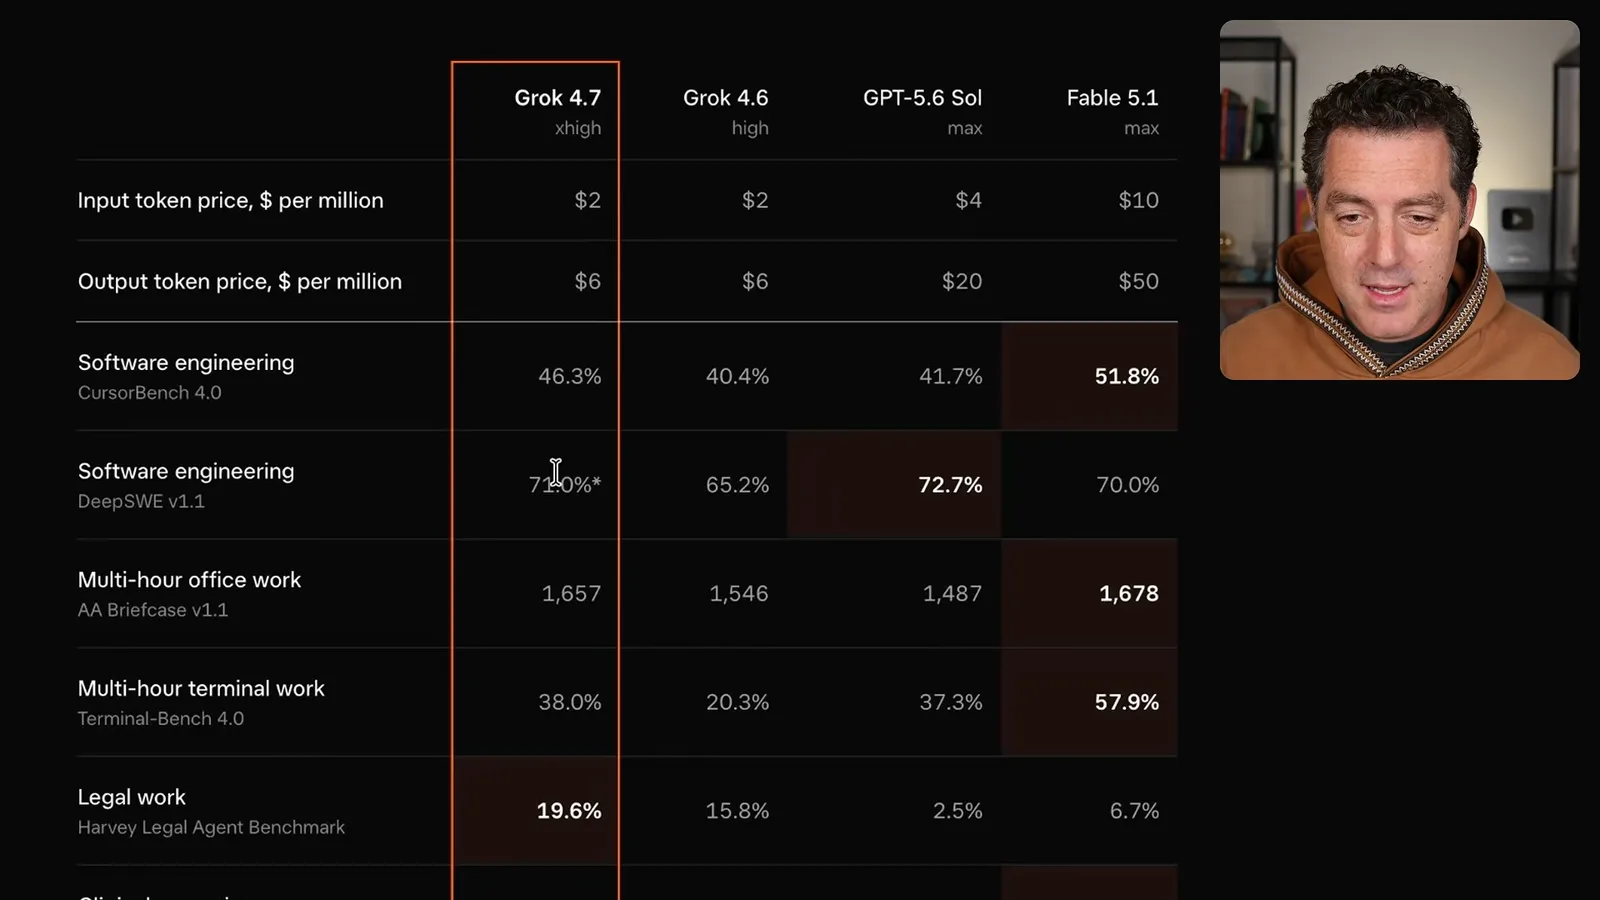
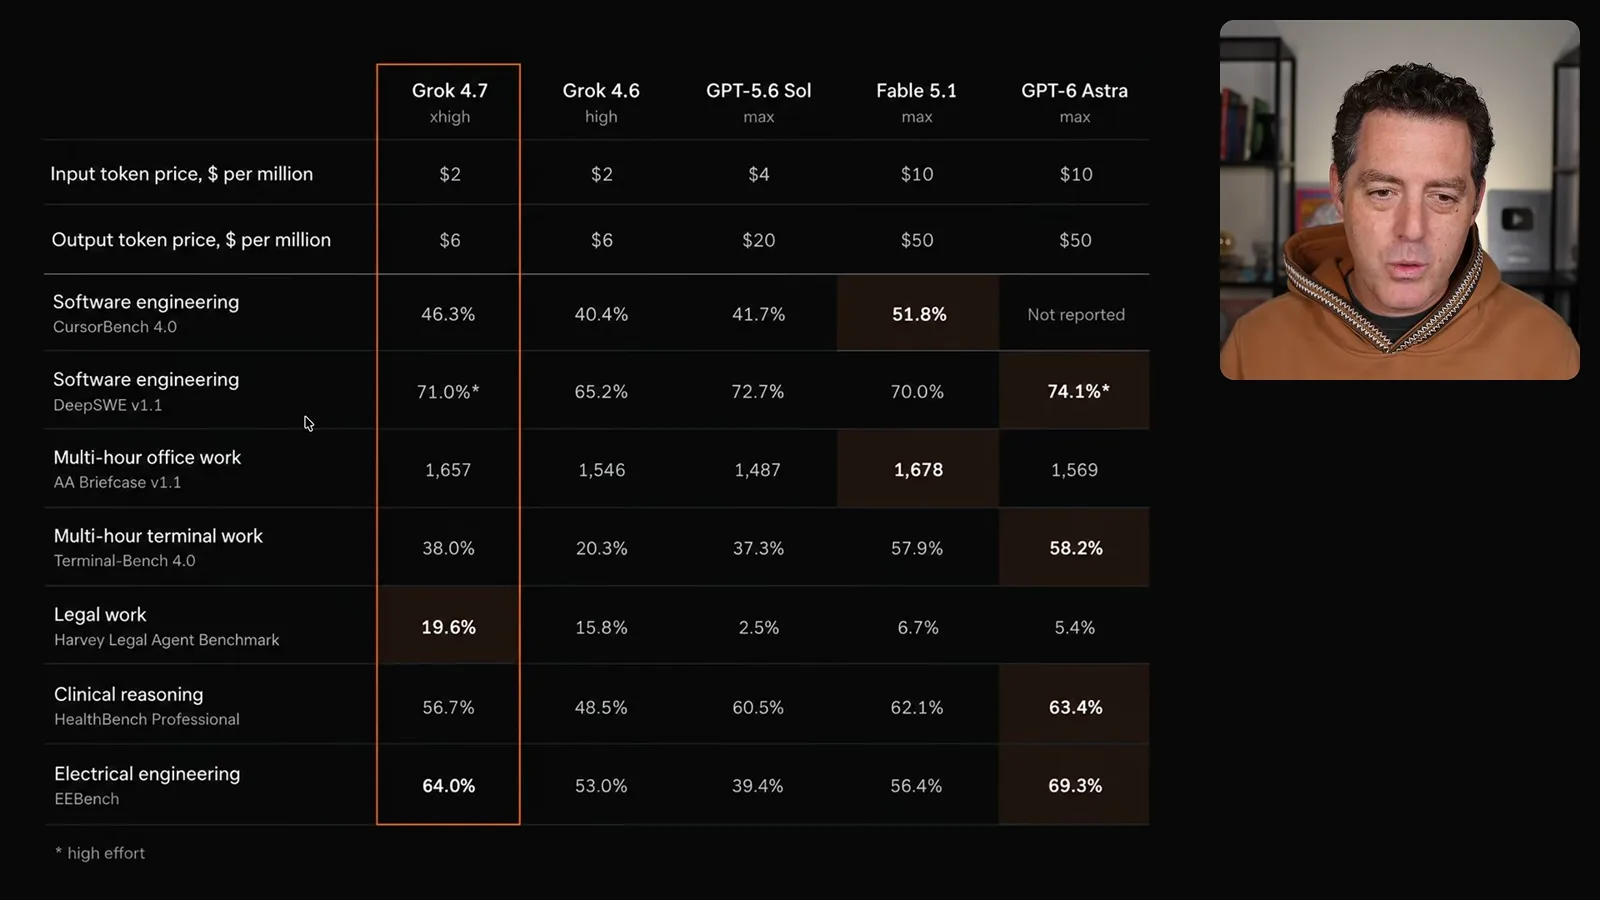
我让 Astra 重新制作表格并加入自己的成绩。生成的比较显示 Astra Max 在 DeepSWE 上为 74.1%,高于 Grok 的 71%。这是我为比较而制作的图表,解读数据时需要了解各自的评测条件和设置。
知识工作、价格与安全防护
他分析法律和终端成绩、token 价格、知识工作得分与公司的安全防护说法。
在 Terminal-Bench 4.0 中,表格显示 Grok 为 38%,低于 Fable 5.1 的 57.9% 和 Astra 的 58.2%。在展示的 Harvey 法律智能体基准中,Grok 得分 19.6%,高于表中其他模型。Berman 还引用了一个更高的 Muse Spark 独立结果。
视频引用 Grok 4.7 的价格为每百万输入 token 2 美元、每百万输出 token 6 美元。Berman 认为,它在一些方面接近前沿水平,价格却明显低于部分竞争模型。不同用户可能合理地选择最好的答案或更低的成本。
Berman 将此与企业采用开放权重模型联系起来,引用了一张使用量与供应商收入呈现不同趋势的图表。他认为,一些工作负载需要高效自动化,而不一定要求最高分;另一些用户则愿意为更好的结果支付更多。
xAI 的发布材料在其他评测中也展示了 Astra。在公布的 GDPval 比较中,Grok 4.7 得分 1695 Elo,位于 Fable 5.1 的 1735 和 Astra 的 1542 之间。展示的 AA Briefcase 中,Grok 与 Fable 的成绩也很接近。模型在一些任务上有竞争力,在另一些任务上差距更大。
公司介绍了新的安全防护体系,并报告拒绝回答和抵抗越狱的能力有所提升,包括双用途领域。这些是公司对自身评测的说法。Berman 还提到马斯克对延期的解释:模型可能过早放弃任务,或未充分检查自己的工作。
独立指数与实际限制
他回顾综合排名、第三方演示和上下文限制,同时强调自己的测试有限。
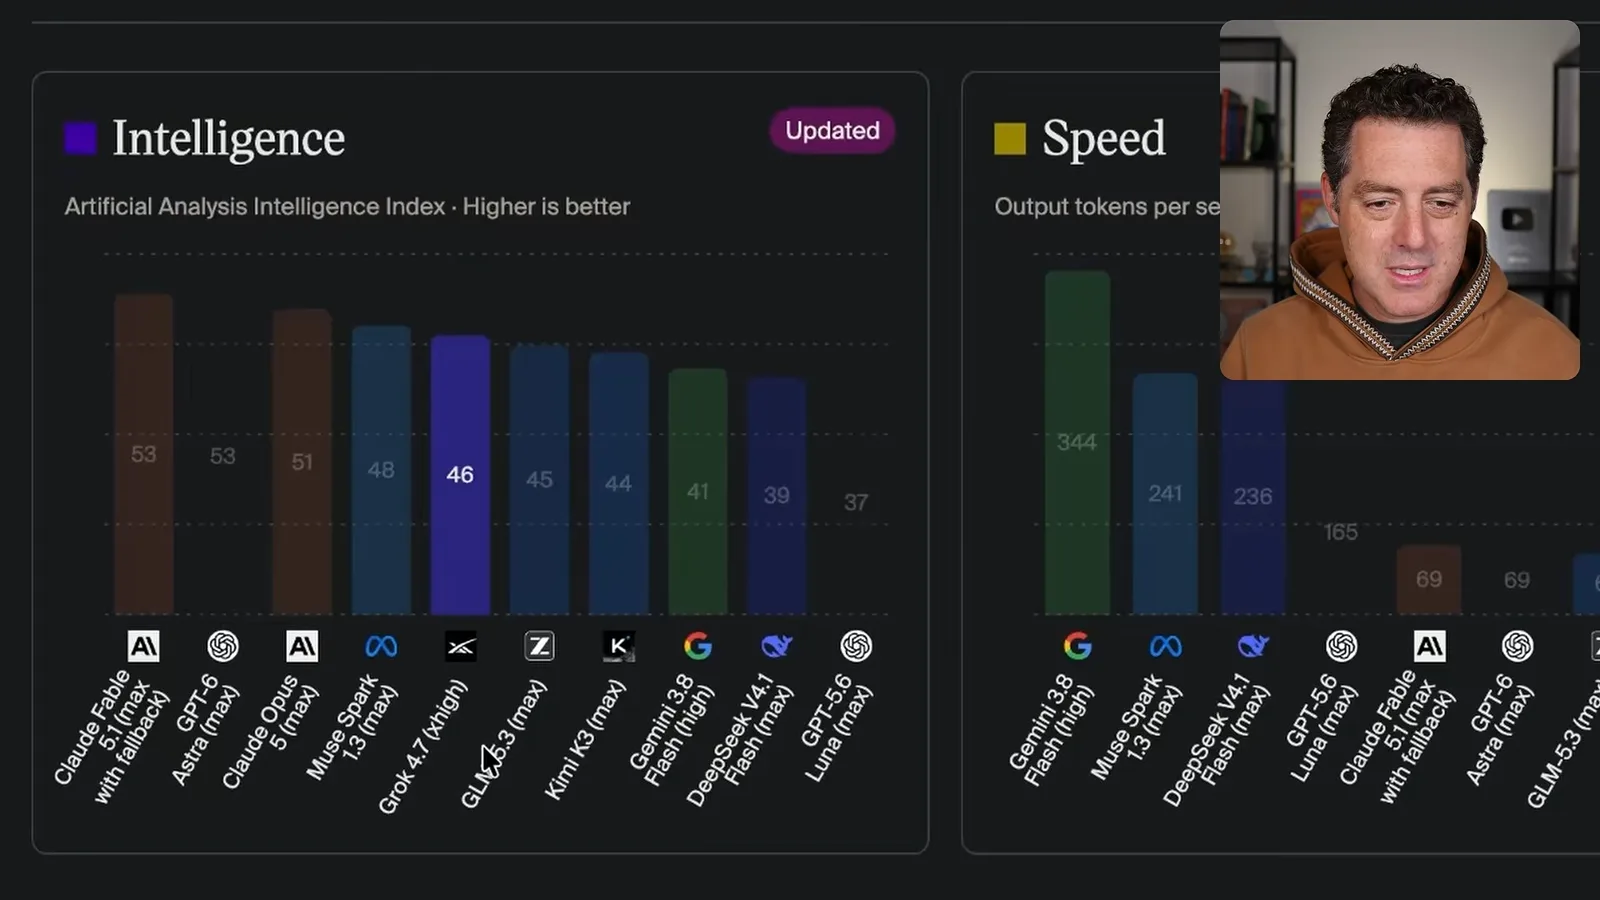
展示的 Artificial Analysis 智能指数将 Grok 4.7 以 46 分列在第五位,排在 Fable、Astra、Opus 和 Muse Spark 等模型之后。这个综合指标提供了另一种比较,但不能取代在用户实际关心的工作中测试模型。
Berman 展示了一段第三方火箭动画对比,Grok 的结果在 Kimi K3 旁边看起来很差。他提醒自己不知道对方使用了什么设置。Artificial Analysis 还报告 Grok 4.7 的 token 用量更高,这可能使每项完成任务的成本上升,即使单价较低。
引用的上下文窗口为 50 万 token,而几个竞争模型为 100 万。Berman 认为 Grok 4.7 在部分领域接近前沿,具有成本效益,并希望未来的 Grok Bot 更新能使用它。由于他自己的测试有限,这一结论仍是初步判断。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 45:08EN → 简体中文
 12:14EN → 简体中文
 10:36EN → 简体中文
 17:37EN → 简体中文