30 秒看懂
Berman 探讨 DeepSWE 的简短提示、多样化代码仓库、行为验证器和编程智能体排行榜。他比较报告中的准确率、token 用量、时间和成本,同时指出自己的体验与一些开发者的印象不同;这些结果只适用于受测配置。
- 1任务设计作者结合新任务、仓库多样性和行为验证。
- 2排行榜快照展示的配置中,GPT-5.5 得分为 70%,Opus 4.7 为 54%,图中同时标注了不确定性。
- 3验证器分歧由大语言模型审查的审计报告了不同的假阳性和假阴性比例。
- 4Harness 很重要固定 harness 使比较标准化,但它与不同模型的交互可能有所差异。
- 5每次试验成本报告的价格和运行时间描述的是该测试设置,而非所有部署场景。
要点建议
- DeepSWE 在 91 个仓库中使用原创参考解答和侧重行为的简短提示。
- 新的参考解答可以减少解答直接泄露,但不能证明完全不存在数据污染。
- 验证器审计使用大语言模型作为裁判,因此分歧率只是估计,并非无可置疑的真实值。
- 统一 harness 有助于标准化比较,而原生 harness 提供补充视角。
- 准确率、时间、输出 token 和每次试验成本衡量的是编程流程的不同方面。
按章节阅读整理后的全文
为什么需要另一个编程基准?
Berman 介绍 DeepSWE 的任务设计和排行榜,并解释简短请求与仓库多样性为何吸引他。
我考察 Datacurve 推出的编程智能体基准 DeepSWE,并探讨它的分数是否更能反映开发者使用模型的方式。基准提供的是性能的一个视角,不能为所有代码库或工作流程确立通用排名。
DeepSWE 的创建者介绍了四个特点:为减少数据污染而新编写的任务、广泛的仓库覆盖、以简短提示提出更有挑战性的修改,以及旨在接受多种有效实现方式的行为验证。
如果任务来自公开问题或提交,可能与模型训练数据中的材料重叠。创建者称其参考解答从头编写,并非复制现有补丁;这能减少一种污染形式,但不能证明模型从未见过任何相关信息。
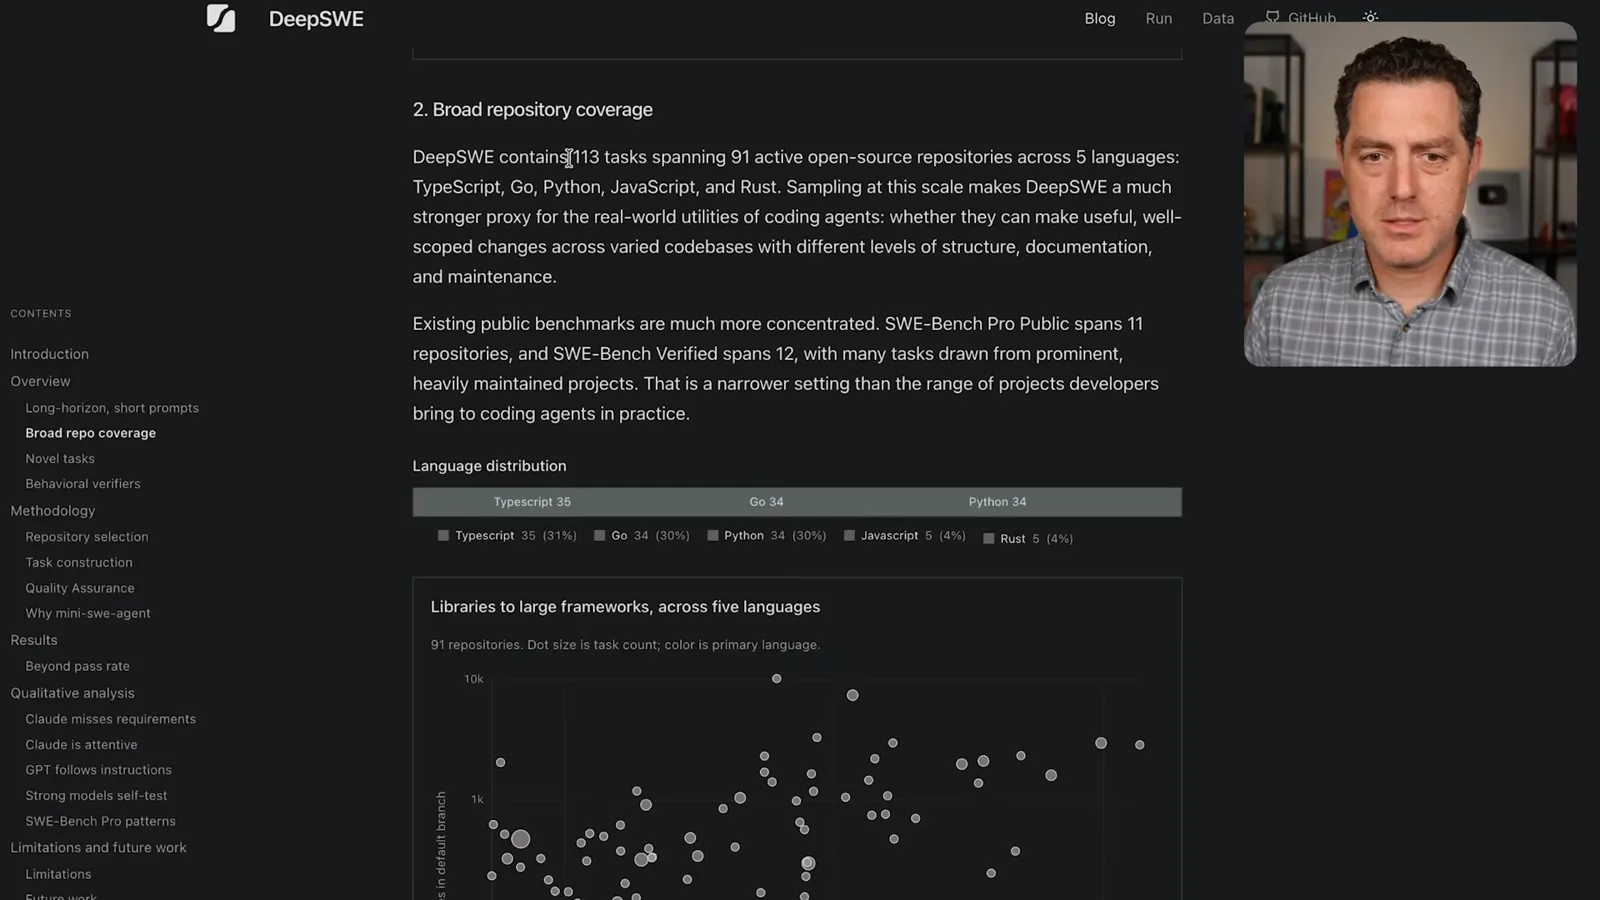
该基准包含 113 项任务,覆盖 91 个活跃开源仓库,涉及 TypeScript、Go、Python、JavaScript 和 Rust。我看重这种多样性,因为真实开发者会面对不同的项目结构和语言。
据基准作者介绍,提示的长度大约是 SWE-Bench Pro 的一半,而解答需要多得多的代码和输出 token。我喜欢侧重行为的请求,因为我经常只告诉智能体哪里出了问题,而不是规定每一步如何实现。
作者审计了验证器的假阳性和假阴性:前者是错误补丁通过验证,后者是正确补丁被拒绝。我讨论了他们报告的 SWE-Bench Pro 分歧情况及 DeepSWE 低得多的数值。
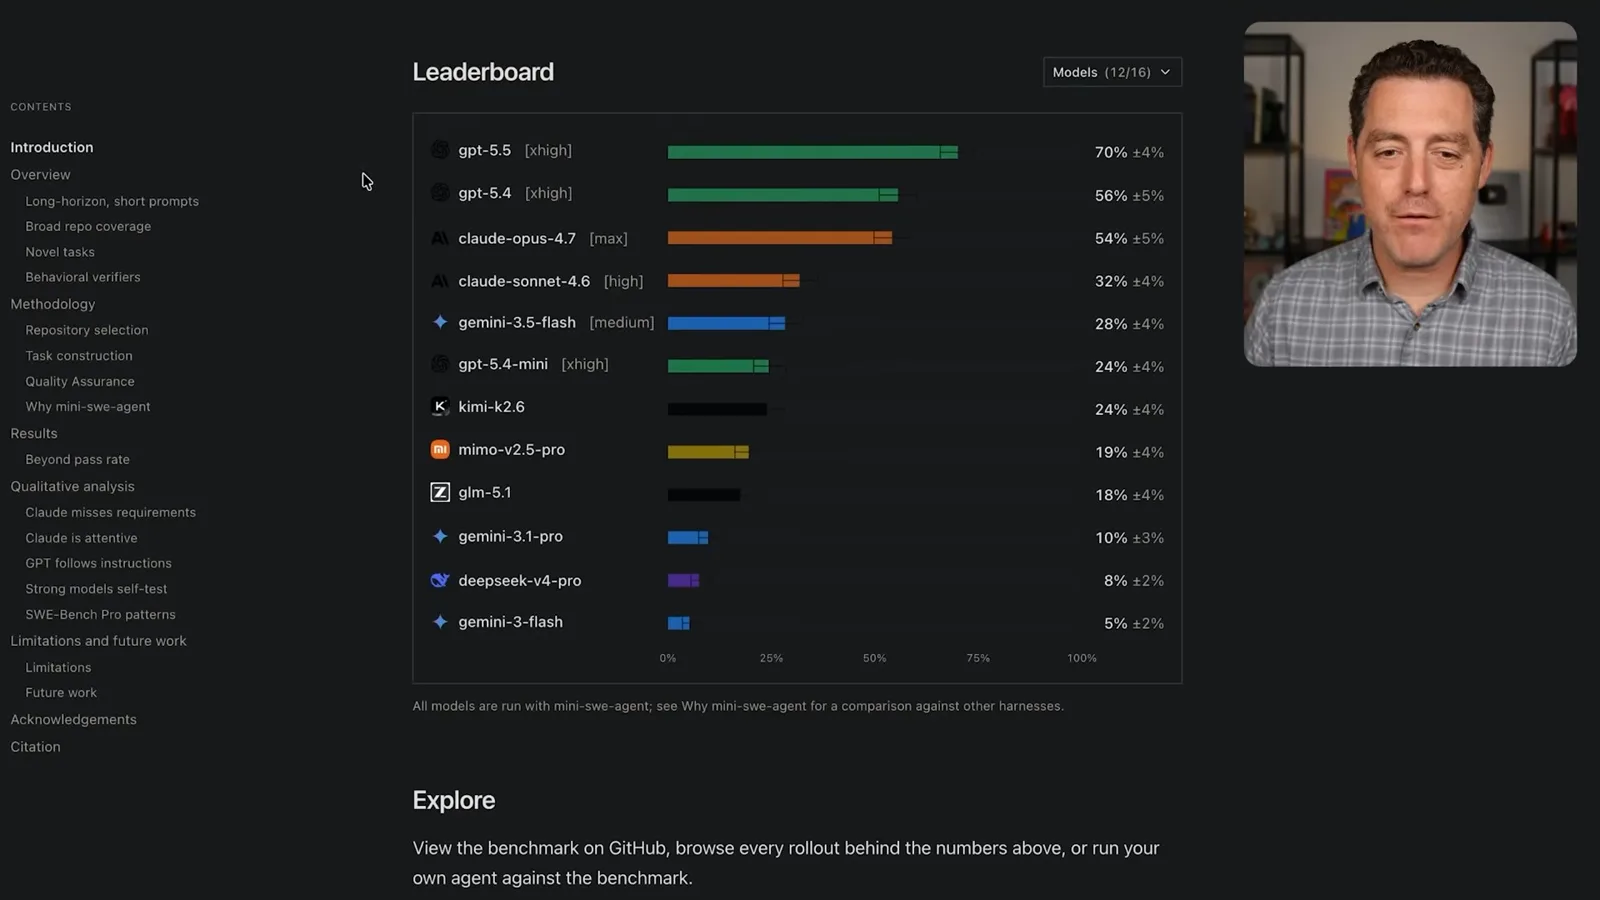
视频展示的排行榜中,以 extra-high 推理配置运行的 GPT-5.5 得分为 70%,GPT-5.4 为 56%,Claude Opus 4.7 为 54%;图中均标注了不确定性。这是特定任务、harness 和配置下的结果,不能证明它在每项开发任务中都更强。
我认识的一些工程师称赞 GPT-5.5,我认为排行榜与他们的反馈一致。我也喜欢 Opus,稍后提到我自己的编程体验尚未让我认定 GPT-5.5 最好;个人观察与基准结果回答的是不同问题。
任务与验证
他讨论原创解答、行为测试和报告中的验证器审计。该审计依赖大语言模型裁判。
DeepSWE 提示描述期望的行为,而不是提供详细施工方案。智能体必须探索仓库、决定在哪里修改并完成实现。我认为这与许多自然的开发者请求相似。
作者称每个参考解答都是新写的,尽管一些任务受尚未解决的公开问题启发。新补丁减少了解答直接泄露的风险,但不能排除模型之前接触过该仓库的其他内容。
行为验证器应评估补丁是否实现了要求的行为,而不要求它与参考代码完全一致。这很重要,因为多种实现方式都可能正确,而过于狭窄的测试可能拒绝有用的替代方案。
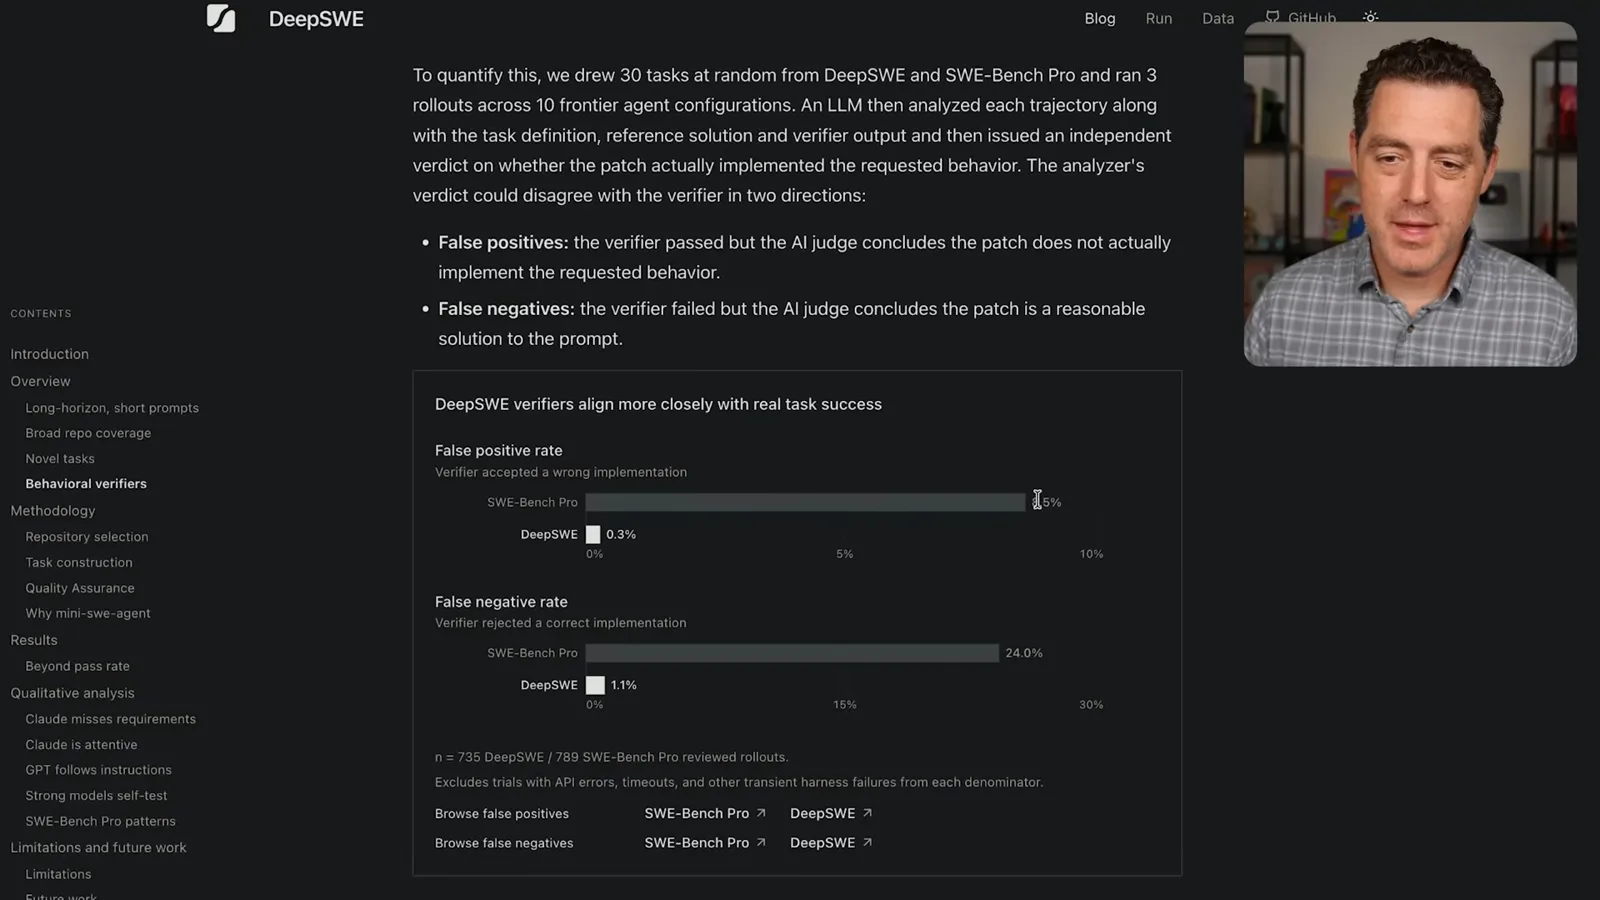
图表显示,SWE-Bench Pro 和 DeepSWE 的假阳性分歧率分别为 8.5% 和 0.3%,假阴性分歧率分别为 24.0% 和 1.1%。画面中的方法说明,大语言模型裁判审查了抽样运行结果;其判定是估计,并非绝对真实值,也不能证明每项任务都有这样的错误率。
仓库必须公开、处于活跃维护状态、采用宽松开源许可证,并至少拥有 500 颗 GitHub 星标。每项任务都包含提示、用于评分的可执行验证器,以及供审查使用的参考解答。
Harness、成本与速度
统一 harness 让比较更标准化,一项小规模试验则比较原生工具。Berman 回顾 token 用量、运行时间和价格。
排行榜在所有模型上固定使用 mini-swe-agent harness,以减少不同脚手架带来的差异。我也思考,将模型与其原生编程 harness 配对是否能提供有用的补充比较,因为模型与工具可能共同优化。
作者展示了一项小规模试验:在 10 道 SWE-Bench Pro 任务上比较 mini-swe-agent 与原生 harness。在这一小样本中,统一 harness 的表现与原生方案相当或更好,但 10 道题不足以证明所有 harness 比较都不受影响。
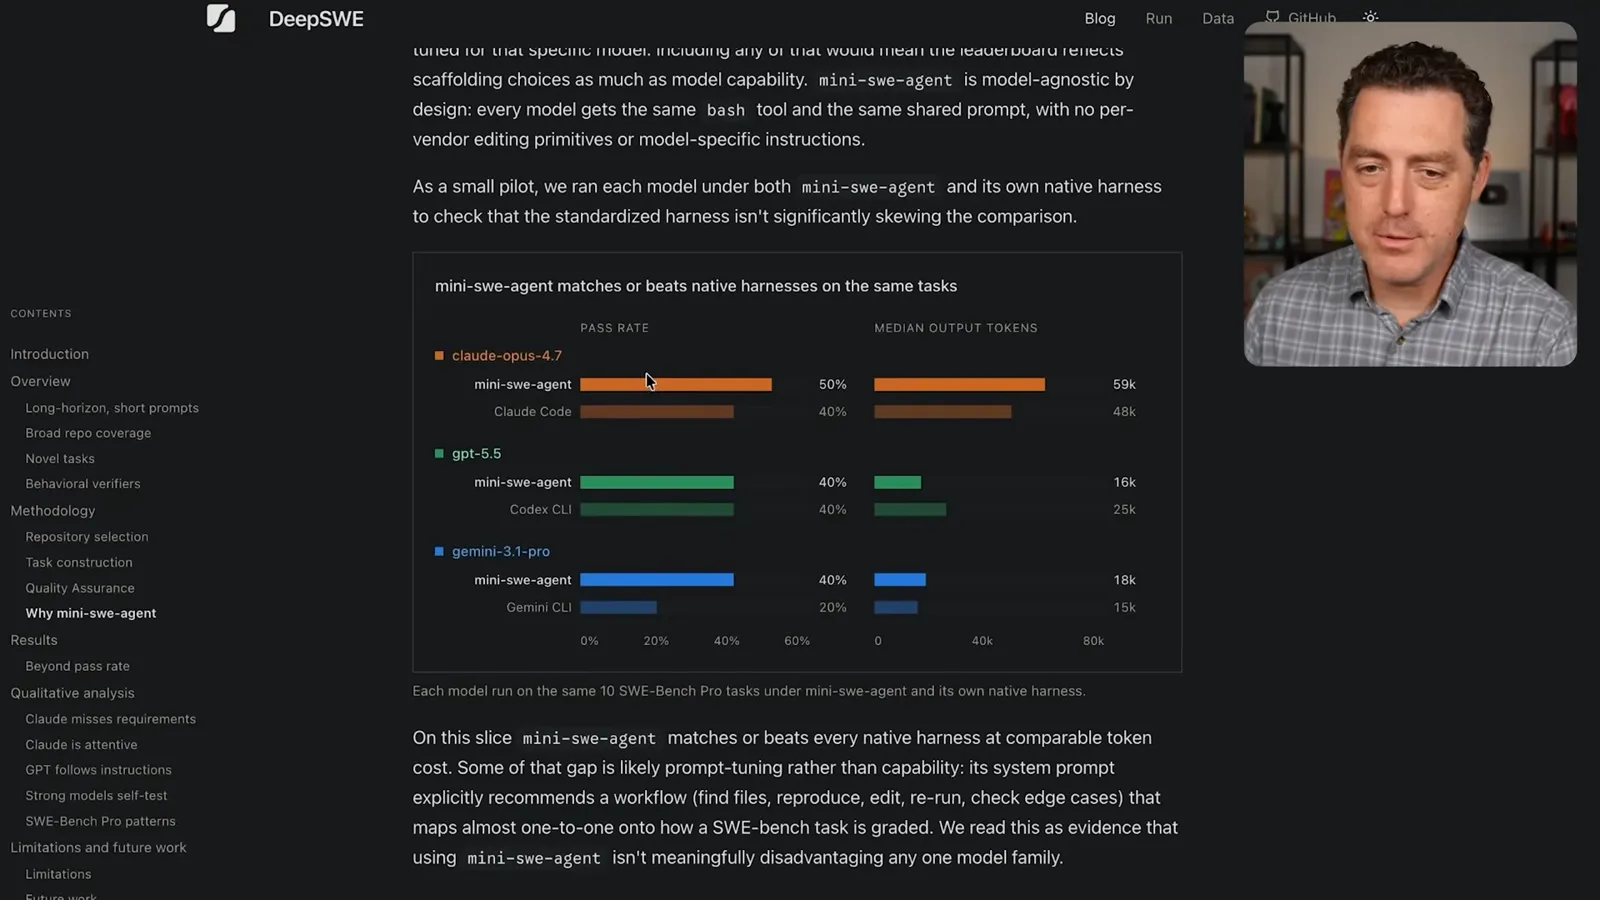
在该试验中,图表显示 Opus 4.7 使用 mini-swe-agent 时输出约 5.9 万 token 的中位数,使用 Claude Code 时约 4.8 万;GPT-5.5 分别使用约 1.6 万和 2.5 万 token。这些试验数据不同于完整 DeepSWE 基准的 token 用量。
我注意到,DeepSWE 的得分差距比 SWE-Bench Pro 比较图中的差距更大。分数差异可以让基准更容易区分模型,但差距大小本身不能证明它更能代表所有真实软件开发工作。
完整基准的图表比较了得分与每次试验的输出 token 中位数、实际耗时和成本。展示的 GPT-5.5 配置得分为 70%,每次试验约输出 4.7 万 token、耗时 20 分钟;这些结果只针对受测设置。
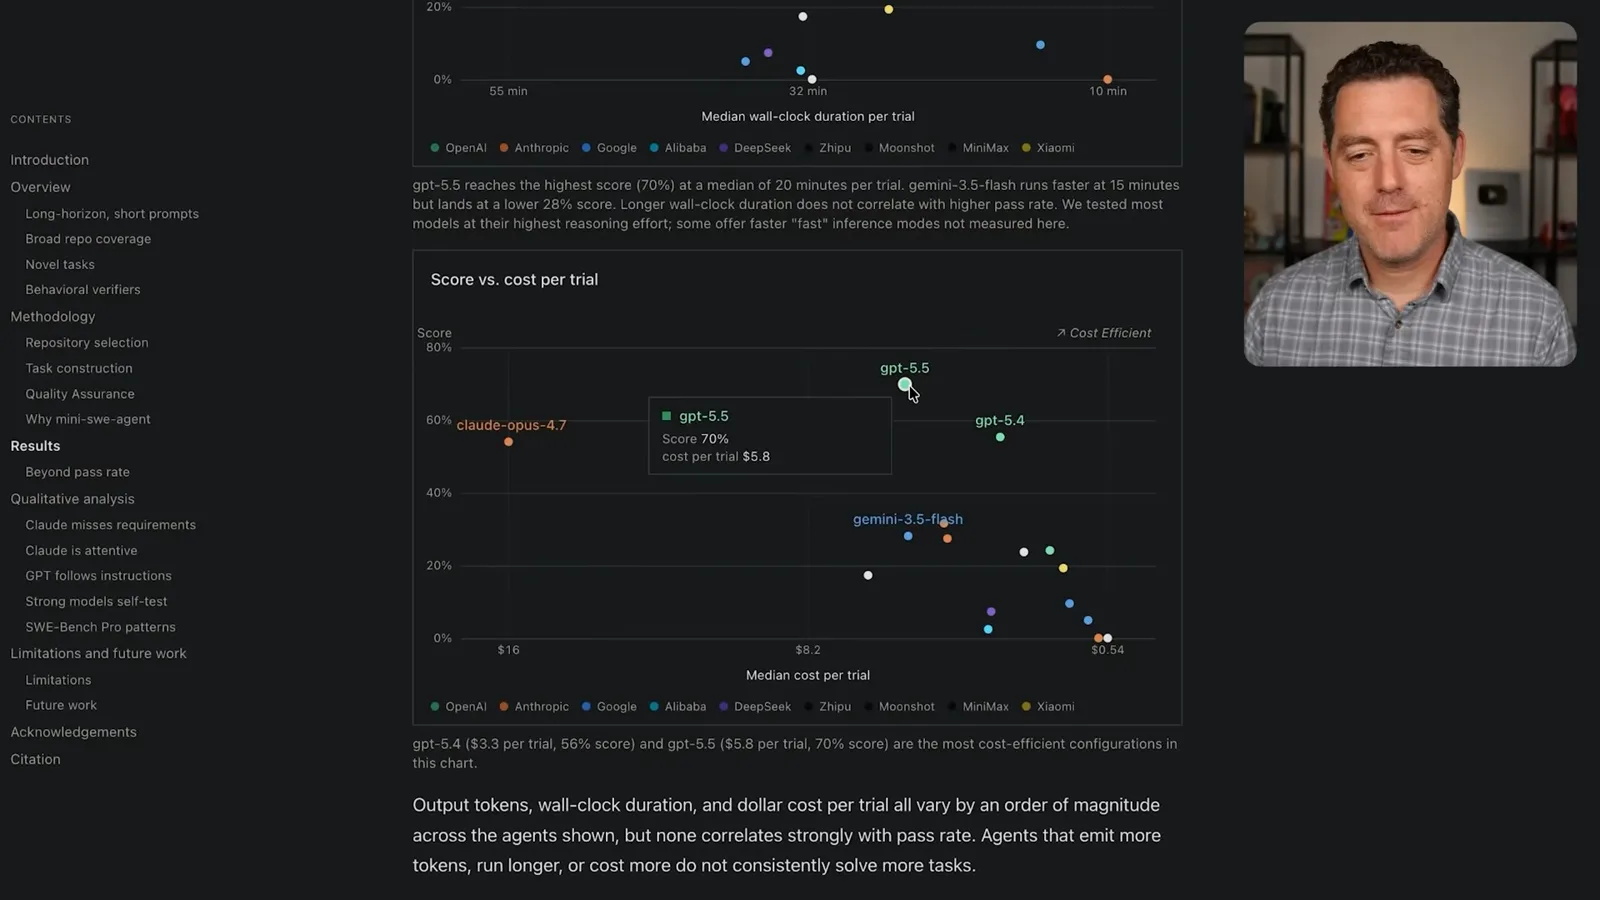
图表显示,GPT-5.5 每次试验约花费 5.80 美元,Opus 4.7 接近 16 美元,两者得分也不同。每次试验成本取决于模型、定价、任务、harness 和设置,并不自动等于每次成功解决任务的成本。
观察到的智能体行为
基准作者描述了失败和自我测试模式。Berman 将结果与开发者的个人观察比较,并指出一个缺席的模型。
作者还对失败进行分类。他们的分析报告说,Claude 配置有时会遗漏多部分需求中的一个分支,而 Opus 在提示与仓库状态似乎不一致时会检查 Git 历史。这些是观察到的趋势,并不适用于每次请求。
他们报告,在该分析中 GPT-5.5 遗漏明确行为要求的比例较低,并使用大语言模型裁判标记自我验证行为。讨论比较了提示是否阻止编写测试时,模型自行编写测试的频率。
一些开发者说排序与他们的体验一致;我觉得这很有意思,尽管我的工作经验尚未让我得出同样结论。我还指出展示的比较缺少 Composer 2.5,因此这些图表不能确定它会排在哪里。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 0:22EN → 简体中文
 45:08EN → 简体中文
 0:32EN → 简体中文
 1:02EN → 简体中文