30 秒看懂
Matthew Berman 用赛博朋克城市、鲁布·戈德堡机械装置、游戏和类 Excel 原型测试 Gemini 4 Argon。他看到了令人印象深刻的结果,也发现视觉缺陷与功能限制,并将公开基准与其他前沿模型作比较。
- 1赛博朋克城市简短提示生成了交互式 Three.js 动画,在 Berman 的测试中达到每秒 60 帧。
- 2鲁布·戈德堡机械装置交互式模拟运行成功,但仍有穿模和真实感问题。
- 3电子表格原型约 20 分钟生成的浏览器界面,在有限测试中处理了基本算术和 SUM。
- 4基准成绩图表显示 DeepSWE 和 Vibe Code Bench 成绩强劲,但 Terminal-Bench 低于 Opus 5.5。
要点建议
- Argon 制作了交互式 3D 场景和可玩的游戏,但真实感和碰撞处理仍需改进。
- 类 Excel 原型在快速测试中处理了基本公式;这并非完整的兼容性评估。
- 公布的编程和计算机操作成绩显示 Argon 有竞争力,但不同测试的结果有所差异。
- Box 的知识工作评测由视频赞助商提供。
按章节阅读整理后的全文
交互式 3D 测试
Argon 制作赛博朋克城市和鲁布·戈德堡机械装置。Berman 称赞其交互性,也指出视觉和物理问题。
我已经使用 Google 的 Gemini 4 Argon 大约一周,初步测试表明 Google 已经赶上前沿水平。我让它用 Three.js 制作详细的赛博朋克城市动画,包括霓虹灯、高楼和飞行汽车,目标是至少每秒 30 帧。
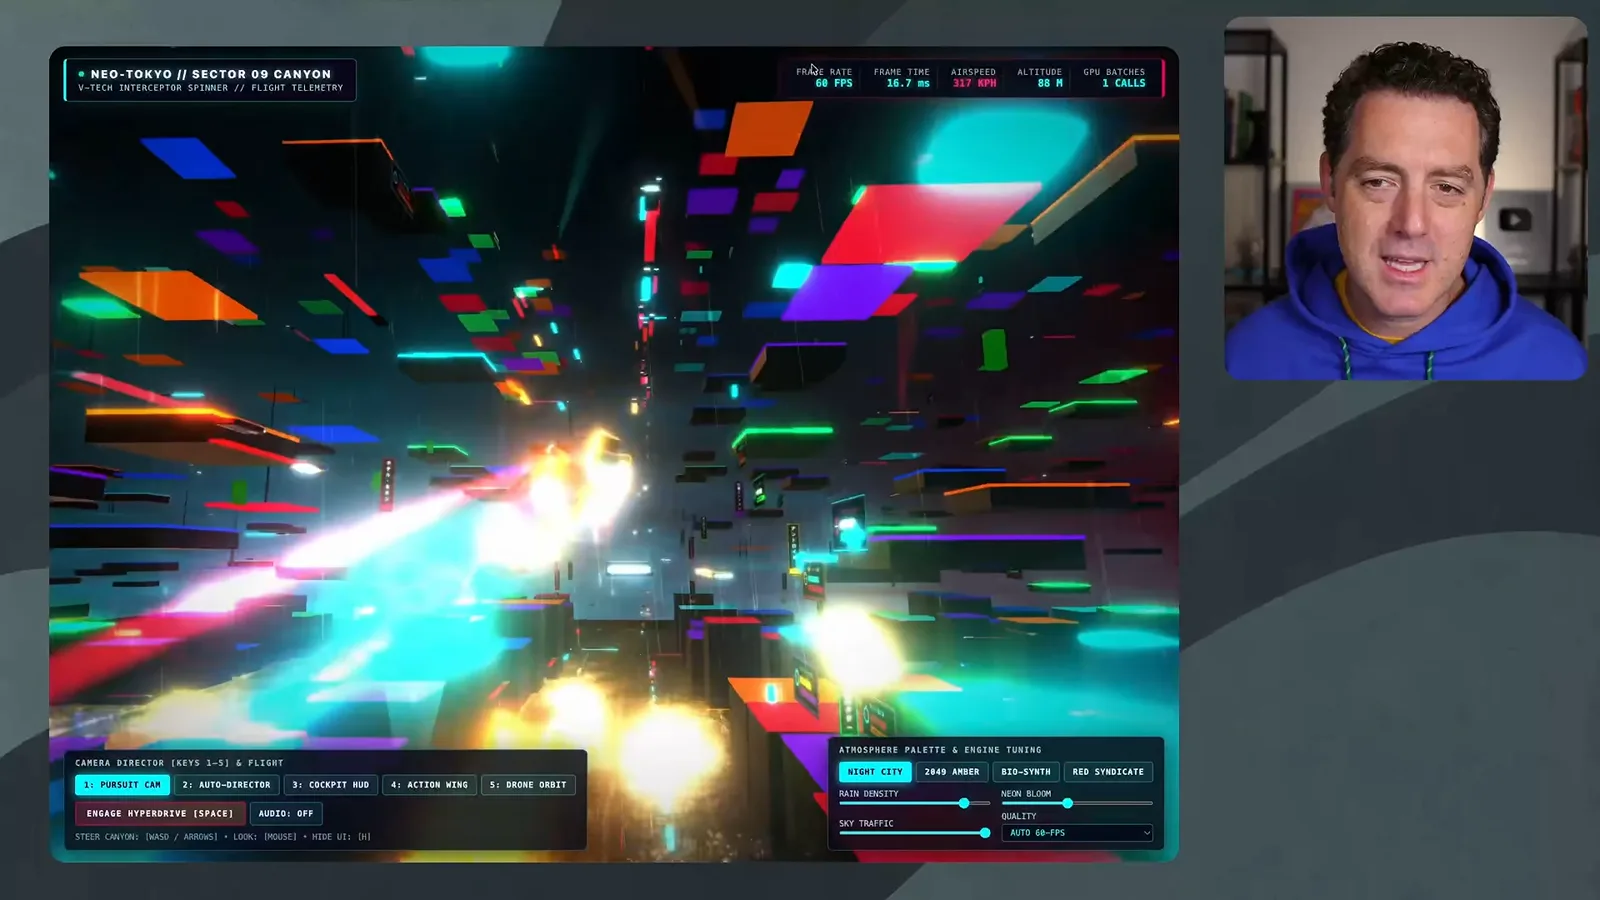
结果在我的浏览器里轻松达到每秒 60 帧,画面中有建筑、交通和动画效果。霓虹灯可能有点过量,但控件可以调整泛光、交通、画质和配色主题。一个简短提示大约 30 分钟就产生了这个结果;如果没有明确指定时间,Argon 往往会花这么久。
我认为 Argon 的 3D 作品还不如我见过的 Astra 和 Opus 最佳结果,不过在这项任务上比 Muse Wonder 更好。这是对这些特定视觉测试的判断,并不是说 3D 较弱的模型在广义编程上也一定不好。
一个 Three.js 鲁布·戈德堡机械装置看起来很出色,而且可以交互:我能移动镜头、启动球、改变速度并单独运行各个阶段。球曾卡住一次,我也看到了穿模,但多米诺骨牌和弹球效果运行良好。制作约花了 30 分钟。
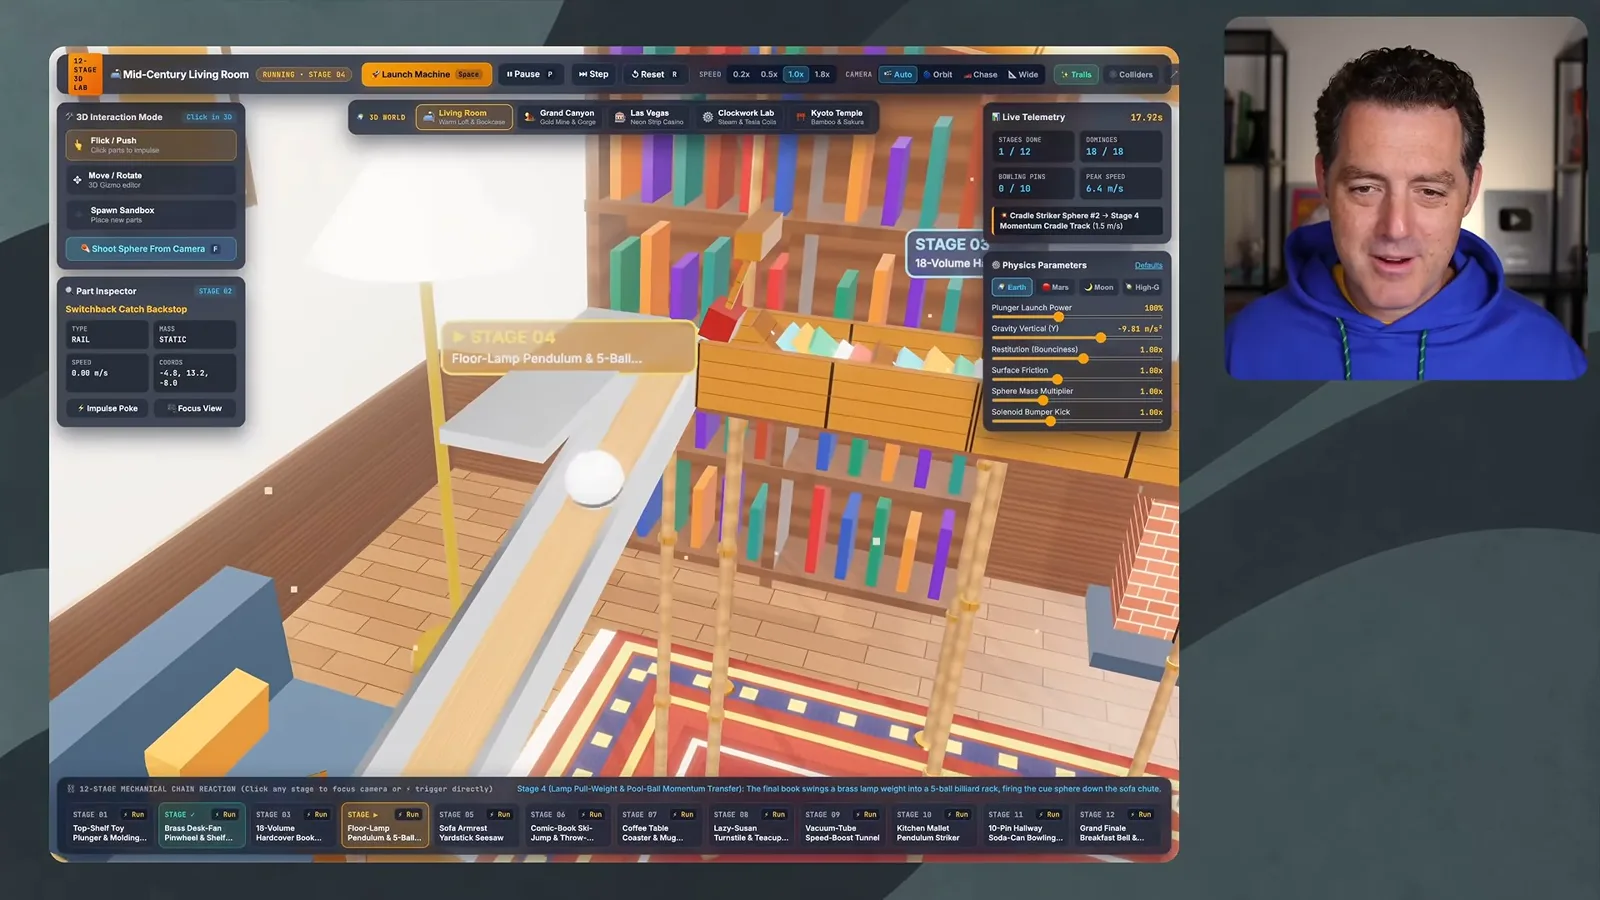
我要求它增加复杂度,并加入客厅、大峡谷和拉斯维加斯等主题关卡。模型加入了主题,但尽管我多次要求超写实,它们看起来并不特别逼真。我想知道,换用 Unreal Engine 或 Blender 等环境是否能得到更好的视觉效果。
知识工作与游戏
赞助商 Box 展示知识工作成绩。Berman 迭代可玩的障碍游戏,并测试 Unreal Engine 船只。
视频合作伙伴 Box 测试了知识工作,包括从文档、电子表格、演示文稿和图片中提取信息。在其报告的数据集上,Argon 得分 85%,Gemini 3.1 Pro 为 71%。Box 是赞助商,这些结果来自它自己的评测,反映的是特定任务,并非所有可能用途。
我还制作了一个 Fall Guys 克隆游戏。关卡有趣且有挑战性,角色碰撞看起来不错。模型做出了可玩的游戏,不过画面仍有闪烁。最终动画的效果也很好。
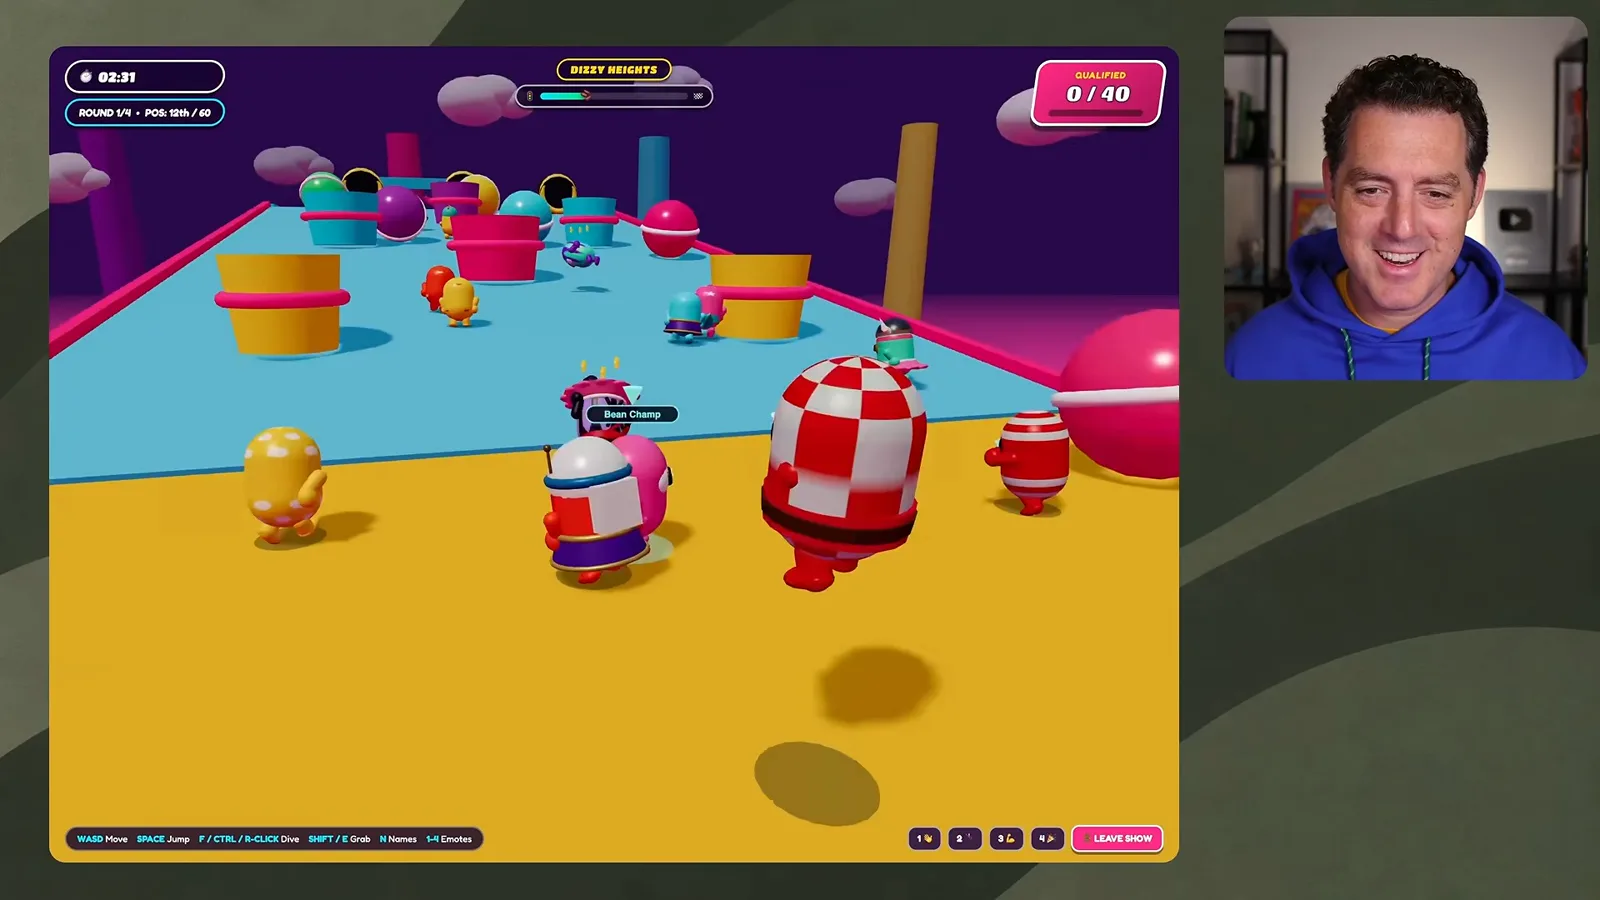
我先用简短提示要求制作功能对等的克隆,再设置目标,让它不断迭代,直到有十个复杂、有趣的关卡。我要求关卡更大,并改进滚动球等物体的碰撞处理。经过几轮迭代后,结果明显改善,我又将它与其他模型的作品作比较。
为了进一步测试 3D 能力,我让它在 Unreal Engine 中渲染海上的船。水面和波浪看起来不错,但有重复的纹理。与我测试过的其他模型生成场景不同,这个场景不能潜到水下。
电子表格原型与基准
快速制作的类 Excel 原型能处理基本公式。Berman 比较多个模型的编程与计算机操作基准。
接着我让 Argon 克隆 Excel,没有设置迭代循环。大约 20 分钟内,它查看了我电脑上的 Excel,并生成了一个看起来很像的浏览器界面。在我的快速测试中,基本算术和 SUM 公式都能运行,过程中虽出现了一个小输入错误。
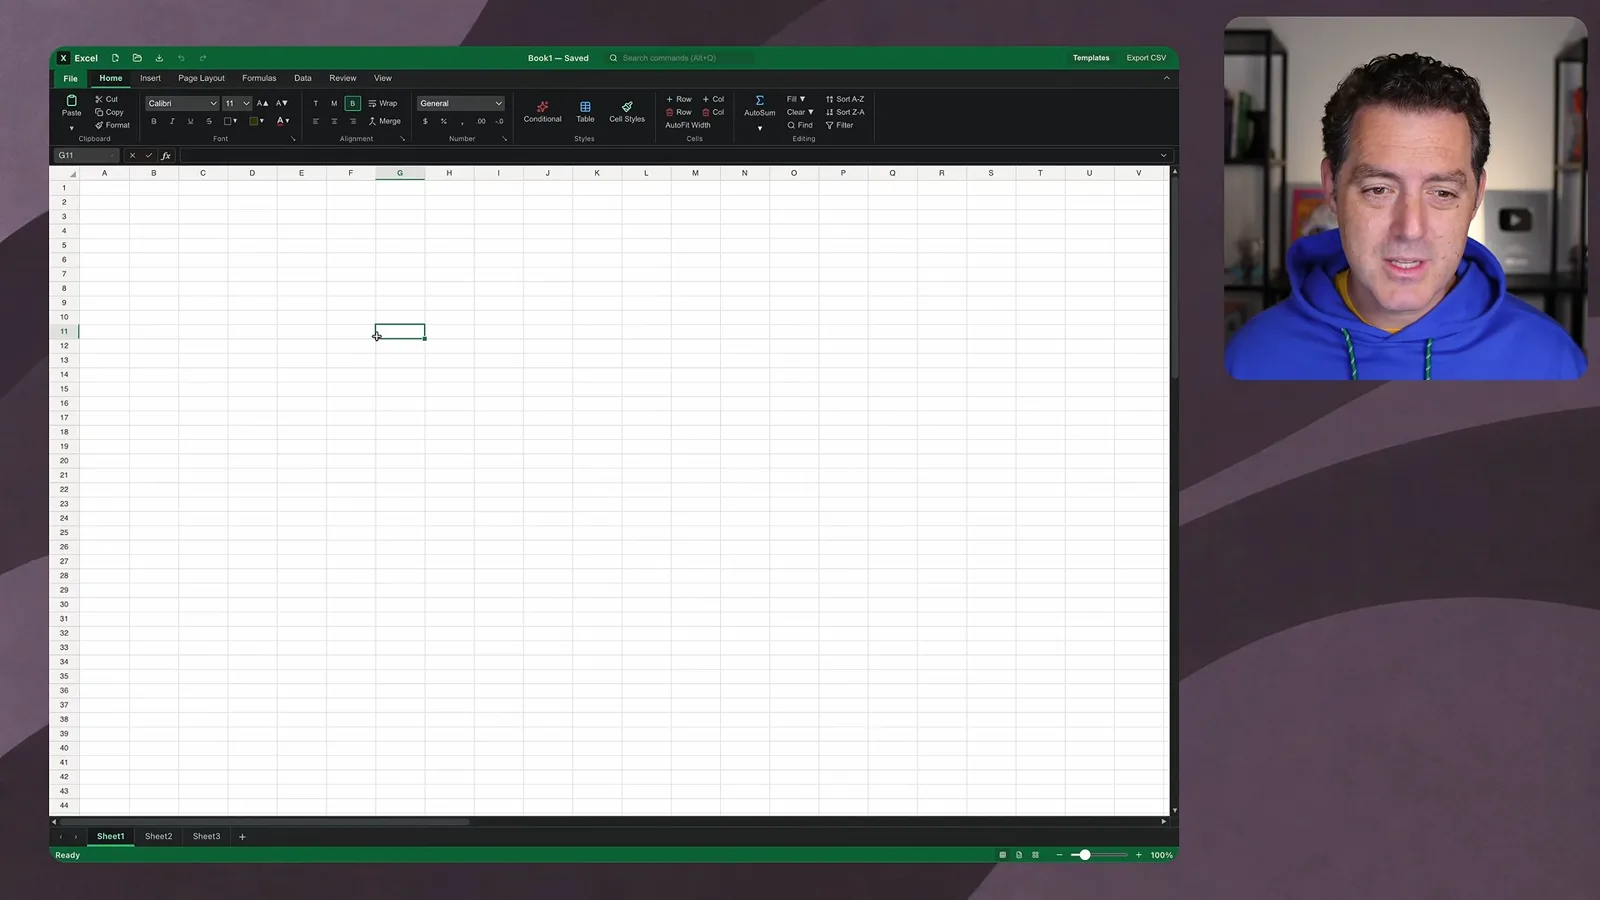
这个原型的制作速度让我觉得,软件代码本身将成为越来越弱的护城河。在我看来,产品需要提供无法仅靠要求模型复制界面就能复现的服务和价值。简短演示并不能证明它与成熟的电子表格产品完全兼容。
Google 的发布方式有些特别:它先公布模型和基准成绩,然后才让公众使用,同时让早期测试者和安全研究人员获得访问权限。基准图将 Argon 与几个领先模型作比较;我又加入了 Muse Wonder Full 和 GPT-6.1 Sol 的较新结果。
展示的比较中,Argon 在 DeepSWE 1.1 上得分 77.9,仅次于 Muse Wonder Full 的 79.0;Vibe Code Bench 得分为 91.9。它的 Terminal-Bench 4.0 得分为 57.4,低于 Opus 5.5 的 66.4 和其他一些模型。我认为这是强劲且有竞争力的表现。
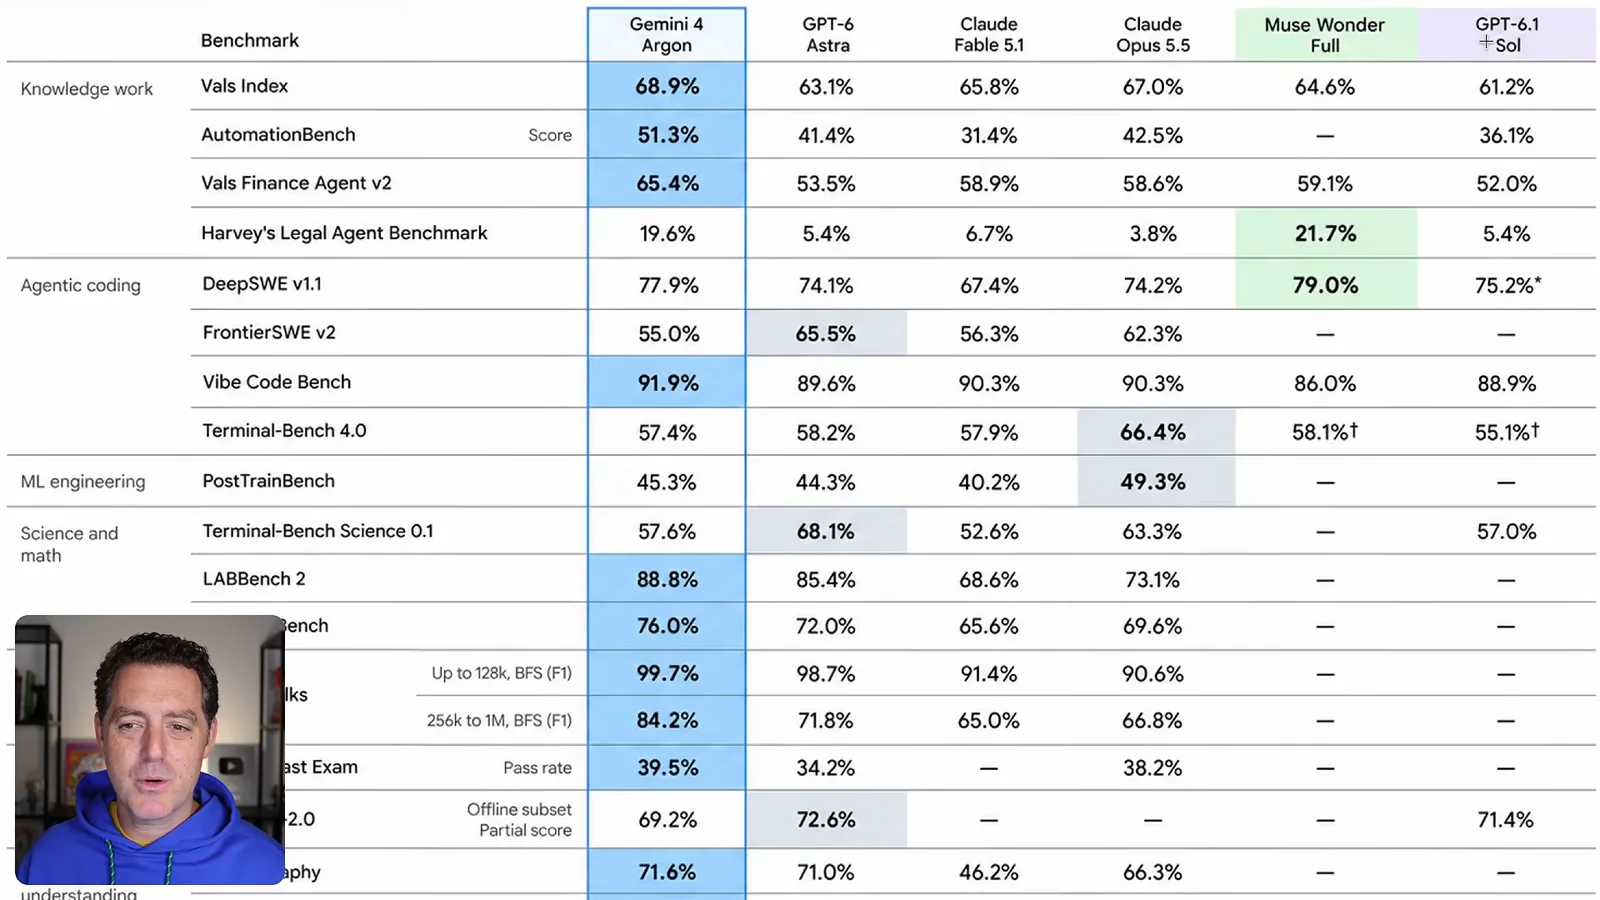
图中 Argon 的 OSWorld 得分为 69.2,接近 GPT-6.1 Sol 的 71.4;Agents’ Last Exam 得分约为 39.5。这些分数有助于比较,但选用什么基准和评测方法很重要。
我很高兴看到 Google、Meta、OpenAI 和 Anthropic 都推出了有竞争力的前沿模型。希望竞争能给用户带来更好、更快、更便宜的模型。目前,实际演示和公开基准都让 Argon 成为值得关注的模型。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 1:03:37EN → 简体中文
 0:53EN → 简体中文
 0:22EN → 简体中文
 45:08EN → 简体中文