30 秒看懂
Matthew Berman 通过基准和价格表评测 Gemini 3.8 Flash,随后展示团队测试的 3D 场景、产品页面、演示文稿、地形图和简单游戏。他认为模型以其价格具有竞争力,但不同任务表现不一致。视频还介绍了访问受限的网络安全版本;基准分数和价格均为当时展示的数字,取决于评测方法和推出条件。
- 1基准结果不一画面中的表格显示 DeepSWE v1.1 得分为 73.7%,其他部分评测的相对表现较低。不同基准测试不同任务,不能互换。
- 2初始价格与常规价格视频显示每百万输入 token 的初始价格为 0.75 美元、输出为 3.75 美元,常规价格分别列为 1.50 和 7.50 美元。
- 3表格读数纠正Berman 将 61.4% 归给 Harvey 法律基准,但屏幕表格将其列在 Vals Finance Agent v2 一行,Harvey 基准显示的是 10.0%。
- 4每项任务的成本如果模型为了完成任务消耗更多 token,较低的 token 单价不一定意味着较低的任务成本。
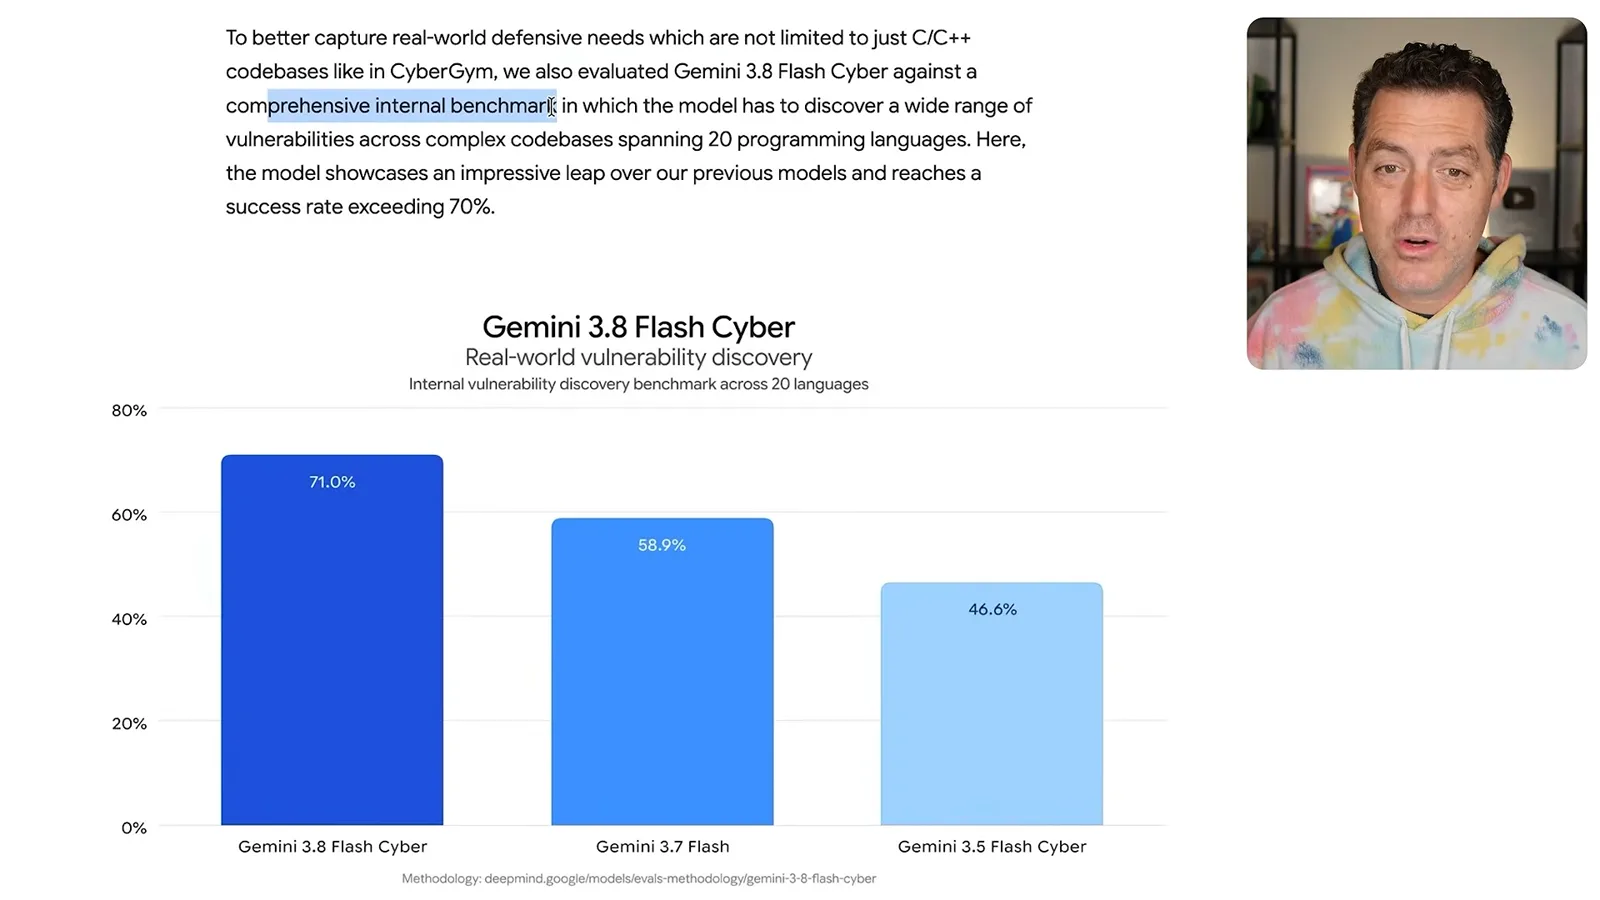
- 5网络安全版本Berman 介绍了受限访问和 Google 内部漏洞发现测试;画面中的比较只包括 Google 自家模型。
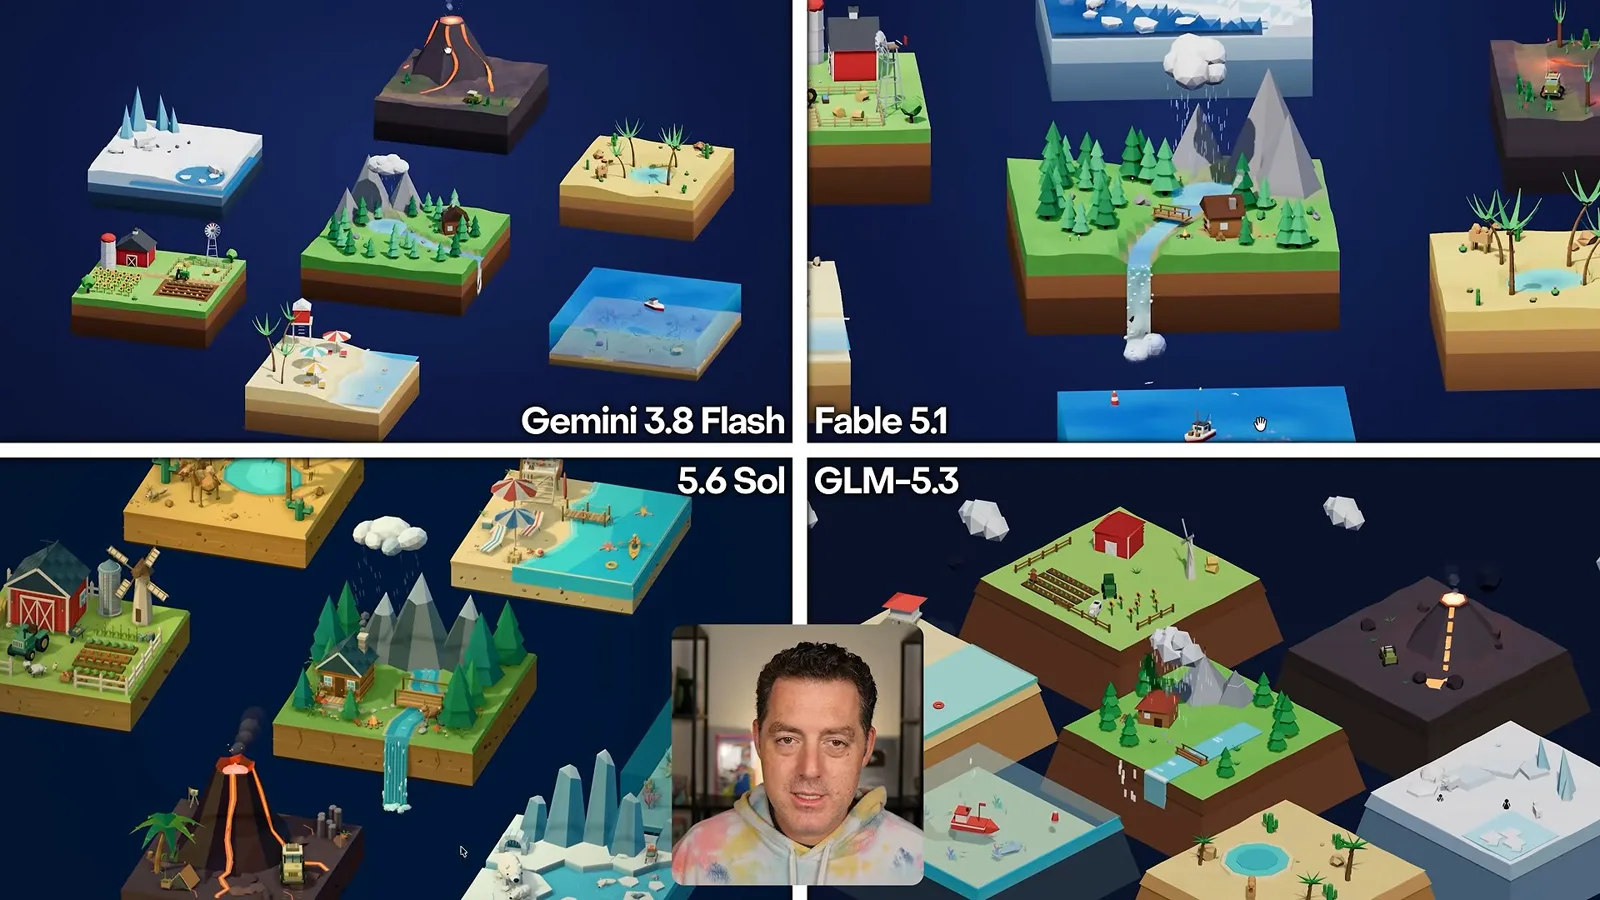
- 6实际测试结果各异3D 场景和交互式地形图令他印象深刻,但几个产品页面和演示文稿存在设计不足。
要点建议
- Berman 看好软件工程基准表现与较低初始 token 价格的组合,同时承认其他测试结果不一。
- 完成任务的成本既取决于 token 单价,也取决于消耗量。
- 视频表格将 61.4% 列为金融基准、10.0% 列为 Harvey 法律基准;口述混淆了二者。
- 网络安全版本的内部评测比较的是 Google 自家模型,不能证明它优于所有竞争者。
- 创意测试既产生了有用的界面,也出现明显的设计或渲染错误;组织应针对自己的任务进行评估。
按章节阅读整理后的全文
Gemini 3.8 Flash 的定位
Berman 评价 Google 近期模型,并介绍新模型的价格和表现。
Matthew Berman 在 Google Gemini 3.8 Flash 于 2026 年 9 月发布后不久对其进行评测。他认为模型实用且成本具有竞争力,但在不同基准和实际任务中的表现各异。比较和价格反映的是视频拍摄时的情况。
基准与定价
他比较编程、知识工作和智能体评测,并指出初始价格不同于常规价格。
Berman 首先介绍 DeepSWE v1.1,这是他认为有意义的长时程软件工程基准。视频表格显示 Gemini 3.8 Flash 得分 73.7%,接近表中 Claude Opus 5 的 74.0%。相比之下,它在知识工作 GDPVal-AA 上的相对得分较低。不同基准和评测设置衡量的是不同能力。
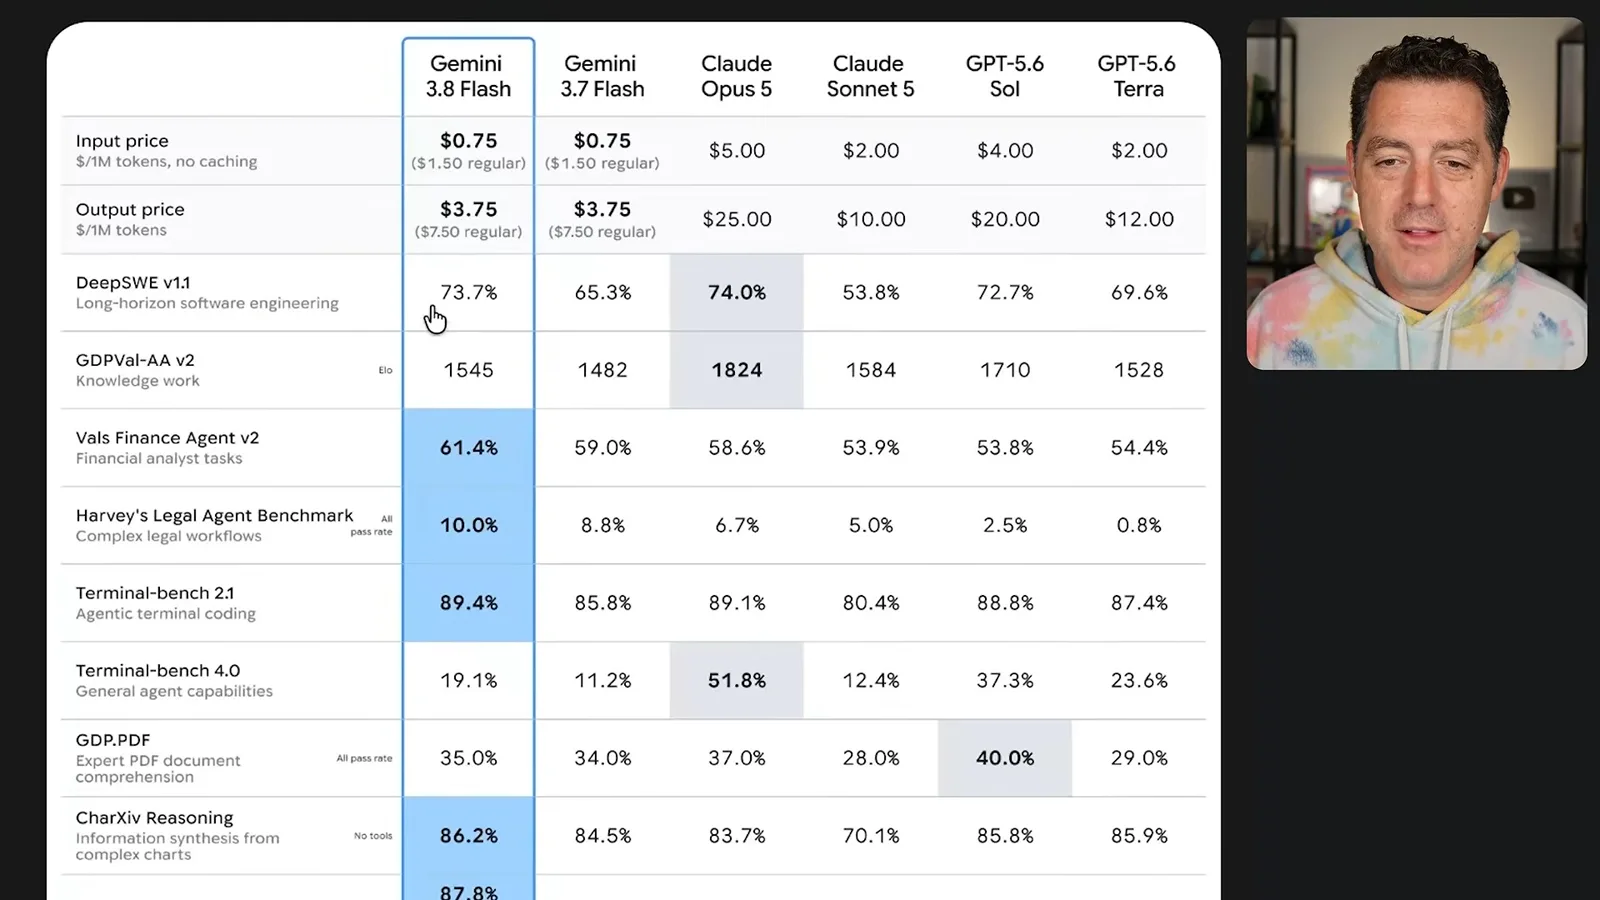
画面显示,初始价格为每百万输入 token 0.75 美元、输出 3.75 美元。Berman 指出表中还列出 1.50 美元和 7.50 美元的常规价格,并表示初始价格计划在 2026 年底到期。他批评临时价格比常规价格更醒目。
Berman 讨论法律和金融基准,并建议组织根据实际任务建立自己的评测。他在口述中将 61.4% 归给 Harvey 法律基准,但表格将 61.4% 列在 Vals Finance Agent v2 一行,Harvey 法律智能体基准则为 10.0%。单凭任何一个分数都不能确定模型适合用于法律或金融决策。
表格显示 Terminal-Bench 2.1 得分为 89.4%,Terminal-Bench 4.0 则为 19.1%;Berman 称后者是更新、更难的评测。他还讨论了 Humanity's Last Exam 和 OSWorld 的成绩。他的主要观察是表现不均:一个测试成绩好,不代表另一个也好。
成本效率与网络安全
他讨论每项任务的成本及访问受限的网络安全版本,包括 Google 的内部评测。
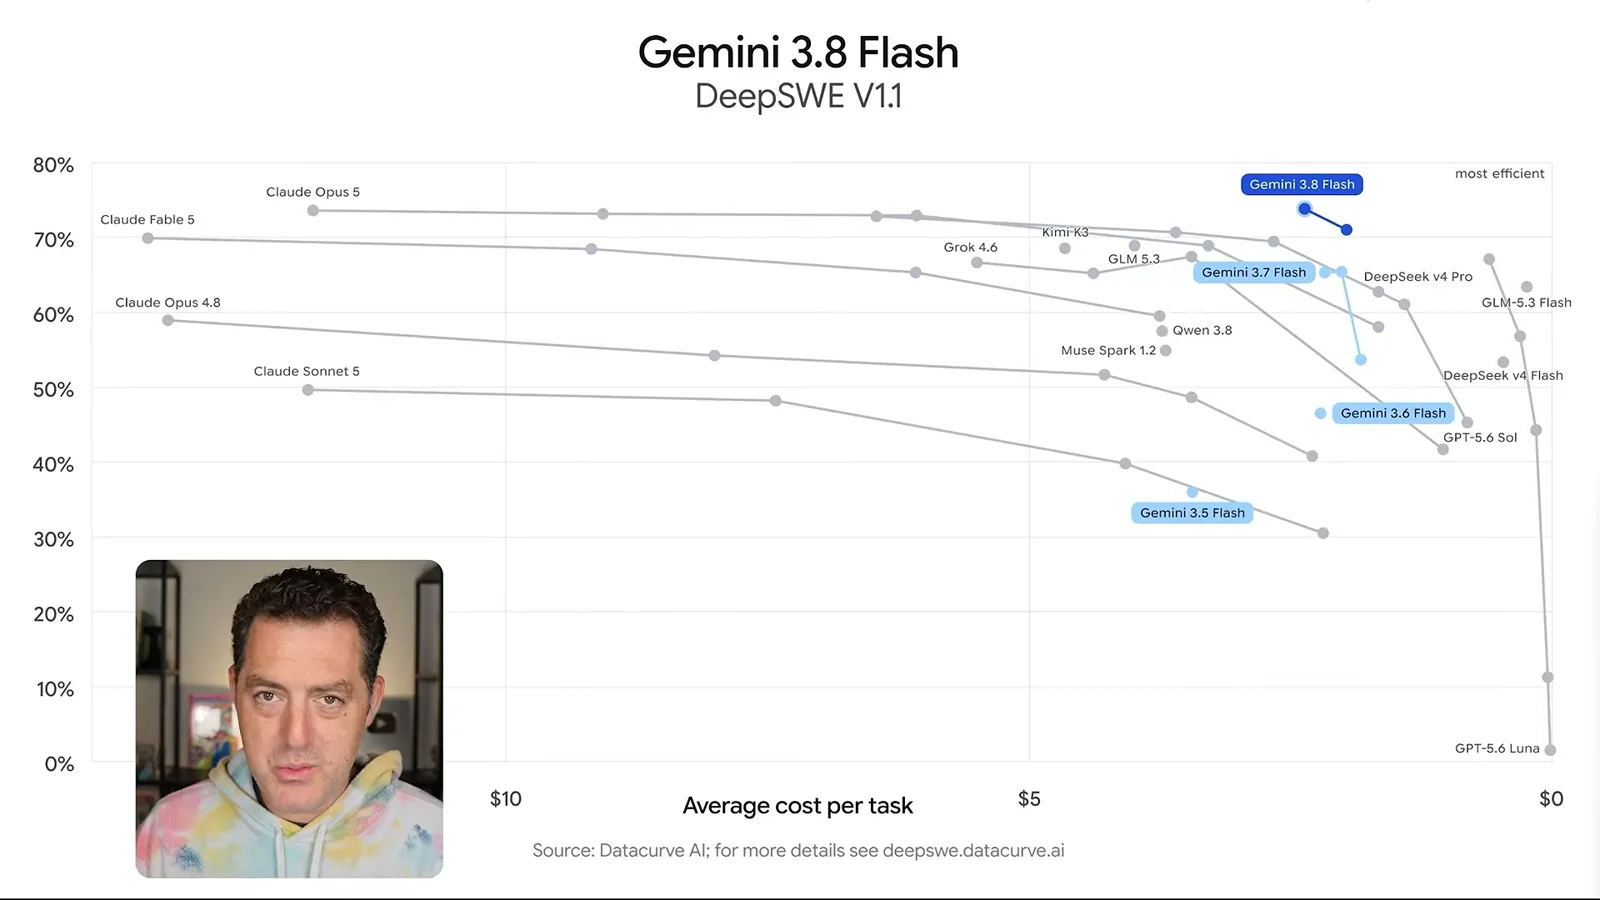
一张 DeepSWE 图表将表现与每项任务的平均成本作比较。Berman 强调 token 单价只是计算的一部分:价格更低的模型如果消耗更多 token,完成任务的成本也可能相同。图表反映的是该评测的工作负载和设置,不是普遍适用的价格排名。
Google 还宣布了 Gemini 3.8 Flash Cyber。Berman 将它描述为面向网络安全的版本,通过受限计划向获批准的防御人员开放。他引用 CyberGym 结果,并解释 Google 还在内部基准中测试了跨 20 种语言的漏洞发现能力。
内部图表将新网络安全版本与早期 Google 模型比较,而没有比较其他公司的模型。Berman 认为进步显著,但内部基准和受限访问限制了外部读者对特定安全环境中表现的推断。
3D 场景与产品网站
Berman 比较生成的视觉场景,并检查多个交互式产品页面。
在实际测试中,Berman 要求模型创建七个低多边形 3D 生物群落,并与其他模型的输出比较。他喜欢海滩和农场,但认为细节不及自己更喜欢的对照结果,还发现了渲染问题,包括水面伸出冰雪场景边界。
下一项测试生成产品网站。苹果商店页面对他来说过于简单,结账流程也令人困惑。一个计算产品页面更好,并包含互动数值,但他注意到文字被裁切。这些是对所展示具体输出的主观比较。
橡皮鸭页面令他失望;折叠手机页面有互动铰链,但手机渲染不够逼真。Model Y 配置页面画车的效果也不好,却允许更改选项,并包含他喜欢的动画。他认为网站整体表现与一个对照模型相当或略逊。
演示文稿、地形图与游戏
幻灯片、交互式珠峰可视化和简单游戏构成了最后的实际测试。
随后 Berman 检查一份生成的数据中心演示文稿。它使用了 Forward Future 的品牌元素,结构也合理,但他认为视觉设计一般,表示如果特别重视演示设计会选择其他模型。他没有对整份文稿进行详细事实核查。
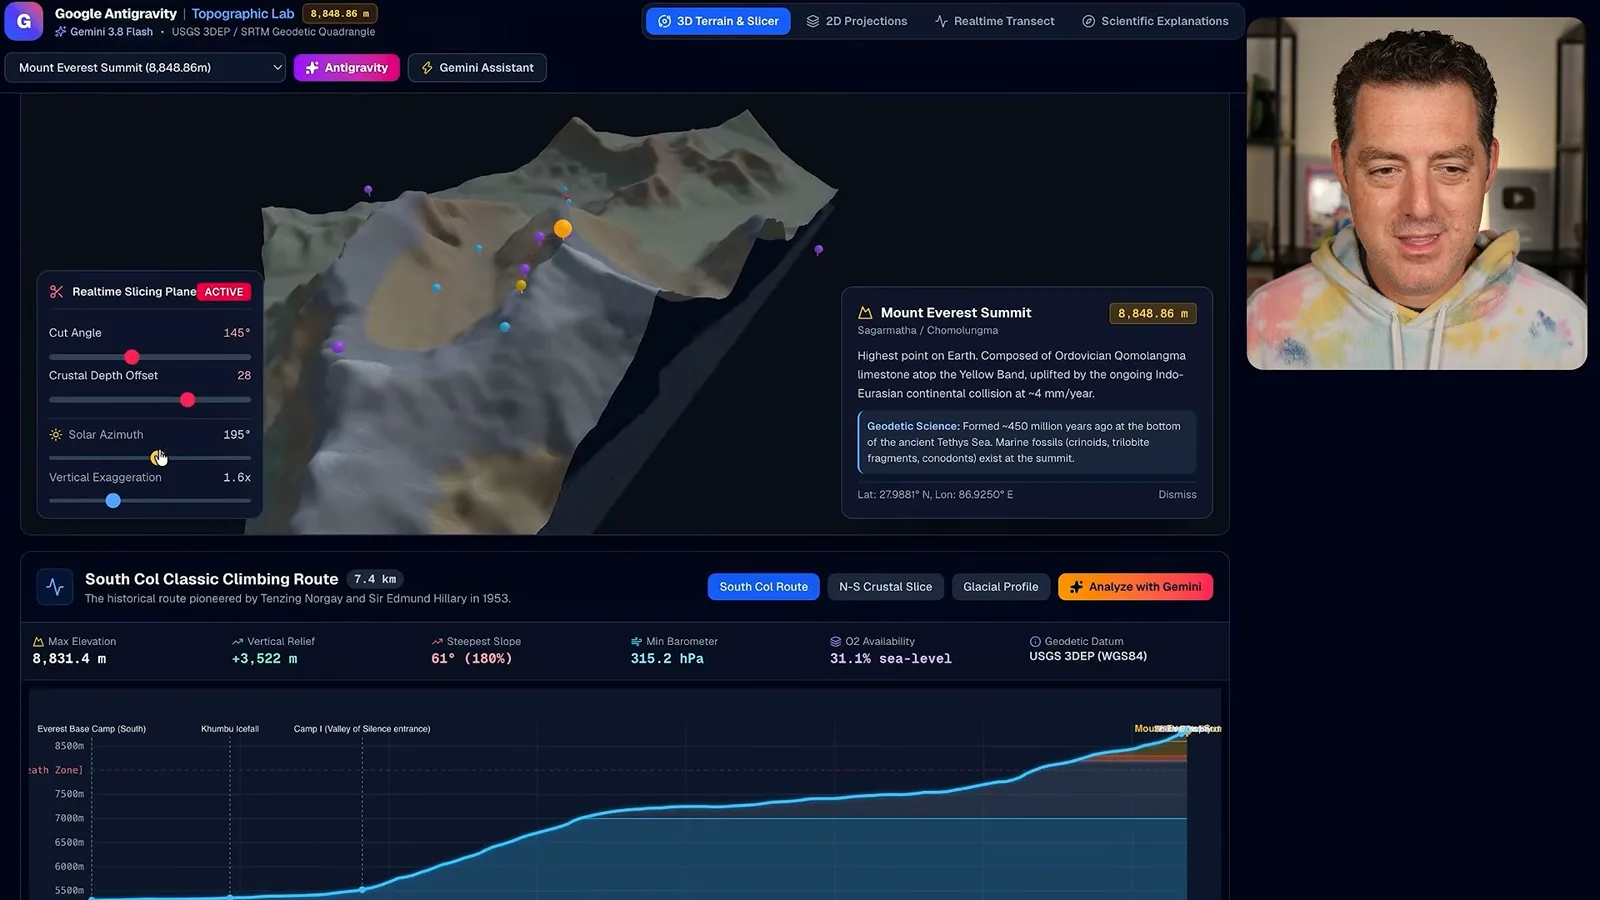
一位团队成员制作的交互式珠峰地形图给他留下更深印象。他旋转和缩放地形,改变切面角度与垂直夸张比例,并查看标记地点和二维视图。他指出自己没有同等测试输出可以比较。
一个根据提示生成的简易类 Doom 游戏可以玩,但较为基础。Berman 总结说,模型并非每项任务都最强,但以其价格具有竞争力;他建议根据目标用途测试输出,而不是只依赖某一个醒目的基准分数。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 45:08EN → 简体中文
 0:32EN → 简体中文
 12:14EN → 简体中文
 10:36EN → 简体中文