30 秒看懂
GPT-6.2 Astra 构建逼真的东京场景时需要反复指导,却诊断出困扰 Matthew Berman 团队 18 个月的录制问题。这位早期测试者说,他总体更喜欢 Anthropic 的模型,但认为 Astra 擅长计算机操作和视频剪辑。他还说 OpenAI 在发布前做了部分测试者没有重新测试的修改,并展示了 GPT 模型以较低报告成本生成出色结果的公开演示。
- 1Berman 认为 Astra 能力不错,但整体更喜欢竞争模型他说计算机操作是主要例外,并将模型质量与订阅额度一起考量。
- 2Astra 需要反复提示才能修正东京建筑模型起初将卫星图像贴到立面上,导致门窗位置错误,之后才直接建造建筑。
- 3计算机操作帮助诊断持续 18 个月的录制问题Berman 说,Astra 检查 OBS 日志并强制开启缓冲设置,解决了掉帧问题。
- 4模型的最后修改可能解释部分评价分歧一位 OpenAI 员工认为早期测试者没有重新测试近期修改;Berman 说自己未收到更新通知。
- 5Astra 在 Berman 的早期开源应用中剪辑对话他说,Scarlet 的剪辑功能由 Astra 驱动,已接近一次处理完整视频。
- 6公开演示呈现不同质量和报告成本之间的取舍Berman 比较了多个模型生成的场景和游戏,其中一些 GPT 模型的成本低得多。
要点建议
- Berman 说,Astra 通过检查 OBS 实时日志并强制开启缓冲设置,解决了掉帧问题。
- 仔细检查视觉输出并继续指导:初看合理的建筑立面也可能隐藏错误。
- 个别演示显示报告成本差异很大,应结合价格和任务比较质量。
- Berman 认为部分早期评价可能没有反映最后的模型修改,并计划重新测试。
- 根据 Berman 的经验,Astra 在其早期应用 Scarlet 中的对话剪辑表现良好。
按章节阅读整理后的全文
为什么早期评价和公众印象不同
Berman 认为 Astra 能力不错,尤其擅长计算机操作。他将它与 Anthropic 的模型比较,并考量订阅额度。
OpenAI 发布了 GPT-6.2 Astra 和 Sol,早期反应颇有争议。我是早期测试者之一,很多人报告体验不佳,而一些使用公开版本的人发布了积极得多的演示。我想解释自己测试了什么,以及这些差异可能来自哪里。
经过大量测试,我认为 Astra 是一个合格但不算突出的模型,有一个重要例外:计算机操作。它可以构建游戏、应用和三维城市模拟,但在我的比较中,许多任务上我更喜欢 Anthropic 的 Opus 和 Fable。
选择还取决于预算和使用额度。我以前更喜欢 OpenAI 订阅,因为额度更高;但我认为 Anthropic 如今提供的使用量已经足够,因此我会改选它。这反映的是我当前的体验,不是适用于所有人的固定规则。
展示演示之前,我需要说明,运行许多测试的电脑坏了。我恢复了一些例子,但最想给大家看的那个没有找回来:一个类似《战争机器》的游戏。
构建东京场景需要多次修正
Astra 建造建筑并使用下载的素材。它起初采用的立面捷径需要反复提示才能纠正。
我让 Astra 使用 Unreal Engine 构建东京的三维复制场景。它的计算机和浏览器操作能力适合这项任务。它自己建造建筑,同时下载标志等素材,但最终版本经过了多次迭代。
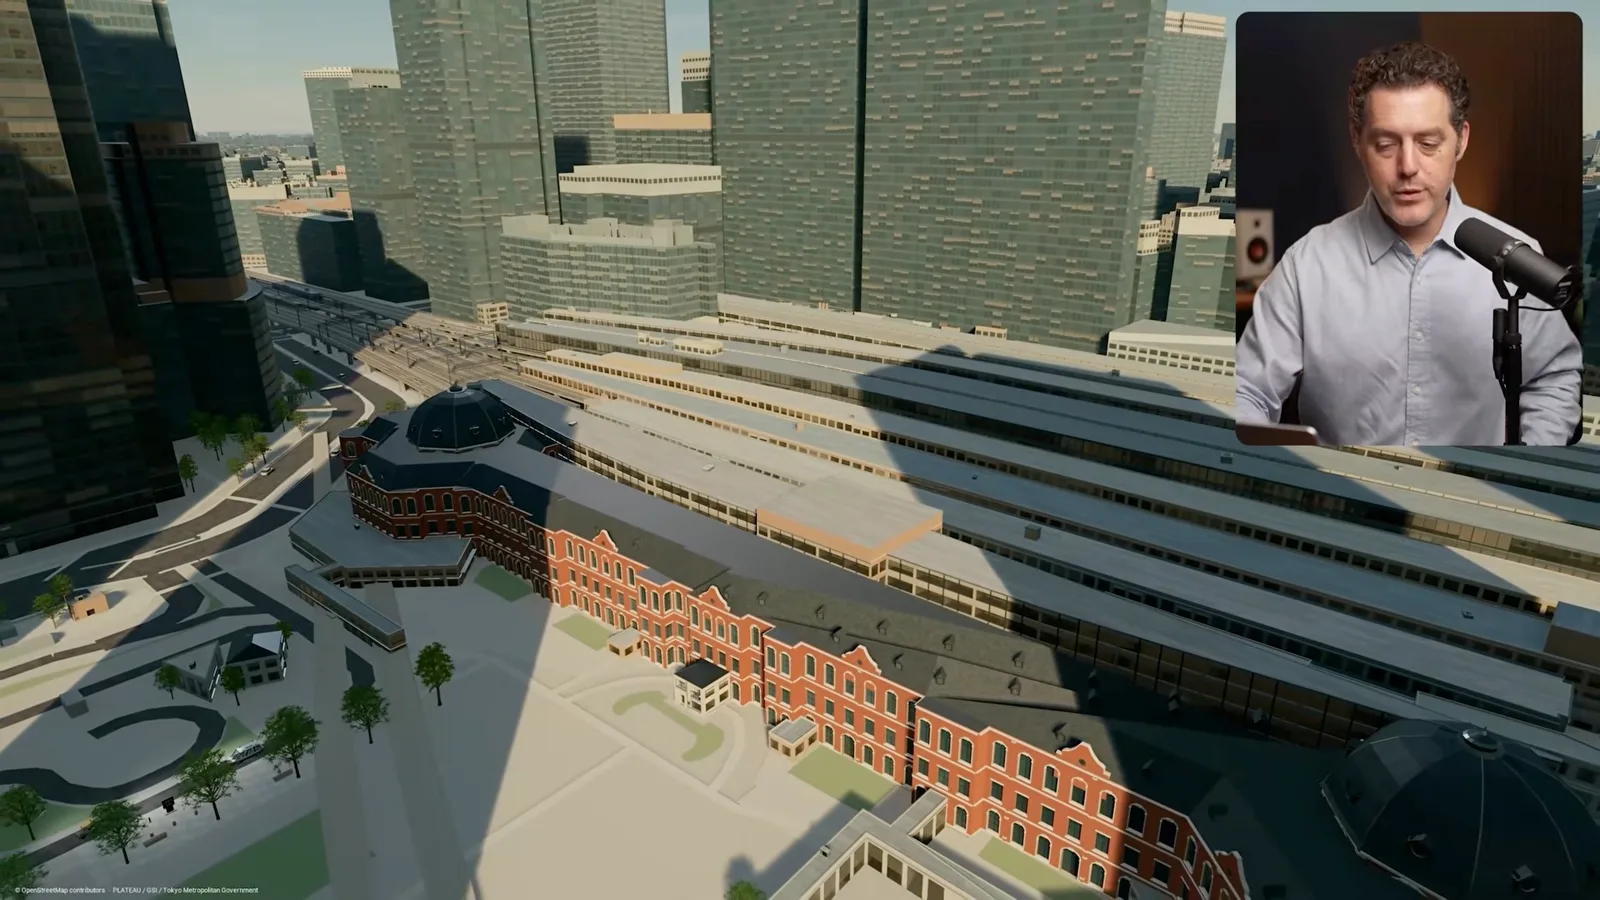
起初模型将卫星图像贴到建筑立面上。远看似乎合理,仔细看却发现门窗位置错误。我不得不反复提示它直接建造结构;这种难以遵从看似明显的指示的情况,是早期测试者感到沮丧的原因之一。
找到录制掉帧的原因
Berman 说,Astra 检查 OBS 日志并找到了一个缓冲设置。此前更换设备和寻求外部帮助都没有解决问题。
另一项任务说明我为什么仍对这个模型印象深刻。我的团队花了大约 18 个月,试图诊断视频偶尔掉帧的问题。更换摄像机、HDMI 线和电脑,询问其他模型以及咨询人类专家,都没能解决。
我录制视频时,Astra 检查了摄像机、输入信号和 OBS 录制日志。它发现一个缓冲设置虽然设为自动,却一直关闭;强制打开后,我们的问题解决了。操作电脑并检查证据的能力,让这次结果很有价值。
早期测试反馈与最后时刻的更新
多位测试者报告了负面体验。Berman 讨论了据称临近发布时的模型更新,并说自己在发布前没有收到通知。
我是 OpenAI 早期测试计划的成员。公司提供模型供我们测试,接受批评性反馈,但不付费让我们参加。发布后,许多成员分享了负面体验;我遇到的问题没有一些人那么多,尽管我仍认为这些模型不如 Anthropic 的竞争产品。
Matt Shumer 最初说体验太差,不打算写完整评价,之后在读者要求下发表了负面评测。Theo 也说自己讨厌 Astra,并解释了原因。我的构建测试也出现了类似问题,但进一步提示往往能让任务完成。
另一位测试者 Paul Solt 报告说,摘要不清晰、任务过早停止、模型执着于错误问题,以及 iOS 界面制作较弱。他也指出视频剪辑更强、成本更低。Dan Shipper 同样认为这次发布相比 Fable 令人失望。
OpenAI 员工 Thibault Sottiaux 提出了评价分歧的一个可能原因:早期测试者已经使用模型一段时间,但团队在最后三四天做了修改,他认为部分评测没有重新测试这些变化。他也承认审美和易用性仍有问题。
就我而言,这个说法大体属实:除了视频剪辑,我最近没有测试太多其他任务;失去部分信任后,我也常用 Opus 检查模型的工作。但测试者通常会收到模型变更通知;这次我没有收到更新通知,也没有得到通常会有的发布预告。
视频剪辑与公开模型比较
Berman 说 Astra 在他的剪辑应用中表现良好。他查看了若干视觉演示和竞争模型报告的耗时、成本。
视频剪辑是我使用中表现突出的领域。Astra 已经为我正在构建的开源应用 Scarlet 提供了数周的剪辑能力。我的测试显示它剪辑对话效果很好,已接近一次完成整段视频的剪辑,虽然应用还处于早期、比较粗糙。
其他用户发布的视觉演示让我想再给 Astra 和 Sol 一次机会。在一次四模型场景生成比较中,测试者报告 Astra 用时约 45 分钟、花费 9 美元,Sol 用时 30 分钟、花费 2 美元,Fable 用时约 3 小时、花费 200 美元,Opus 用时近 3 小时、花费 31 美元。
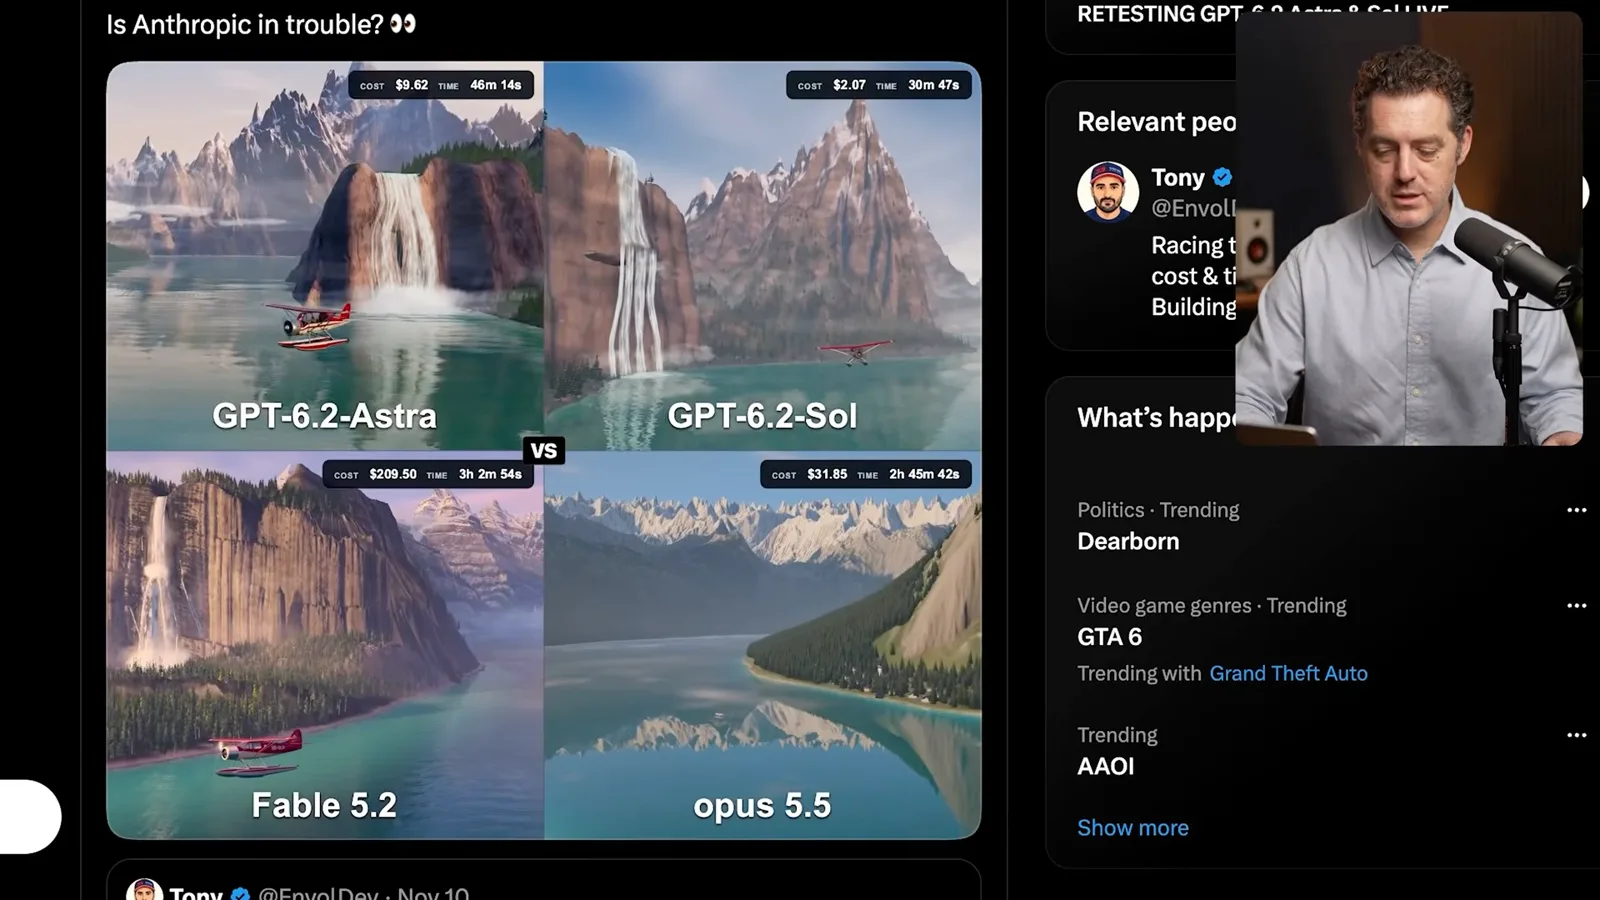
只看生成风景的外观,在那个例子里我更喜欢 Fable,Astra 也有竞争力。我觉得四个结果都不差。另一个示例展示了积水倒影的恐怖游戏,还有一个光照出色的日本寺庙场景。
这些公开演示与早期评价形成对比,让我觉得发布过程本可以处理得更好,特别是如果最后一次更新实质改变了模型表现。在另一次比较中,Astra 的场景更像卡通,Fable 的更逼真,但我觉得两者都不错。
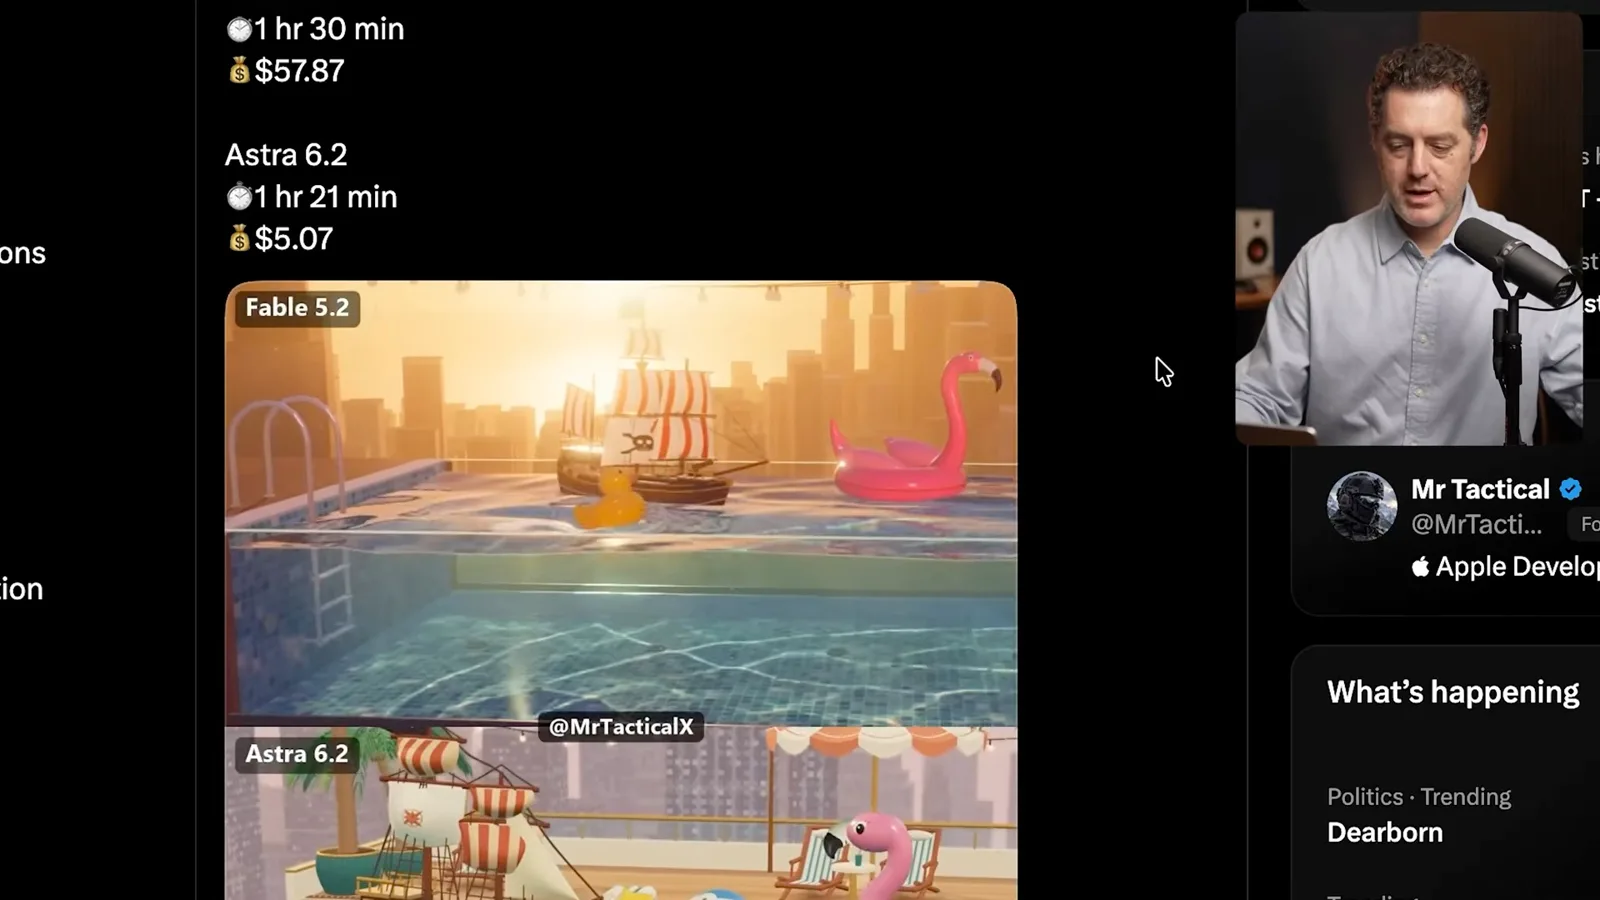
那位创作者报告,Astra 一次运行花费约 5 美元、耗时 81 分钟,而 Fable 花费近 60 美元、耗时 90 分钟。质量差异是否值得数倍成本,取决于任务和用户的优先事项。
我也喜欢一个一次生成的 Doom 风格游戏,以及另一组并排场景:Astra 花费约 8 美元、耗时 40 分钟,Fable 花费 81 美元、耗时近两小时。这些例子暗示成本差异反复出现,尽管它们只是个别演示。
我认为 Astra 是一个不错的模型,并打算重新测试。我还推测,Anthropic 近期的模型进展反映了递归自我改进的开始,并请观众参考我在另一段视频中讨论的外部研究。
同频道的其他文章
 56:20EN → 简体中文
 Matthew Berman· 2026年11月12日语言模型如何从文本学习并通过试错改进Matthew Berman, Jeremy Berman · Forward FutureAnthropic 研究员 Jeremy Berman 从公寓价格讲起,解释神经网络、语言模型和强化学习。
 18:18EN → 简体中文Matthew Berman· 2026年11月11日Fable 5.2 领跑本周模型发布,但成本影响选择Matthew Berman · Forward FutureMatthew Berman 对比 Fable 和 Gemini Carbon,评测较小模型,并讨论 Nvidia 的调查。
 24:18EN → 简体中文Matthew Berman· 2026年11月9日Fable 5.2 制作了可玩的演示,但部分项目成本达数千美元Matthew Berman · Forward FutureMatthew Berman 展示游戏、创意软件和模拟项目,估算 API 成本从 25 美元到 1.5 万美元不等。
 20:08EN → 简体中文Matthew Berman· 2026年11月7日METR 发现 Anthropic 的 AI 研发加快,但仍有很大不确定性Matthew Berman · Forward FutureMatthew Berman 解读一份独立评估,关注 AI 对研发的帮助以及评估人员获取证据的限制。
 19:53EN → 简体中文Matthew Berman· 2026年11月5日AI 新闻:Kimi K3.1 权重、计算机操作与专用开放模型Matthew Berman · Forward FutureMatthew Berman 回顾一周的模型发布,涵盖桌面智能体、科学工作流以及图像、视频和语音工具。
 26:47EN → 简体中文Matthew Berman· 2026年11月4日权重空间编程实验说明了什么,以及它的局限Matthew Berman · Forward FutureMatthew Berman 解读前沿模型读取、修复和编写其他网络权重的实验,涵盖小型游戏策略和语言模型的定向修改。