30 秒看懂
Matthew Berman 说,在他的测试中,Claude Fable 5.2 的能力优势比它相对 Gemini 4 Carbon 的基准分领先幅度更明显,但他也指出 Fable 成本更高,而 Carbon 的演示有实用价值。他介绍了开放权重和适合处理委派任务的小模型、图像与视频新产品,以及模型质量和任务成本之间的权衡。他还讨论了 Nvidia 针对涉及 CEO Jensen Huang 的报道展开的独立调查。
- 1Nvidia 董事会调查涉及其 CEO 的报道Berman 讨论了可能的影响,并认为需要调查厘清事实。
- 2Berman 认为实际使用差距比指数显示的更大他对比 Fable 5.2 和 Carbon 的分数、决策及自己的使用体验。
- 3最高基准分伴随着更高的任务成本他说,对于不需要最昂贵模型的工作,Carbon 可能适用。
- 4较小模型可以较低成本处理委派任务他对比 Muse Ember 和其他小模型,并介绍规划模型加执行模型的方式。
要点建议
- 将基准成绩与自己任务中的实际表现对照。
- 除了模型的总分,也要考虑每项完成任务的成本。
- 不需要最强模型时,可以考虑用较便宜的模型处理合适的委派任务。
- 有关情报行动的报道仍有待 Nvidia 的独立调查厘清。
按章节阅读整理后的全文
Nvidia 调查和模型对比
Berman 讨论公司的调查,随后对比 Fable 5.2 与 Gemini Carbon。
Nvidia 董事会正在调查有关 CEO Jensen Huang 成为外国情报行动目标的报道;Huang 此前承认了一段婚外关系。我讨论了此事可能对公司造成的影响,并认为需要通过调查弄清事实。
Claude Fable 5.2 和 Gemini 4 Carbon 相继发布。独立基准结果显示 Fable 领先,但我自己的使用体验中感受到的质量差距比综合分数显示的更大。
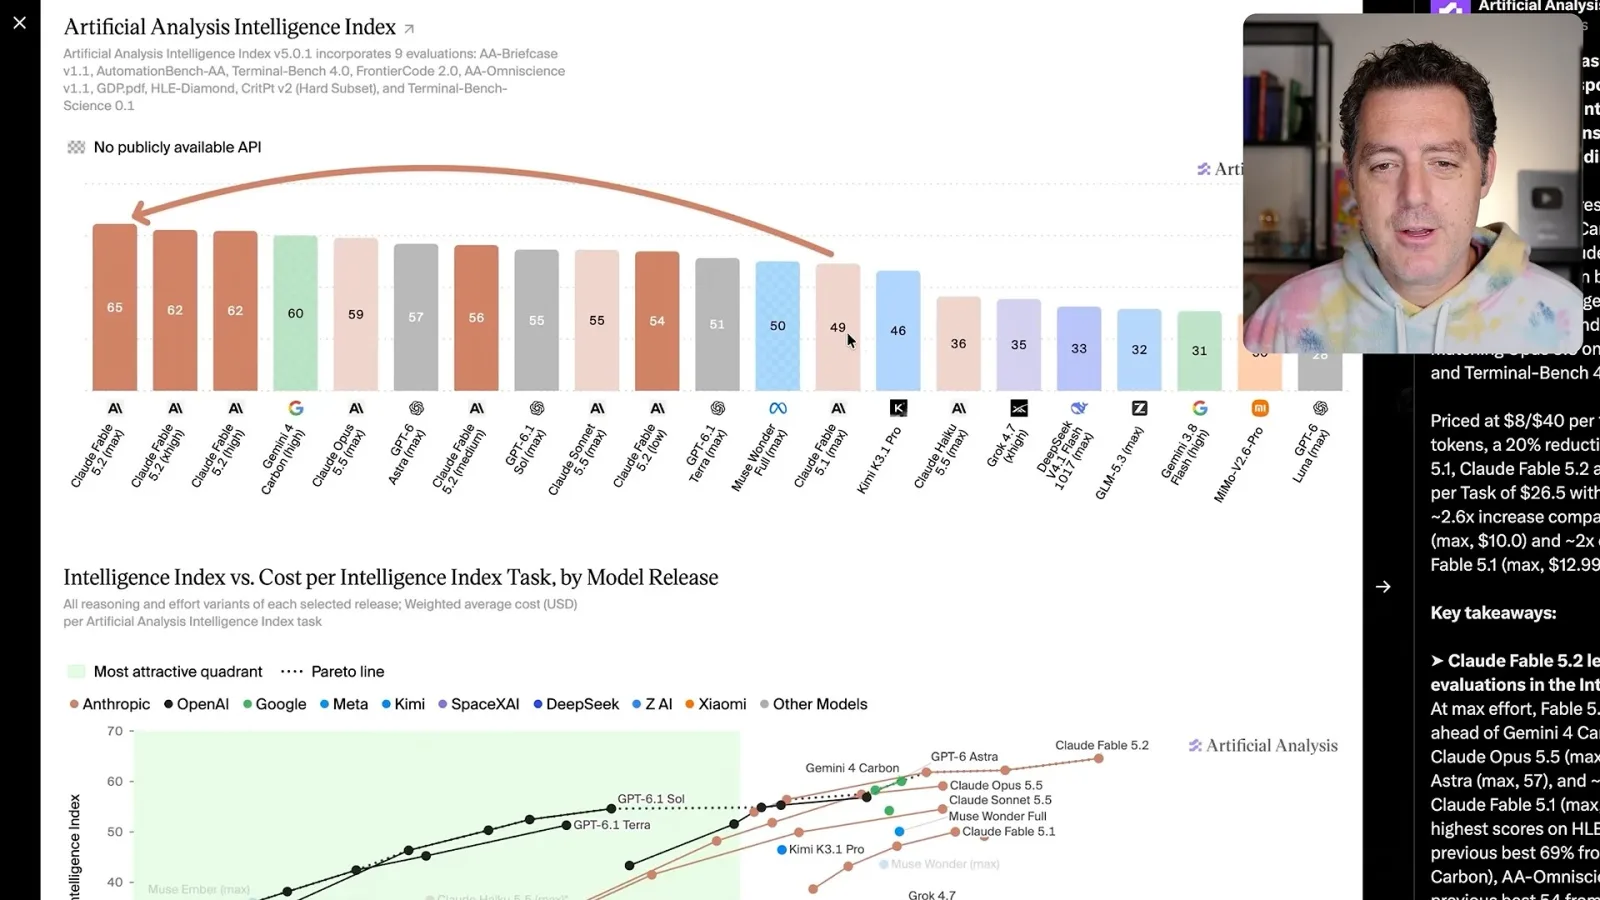
Artificial Analysis 指数将多个 Fable 版本排在前列,Carbon 紧随其后。我质疑这个基准是否反映了我在决策、假设和执行任务时看到的差异。
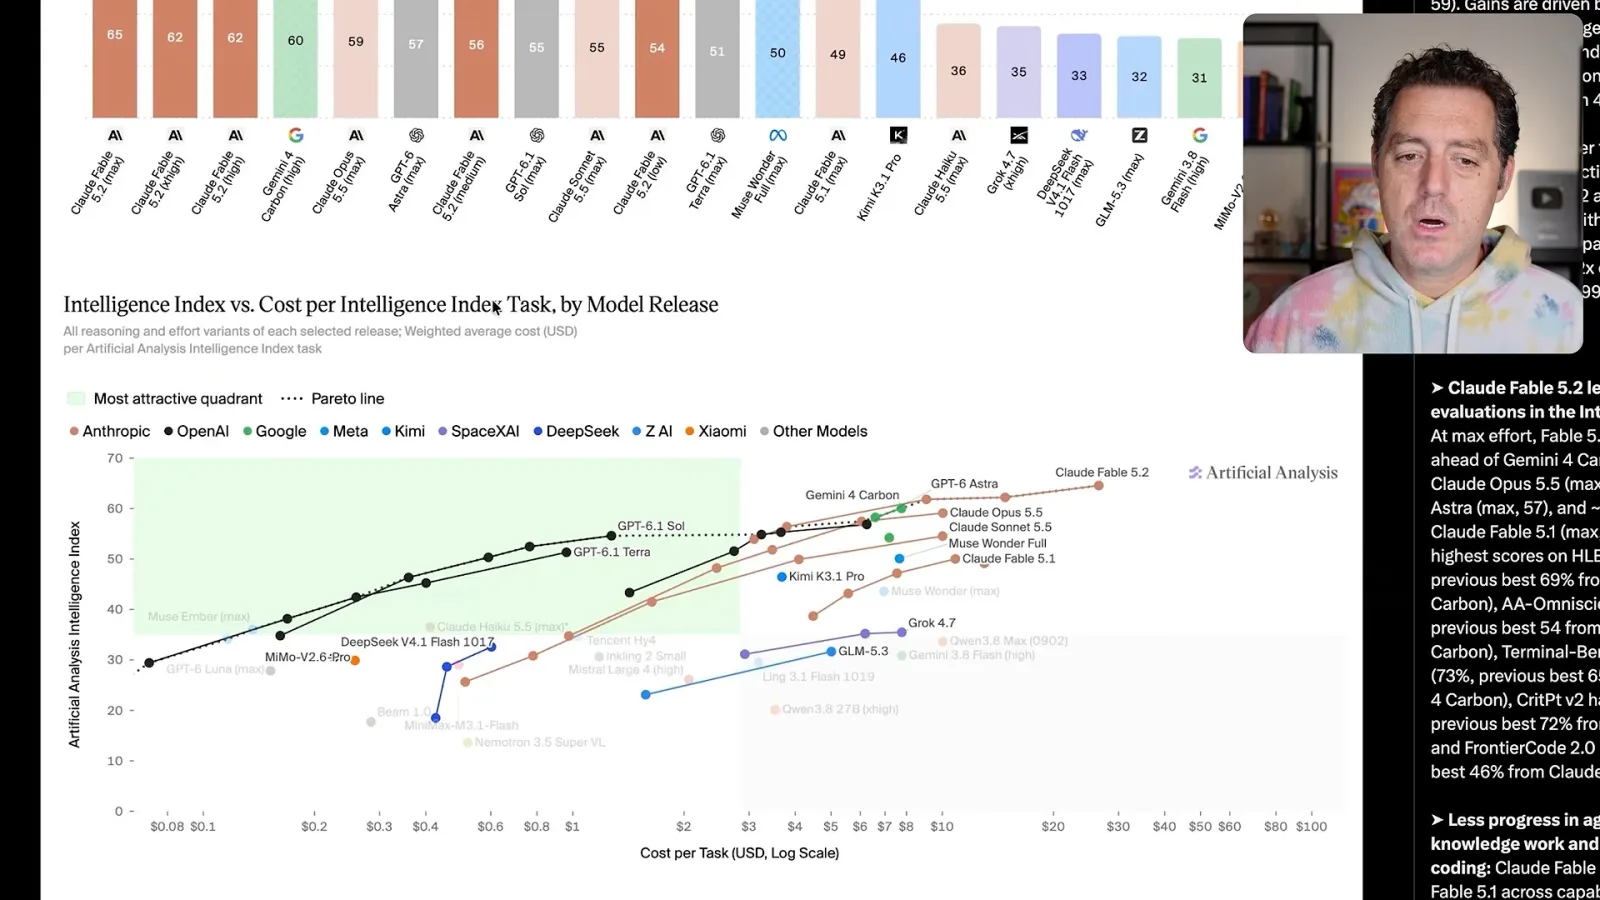
成本会改变选择:Fable 5.2 很昂贵,而 Carbon 每项基准任务的成本低得多。即使我自己偏爱 Fable,也并非每项工作都需要能力最强的模型。
基准、成本与实际演示
他质疑综合分数,并展示 Carbon 生成的表格和游戏示例。
我查看了知识工作、自动化和编程测试中的个别例外。实际使用这些模型让我越来越不相信单一的一组分数能够概括它们的差异。
我描述了自己眼中 Anthropic 在编程模型需求、收入、数据和算力之间形成的循环,并推测前代模型如何帮助构建后继模型。对尚未发布模型的判断只是我的推测。
我认为 Carbon 有用且相对便宜,虽然在我的测试中更偏爱 Fable。一个例子是外观类似 Excel 的浏览器表格应用。
模型报告称,表格演示约花费三个智能体小时,实际经过约一小时四十分钟,消耗 2600 万令牌。这些数字来自模型自己的报告。
在一个 Fall Guys 风格的游戏中,我看到穿模、碰撞和物理效果问题,不过结果仍优于我试过的某些模型。另一个例子是鲁布·戈德堡式动画。
开放权重和较小模型
他介绍 LongCat、Ripple、Inkling 和 Muse Ember,以及模型体积与成本的权衡。
接下来是开放权重模型,首先是 LongCat 2.5:我报告其总参数量为 1.6 万亿、活跃参数量为 480 亿,并支持多模态。模型规模使多数人难以在本地运行。
Recursive Intelligence 的 Ripple 65B 预览版是一个较小的稠密模型。我引用其报告的 Terminal-Bench 2.1 分数和百万令牌上下文,同时指出它比较的是开放权重模型。
Thinking Machines 的 Inkling 2 Small 是另一款紧凑的开放权重模型。我展示了城市建造游戏、Python 电脑模拟器等示例,以及它与更大 DeepSeek 模型的对比。
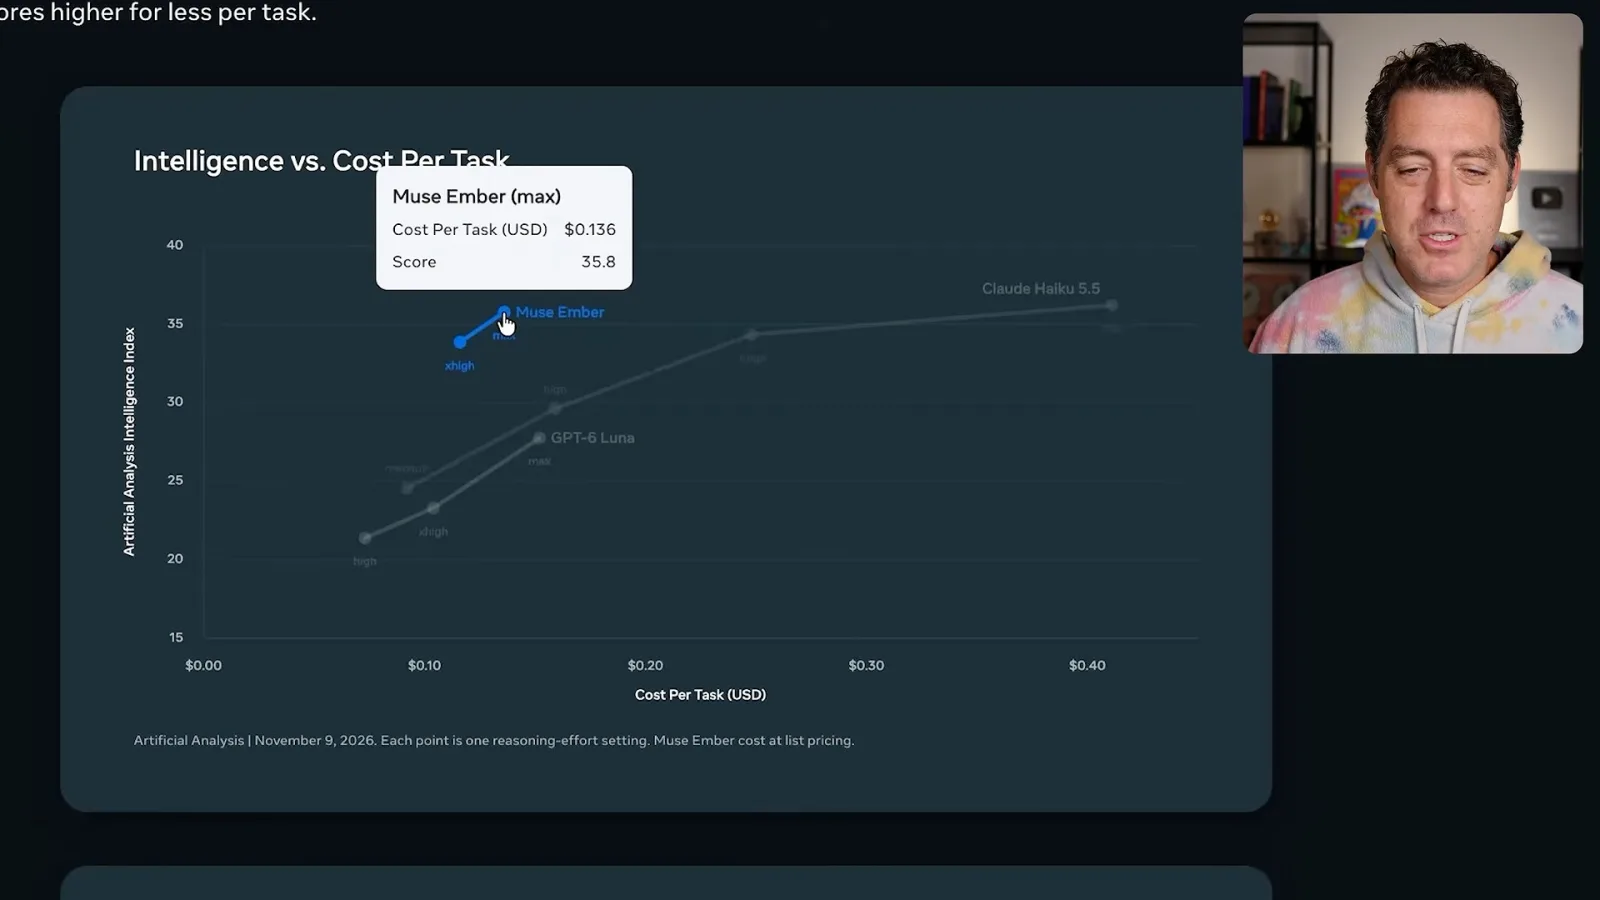
Meta 的 Muse Ember 面向较小模型的工作负载。我对比画面中它与 Claude Haiku、GPT-6 Luna 的成本和成绩,并建议用更强的模型规划、较便宜的模型执行委派任务。
图像、视频和编程模型新产品
Berman 介绍图像与视频生成,以及较小的编程模型。
OpenAI 的 GPT Image 2.6 加入动态图生成并提高图像生成速度,提供侧重质量和速度的版本。我展示了价格,也表示不确定其输入计费如何运作。
我介绍 Gemini Omni 1.2 Flash,称它的视频生成速度更快、成本更低,支持更长片段和对话式编辑;随后展示据称由字节跳动 Seedream 5.5 生成的例子。
我讨论的介绍称,Cognition 的 SWE 2 Flash 基于 Inkling Small,面向高效编程工作。我再次建议,在需要节省配额时考虑用较小模型处理委派任务。
MiniMax H3 Image 被介绍为开放权重图像模型。我提到完整下载和较小量化版本的体积,最后再次说明自己偏爱 Fable 5.2。
同频道的其他文章
 24:18EN → 简体中文
 Matthew Berman· 2026年11月9日Fable 5.2 制作了可玩的演示,但部分项目成本达数千美元Matthew Berman · Forward FutureMatthew Berman 展示游戏、创意软件和模拟项目,估算 API 成本从 25 美元到 1.5 万美元不等。
 20:08EN → 简体中文Matthew Berman· 2026年11月7日METR 发现 Anthropic 的 AI 研发加快,但仍有很大不确定性Matthew Berman · Forward FutureMatthew Berman 解读一份独立评估,关注 AI 对研发的帮助以及评估人员获取证据的限制。
 19:53EN → 简体中文Matthew Berman· 2026年11月5日AI 新闻:Kimi K3.1 权重、计算机操作与专用开放模型Matthew Berman · Forward FutureMatthew Berman 回顾一周的模型发布,涵盖桌面智能体、科学工作流以及图像、视频和语音工具。
 26:47EN → 简体中文Matthew Berman· 2026年11月4日权重空间编程实验说明了什么,以及它的局限Matthew Berman · Forward FutureMatthew Berman 解读前沿模型读取、修复和编写其他网络权重的实验,涵盖小型游戏策略和语言模型的定向修改。
 12:58EN → 简体中文Matthew Berman· 2026年11月3日Matthew Berman:用 AI 构建个人软件Matthew Berman · Forward Future自制 PDF 阅读器让 Berman 认为,编程智能体可能让定制消费软件变得更容易。
 14:45EN → 简体中文Matthew Berman· 2026年10月29日Matthew Berman 解读 Google 的 Gemini 4 Carbon 公告Matthew Berman · Forward FutureMatthew Berman 回顾 Google 公布的 Gemini 4 Carbon 基准结果、分阶段开放计划与定价,同时指出自己尚未使用该模型。