30 秒看懂
METR 估计,2026 年 10 月 Anthropic 模型在定义明确的任务上提升能力的速度约为此前一段时期的两倍,但这一估计存在很大不确定性。评估人员认为,当前加速的大部分来自 AI 辅助研究;不过 Anthropic 控制信息访问权限,并删去了大量关键证据。Matthew Berman 认为这可能形成自我强化的循环;METR 则说可能遗漏了瓶颈,而且当前 AI 主要提供辅助,尚非完全自主研究。
- 1评估人员获得较广泛但需要协商的访问权限METR 查看了 Anthropic 的内部数据,但 Anthropic 保留拒绝请求和删去非公开证据的权利。该项目与后来的员工同等权限计划是两回事。
- 2估计的进步速度约为此前的两倍多数评估人员认为,目前在定义明确的任务上的增长速度约为历史水平的 2 倍,但也说 1.3 倍或 3 倍都不会让他们意外。
- 3评估人员认为当前加速主要来自 AI,但归因不确定METR 猜测,2026 年 10 月约 80% 的当前加速来自 AI 辅助研发,而 2025 年末的加速可能受到非 AI 因素的重要影响。
- 4没有发现瓶颈,并不保证加速会持续METR 没有发现明确的近期瓶颈,但表示其认识在评估过程中发生过变化,也可能遗漏了瓶颈。
- 5AI 主要辅助研究,而非自主主导研究评估人员说,AI 尚未在模型训练最重要的部分做出高度重要且完全自主的贡献,但研究人员观察到进展迹象。
- 6评估没有完成对计算资源分配的核验Anthropic 在项目中途更改了范围;METR 表示,核验取消时尚未得出实质性结论。
要点建议
- METR 的约 2 倍估计指定义明确的任务上的进步速度,不等于所有 AI 能力都翻倍。
- 评估人员估计当前加速主要来自 AI,但归因存在不确定性,重要证据也被删去。
- 没有找到瓶颈,不等于瓶颈不存在。
- Anthropic 可以批准或拒绝信息请求,计算资源分配的核验也被移出了项目范围。
按章节阅读整理后的全文
METR 的评估要回答什么
Berman 介绍 METR 对 Anthropic AI 辅助研发的独立评估。评估人员获得了较大访问权限,但 Anthropic 控制请求和非公开信息的发布。
Matthew Berman 说,AI 辅助开发可能正在让 AI 研究速度形成自我强化的增长。他讨论的依据是 AI 评估机构 METR 对 Anthropic 研发工作的一份独立评估。
METR 与 Anthropic 合作,查看了内部材料、研究人员访谈和各项指标。Berman 一开始将访问权限描述为接近不受限制,随后将该项目与另一项提供员工同等权限的计划区分开:本次评估的信息请求须由 Anthropic 批准。
报告试图回答三个问题:模型能力的进步速度是否加快,加速有多少来自 AI,以及瓶颈是否会拖慢未来进展。Berman 说,报告的答案让他担忧未来的发展速度。
Anthropic 可以批准或拒绝信息请求,并有权在发布前删去非公开信息。Berman 在讨论结果前强调了这一限制。METR 说,它认为最有参考价值的证据中有很大一部分被删去。
模型进步的速度看起来快了多少
METR 估计,定义明确的任务上的进步速度约为此前的两倍,并认为当前加速主要来自 AI,但这些判断存在很大不确定性。Berman 解释一张示意图。
参与评估的多数 METR 员工估计,截至 2026 年 10 月,Anthropic 模型在定义明确的任务上的提升速度约为 2024 年 3 月至 2025 年 10 月期间的两倍。他们强调不确定性很大:如果实际速度是此前的 1.3 倍或 3 倍,也不会让他们意外。
Berman 将这一指标与编写代码、构建模型开发所需系统等研究工作联系起来。METR 估计的是定义明确的任务上的能力进步速度,并非声称所有能力突然翻倍。
评估认为,其他因素可能对 2025 年末的加速发挥了重要作用。至于当前的加速,METR 猜测其中大部分——或许约 80%——来自 AI,同时明确表示这一判断存在很大不确定性。
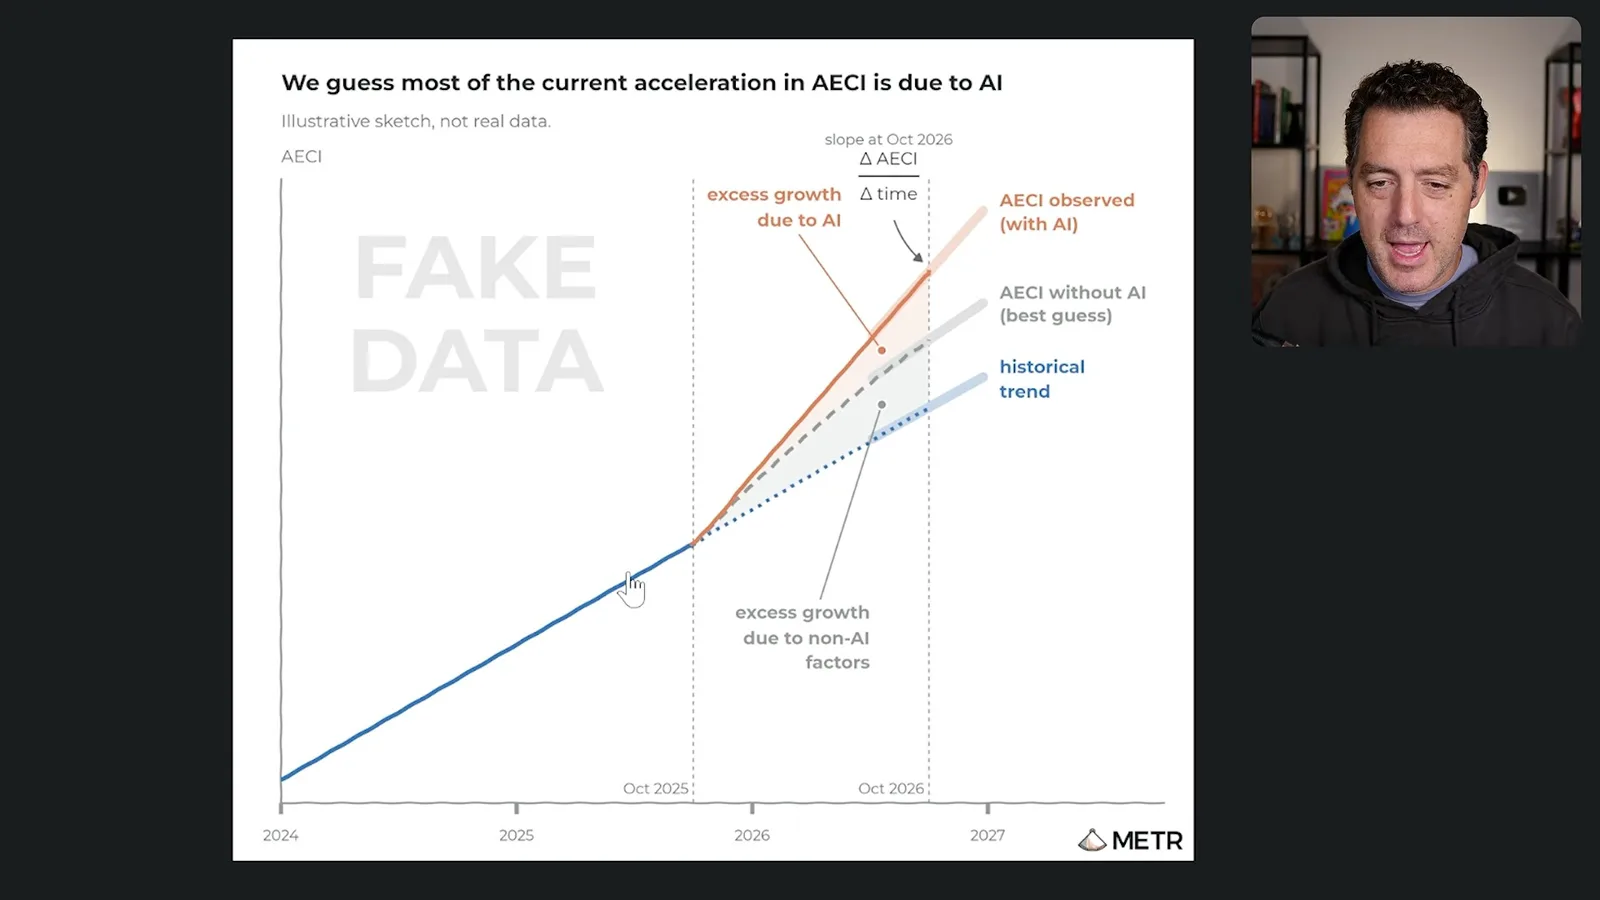
Berman 展示了 METR 的一张示意图,比较此前的趋势、假设没有 AI 时的路径和观察到的路径。图上标明数据为虚构;其目的是解释如何归因,而不是展示测量值。
他把这一时间点与 2025 年末前后 AI 编程工具的进步联系起来,认为开发者感受到了模型能力的变化。在他的描述中,对大型代码库和功能开发的帮助可以反过来促进实验室自身的开发工作。
自我强化循环的可能性
Berman 认为,更强的模型可以加快研究并改善计算资源的利用。METR 提醒,加速可能产生复利效应,但对潜在瓶颈仍不确定。
Berman 担心的是复利效应:更强的模型可能帮助研究人员提高下一代模型的能力、改善计算资源利用,并放大人的工作成果。他把这种可能性与有关智能爆炸的论述联系起来。
他讨论了报告中的计算效率提升,并以 Google 的 AlphaEvolve 工作举例,说明 AI 可以为工程改进做出贡献。他认为,在大型 AI 公司的规模下,即使很小的效率提升也可能产生显著影响。
METR 说,没有发现会阻止近期进一步加速形成复利效应的明确瓶颈或显著收益递减。Berman 将此解读为对快速进步的警示。METR 同时表示,评估期间其认识发生过变化,也可能遗漏了重要瓶颈。
报告说,Anthropic 在此前一年取得的基准测试进步,大致相当于 2023 年 10 月至 2025 年 10 月两年间的进步。Berman 将这一发现与自己观察到的更快的模型发布节奏联系起来。
基准测试趋势与研究人员的反馈
视频考察了 Anthropic 内部能力指数和研究人员访谈。METR 认为 AI 辅助作用重要,同时将其与完全自主研究区分开。
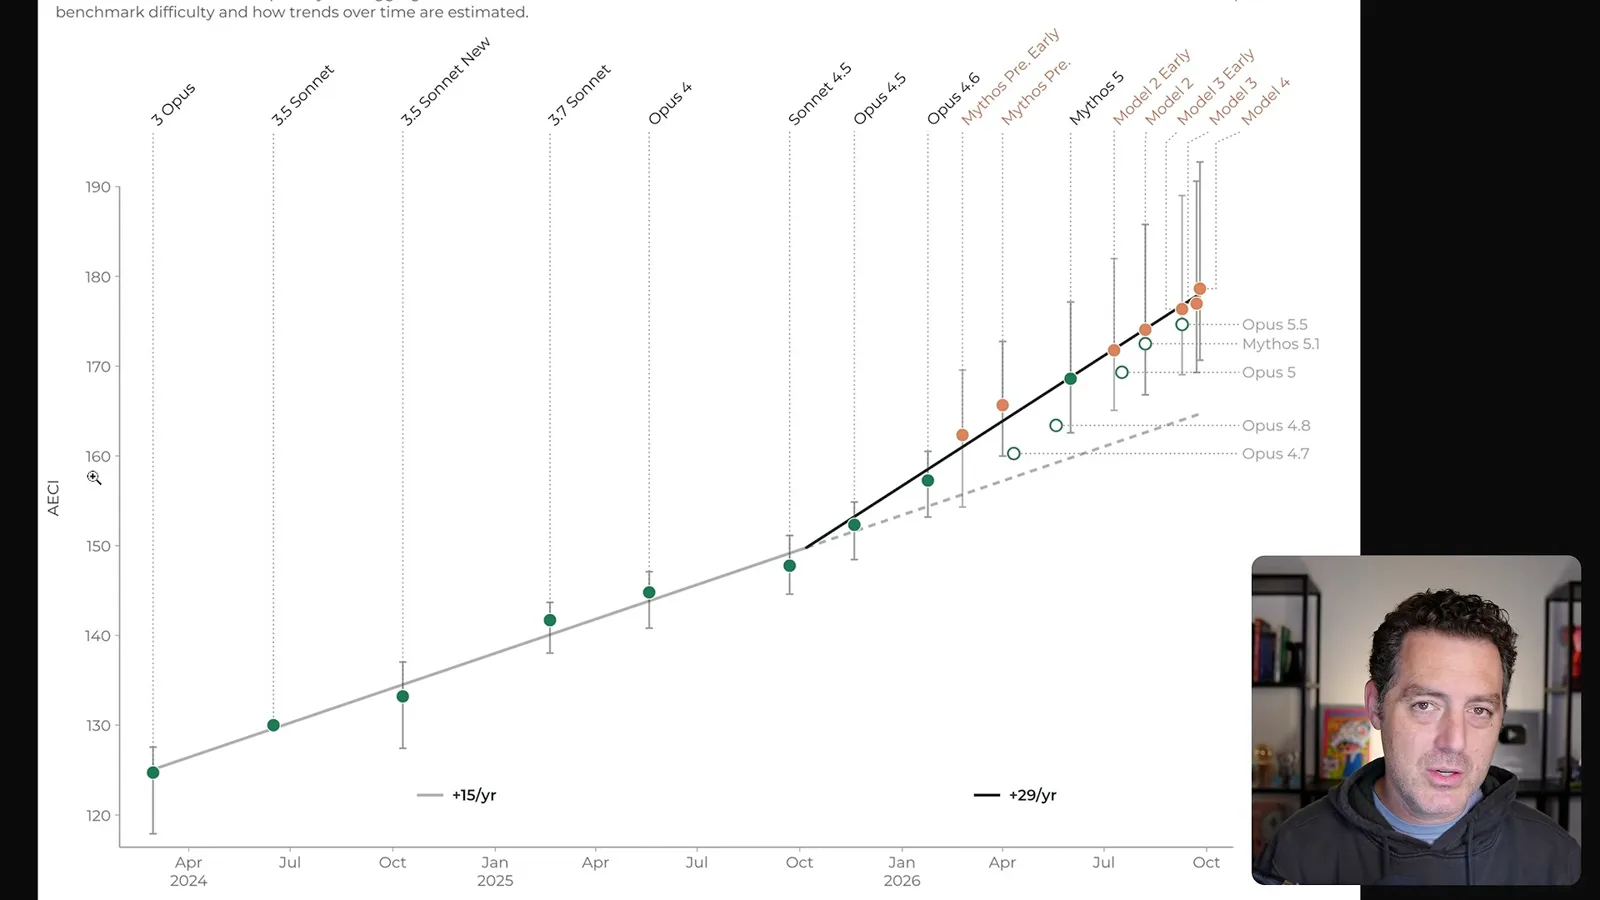
他展示的图使用 AECI,即 Anthropic 版本的 Epoch Capabilities Index。Berman 指出 2025 年末之后的趋势更陡,以及较新的内部模型对结果的影响。METR 估计基准趋势的增长速度变为此前的 1.9 倍,但这一结果如何对应更广泛的任务仍有不确定性。
评估人员说,他们获得了有说服力的证据,表明加速不是由训练计算规模的增长速度加快造成的。Berman 指出,Anthropic 删去了更多细节,因此公众能够直接检查的内容有限。
METR 还考虑了访谈、研究人员对自身生产力的估计、员工人数、代码和实验使用情况。Berman 承认,随意填写的自报数据不是受控的科学测量,但认为它和其他证据一起提供了一个信号。
他读出的匿名反馈中,研究人员描述工作速度变快,并说代码不再是那么大的限制。其中一人认为,想法和计算资源仍是瓶颈。Berman 强调,即使实现变快,找到有前景的研究方向仍可能十分重要。
报告说,AI 尚未在模型训练过程最重要的部分做出高度重要且完全自主的贡献。不过,研究人员描述了更自主贡献可能出现的早期迹象。Berman 把这一观察与近期 AI 在数学证明方面的工作联系起来。
他推测,如果有足够的计算资源,模型或许能够测试大量可能的方向,即使没有类似人类的直觉也是如此,不过直觉可以降低搜索成本。METR 自己的评估则表示,对未来瓶颈的判断仍不确定。
访问权限、删节与变化的项目范围
评估人员介绍了协商获取信息的过程,以及项目中途移除计算资源分配核验的决定。Berman 讨论了内部模型和剩余的不确定性。
Berman 回到项目的开展方式。METR 投入了约相当于 2.5 名全职员工的工作量,合作从 8 月中旬开始。评估团队请求获取他们认为相关的信息,Anthropic 可以接受或拒绝请求,双方也会就敏感数据进行协商。
这项项目并非 Anthropic 在 10 月 15 日更新中描述的员工同等权限安排。Berman 强调这一差别,因为此前的安排让 Anthropic 同时控制材料访问和非公开细节的删节。
最初的项目范围包括核查 Anthropic 如何分配计算资源,尤其是能力研发与安全工作之间的分配。Anthropic 在项目中途更改范围,移除这项核验,当时 METR 尚未得出实质性结论。Anthropic 表示,希望暂时聚焦风险评估,日后再讨论核验。
Berman 推测,公司的首次公开募股计划可能影响了这一决定。他把这作为自己对项目范围变化的看法,而非评估人员已经证实的解释。
在附录中,Berman 指出 METR 在判断进步是否体现持续趋势变化、而非一次性跃升时,考虑了未发布的内部模型结果。他还指出,当模型接近基准测试的上限时,测试必须变得更难。
最后,他再次谈到更强的模型可能加速自身开发,以及人们可能逐渐无法理解这些系统的担忧。他提到模型为其他模型直接编写权重的研究,作为希望观众继续思考的另一个例子。
同频道的其他文章
 19:53EN → 简体中文
 Matthew Berman· 2026年11月5日AI 新闻:Kimi K3.1 权重、计算机操作与专用开放模型Matthew Berman · Forward FutureMatthew Berman 回顾一周的模型发布,涵盖桌面智能体、科学工作流以及图像、视频和语音工具。
 26:47EN → 简体中文Matthew Berman· 2026年11月4日权重空间编程实验说明了什么,以及它的局限Matthew Berman · Forward FutureMatthew Berman 解读前沿模型读取、修复和编写其他网络权重的实验,涵盖小型游戏策略和语言模型的定向修改。
 12:58EN → 简体中文Matthew Berman· 2026年11月3日Matthew Berman:用 AI 构建个人软件Matthew Berman · Forward Future自制 PDF 阅读器让 Berman 认为,编程智能体可能让定制消费软件变得更容易。
 14:45EN → 简体中文Matthew Berman· 2026年10月29日Matthew Berman 解读 Google 的 Gemini 4 Carbon 公告Matthew Berman · Forward FutureMatthew Berman 回顾 Google 公布的 Gemini 4 Carbon 基准结果、分阶段开放计划与定价,同时指出自己尚未使用该模型。
 21:11EN → 简体中文Matthew Berman· 2026年10月28日Matthew Berman 实测 DeepSeek V4.1 Flash:编程、视觉与本地应用Matthew Berman · Forward Future从视觉编程、图像推理到本地应用和服务商价格,实测既展示了模型的能力,也暴露出明显缺陷。
 0:37EN → 简体中文Matthew Berman· 2026年10月28日Google 发布 Gemini 4 CarbonMatthew Berman · Forward FutureMatthew Berman 简述模型发布和分阶段开放计划。