30 秒看懂
Matthew Berman 讨论 Kimi K3.1 Pro、NorthCUA、PRISM、Hydrogen、Pika H3 Flex 等模型。基准、价格和性能数据归属于演讲者或开发者,并取决于测试配置。
- 1Kimi 权重Berman 展示大型分片权重下载,并讨论部署资源需求。
- 2计算机操作NorthCUA 在展示的桌面运行框架中使用观察、决策、行动的循环。
- 3更快的图像生成Pruna 的演示将 8 步图像生成与更长的基线比较。
- 4决策模型Sarvam PRISM 为预定义选项分配概率,而不是生成文本回答。
- 5科学工作流Hydrogen 演示了生成代码和分子模拟。
- 6成本与性能最后一部分比较闭权重模型报告的价格和基准结果。
要点建议
- Kimi K3.1 Pro 权重规模很大,部署完整模型需要大量资源。
- 计算机操作和决策模型为特定任务提供专门接口。
- 报告的基准和速度取决于工作负载、硬件及评估条件。
- 小型专用模型瞄准检索、3D 编码、语音和设备端运行等任务。
- 科学输出和选定的演示仍需要独立验证。
按章节阅读整理后的全文
开放权重与计算机操作
Berman 讨论 Kimi K3.1 Pro 和 NorthCUA 系列。
本周发布了许多模型:Kimi K3.1 Pro 的开放权重、计算机操作模型、图像与科学模型,以及一些更小的专用系统。我会介绍演示和公布的基准成绩;解读数据时需要考虑各开发者的测试条件。
Moonshot 发布了 [Kimi K3.1 Pro 权重](https://huggingface.co/moonshotai/Kimi-K3.1-Pro)。我认为这是一个能力很强的开放权重模型,但它非常大:展示的文件分为 96 部分,每部分约 17 GB,普通本地计算机不太可能运行完整版本。
我估计运行该模型可能需要超过 1 TB 的显存,具体取决于精度和部署方式;社区也可能探索量化版本。确切硬件需求取决于实现;开放权重并不自动意味着采用无限制的开源许可。
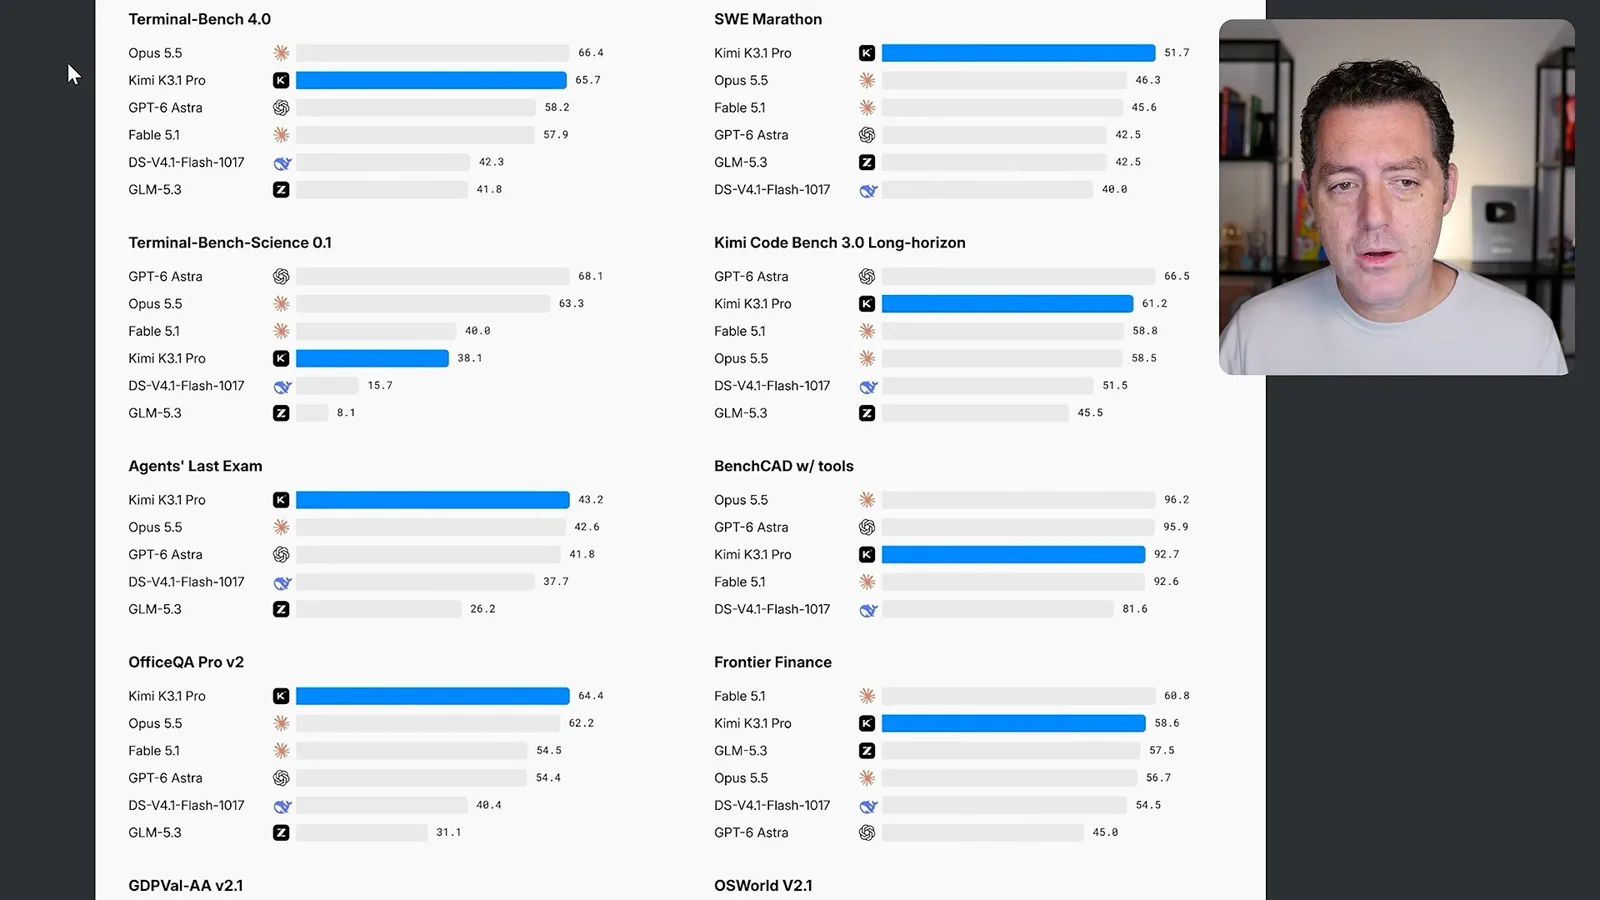
公布的图表将 Kimi 与数个闭源模型在终端、智能体等基准上作比较。这些结果有助于比较被测试的配置,但某项基准高分并不能证明它适合所有任务。
[NorthCUA](https://huggingface.co/beipo-ai/NorthCUA-Pro) 是 Beipo AI 的计算机操作模型系列。我介绍的 Pro 版本采用混合专家架构,总参数为 3970 亿、激活参数为 170 亿,另外还有更小的 Mini 和 Nano。
团队还提供运行框架。在我展示的桌面智能体循环中,系统观察截图、决定下一步并采取行动,然后重复这一过程。我引用了发布方提供的 OSWorld Verified 成绩;这些是报告值,并非我独立复现的结果。
图像与决策模型
他介绍 P-H3-Image 和 Sarvam PRISM。
Pruna AI 的 P-H3-Image 将 MiniMax H3 用于图像生成和编辑。演示对比了 8 步与 50 步生成,并称模型更小、输出更快;实际速度和质量取决于硬件和比较条件。
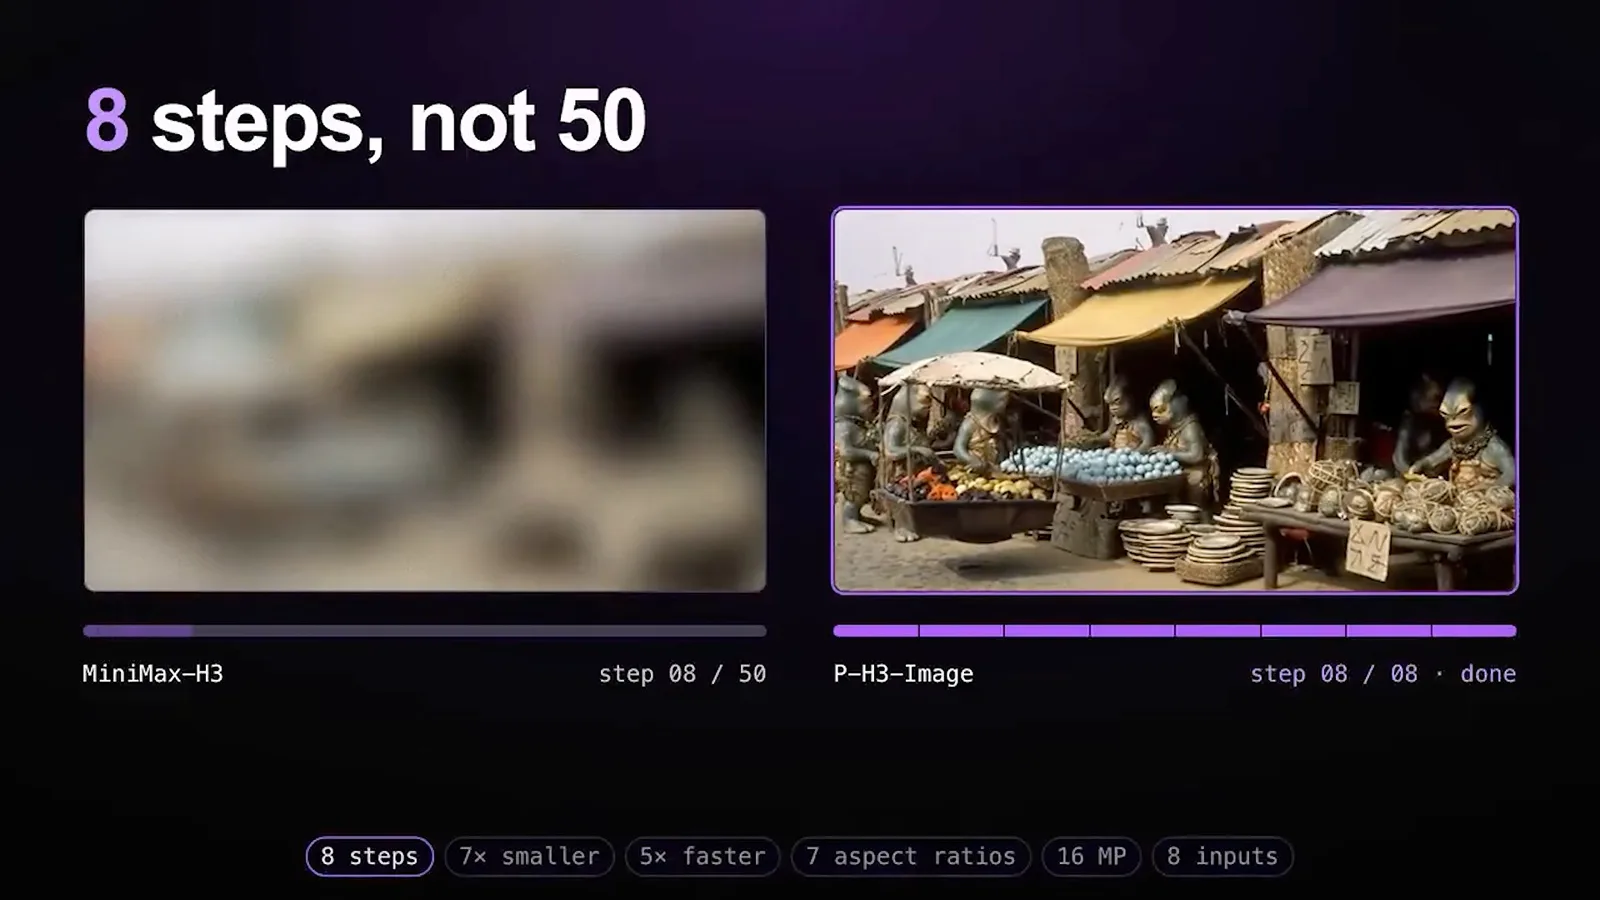
示例包括写实图像、动漫风格图片,以及看起来像手写的食谱。我更喜欢其中一些展示结果,但这是基于选定样例的主观判断,并非全面的质量评估。
[Sarvam PRISM](https://huggingface.co/sarvamai/prism) 被介绍为决策模型,而非文本生成模型。给定上下文和固定选项后,它会返回各选项的概率;其接口与让聊天模型撰写答案不同。
我提到模型权重需要较大的磁盘空间,模型卡建议使用数据中心级 GPU。某台本地机器能否运行,取决于内存、精度和可用实现。
科学、检索与 3D 编码
新闻汇总涵盖 Hydrogen、Perplexity 嵌入模型和 Qwen 专用微调模型。
Hydrogen 1.0 被介绍为面向科学工作的模型,基于 GLM 5.3 后训练。我展示了 Frontier Science 对比和报告的每题成本。这些数字来自发布方选用的基准,本身不能证明科学结果可靠。
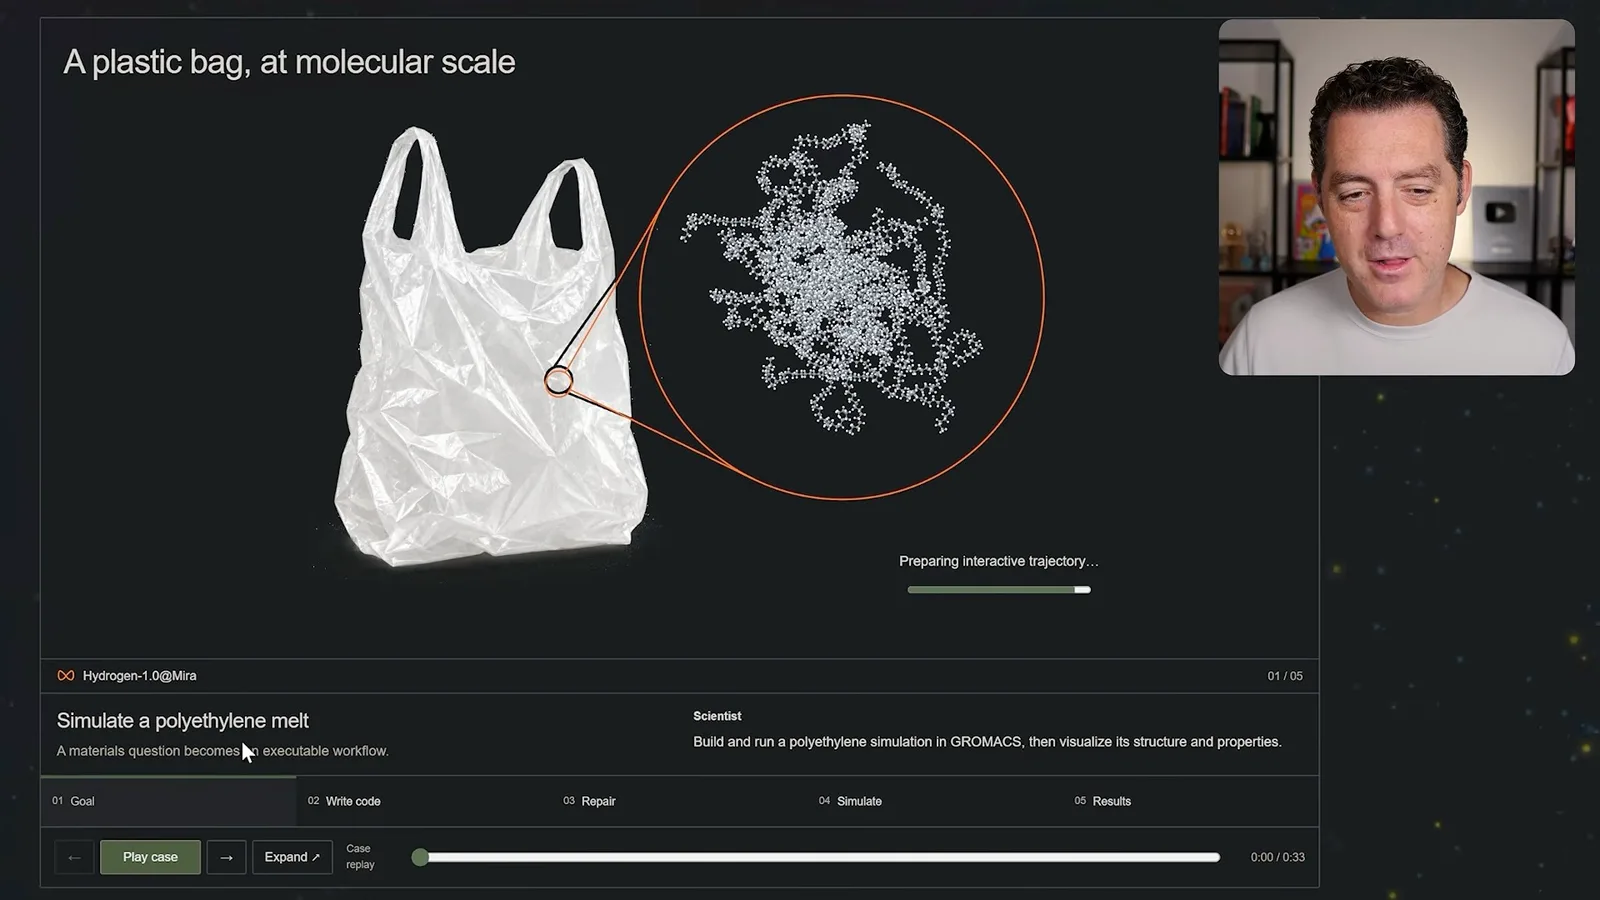
演示要求模拟聚乙烯熔体,并展示代码和分子可视化。模型生成的模拟展示了一种工作流,其假设和结果仍需要领域专家验证。
Perplexity Embed v2 Context 被描述为开放权重的视觉语言嵌入模型系列,有 9B 和 600M 两种规模,面向文本、图像和视觉文档检索。我也提到配套论文与模型资料。
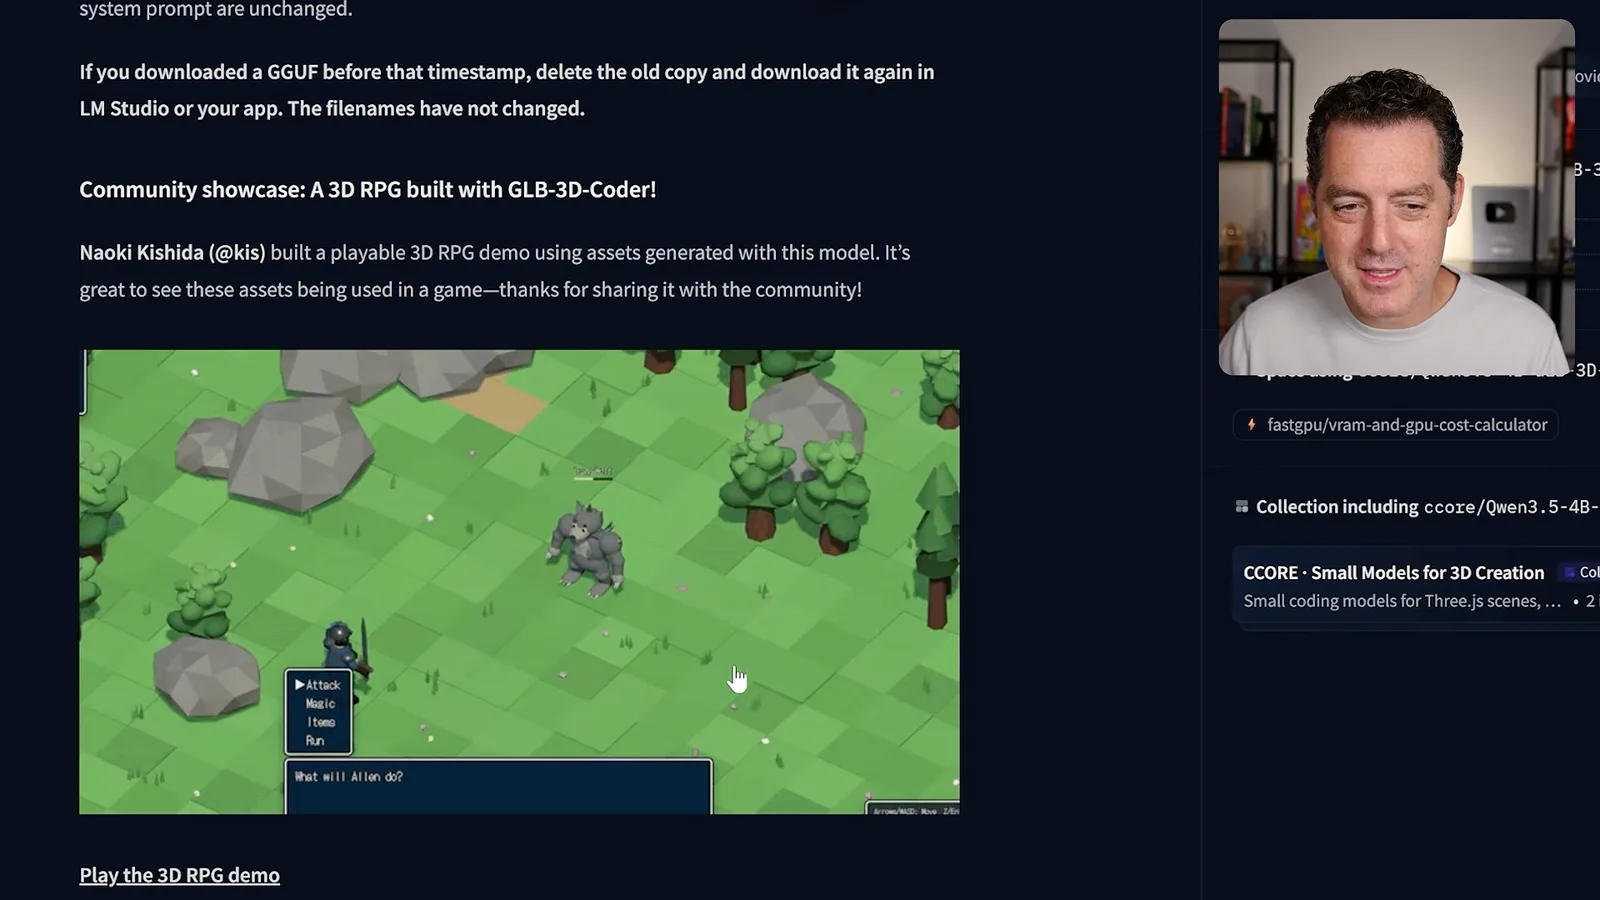
一个基于 Qwen3.5 4B 的社区微调模型面向 3D 编码,包括 Three.js 场景和 GLB 导出。我展示了一个小游戏风格的例子,并认为此类小型专用模型可能适合资产原型制作;质量会随任务而变化。
视频、语音与扩散模型
他展示 Pika H3 Flex、Apriel Voice 和 DiffuSpace Clover。
Pika H3 Flex 是基于 MiniMax H3 的视频模型。我展示样片以及开发者对输出速度、分辨率和价格的说法;实际价格和性能取决于服务条款和配置。
在展示的编辑流程中,多张图片和一个音频文件被组合成生成视频,之后还可修改个别元素。我认为示例很有前景,但它们是选定的演示,并非受控对比。
ServiceNow 的 [Apriel Voice 27B 预览版](https://huggingface.co/ServiceNow-AI/Apriel-Voice-27B-preview) 被介绍为能接收语音、文本和图像,用于面向任务的交互,并支持语音输出。我讨论了其报告的基准成绩;本地运行仍取决于硬件和精度。
DiffuSpace Clover 是扩散式模型,我介绍的参数规模为总计 35B、激活 3B。我展示了一个计算机操作例子,其中它比对比模型更快完成演示任务;单个例子无法衡量所有任务的表现。
设备端模型、OCR 与 Terra
最后介绍 LFM3、Unlimited OCR 2 和 GPT-6.1 Terra。
Liquid AI 的 [LFM3](https://www.liquid.ai/blog/lfm3) 面向设备端运行。我介绍其较小的模型规模、256K 上下文的说法,以及相对前一版本报告的改进。内存占用与实际速度会因设备和配置而异。
百度的 [Unlimited OCR 2](https://github.com/baidu/Unlimited-OCR) 是文档 OCR 系统。我介绍了其报告的长文档测试和自己的正面体验;准确率仍可能随文档质量和版式变化。
最后我介绍 OpenAI 的 GPT-6.1 Terra,这是本期汇总中的闭权重模型。我转述了公布的价格、基准比较,以及同事对视频编辑能力的正面评价。这些说法具有时效性,实际成本取决于工作负载和当前价格。
同频道的其他文章
 26:47EN → 简体中文
 Matthew Berman· 2026年11月4日权重空间编程实验说明了什么,以及它的局限Matthew Berman · Forward FutureMatthew Berman 解读前沿模型读取、修复和编写其他网络权重的实验,涵盖小型游戏策略和语言模型的定向修改。
 12:58EN → 简体中文Matthew Berman· 2026年11月3日Matthew Berman:用 AI 构建个人软件Matthew Berman · Forward Future自制 PDF 阅读器让 Berman 认为,编程智能体可能让定制消费软件变得更容易。
 14:45EN → 简体中文Matthew Berman· 2026年10月29日Matthew Berman 解读 Google 的 Gemini 4 Carbon 公告Matthew Berman · Forward FutureMatthew Berman 回顾 Google 公布的 Gemini 4 Carbon 基准结果、分阶段开放计划与定价,同时指出自己尚未使用该模型。
 21:11EN → 简体中文Matthew Berman· 2026年10月28日Matthew Berman 实测 DeepSeek V4.1 Flash:编程、视觉与本地应用Matthew Berman · Forward Future从视觉编程、图像推理到本地应用和服务商价格,实测既展示了模型的能力,也暴露出明显缺陷。
 0:37EN → 简体中文Matthew Berman· 2026年10月28日Google 发布 Gemini 4 CarbonMatthew Berman · Forward FutureMatthew Berman 简述模型发布和分阶段开放计划。
 34:21EN → 简体中文Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。