30 秒看懂
Nori Agentic 联合创始人 Amol Kapoor 和 Clifford Ressel 解释资产管理公司的证券主数据库有什么作用,以及分散在各类文件中的私募投资条款为何难以标准化。Kapoor 介绍了一套客户工作流:智能体调查每个发生变更的字段,引用证据,并请负责人审核其建议。 两人将人工工作从约一小时缩短至五分钟作为该部署的案例,并主张采用共享智能体基础设施、领域专用指令和人工监督。
- 1证券主数据库Ressel 将这个中心投资数据库描述为数据生产者与下游消费者之间的质量边界。
- 2私募资产缺少统一标识交易条款和修订记录存在定制文件中,而不是集中于标准化 API。
- 3逐单元格审核Kapoor 称,客户团队此前平均需要约一小时调查每个变更字段。
- 4智能体收集有据可查的材料本地部署的模型调查指定数据源、提出建议,并提醒负责人审核。
- 5保留人工参与Kapoor 认为,大部分工作自动化再加上简短人工审核,可能比坚持完全自主更切实可行。
要点建议
- 证券主数据库将不一致的数据源连接到风险、会计和合规工作流。
- 私募资产往往缺少统一标识,需要从针对具体交易的文件中提取信息。
- 智能体可以为字段变更收集证据并提出建议,同时由人作出决定。
- 指令、数据源访问权限和运行环境提供了智能体所需的大部分领域上下文。
- 共享基础设施与人工审核环节有助于部署专业工作流。
按章节阅读整理后的全文
私募资产数据为何棘手
Kapoor 介绍私募投资的增长,以及承载相关细节的各类文件,并引出 Nori Agentic 和证券主数据问题。
Amol Kapoor 开场谈到金融业的变化:越来越多资金流向私募资产,包括土地、能源基础设施、数据中心和未上市 AI 公司的股份。他引用二级交易量及另类资产预测,作为这一趋势的例证,并未将其视为未来增长的保证。
Kapoor 认为变化来自多方面因素。除了支撑 AI 的基础设施需求,他还提到企业保持私有状态的时间更长、监管因素,以及投资者在竞争激烈的公开市场之外寻找机会。
Kapoor 认为,如果经济活动中有更大比例由私募资产承载,购买公开股票指数就不能覆盖整个市场。更多投资者因此寻求私募资产,也让资产数据管理问题更加突出。
一项私募投资的细节可能散落在 PDF、Box 文件夹、邮件和通话记录中。即使只是查持股数量、行权价、土地购买价格或交易附带权利,也可能需要搜索多份文件。
Kapoor 介绍了构建云端智能体的 Nori Agentic,并说明演讲将讨论如何用智能体管理和审计公司的投资。曾从事金融后台工作的联合创始人兼首席技术官 Clifford Ressel 接着解释证券主数据库。
证券主数据库的作用
Ressel 解释数据库如何把标识符和数据源连接到重要业务分析,并用公开交易的股票说明映射难题。
Ressel 说,证券主数据库是资产管理公司投资范围内证券和金融工具的主数据库。风险管理、损益核算、监管合规等关键分析通常从这里获取基础数据。
当不同来源对某个数值有分歧时,理想流程会在数据进入主库之前发现冲突。团队可以回查来源或检查映射逻辑,在错误传播到下游分析之前修正上游问题。
Ressel 将这一层称为一种组织基础设施:它位于数据生产者与消费者之间,可以实施标准、可见性和质量检查。具体实现可以是包含多个表的复杂湖仓,也可以是单一的反规范化事实来源。
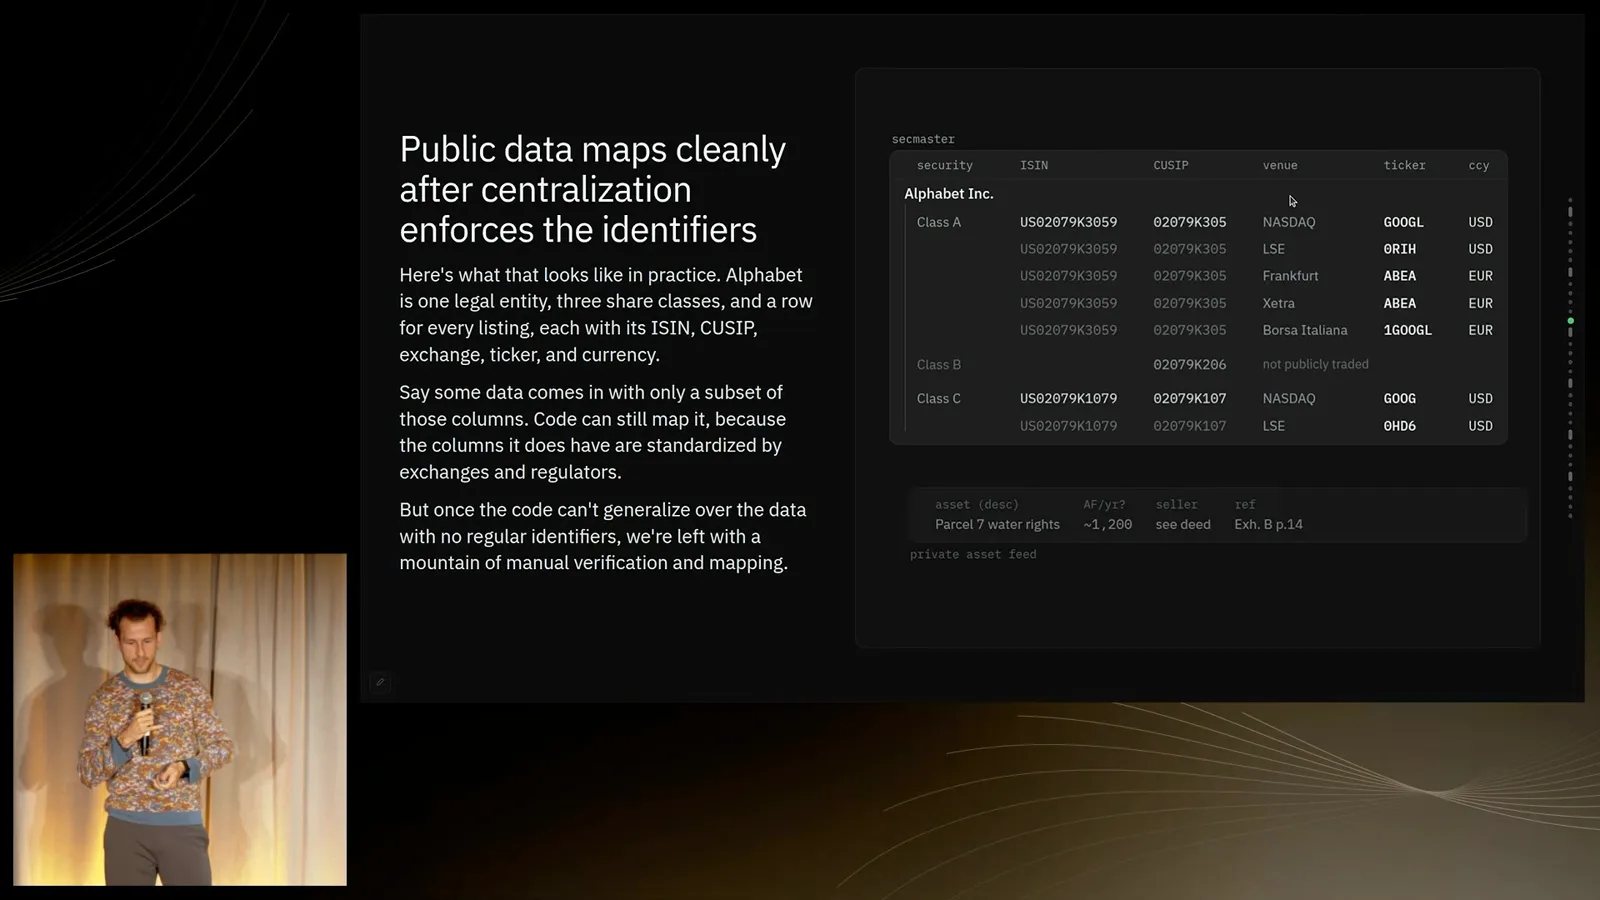
公开市场有多个协调数据的机构。数据供应商提供 FIGI、RIC 等标识,编号机构提供 ISIN、CUSIP 等标识,以满足监管和其他需求。将这些标识映射到内部视图后,公司才能关联外部数据、报告持仓和建立风险模型。
即使是熟悉的公开股票,也能说明其中的复杂性。Google 有 GOOG 和 GOOGL 两类股票;信息可能按法律实体、证券或不同交易所的层级报告。公司必须正确映射这些不同粒度,才能组合数据。
Ressel 把这个问题比作日期时间库:有人把它做好时,一切看似简单,但内部包含大量边界情况和复杂惯例。反规范化表可以提供足够的标识映射,即使传入数据只包含部分标识,也能找到正确的内部记录。
私募资产如何打破既有模式
私募交易可能没有统一标识或集中数据源,交易条款和修订需要从单独文件中核对。
Ressel 说,结构化数据和定义清楚的内部本体可以帮助编码智能体建立新的分析。更困难的是没有标准标识的数据源:人们必须手工判断它描述的是哪个实体,以及映射是否正确。
例如,向一家建设发电厂的公司放贷,或购买附近土地时,交易可能没有统一标识、集中规范信息结构的机构,也没有供应商 API 提供现成的本体。还款计划、抵押和修订都存在单独协议中,因此每项资产都带来自己的文件与数据处理工作。
Kapoor 回到实际运营后果。即使私募资产文件格式不一致,数据仍需要标准化、清洗和审计。风险分析人员不应该为了确定收到的数据是否正确,而自行搜索每一份文件。
变更审核工作流
Kapoor 介绍一家资产管理公司逐单元格审核的流程。团队的智能体调查变更、引用证据并请负责人决定。
他介绍了一家财富 200 强资产管理公司,其数据工程团队逐日检查证券主数据库的变化。在他的例子中,一张含 5 万项资产、约 200 个字段的表会持续产生需要调查的单元格变更。
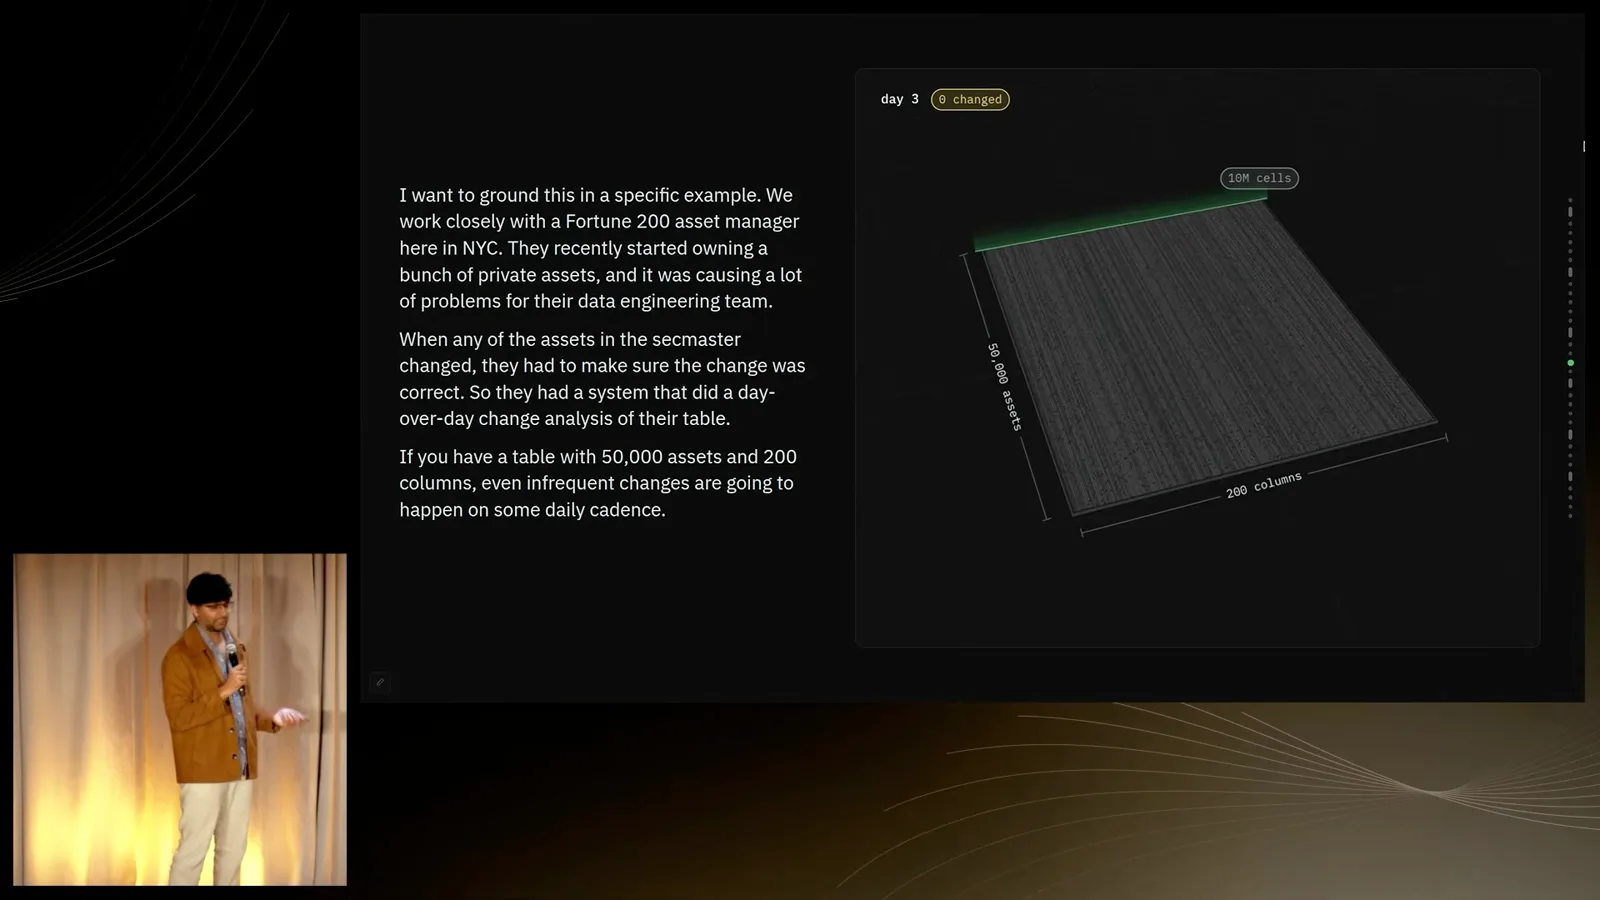
调查人员将每个变更单元格与文件和其他来源比较,判断变化是否有效。价格、名称、破产、所有权或重新谈判的合同都可能触发审核。Kapoor 说平均每项变更约需一小时;他把最初所说的每月几十万小时更正为数百或数千小时。
Kapoor 将云端智能体定义为运行在远程环境而非用户笔记本上的编码智能体。他说,该环境可以支持定时工作、可观测性、透明度和审计要求,因此新证券主数据到达时,智能体就能启动。
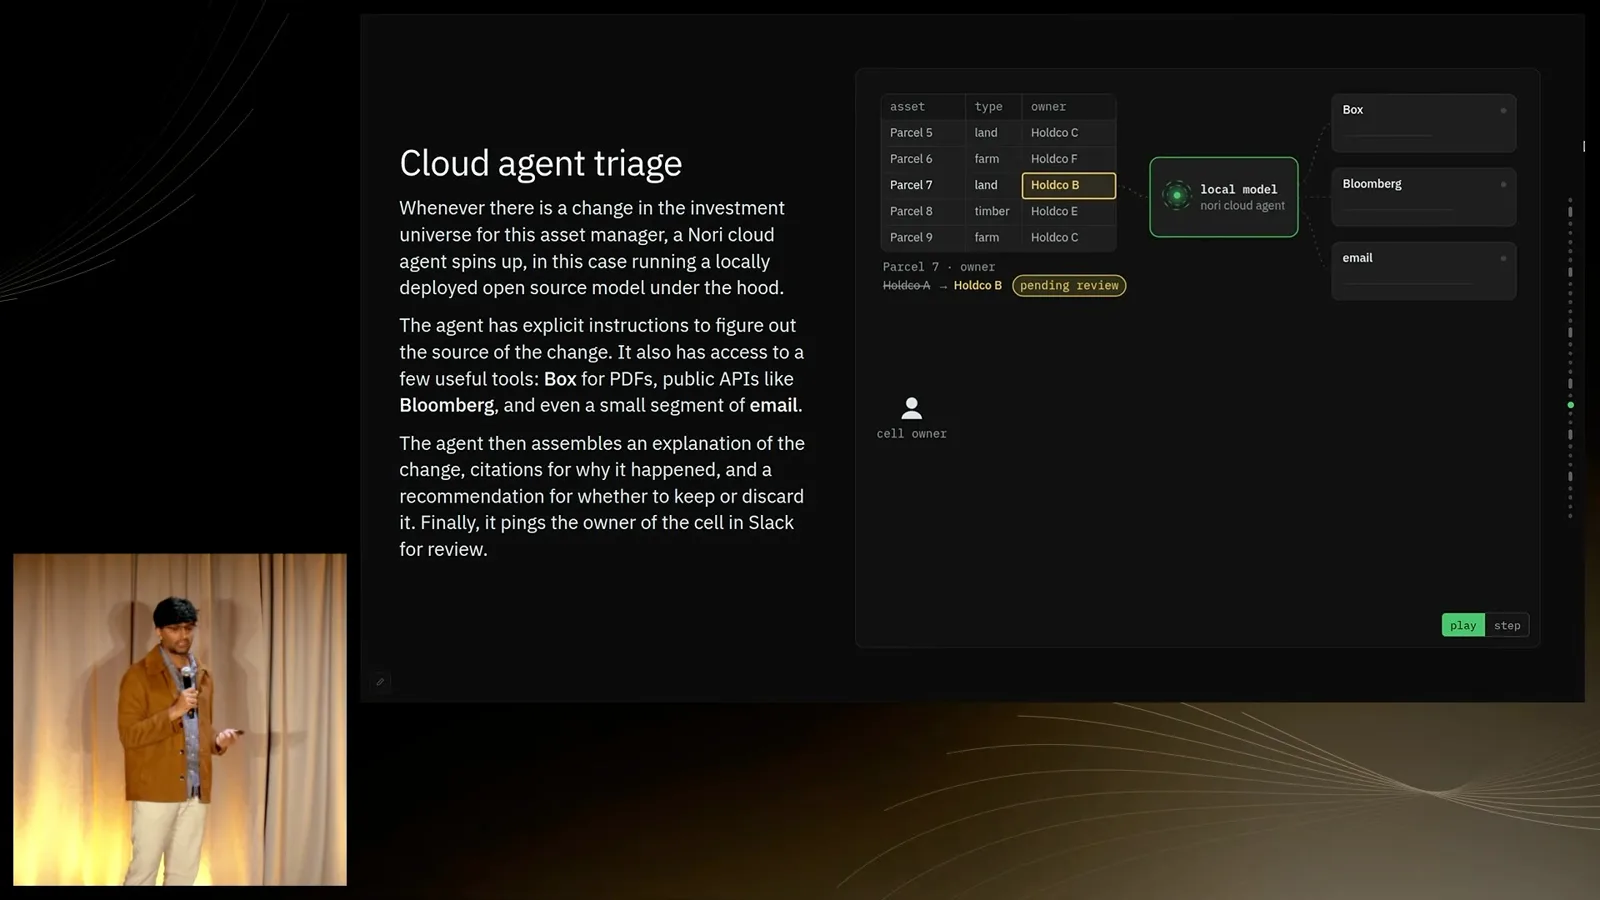
在他描述的部署中,变更会触发 Nori 智能体,使用部署在客户环境内部的开源模型。智能体根据指令访问指定来源,包括 Box 中的 PDF、公开数据 API 和有限范围的邮件,调查变更从何而来。
智能体整理变更说明,引用支持证据,并建议保留或丢弃这一变更,然后在 Slack 上提醒对应单元格的负责人。人来审核建议,也可以进一步调查;智能体并不是最终决策者。
Kapoor 说,智能体承担了文件搜索和证据整理,因此这一典型检查中人工部分从约一小时降至约五分钟。这是团队对自身特定工作流的描述,并非适用于所有资产管理公司的通用基准。
指令与共享基础设施
团队用书面领域知识和工具配置来调整通用智能体。Kapoor 建议在不同工作流之间复用编排和安全设施。
智能体如何获得领域知识?Kapoor 将其比作培训新分析师:用书面说明告诉它文件在哪里、哪些来源可信、如何判断变更。团队可以更新自然语言 Markdown 指令,而无需为每项任务单独构建一套智能体。
他建议把通用智能体与 skills 或 AGENTS.md 等配置结合。专业化能力很大程度来自运行环境、凭据、可用工具和提供的指令,而不是每种工作流都需要一套独特的底层编排系统。
Kapoor 将最终的证券主数据库比作周围有一群自动清洁工的数据库:它们持续查找问题并主动提示。他认为,同一模式可以让企业工作从人先请求帮助的被动方式,转向智能体主动提供分析和建议。
为了扩大这种做法,他建议证券主数据、审计和代码审核智能体共享编排、安全和集成基础设施。每项任务可以保留各自的触发条件、工具、上下文和公司所有的指令,同时共用底层平台。
为金融行业构建 AI 的经验
Kapoor 强调与领域专家协作以及人工审核,并认为智能体可以减少处理系统自然演化导致的数据不一致所需的工作。
第一条经验是 AI 采用首先是协作问题:客户想购买解决方案,工程师却常提供构建模块。Nori 发现,当领域专家能够把云端智能体能力与现有具体问题联系起来时,更容易取得进展。
第二,Kapoor 建议实现大部分自动化,同时保留人工参与。与其坚持让智能体端到端处理每一个案例,不如让人花五分钟审核,这能让许多有价值的工作流落地,并保留责任归属,金融领域尤其如此。
最后一条经验涉及偶然复杂性:工作量来自系统如何演化,例如相同数据以不同格式出现,而非问题本身的固有难度。他认为智能体适合处理这类重复且费时的工作,让人们有更多时间处理真正困难的决策。
同频道的其他文章
 31:22EN → 简体中文
 AI Engineer· 2026年11月7日Nouha Dziri:如何降低编码智能体团队的成本Nouha Dziri · CohereProgramBench 和 Commit0 上的实验说明,任务瓶颈、主智能体模型和协调方式比单纯增加智能体数量更重要。
 18:28EN → 简体中文AI Engineer· 2026年11月7日Vinoo Ganesh:如何让 AI 回答建立在可验证的事实之上Vinoo Ganesh · KeplerKepler 联合创始人介绍金融 AI 中的指针式检索、确定性计算和访问控制。
 1:04:02EN → 简体中文AI Engineer· 2026年11月6日Lance Martin:审计提示词、改进评估并优化 Agent 成本Lance Martin · AnthropicAnthropic 工程师介绍提示词缓存、评估设计、爬山优化,以及可靠的长时间运行 agent 架构。
 23:05ZHAI Engineer· 2026年11月6日Ryo Lu:当我们什么都能做,还知道自己想做什么吗?Ryo Lu从 AI 生成的日记工具到爵士乐团,Ryo Lu 讨论如何在更强大的工具旁保有判断、生活和与他人合作的空间。
 19:19EN → 简体中文AI Engineer· 2026年11月6日Ben Holmes:用 Agent 追踪记录改进技能Ben Holmes · WarpWarp 工程师解释如何给对话评分,找出隐藏摩擦并提出可审阅的配置改进。
 19:43EN → 简体中文AI Engineer· 2026年11月6日知识图谱如何帮助映射 3,500 万行大型机代码Stephen Chin, Neeraj Deshmukh · Neo4jStephen Chin 与 Neeraj Deshmukh 介绍旧系统现代化中的上下文、agent 编排与行为一致性测试。