30 秒看懂
Lance Martin 介绍通过提示词审计、缓存和可衡量优化来改进 Claude 应用的实践。在较长的问答中,他讨论开放式评分、过拟合、模型思考强度、评估责任和可恢复的 agent 框架。报告的节省幅度属于具体示例。
- 1审计旧提示词衡量效果后移除过时或相互矛盾的指令。
- 2保持缓存前缀稳定稳定的请求前缀有助于复用缓存。
- 3构建可优化的评估检查提升空间、模型扩展趋势与多次运行的波动。
- 4注意过拟合使用保留测试集与有代表性的生产案例。
- 5让长期运行可恢复将会话状态与运行框架和沙盒分离。
要点建议
- 结合实际任务审计旧指令和相互矛盾的指令。
- 稳定前缀与缓存诊断可以降低重复输入成本。
- 有用的评估需要有意义的提升空间、代表性案例和较小波动。
- 优化期间用保留案例发现过拟合。
- 长时间运行的 agent 需要可恢复状态、隔离和合适的凭据管理。
按章节阅读整理后的全文
提示词债务
Martin 解释这一实践及其取舍,并结合示例和观众提问展开。
Anthropic 的 Lance Martin 认为,应用团队常因细小配置错误而未达到可实现的成本与质量前沿。修正这些问题有时可以同时提高质量并降低成本。
提示词和代码一样会积累债务。Martin 建议检查为旧模型编写的指令,包括一律要求逐步思考、反复检查或尽可能详尽的要求。
他的判断取决于模型和任务:较新的前沿模型可能在这些仪式上花费不必要的 token。相互矛盾的规则也可能让更擅长遵循指令的模型困惑。删除指令前应衡量实际任务中的效果。
Martin 演示用于 Claude Code 配置和 API 应用的提示词审计技能。它们会检查项目指令、工具和提示词,寻找可能不再有帮助的模式。
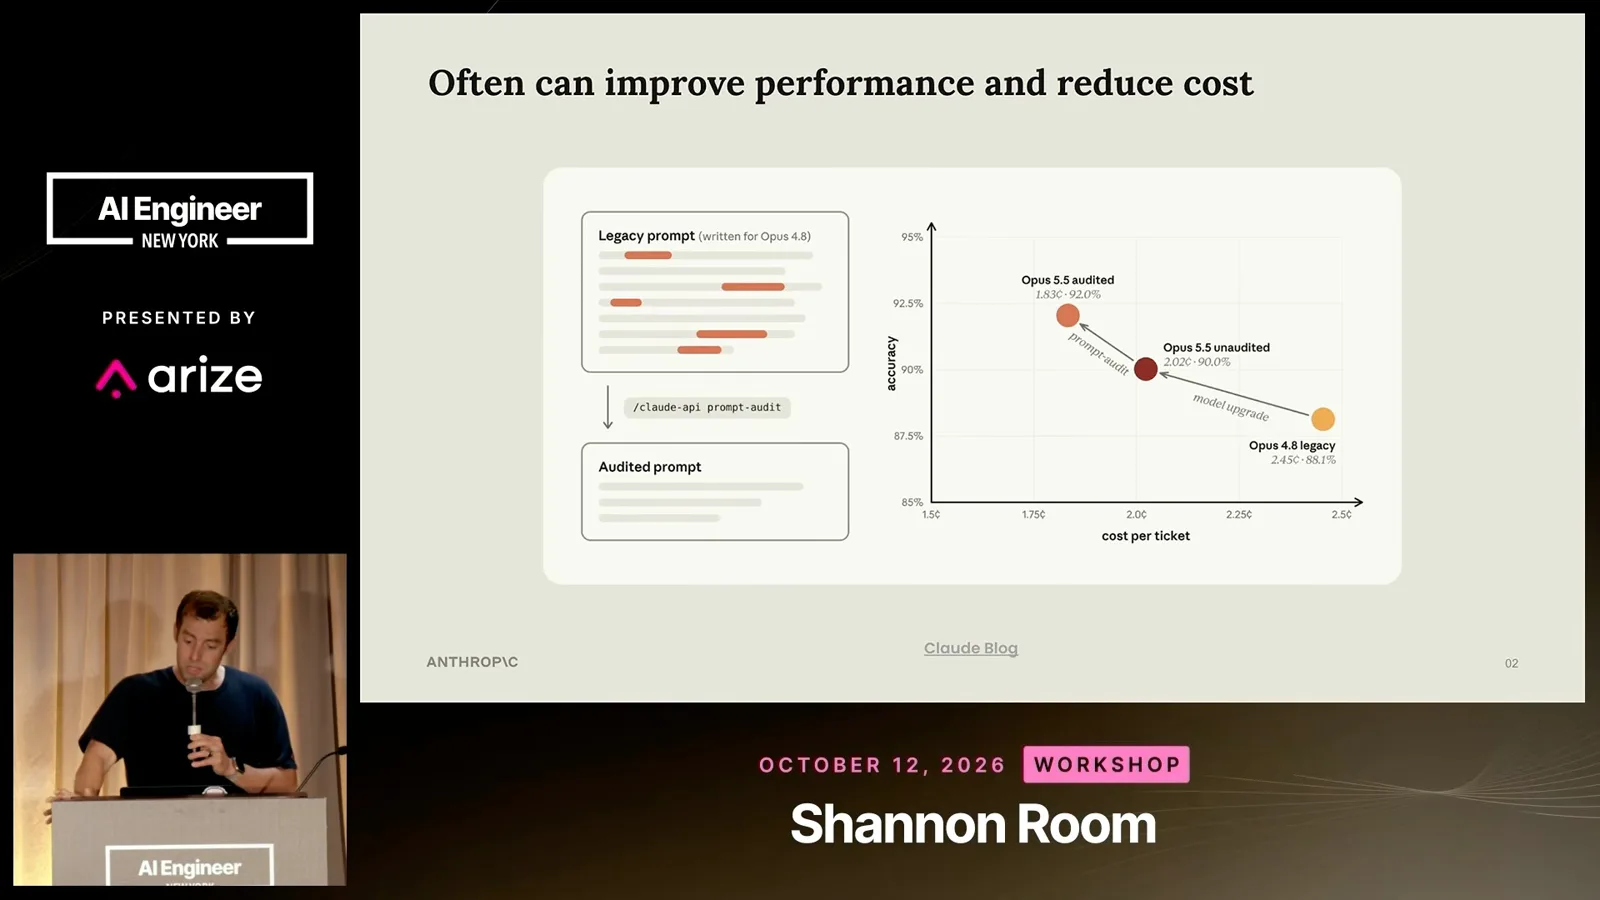
在约 50 个合成客服工单的评估中,他比较了旧提示词、模型升级和审计后的提示词。该基准中审计提高了报告得分并降低成本,但不能保证适用于所有工作负载。
提示词缓存
Martin 解释这一实践及其取舍,并结合示例和观众提问展开。
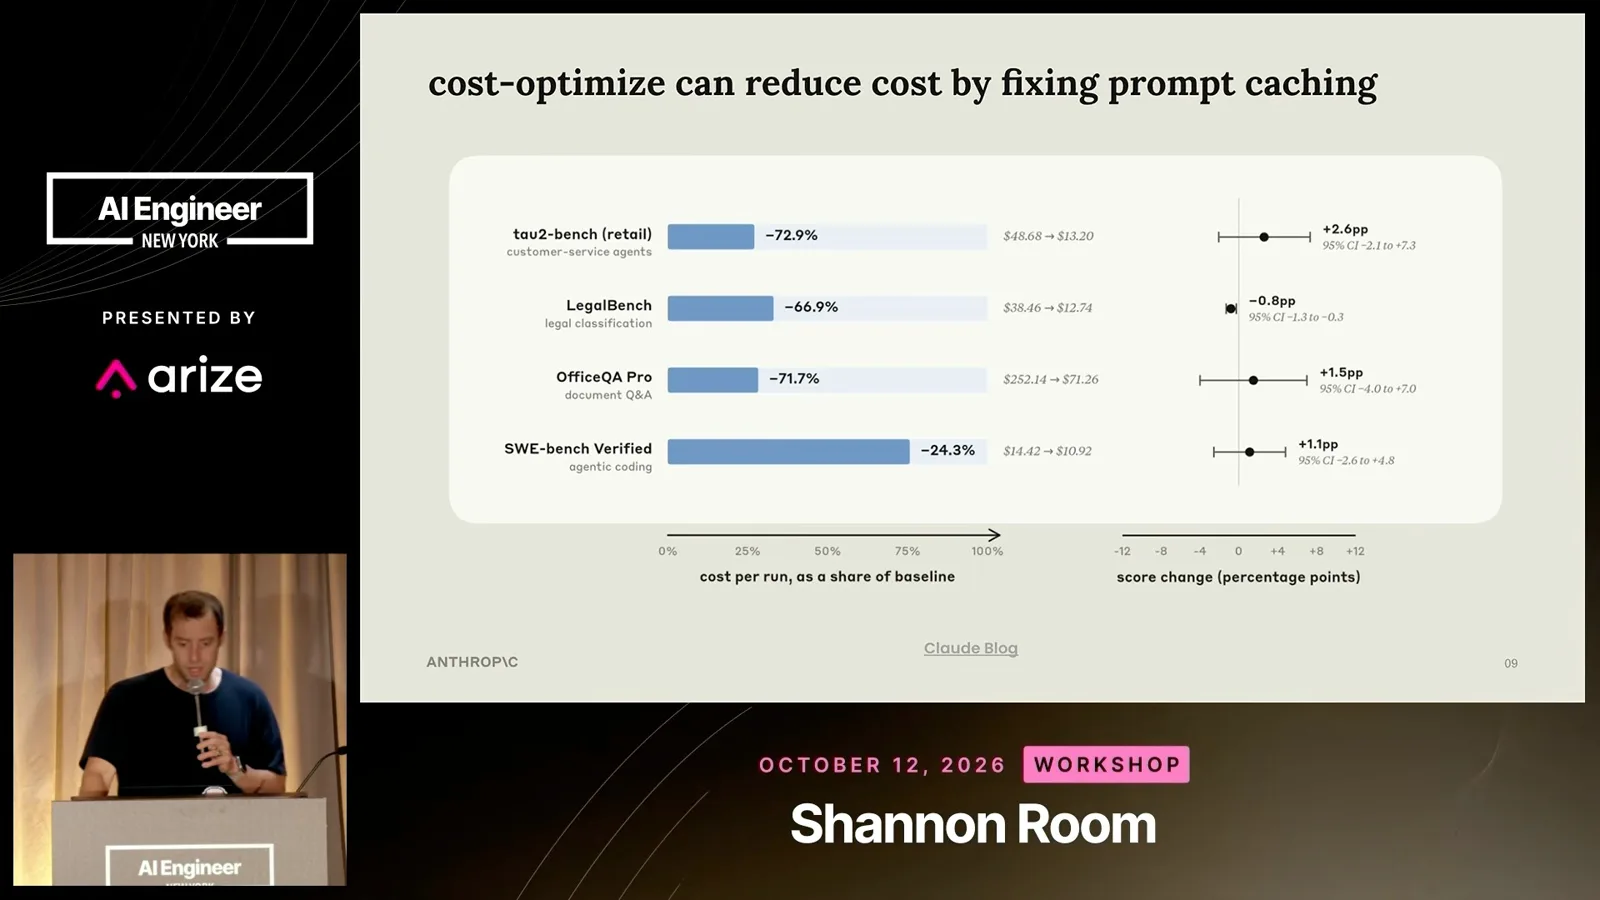
接下来是提示词缓存。Agent 对话在多轮之间重复大量上下文,因此读取缓存 token 可以降低成本和延迟。Martin 提醒,具体价格取决于模型,应自行核对。
缓存要求前缀匹配。请求前部的变化可能使可复用前缀失效,因此在 API 允许时,应把稳定的系统指令和工具放在项目、会话与每轮变化的内容之前。
他建议监控缓存命中率,并用诊断工具寻找可重排的提示词。他的团队报告,在内部基准运行框架中修正缓存使用后,成本最多降低约 72%,测得的性能没有明显变化。
设计可优化的评估
Martin 解释这一实践及其取舍,并结合示例和观众提问展开。
对于优化,Martin 说有用的评估必须可供持续改进:更强模型和更多思考通常应有帮助,最佳模型仍应有提升空间,多次运行的波动应较小。
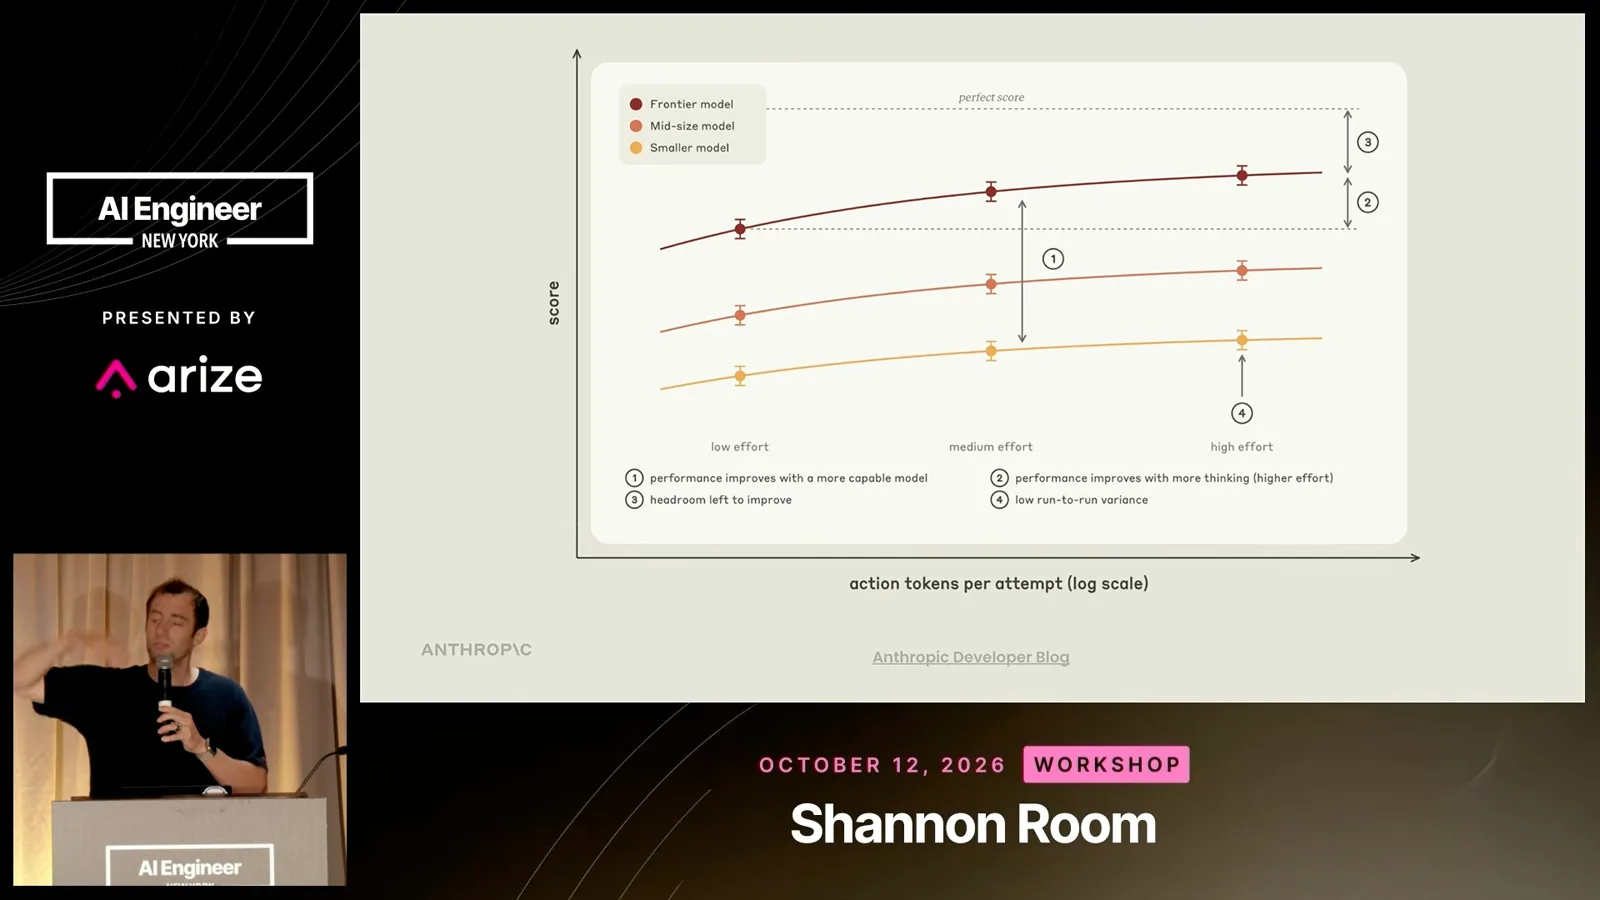
模糊或不可能完成的案例会制造虚假的提升空间。团队可能花费大量 token 追求合理方案无法达到的分数,因此应在搜索前检查数据和评分标准。
他介绍一个 Claude Code 技能,可根据追踪记录或其他数据帮助构建评估。用户仍需决定什么重要、检查样例,并确认评分器是否反映期望行为。
爬山优化与过拟合
Martin 解释这一实践及其取舍,并结合示例和观众提问展开。
评估可靠之后,agent 可以反复修改提示词或技能并衡量结果。Martin 将其称为爬山优化,但提醒说,提升可能只是对评估集过拟合,并不代表生产表现改善。
例如,优化器可能因为某个基准案例需要 OCR 而增加工具,尽管真实用户并不需要。基准样例中特有的措辞也可能诱导出无法泛化的提示词修改。
他的方法将样例分为训练集和测试集。优化器查看训练集中的失败案例;如果训练表现改善而保留测试集的得分不变,就可能出现过拟合预警。
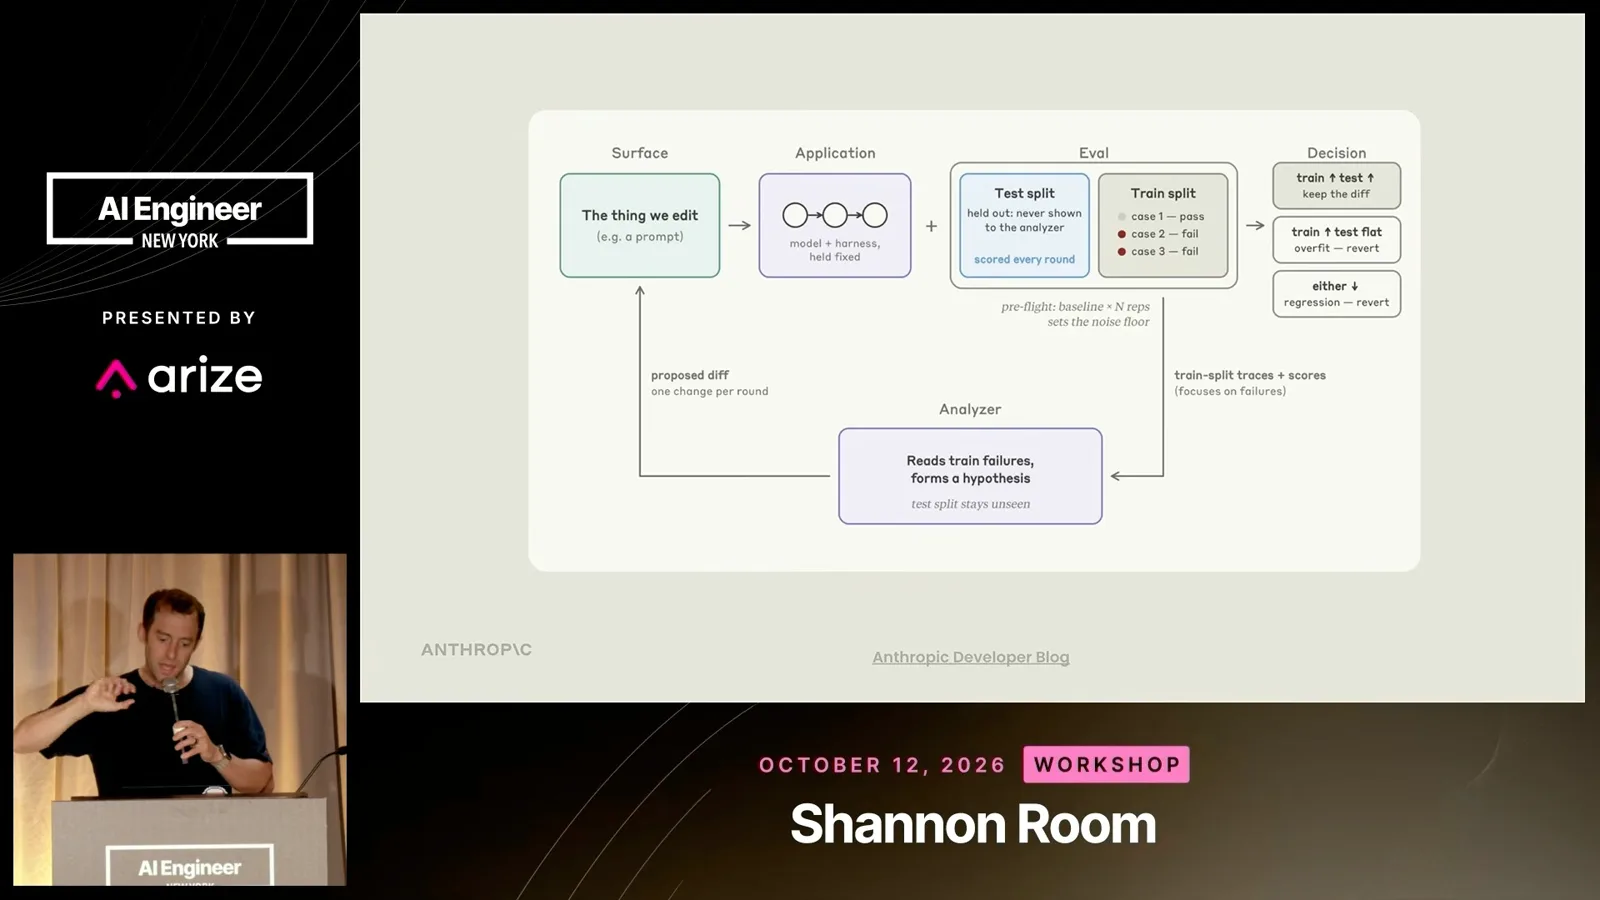
Martin 介绍了一个 Claude API 文档技能的改进过程:它最初在他的评估中得分 66%。他让系统检查失败案例并对照文档修改技能,这是范围清晰且可衡量的优化对象。
搜索更低成本
Martin 解释这一实践及其取舍,并结合示例和观众提问展开。
同样的过程可以在保持至少基线性能的同时搜索更低成本。它可以尝试模型、思考强度和提示词的组合,拒绝让评估表现下降的配置。
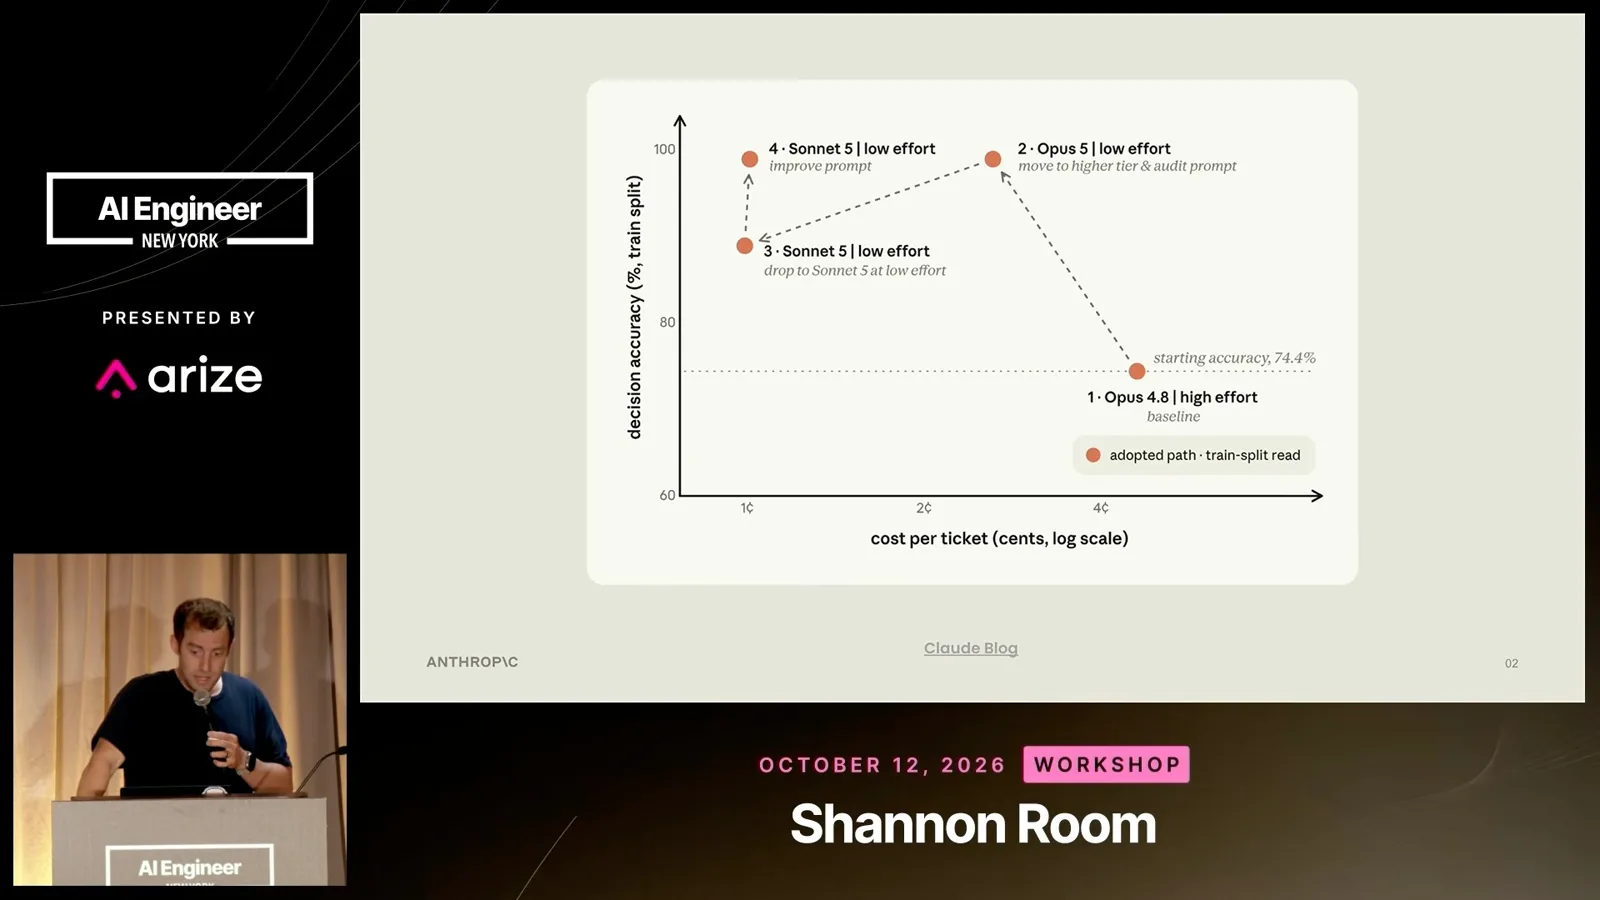
在一个客服示例中,Martin 报告称,通过更换模型与思考强度并调整提示词,成本降低约 90%,性能还得到提升。这是该合成基准的具体结果。
他的经验法则是试试更强模型配合较低思考强度:它可能比高强度运行的较弱模型使用更少 token。最佳选择仍应通过实验确定,也取决于任务和价格。
长时间运行的 agent 框架
Martin 解释这一实践及其取舍,并结合示例和观众提问展开。
长时间运行的 agent 需要不同于短对话的运行框架。当 agent 可能运行数小时或数天时,Martin 特别关注可恢复性和安全性。
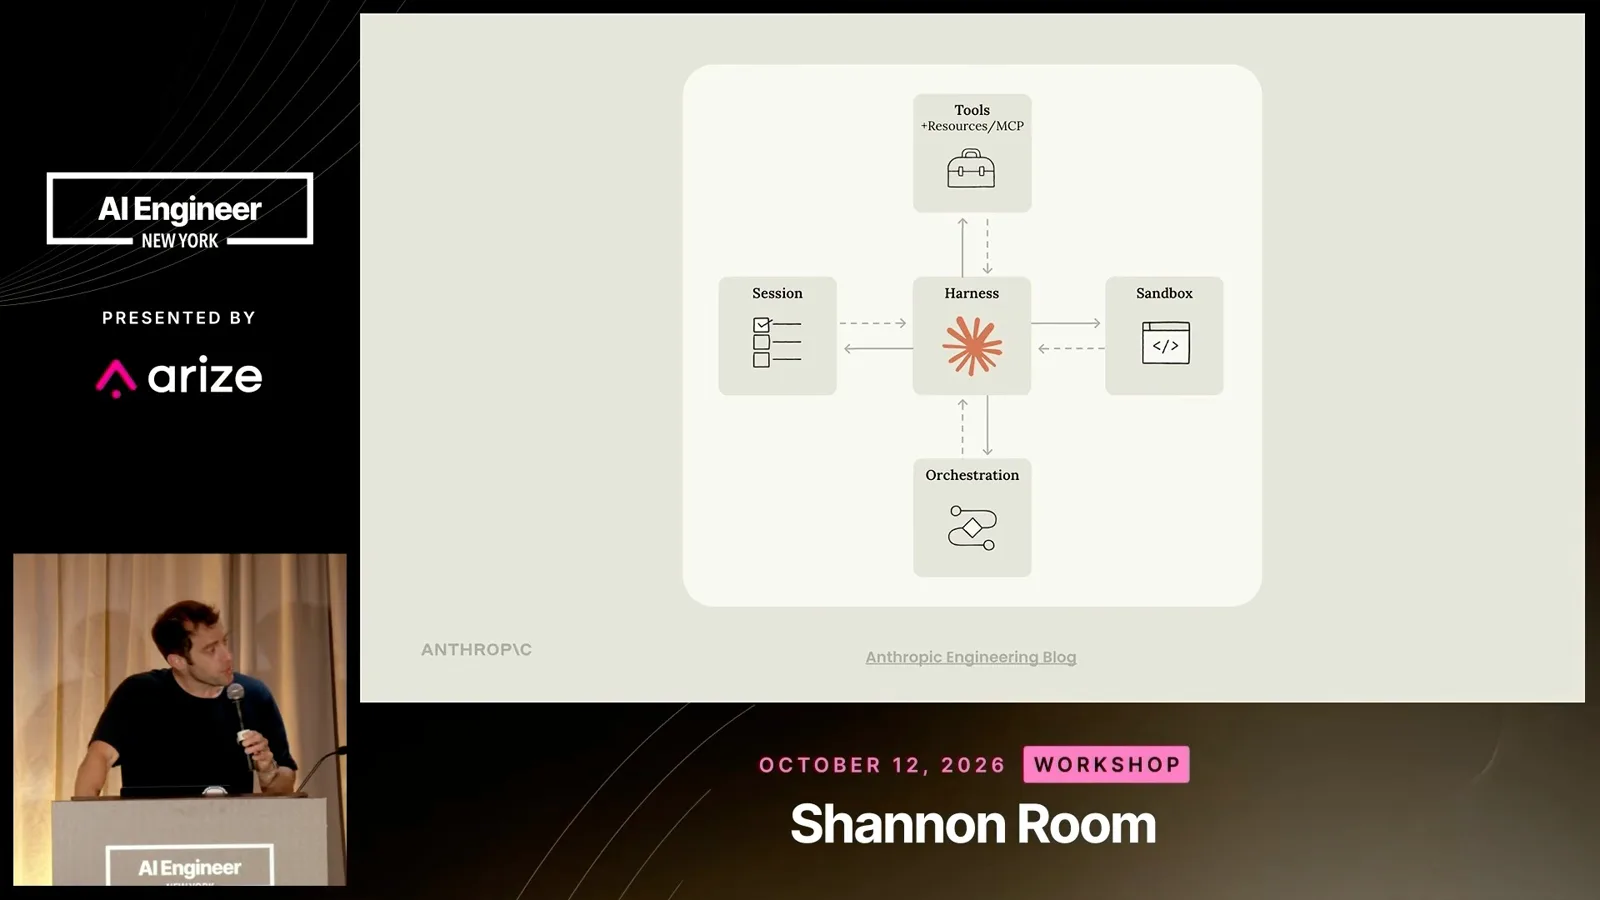
他描述将 agent 运行框架、沙盒和只追加的会话日志分离。如果沙盒或运行框架失败,编排层可以重新创建它,并从独立保存的状态恢复会话。
对于凭据,Martin 说托管 agent 使用保险库,让模型通过工具引用凭据而不直接看到内容。他将其作为长时间自主运行的一项控制措施。
他的总结将各部分连起来:审计提示词、使用缓存、设计良好评估、防止过拟合,并为长期工作选择可恢复且安全的运行框架。
人机协作设计评估
Martin 解释这一实践及其取舍,并结合示例和观众提问展开。
被问到评估设计能自动化多少时,Martin 说 Claude 可以扫描追踪记录并寻找可能失败的案例。他希望工作流先向人展示原始样例,再将其转成评估案例。
只要人类反馈能够区分更好和更差的结果,就可以将其转成爬山优化的评估信号。Martin 强调协作:人设定目标、检查数据,模型协助重复工作。
提示词和技能是方便的优化对象,因为它们容易修改且直接影响行为。修改整个运行框架也可行,但更大的代码变更更难解释。
便利也伴随风险:提示词很容易过拟合。即使有训练集和测试集,也不能代替具有代表性的样例和对真实生产行为的仔细检查。
对于重复工作流,Martin 建议让模型把流程整理成可复用技能。优化时,可以从简单的基线技能开始,再根据定义好的评估改进。
开放式工作的评分
Martin 解释这一实践及其取舍,并结合示例和观众提问展开。
开放式任务比答案可确定的测试更难评分。Martin 建议先写出人能理解的评分标准;可行时使用清晰的二元检查,而不是含糊的数字评分。
他建议用多个模型和多次运行检查评分标准。成对比较也有帮助:判断两个作品哪个更好,可能比给单个作品打一个任意分数更可靠。
评估分布应反映生产中重要的案例。如果只抽取某个模型的失败案例,基准就可能偏向该模型特有的弱点,而另一个模型可能因偶然原因解决这些案例。
Martin 澄清,只要各等级定义清楚且评分者能够达成一致,也可以使用多个评分类别。二元评分是简化问题的方法,并非每项评估的硬性要求。
个人自动化是否需要评估取决于任务的重要性。生成重要对外交付物或处理敏感工作的流程,比低影响的便利工具更需要严格检查。
搜索停滞与思考强度
Martin 解释这一实践及其取舍,并结合示例和观众提问展开。
爬山优化并不保证收敛。Martin 说,如果过程停滞,优化器可以对剩余失败案例聚类,寻找模糊指令或有问题的评分器,而不是无限消耗资源解决不可能的案例。
他说爬山优化技能是开源的,可能适配其他框架,但他本人没有核实所有集成细节。底层循环具有一般性:提出修改、衡量结果并保留有用的变化。
谈到思考强度设置时,Martin 建议先试能力较强的模型和低强度,只有测量结果表明有必要时再提高。小模型在高强度下可能花费更多 token,却不一定得到最佳结果。
一次优化运行也需要预算。定义不清的评估可能让系统在模糊案例上消耗大量 token,因此支出上限和评估质量需要配合。
人负责确定目标和重要事项;随后 Claude 可以检查追踪记录并标记可能的失败。人们在将候选案例加入评估集之前再进行审阅。
责任归属与 autoresearch
Martin 解释这一实践及其取舍,并结合示例和观众提问展开。
Martin 说,评估责任通常跟随产品责任,而不是专属于某个专业团队。工具可以减少搭建工作,让不同角色的人更容易参与。
对于生成式界面,他见过成对评分器在多轮试验中比较不同版本并汇总结果。只要评分标准设计谨慎,类似的模型评分也可用于检索和写作。
他将这一方法与 autoresearch 联系起来:两者都使用可衡量目标、运行实验并根据结果调整。具体优化对象和目标不同,因此工作流可能需要适配。
成本、质量和速度等多个目标可以一起考虑,但每增加一个目标都会让搜索更难。Martin 认为,有时逐次调整一个维度可能有帮助。
被问到提示词审计建议适用于多早的模型时,他说新旧模型之间的边界并不精确。该技能包含一些模型专属指导,团队迁移时应测试修改。
他把思考强度解释为对模型思考程度的引导,而不是简单的硬性上限。困难任务可能让高强度设置昂贵得多,因此团队应比较结果与 token 使用量。
这一方法使用目标和训练测试划分,和训练有相似之处;但 Martin 区分说,这里是在部署后于运行时修改提示词或技能。
评估意识是更广泛的问题,但他认为在此场景中过拟合是更直接的实际问题。模型可以利用基准特性提高分数,而这些改动未必适用于生产。
小数据集与长任务
Martin 解释这一实践及其取舍,并结合示例和观众提问展开。
小评估集可能噪声大、缺乏代表性且容易过拟合。Martin 没有给出通用最小规模;他建议根据所需信号和任务选择数据量。
对于持续时间很长的任务,每轮优化耗时更久,失败的代价也更高。当搜索运行许多小时或数天时,可靠且可恢复的基础设施就成为必需。
Agent 评估可能需要多轮交互,可以对完整轨迹、最终结果或两者评分。追踪记录是构建案例的有用输入,但合适的评分设计取决于任务。
谈到上下文可靠性时,Martin 再次强调让会话日志独立于运行框架。这样 agent 在压缩上下文后仍能检索旧材料,而不会丢失以后可能有用的信息。
让评估持续有用
Martin 解释这一实践及其取舍,并结合示例和观众提问展开。
开放式和非确定性任务对评估设计提出更高要求。明确目标、可理解的评分标准、评分者之间的一致性和较小波动,能给优化器更有用的信号。
随着模型改进,Martin 预计健康的评估应显示相应进步;已经饱和或含糊的基准可能需要替换。设计有挑战性的评估仍是一项持续工作。
他介绍生产反馈循环:监控追踪记录,将有意义的失败加入离线评估,针对它们优化,并把已解决案例保留为回归测试。难点在于判断生产中的哪些结果真正重要。
同频道的其他文章
 31:22EN → 简体中文
 AI Engineer· 2026年11月7日Nouha Dziri:如何降低编码智能体团队的成本Nouha Dziri · CohereProgramBench 和 Commit0 上的实验说明,任务瓶颈、主智能体模型和协调方式比单纯增加智能体数量更重要。
 19:34EN → 简体中文AI Engineer· 2026年11月7日云端智能体如何辅助审核证券主数据变更Amol Kapoor, Clifford Ressel · Nori AgenticAmol Kapoor 和 Clifford Ressel 解释私募资产数据为何难以核对,以及智能体如何辅助人工审核。
 18:28EN → 简体中文AI Engineer· 2026年11月7日Vinoo Ganesh:如何让 AI 回答建立在可验证的事实之上Vinoo Ganesh · KeplerKepler 联合创始人介绍金融 AI 中的指针式检索、确定性计算和访问控制。
 23:05ZHAI Engineer· 2026年11月6日Ryo Lu:当我们什么都能做,还知道自己想做什么吗?Ryo Lu从 AI 生成的日记工具到爵士乐团,Ryo Lu 讨论如何在更强大的工具旁保有判断、生活和与他人合作的空间。
 19:19EN → 简体中文AI Engineer· 2026年11月6日Ben Holmes:用 Agent 追踪记录改进技能Ben Holmes · WarpWarp 工程师解释如何给对话评分,找出隐藏摩擦并提出可审阅的配置改进。
 19:43EN → 简体中文AI Engineer· 2026年11月6日知识图谱如何帮助映射 3,500 万行大型机代码Stephen Chin, Neeraj Deshmukh · Neo4jStephen Chin 与 Neeraj Deshmukh 介绍旧系统现代化中的上下文、agent 编排与行为一致性测试。