30 秒看懂
Kepler 联合创始人兼首席执行官 Vinoo Ganesh 解释 AI 系统给出错误数字的三种途径:选错文件、抽取错误数值和算术出错。他介绍了一条处理流程:预处理事实并分配指针,由代码检索和计算,再检查生成结果的引用。 Ganesh 还讨论了广泛检索、按租户限制访问以及拒绝没有依据的事实。他同时提醒,模型输出仍可能包含无依据的数字,因此需要进一步检查。
- 1数字出错的三种途径Ganesh 区分了检索到错误来源、从正确来源抽取错误数值以及算术错误。
- 2事实变成指针所介绍的流程提前将事实结构化,再由代码解析标识符并执行计算。
- 3先广泛搜索,再缩小范围系统结合语义和关键词检索、排名融合与交叉编码器来筛选候选结果。
- 4检索必须考虑安全租户过滤、身份检查以及搜索和直接读取之间一致的访问规则都很重要。
- 5仍需检查最终输出Ganesh 说无依据输出减少但并未消失,因此系统还使用后处理检查。
要点建议
- 错误数字可能来自来源选择、数值抽取或算术计算,每种情况需要不同的控制。
- 预处理事实与可解析指针可以让回答到来源的路径变得可检查。
- 确定性计算避免依赖语言模型在生成文字时完成算术。
- 指针有效并不能证明底层来源本身正确,也不能证明选对了来源。
- 文件检索必须在整个系统中执行租户和用户访问规则。
- 无依据的说法应被纠正或拒绝,最终输出也需要检查。
按章节阅读整理后的全文
金融行业为何需要可验证的回答
Ganesh 认为模型既可能编造事实,也可能遗漏公司的内部上下文。他将信任与责任归属、可检查的工作成果联系起来。
Kepler 联合创始人兼首席执行官 Vinoo Ganesh 延续了此前演讲的主题:金融机构需要验证 AI 工作成果的方法。他认为,只在回答生成后附加验证层,会错过流程前段的重要设计选择。
Ganesh 说,华尔街的信任问题并不只是模型偶尔编造数字。公司的研究和内部数据可能从未被检索到,也没有体现在回答中。与此同时,他重视能帮助投资者获得优势的创造性分析,也就是他所说的 alpha。
金融公司正在采购检索系统、自建工具并试运行智能体,但演示令人信服,不代表专业人士会依赖其回答。Ganesh 将信任部分视为责任归属问题:必须有人能够理解工作结果并为其负责。
数字出错的三个来源
错误文件、错误抽取和算术错误需要不同的干预。他主张使用确定性工具完成计算。
他指出数字答案出错的三种途径。第一,检索可能返回错误文件;何为正确来源本身也取决于公司更信任自己的分析,还是某位外部分析师。
第二,系统可能找对文件,却抽取了错误数值。例如,较晚发布的年度报告可能包含多个年度的数据,询问 2023 年营收时不能引用 2025 年的数字。引用检查有帮助,但事后过滤本身并不会改变答案生成过程。
第三,模型可能出现算术错误。Ganesh 主张用确定性代码计算,而不是依赖生成文本完成算术。他希望让模型负责规划和解释,常规工具则负责自己擅长的操作。
指针、结构化事实与查询
Kepler 预处理事实并分配标识,由模型规划要查询的材料。代码解析存储的事实,后续环节再检查输出。
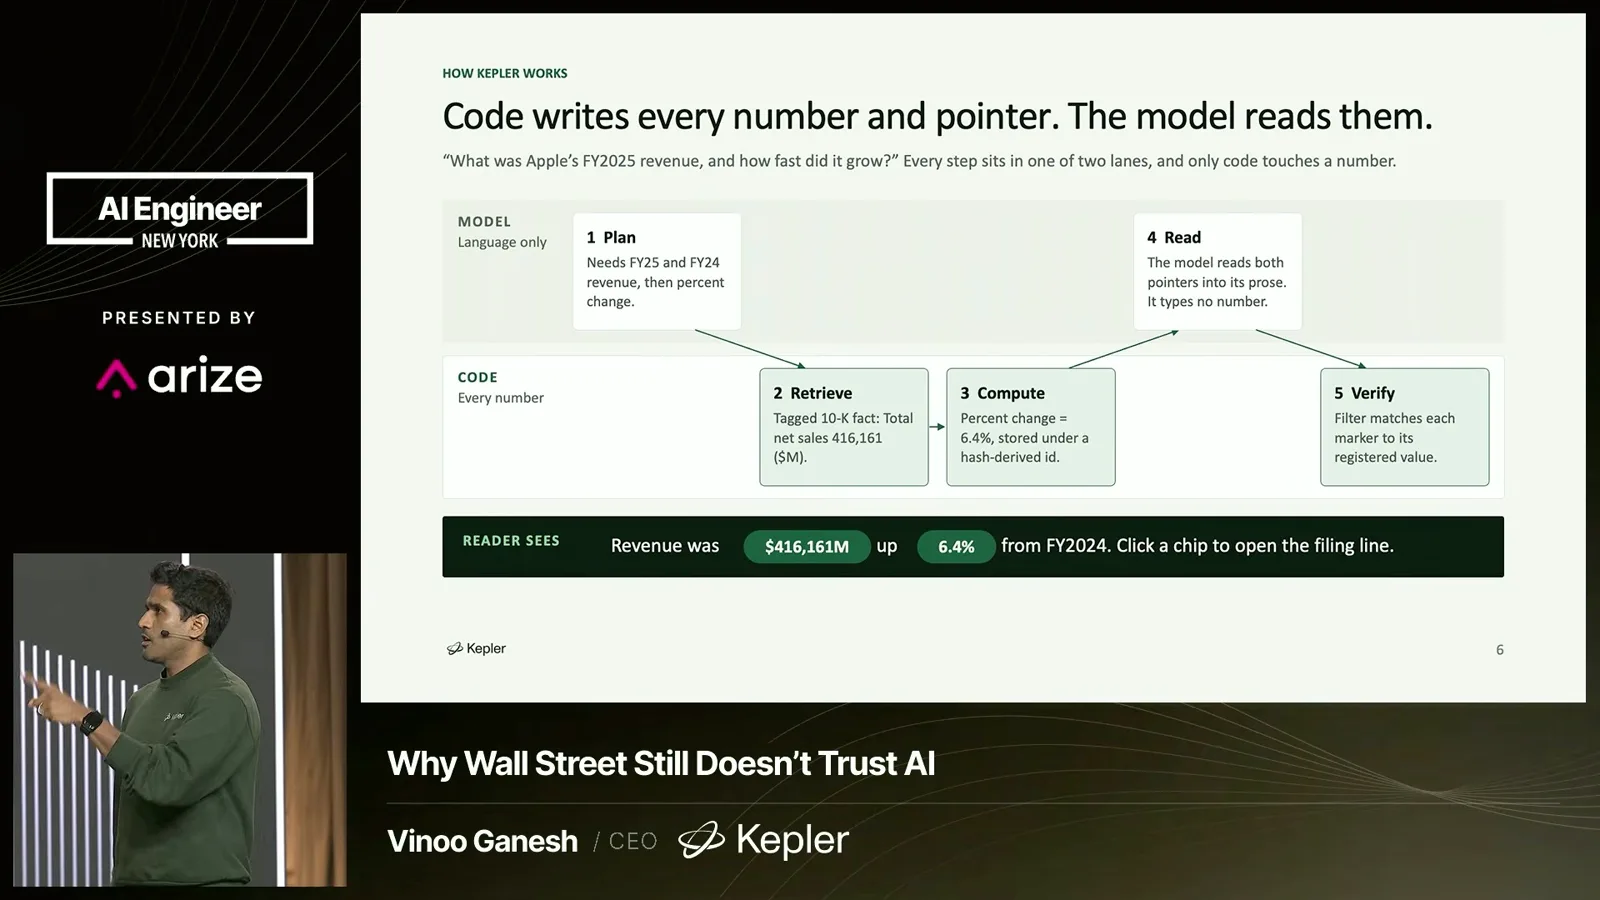
他说,在 Kepler 的设计中,预处理会从文件抽取事实并存入结构化存储,为每项事实分配标识或指针。模型规划要查询哪些来源和实体,代码随后检索所指向的事实并执行计算。这样,部分工作从每次查询时重复读取转移到了预处理阶段。
Ganesh 说,输出路径被设计为先解析指针,数字才能出现,之后还有独立验证环节。读者可以点击引用查看来源。他在演讲后面承认,模型在推理时仍可能生成无依据数字,因此还需要额外后处理。
结合曾在 Citadel 从事业务工程的经历,Ganesh 将模型比作配备确定性工具的优秀分析师。投资者既需要可靠数据,也需要在信息不完整时作出判断。目标是查出已知事实,并谨慎推理仍未知的部分。
他介绍,能够确定性表示的信息会被存储;较不结构化的信息经过预处理后进入混合存储系统。搜索和重排序负责识别候选材料,指针解析随后取得具体的存储值。查询可以可靠返回存储值,但选错指针或存入错误数值仍是独立风险。
广泛搜索与访问控制
检索流程结合语义搜索、关键词搜索和重排序。安全规则必须同时约束搜索和直接读取文件。
为了广泛检索,系统结合近似最近邻搜索和 BM25,再用倒数排名融合及交叉编码器缩小候选范围。他的幻灯片展示了从最多 200 个候选结果缩减到 100 个、20 份文件,最终得到 10 个结果的漏斗;图中的 RRF 参数 k 为 60。
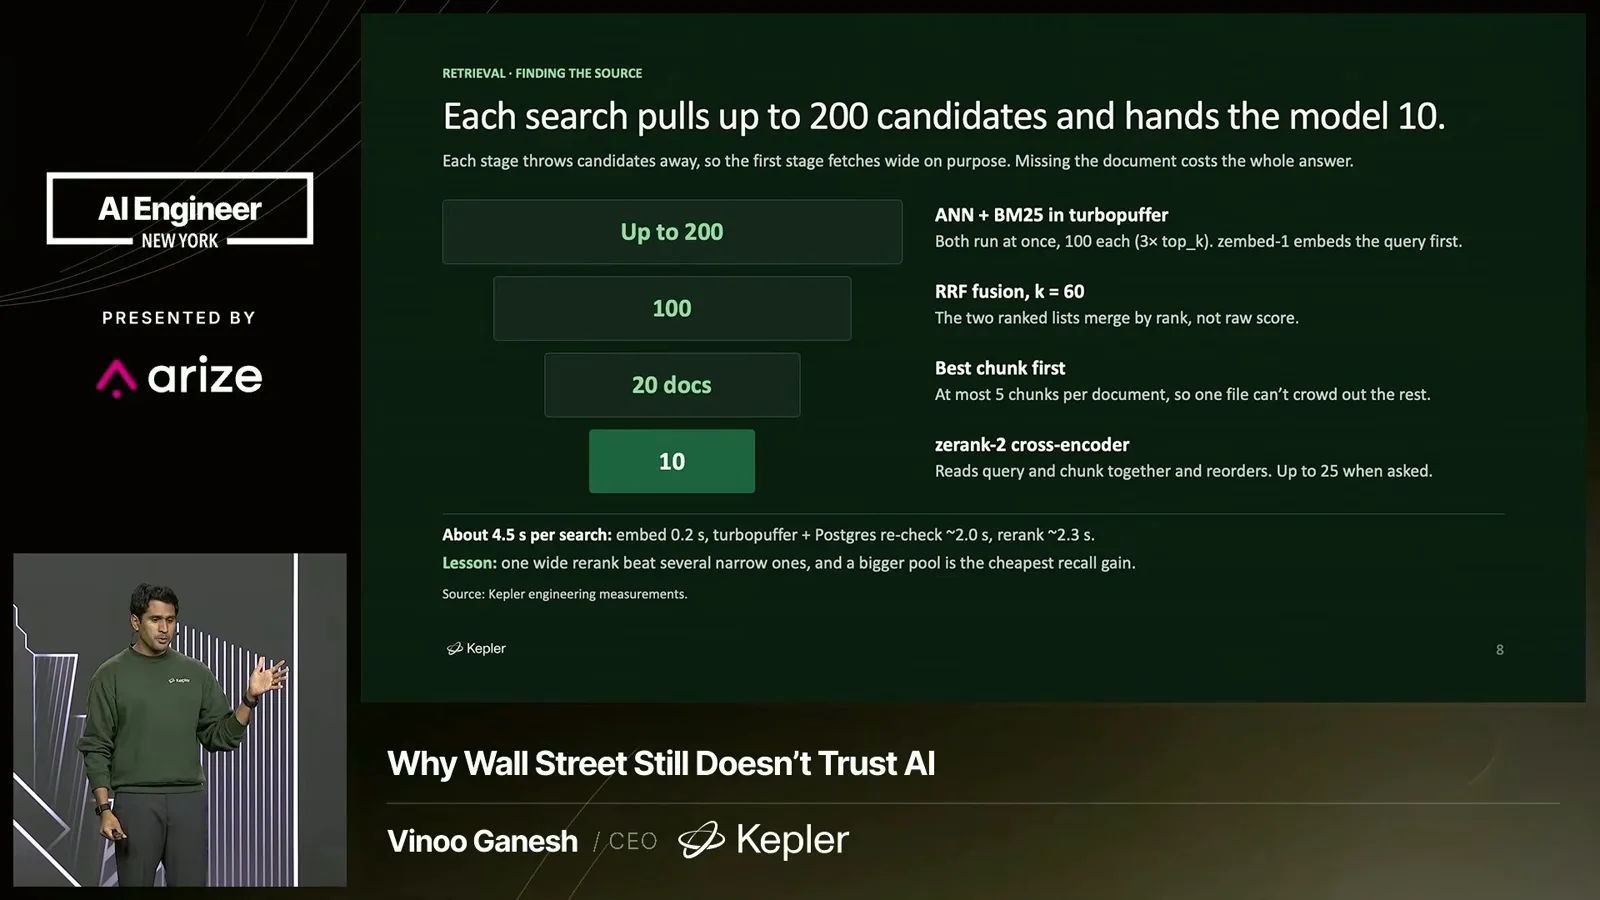
Ganesh 主张先广泛搜索,再逐步缩小范围。根据他的经验,智能体可能倾向于接受较早出现的结果,而不是探索更广泛的来源,部分原因是检查更多材料有成本。该设计试图让广度成为检索系统的属性,而不只依赖模型的搜索计划。
随后他谈到文件检索安全。可能的故障包括遗漏租户过滤、未经适当检查就接受调用方声称的身份、返回过期结果、允许直接读取绕过搜索规则,以及查询尚未填充完成的索引。
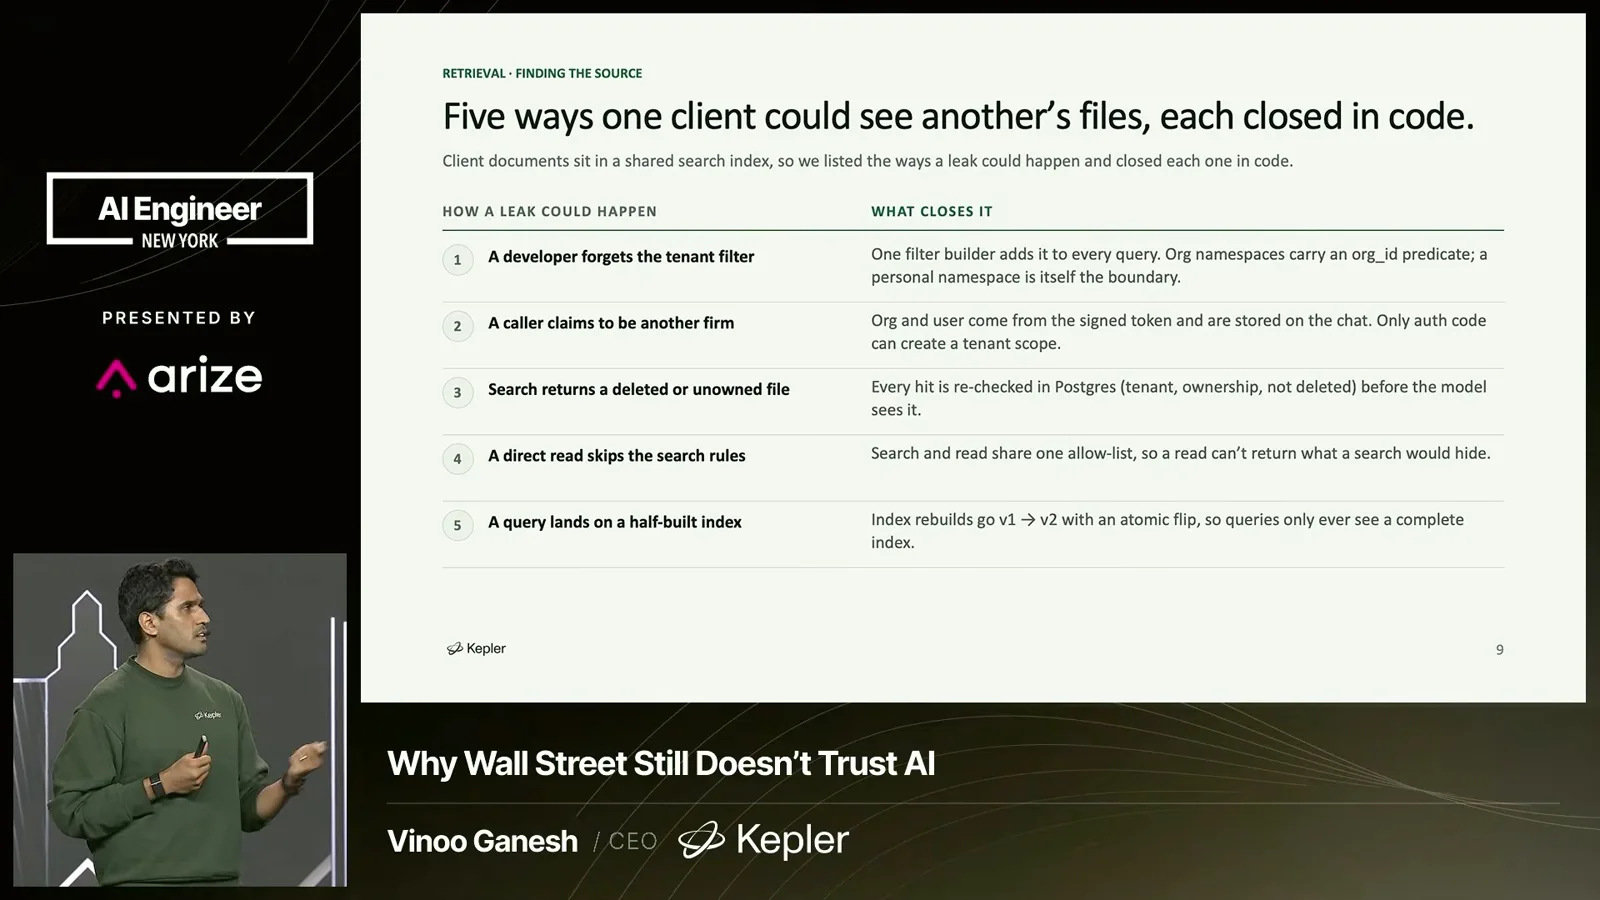
他建议把授权内置到每次查询和每条文件访问路径的范围控制中。金融公司的研究可能高度敏感,因此找回有用上下文还不够:系统也必须防止用户或租户收到无权访问的材料。
验证与生产表现
Ganesh 介绍引用应被验证、纠正或拒绝的约定,并承认模型生成的无依据数字仍需要后处理。
谈到验证时,Ganesh 描述了如何用标识符和哈希把存储的事实关联回源材料。如果所请求的指针无法解析,就不应返回事实。这有助于检查出处,但本身不能证明底层来源正确,或证明系统选对了来源。
他提出的目标约定是:引用要么得到验证,要么在搜索时纠正,要么被拒绝。同样的模式也可以用于金融之外,例如检查引用的法律判例是否真实存在。更广泛的目标是让事实来源可见,而不是事后仅附上看似合理的引用。
Ganesh 担心,不可靠的输出会让机构拒绝本来有用的 AI 工具。他认为,更广泛的采用需要数字和来源都能接受检查的系统,而不只是能生成流畅演示文稿的系统。关于行业采用现状的说法是他的个人判断。
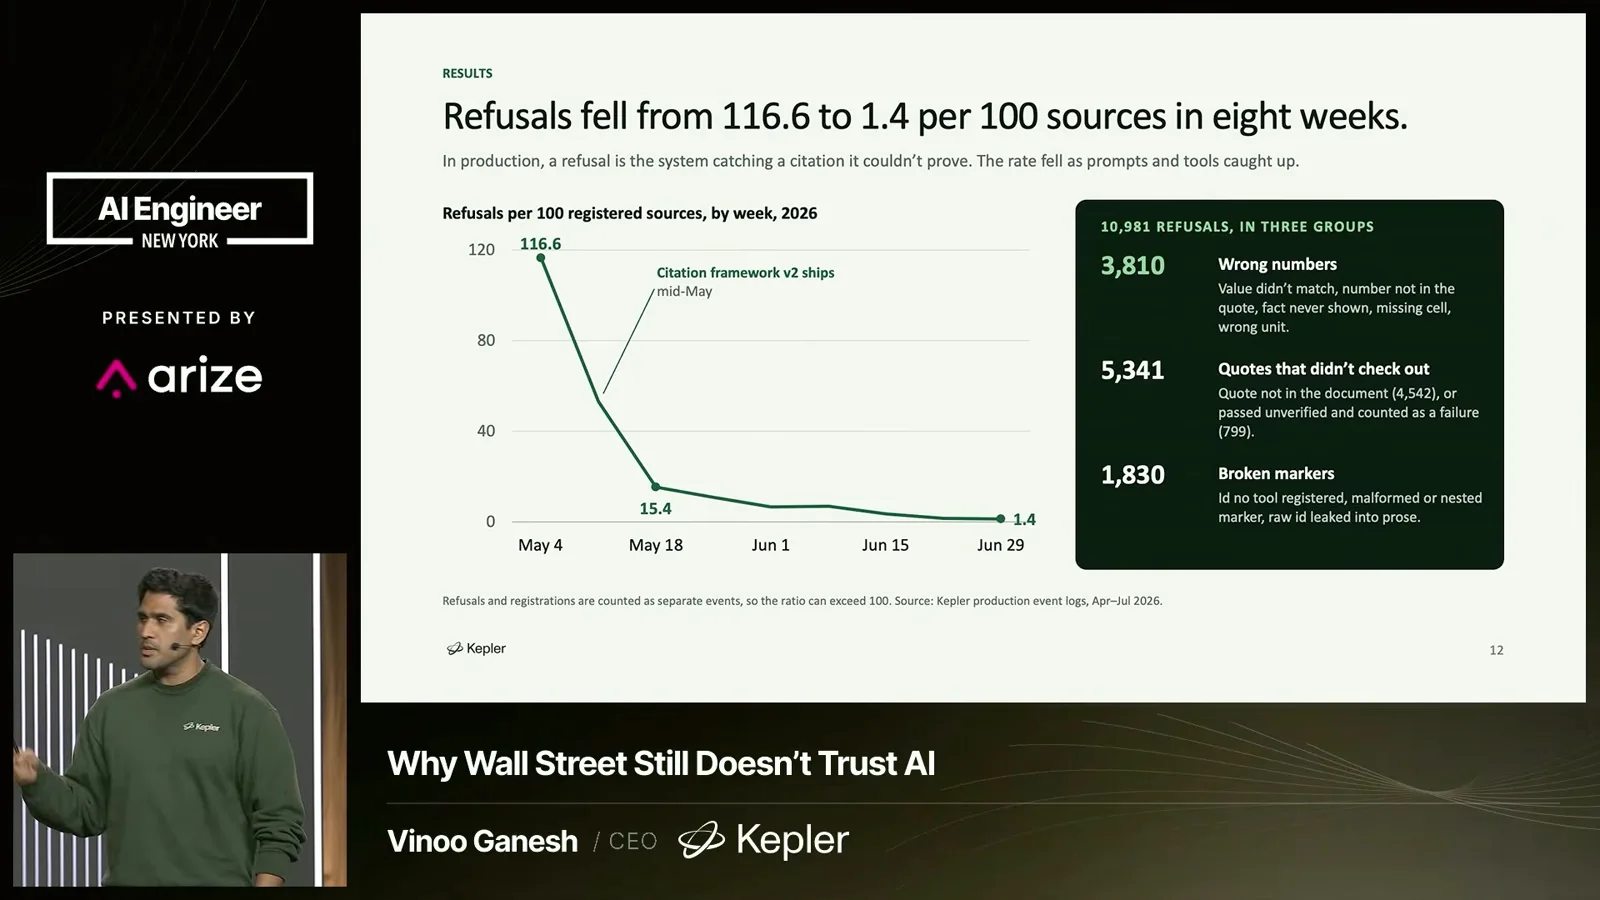
他展示生产结果时说,团队引入指针处理后,无依据数字导致的拒绝事件显著减少,但没有降到零。他承认概率模型在推理过程中仍可能生成数字,因此实现中还有后续检查环节。演讲提供的信息不足以把该结果当作通用基准。
建设者和供应商应回答的问题
他要求团队检查来源、计算、授权与缺失事实。演讲以呼吁为模型配套可靠基础设施作结。
他向建设者提出的实际要求是让数字可检查,无论它来自抽取、计算还是两者结合。他建议询问供应商:是否检查每条引用和算术步骤,访问控制能否防止未授权文件到达客户,以及事实没有来源时会发生什么。
Ganesh 最后表示,即使模型更强,仍需要可靠的数据基础设施和精心设计的配套软件。数据库中缺失的值不应悄悄变成编造的事实;可信应用需要检索、控制和验证共同发挥作用。
同频道的其他文章
 31:22EN → 简体中文
 AI Engineer· 2026年11月7日Nouha Dziri:如何降低编码智能体团队的成本Nouha Dziri · CohereProgramBench 和 Commit0 上的实验说明,任务瓶颈、主智能体模型和协调方式比单纯增加智能体数量更重要。
 19:34EN → 简体中文AI Engineer· 2026年11月7日云端智能体如何辅助审核证券主数据变更Amol Kapoor, Clifford Ressel · Nori AgenticAmol Kapoor 和 Clifford Ressel 解释私募资产数据为何难以核对,以及智能体如何辅助人工审核。
 1:04:02EN → 简体中文AI Engineer· 2026年11月6日Lance Martin:审计提示词、改进评估并优化 Agent 成本Lance Martin · AnthropicAnthropic 工程师介绍提示词缓存、评估设计、爬山优化,以及可靠的长时间运行 agent 架构。
 23:05ZHAI Engineer· 2026年11月6日Ryo Lu:当我们什么都能做,还知道自己想做什么吗?Ryo Lu从 AI 生成的日记工具到爵士乐团,Ryo Lu 讨论如何在更强大的工具旁保有判断、生活和与他人合作的空间。
 19:19EN → 简体中文AI Engineer· 2026年11月6日Ben Holmes:用 Agent 追踪记录改进技能Ben Holmes · WarpWarp 工程师解释如何给对话评分,找出隐藏摩擦并提出可审阅的配置改进。
 19:43EN → 简体中文AI Engineer· 2026年11月6日知识图谱如何帮助映射 3,500 万行大型机代码Stephen Chin, Neeraj Deshmukh · Neo4jStephen Chin 与 Neeraj Deshmukh 介绍旧系统现代化中的上下文、agent 编排与行为一致性测试。