30 秒看懂
Cohere 研究员 Nouha Dziri 介绍了层级式编码智能体团队的实验。在 ProgramBench 上,让工作智能体探索黑盒程序并参与规划,以更低成本取得了接近全流程委派的得分;她说在 Commit0 上,实现阶段则是更重要的瓶颈。 团队还测试了主智能体与工作智能体的模型组合、团队规模和消息传递。所报告的约 70% 成本节省,是特定的强主智能体加低价规划工作智能体配置,与各阶段均使用工作智能体的配置相比得到的;结果依赖具体任务和框架。
- 1得分提高,成本也提高在最少指令下,阻塞式团队的得分提高近 10 个点,但成本约为单智能体的 4 至 7 倍。
- 2把工作智能体放在瓶颈处在黑盒 ProgramBench 任务中,仅委派规划就以约一半成本取得接近全流程团队的得分。
- 3任务不同,瓶颈也不同Dziri 说,Commit0 已提供规格和测试,因此增加实现阶段的工作智能体更有帮助。
- 470% 成本对比的基准报告中的节省是强主智能体加 16 个低价规划智能体,与各阶段都有工作智能体的团队相比,而非与所有基准相比。
- 5大多数消息发给主智能体约 84% 的消息从工作智能体发给主智能体;在所测框架中,增加同级消息并未提高得分。
要点建议
- 智能体团队可以提高编码任务得分,但未经优化的委派成本可能是单智能体的数倍。
- 应将工作智能体分配到任务受限的阶段:本实验中 ProgramBench 的瓶颈是探索,Commit0 则是实现。
- 明确的协调指令可以帮助异步主智能体等待并使用工作智能体的结果。
- 在所测配置中,强主智能体搭配低价工作智能体可以更低成本接近全强模型团队的表现。
- 同级消息在所测框架中没有带来收益,但任务拆分方式和工作智能体对同伴的有限可见性限制了这一结论。
- 更大规模团队仍面临自适应组织、通信、安全和对齐等问题。
按章节阅读整理后的全文
为什么使用编码智能体团队?
Dziri 将延长推理和独立采样,与把工作委派给拥有独立上下文的智能体作比较。协调与成本随之成为核心设计问题。
Cohere 高级研究员 Nouha Dziri 介绍如何提高编码智能体团队的效果,同时控制不断增长的成本。除了让模型推理更久或运行多个独立尝试,主智能体还可以把任务拆给拥有独立上下文的工作智能体,再合并它们的报告。
较长的编码任务可能填满单个智能体的上下文窗口,也需要等待很久。独立采样会让每次尝试重复整个任务;工作智能体则可以探索不同部分并返回精简发现。但这种优势依赖任务能够拆分,且各部分足够独立。
团队同时带来协调和成本问题。增加智能体会迅速扩大 token 预算;团队必须决定谁来领导、哪个阶段需要协助、工作智能体如何通信、需要多少成员,以及每个角色使用什么模型。
在最初的开放式配置中,智能体并没有自动组成分工清晰的团队。它们经常各自构建不同版本,通过主智能体传递消息,有时还会重复劳动或互相干扰。因此 Dziri 的团队明确研究了框架和指令设计。
实验框架与基准
研究者构建层级式共享工作区框架,在黑盒 ProgramBench 任务上比较阻塞式和异步主智能体。
研究者把团队设计视为算力分配问题:与单智能体相比,每增加一美元推理成本能买到多少额外任务得分?他们比较工作阶段、模型、团队规模和主智能体模型,希望提高得分,同时避免推理成本过高。
他们的精简层级结构给主智能体提供委派工具,工作智能体通过 shell 在共享工作区操作。主智能体决定生成多少成员及其工作,接收报告并整合结果,还可以监督、恢复或停止工作智能体。
团队比较了两种主智能体:阻塞式会等待所有委派工作完成;异步式则在报告陆续返回时继续工作。在最初配置中,后者有时会根据自己的猜测提前实现,忽略迟到的发现,或者在工作智能体完成前就提交。
ProgramBench 在空工作区中提供一个黑盒可执行程序和文档。智能体必须探测程序,发现接口及边界情况,再实现一个兼容版本。Dziri 称这些任务很难,并提到在 FFmpeg 任务上领先模型也只通过了少量测试。
协调和提示词设计
在最少指令下,团队以数倍成本提高得分。更明确的指令改善协调,也帮助异步主智能体使用工作结果。
在最少指令下,阻塞式团队比单智能体高出近 10 个得分点,但成本约为后者的 4 至 7 倍。阻塞式配置优于最初的异步配置,不过成本更高、耗时也更长。
研究者随后比较最少指令和更详细的规划、实现与验证提示词。更充分的指导提高了单智能体和团队表现,也让异步主智能体学会何时等待,使其在该实验中追上阻塞式配置。
找到瓶颈
团队分别在规划、实现和验证阶段安排工作智能体。ProgramBench 最受益于并行探索;Dziri 说 Commit0 的结果不同。
即使改进提示词,全流程团队的成本仍可能是单智能体的 6 至 7 倍。Dziri 追问额外推理支出究竟在哪个阶段有用,并比较只在规划、只在实现或只在验证阶段使用工作智能体。
在仅规划配置中,工作智能体探测可执行程序并汇报计划,由主智能体实现和验证。仅实现配置中,主智能体规划并拆分编码工作;仅验证配置中,主智能体先规划和实现,再请工作智能体检查结果。
在 ProgramBench 上,只使用规划工作智能体的团队以约一半成本取得了接近全流程团队的得分。Dziri 将其归因于该基准的瓶颈:实现前必须先发现黑盒程序的行为和边界情况。
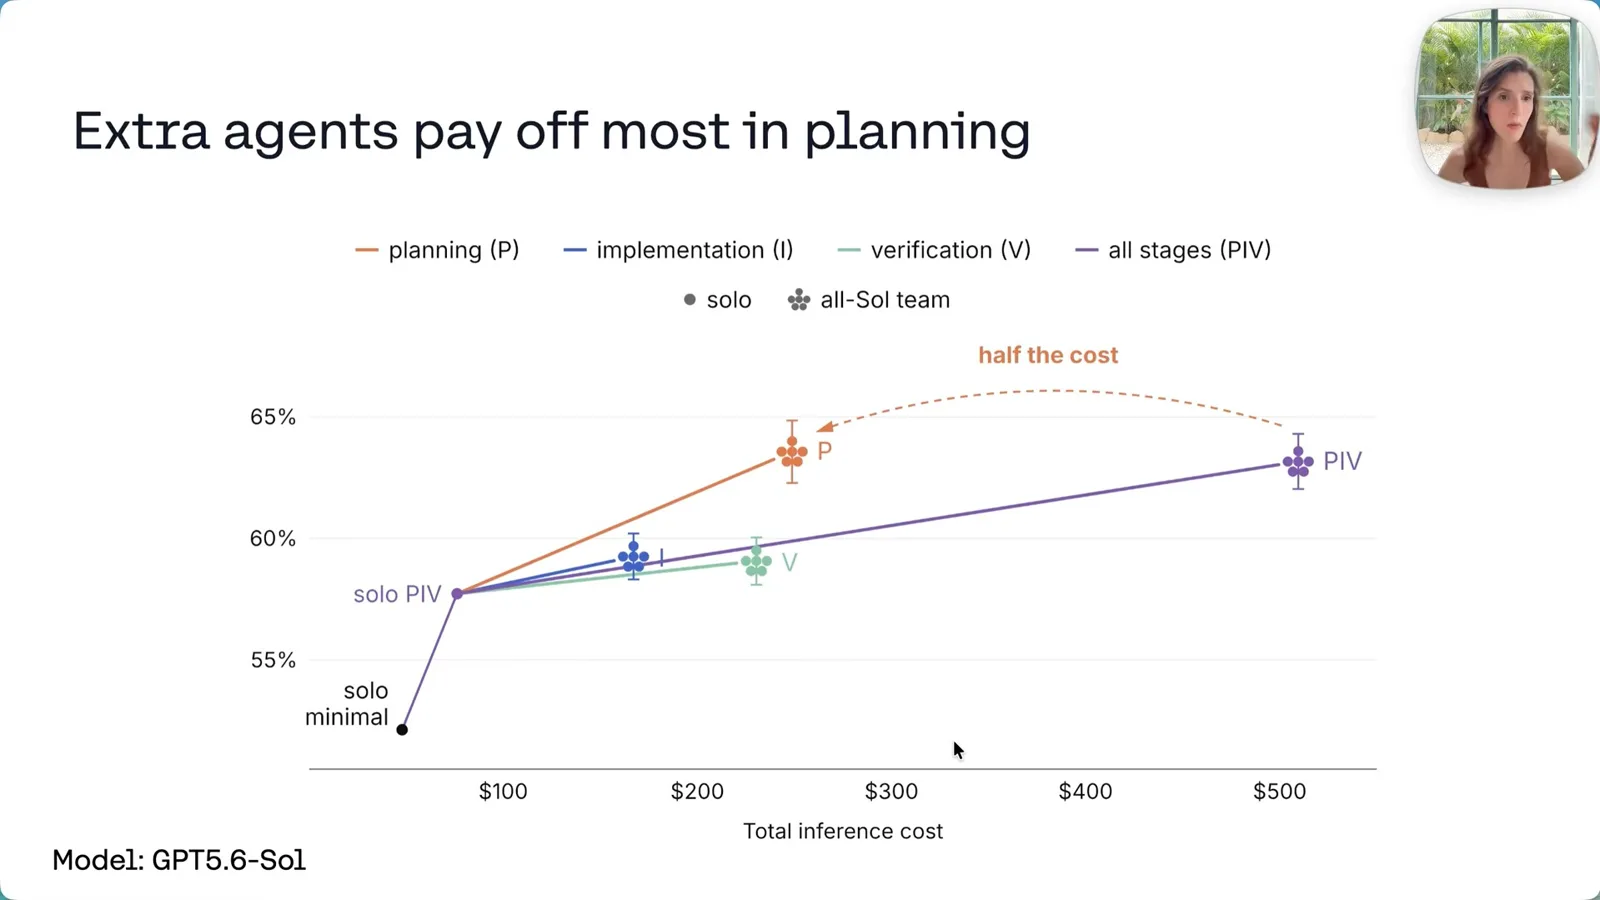
她的效率比较显示,在这一设置中,规划阶段每增加一美元所带来的得分超过实现或验证阶段。增加后两个阶段的工作智能体会提高成本,却没有相对单智能体基准带来同等改善。这些观察限于所测任务和框架。
并行规划工作智能体可以在各自的新上下文中探测程序的不同部分,返回精简报告,让主智能体获得更全面的基础。团队观察到,早期集中委派很有用;在整个过程中持续委派则增加了数百次调用和大量成本,在该比较中却没有提高测得的得分。
仅实现配置的基础较弱,因为只有主智能体独自发现程序行为。每个工作智能体随后只看到任务的一部分,可能写出不兼容的代码。提供更多上下文也没有自动解决问题:工作智能体有时越过分工边界并重复劳动。
大多数消息发回主智能体,工作智能体之间直接通信很少,因此主智能体需要协调并拼接结果。Dziri 说,当各部分无法衔接时,这种整合负担会提高延迟和成本,并降低得分。
在 Commit0 上,结果发生了变化:文档、代码骨架和单元测试让预期方案更加明确。Dziri 说,该任务的瓶颈是实现,增加实现阶段的工作智能体带来了最大改善。她请观众查看论文附录,而没有在演讲中展示完整结果。
混合模型并扩大规划团队
实验将强主智能体与低价工作智能体结合,并改变团队规模。报告的成本节省取决于比较基准。
接着研究者改变模型强度。使用较强的 Sol 主智能体和较便宜的 Luna 规划工作智能体时,他们报告的表现接近全程使用强模型的团队,虽有轻微性能取舍,成本却明显更低。这个对比说明,并非每个角色都需要最贵的模型。
反过来,配置较弱的主智能体并不能靠工作智能体补足。Dziri 将所测模式概括为:主智能体决定性能上限,工作智能体影响价格。她举例说,Terra 主智能体加 Luna 工作智能体的得分低于单独运行的 Sol。
随后团队固定 Sol 主智能体和 Luna 规划工作智能体,将规划成员数量从 2 个增加到 16 个。报告称,16 个规划工作智能体的配置比全 Sol 规划团队便宜 38%,比在每个阶段都使用工作智能体的团队便宜约 70%。这些节省比例仅对应所述基准,而非所有单智能体或前沿模型配置。
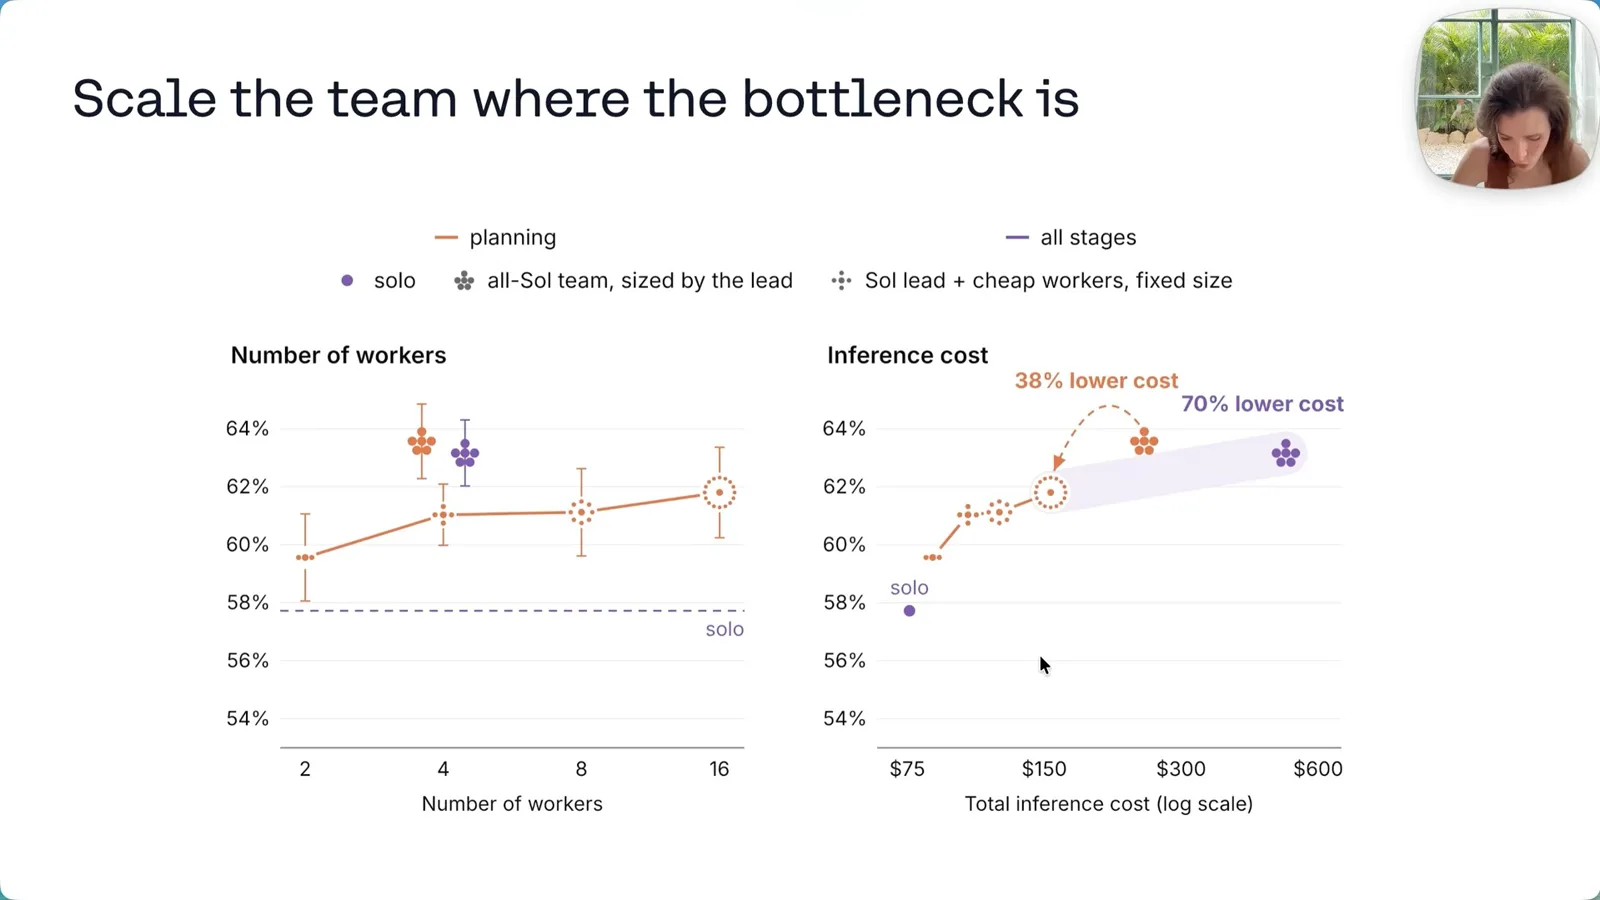
在实验预算范围内,增加规划工作智能体似乎对这一基准有帮助,但 Dziri 预计最终会出现上限。在所测 ProgramBench 设置中,扩大实现或验证工作智能体规模没有显示同样的收益。
通信与其他主智能体
大多数消息发给主智能体,增加同级消息在这一框架中没有提高结果。Dziri 讨论该观察的局限,并测试其他模型家族。
研究者还为智能体提供了向同伴发消息的工具。约 84% 的消息从工作智能体发给主智能体,而工作智能体之间的直接通信很少。团队在所测试的模型家族中都观察到了这种层级式通信模式。
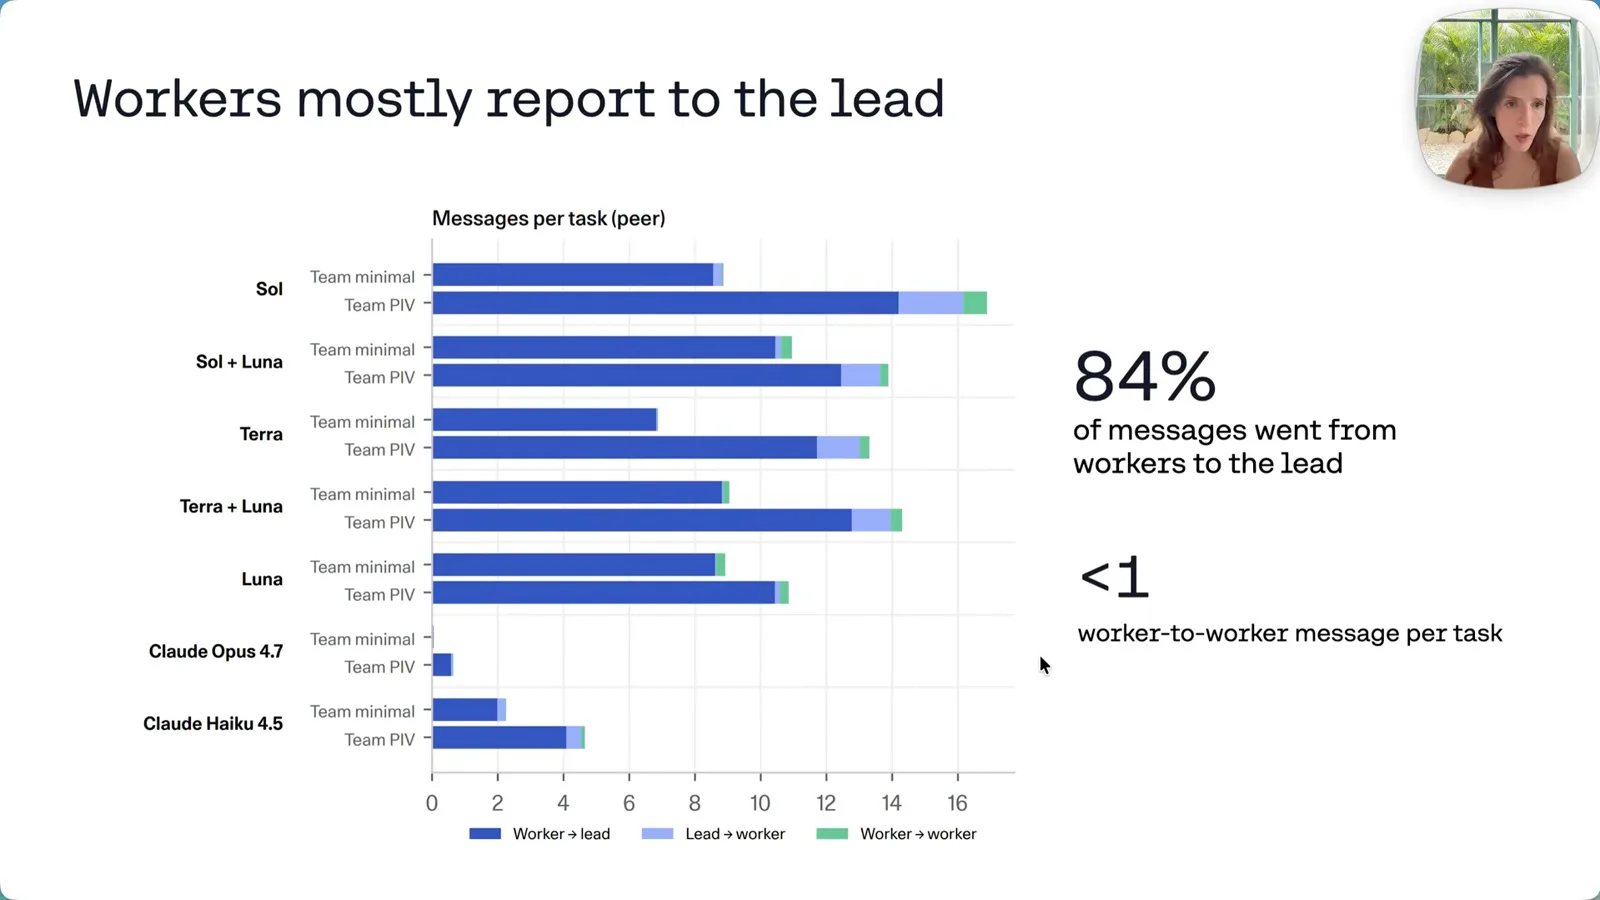
在这些实验中,更多通信并没有转化为更高得分。Dziri 报告说,较便宜模型的一些消息格式不正确,较强模型编写的消息文字更多;增加消息功能对某些团队几乎没有影响,却降低了 Luna 团队的得分。
她提醒,不能据此概括为同级消息没有必要。该框架把工作拆成大体独立的任务,工作智能体也不清楚有哪些同伴存在。共享消息板或不同的任务结构可能改变结果;团队将其留待未来研究。
研究者还用相同工具测试了其他模型家族。有些主智能体会委派并从中获益,有些很少委派,另一些即使委派也没有改善。Dziri 认为,选对要委派的任务和利用返回的结果,两者都不可缺少。
经验与开放问题
Dziri 建议将智能体分配到任务瓶颈,并以组织、通信、自适应和安全方面的开放问题作结。
她的主要结论是,把工作智能体分配到实际限制任务的阶段,而不是单纯增加人数。在所测配置中,强主智能体搭配较便宜的工作智能体,能够以更低成本接近强模型团队的表现。
开放问题包括:更大规模的团队应如何组织,能否在预算和截止时间约束下自行选择结构,以及智能体如何避免所有通信都经过同一个主智能体。她也希望主智能体无需大量针对任务的提示词调优,就能自行适应。
Dziri 最后强调,随着自主智能体团队能力增强,安全和保障问题也更加重要。她呼吁研究如何保护基础设施并对齐智能体,随后感谢研究团队,并请观众查阅论文和博客了解详情。
同频道的其他文章
 19:34EN → 简体中文
 AI Engineer· 2026年11月7日云端智能体如何辅助审核证券主数据变更Amol Kapoor, Clifford Ressel · Nori AgenticAmol Kapoor 和 Clifford Ressel 解释私募资产数据为何难以核对,以及智能体如何辅助人工审核。
 18:28EN → 简体中文AI Engineer· 2026年11月7日Vinoo Ganesh:如何让 AI 回答建立在可验证的事实之上Vinoo Ganesh · KeplerKepler 联合创始人介绍金融 AI 中的指针式检索、确定性计算和访问控制。
 1:04:02EN → 简体中文AI Engineer· 2026年11月6日Lance Martin:审计提示词、改进评估并优化 Agent 成本Lance Martin · AnthropicAnthropic 工程师介绍提示词缓存、评估设计、爬山优化,以及可靠的长时间运行 agent 架构。
 23:05ZHAI Engineer· 2026年11月6日Ryo Lu:当我们什么都能做,还知道自己想做什么吗?Ryo Lu从 AI 生成的日记工具到爵士乐团,Ryo Lu 讨论如何在更强大的工具旁保有判断、生活和与他人合作的空间。
 19:19EN → 简体中文AI Engineer· 2026年11月6日Ben Holmes:用 Agent 追踪记录改进技能Ben Holmes · WarpWarp 工程师解释如何给对话评分,找出隐藏摩擦并提出可审阅的配置改进。
 19:43EN → 简体中文AI Engineer· 2026年11月6日知识图谱如何帮助映射 3,500 万行大型机代码Stephen Chin, Neeraj Deshmukh · Neo4jStephen Chin 与 Neeraj Deshmukh 介绍旧系统现代化中的上下文、agent 编排与行为一致性测试。