30 秒看懂
在 3Blue1Brown 的特邀课程中,Stephen Welch 用二维玩具数据集解释图文对比表示、扩散采样和无分类器引导。他将算法与布朗运动联系起来,并解释确定性采样为何不等于直接删除随机采样器中的噪声。
- 1CLIP 的共享空间对比训练使匹配的图像与文字向量对齐,同时区分不匹配的组合。
- 2学习逆转噪声DDPM 训练模型估计加入干净样本的总噪声。
- 3二维类比像素值成为坐标,噪声形成随机游走,而去噪可以表示为向量场。
- 4采样噪声为何重要直接从 DDPM 采样器中删除噪声可能使样本趋向平均值;视频也指出了类比的局限。
- 5确定性替代方案DDIM 改变更新规则和步长缩放,而非只是删除 DDPM 的随机步骤。
- 6引导无分类器引导放大有条件预测和无条件预测之间的差异。
要点建议
- CLIP 训练图像和文本编码器,在共享嵌入空间中对齐匹配的图文对。
- 扩散模型学习如何将带噪样本移向数据分布,并把噪声水平作为输入。
- DDPM 采样时加入随机噪声;直接删除这一步会改变过程并可能降低质量。
- DDIM 使用不同缩放的确定性轨迹,以较少步骤近似得到相应分布。
- 条件输入和无分类器引导使生成过程朝提示词移动;负面提示词提供另一个需要远离的方向。
按章节阅读整理后的全文
从噪声到视频
Welch 介绍迭代生成及其与扩散的联系。
AI 图像与视频生成器已经能根据文字生成细致的场景。Stephen Welch 将扩散介绍为一种与高维空间中逆向布朗运动相关的过程。这种物理联系带来了实用算法,而不只是一个比喻。
Welch 以开放的 WAN 2.1 视频模型为例,展示它如何回应关于宇航员的提示词。生成从随机噪声开始,Transformer 反复更新样本,逐渐形成视频。视频简介说明,展示的噪声画面是从压缩的潜在表示解码出来的。
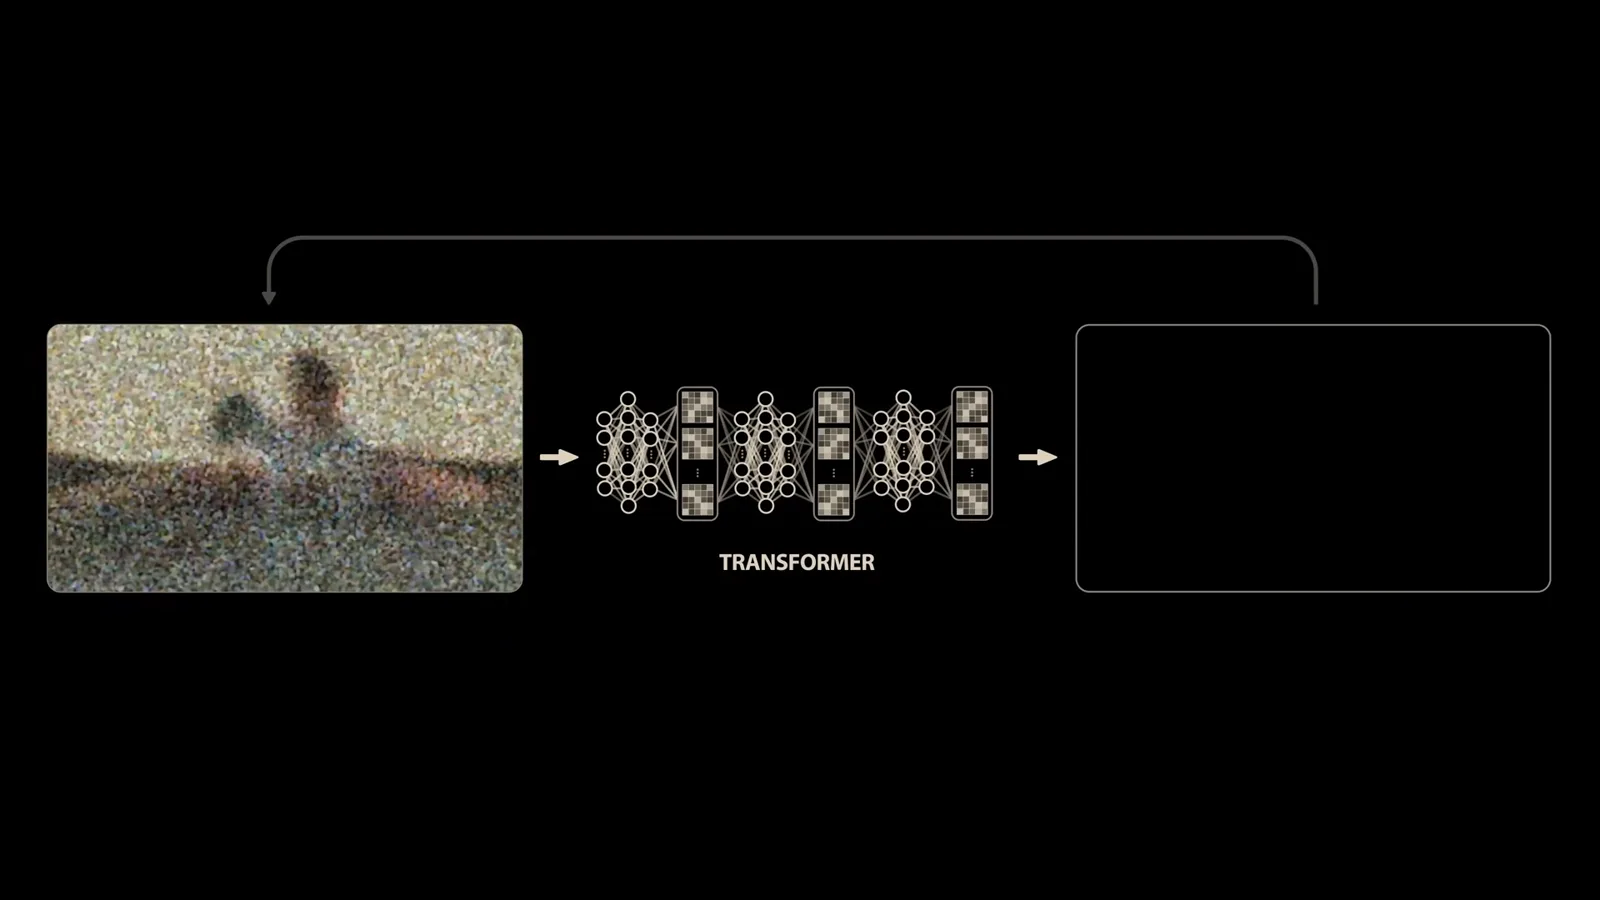
每次模型运行都会产生更新,反复迭代后可见结构逐渐出现。这引出两个问题:模型如何逆转随机过程,文字又如何将过程引向所请求的场景?Welch 通过 CLIP、扩散和引导来解答。
CLIP 与共享嵌入
对比训练把图像和文字表示联系起来。
OpenAI 于 2021 年发布的 CLIP 使用图像编码器和文本编码器,并用图像—说明文字配对训练。两者在共享空间中各自产生向量。训练目标使匹配图文的表示更相似,同时区分不匹配的组合。
在一个批次中,可以把图像向量和文字向量排列成矩阵。匹配对位于对角线,其他位置是不匹配的组合。对比目标同时利用两类配对,并用余弦相似度衡量向量方向有多接近。
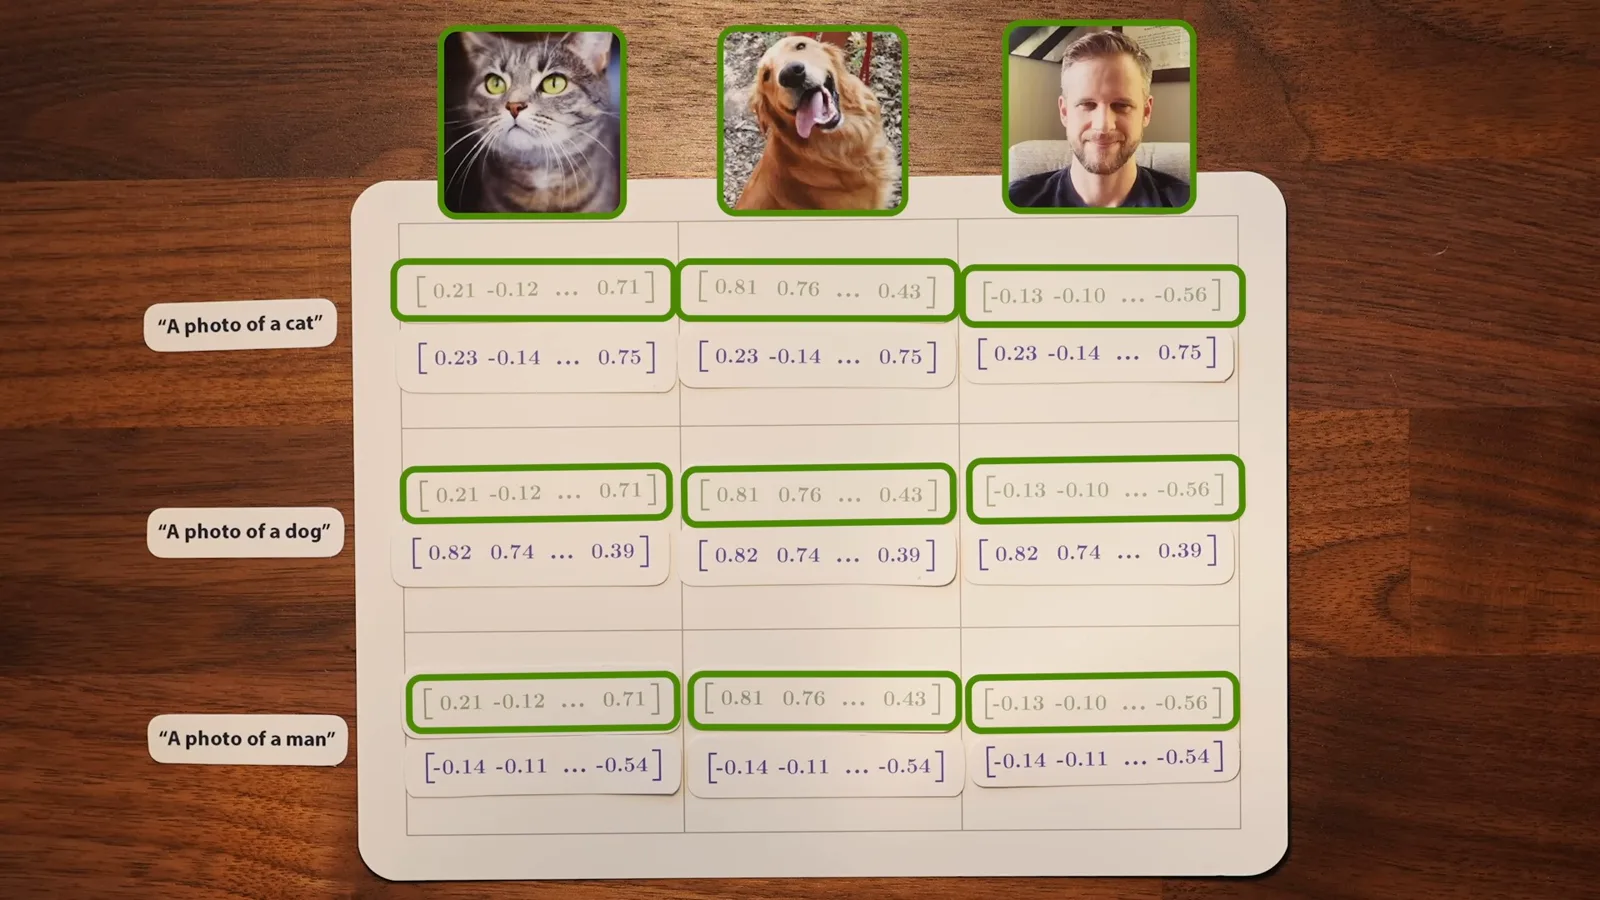
余弦相似度是向量夹角的余弦;方向相同的向量相似度为 1。虽然实际空间是高维的、二维图形只是帮助直觉的工具,学到的空间仍让模型能够比较文字描述与图片。
Welch 从戴帽子的照片嵌入中减去没戴帽子的照片嵌入。在他测试的数百个单词中,“hat”与差向量最匹配,其后是相关词。这说明某些有意义的图像差异对应于学习空间中的方向。
CLIP 可以把图像嵌入与候选文字标签比较,选择最相似的标签完成分类。但这些编码器只把图像和文字映射进空间,本身不能从嵌入生成图像。
DDPM 与随机游走
玩具数据集让去噪和随时间变化的向量场变得可视。
去噪扩散概率模型(DDPM)提供了一种生成图像的方法。训练从干净样本出发,加入按比例缩放的随机噪声。神经网络学习估计加入的总噪声,而不只是恢复紧邻的上一步。
DDPM 生成时也会加入随机噪声。在 Welch 的 Stable Diffusion 例子中,直接从 DDPM 更新里删除这一步,会产生一棵又小又模糊的树。视频技术说明补充说,该特定结果很可能与实际噪声水平和模型预期水平不匹配有关。
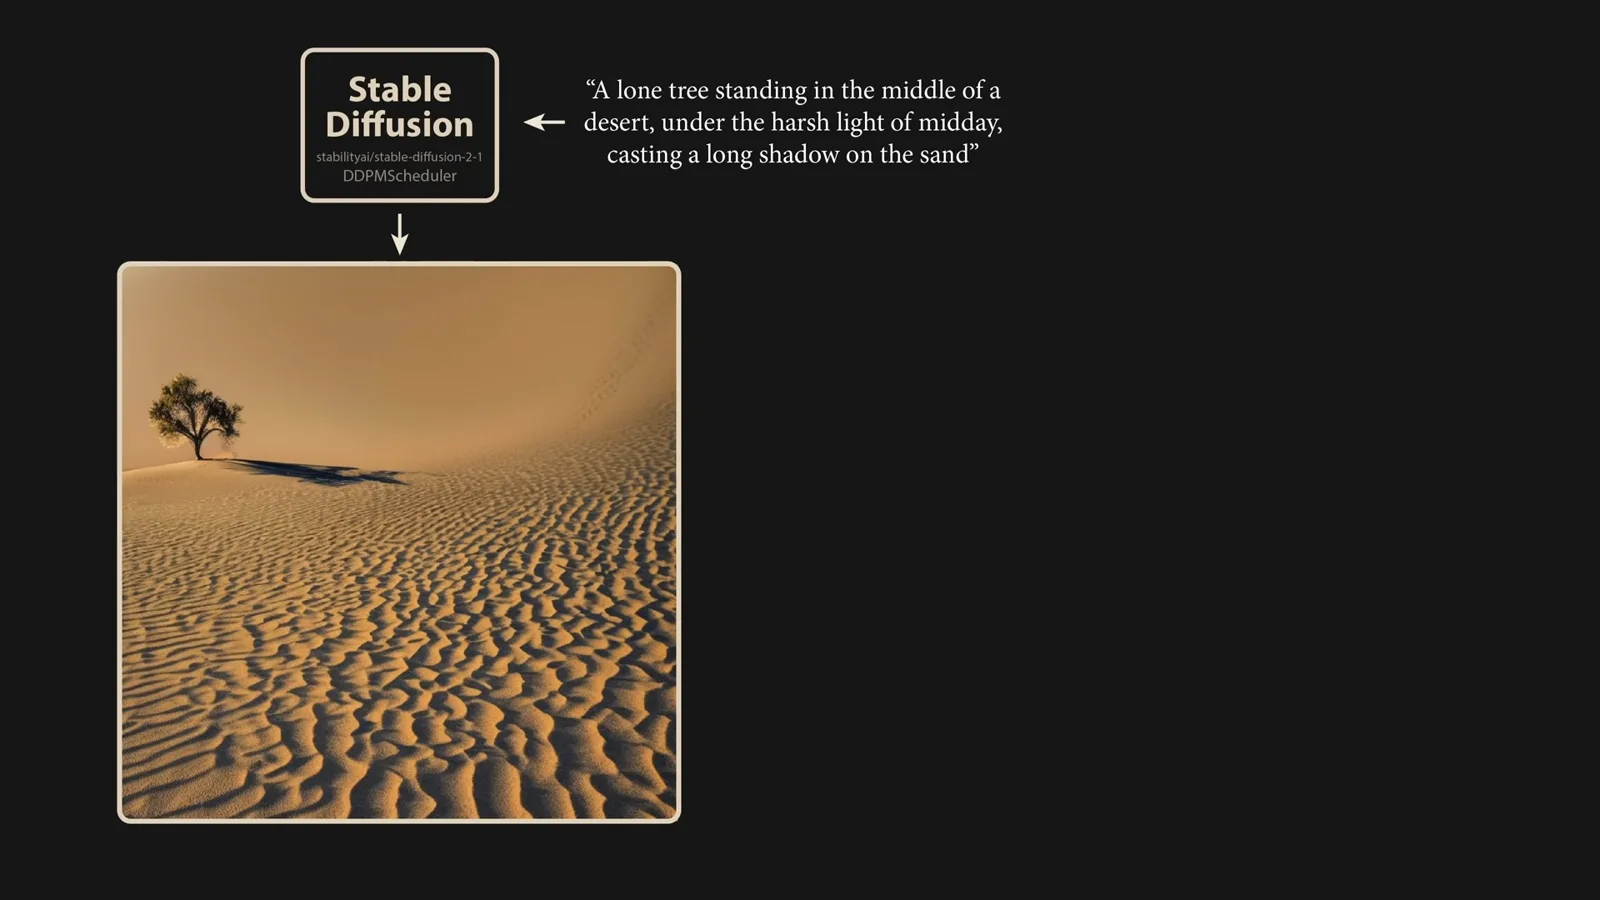
为什么预测总噪声,而不是只预测最后一小步?Welch 给出一种不同但相关的视角:模型学习一个随时间变化的向量场,将带噪样本引向数据分布。这种视角也与更广泛的基于流的方法相联系。
想象一张只有两个灰度像素的图像。两个强度值成为平面上的 x、y 坐标,图像集合就变成点集;在玩具例子中,Welch 把点排列成螺旋形。
添加噪声会使像素值朝随机方向改变。反复添加后,一个点进行随机游走,类似布朗运动。学习去噪意味着学习如何把带噪点移回螺旋数据分布,而不是精确重建某条随机路径。
给定一个带噪点,很多不同的训练路径可能经过附近。虽然每一步都是随机的,它们的平均值仍包含指向数据的信号。预测总噪声提供了方差更低的训练信号,有助于学习这个方向。
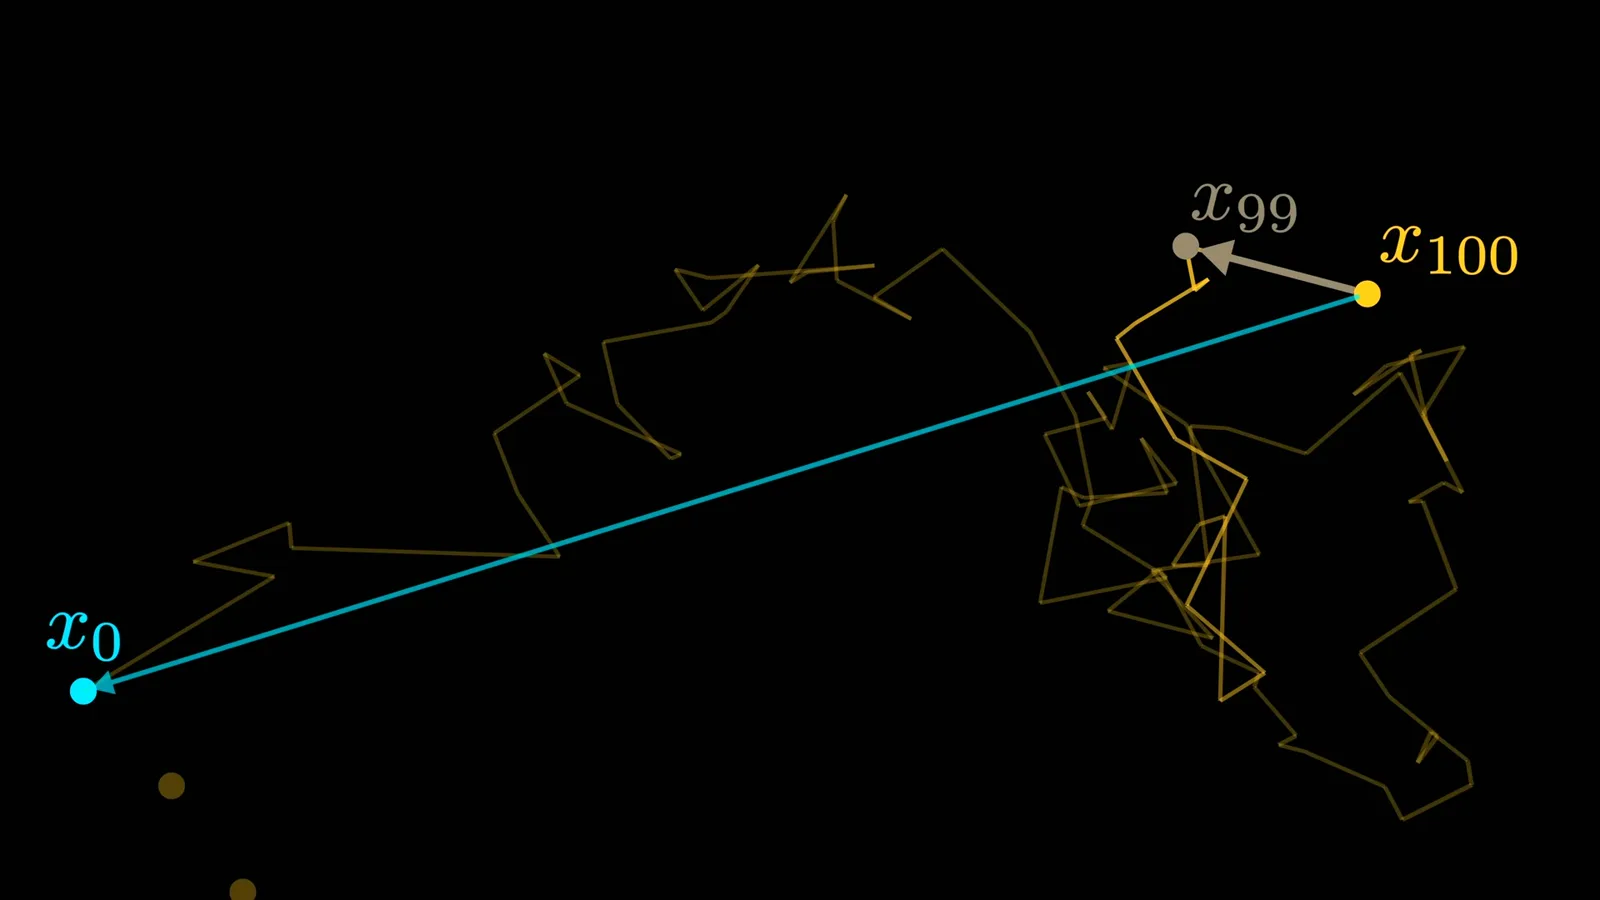
学到的方向还取决于噪声水平。远离原始数据时,向量场大致指向螺旋中心;噪声较小时,它可以解析更精细的结构。把时间或噪声水平作为输入,使同一个模型能够学习两者。
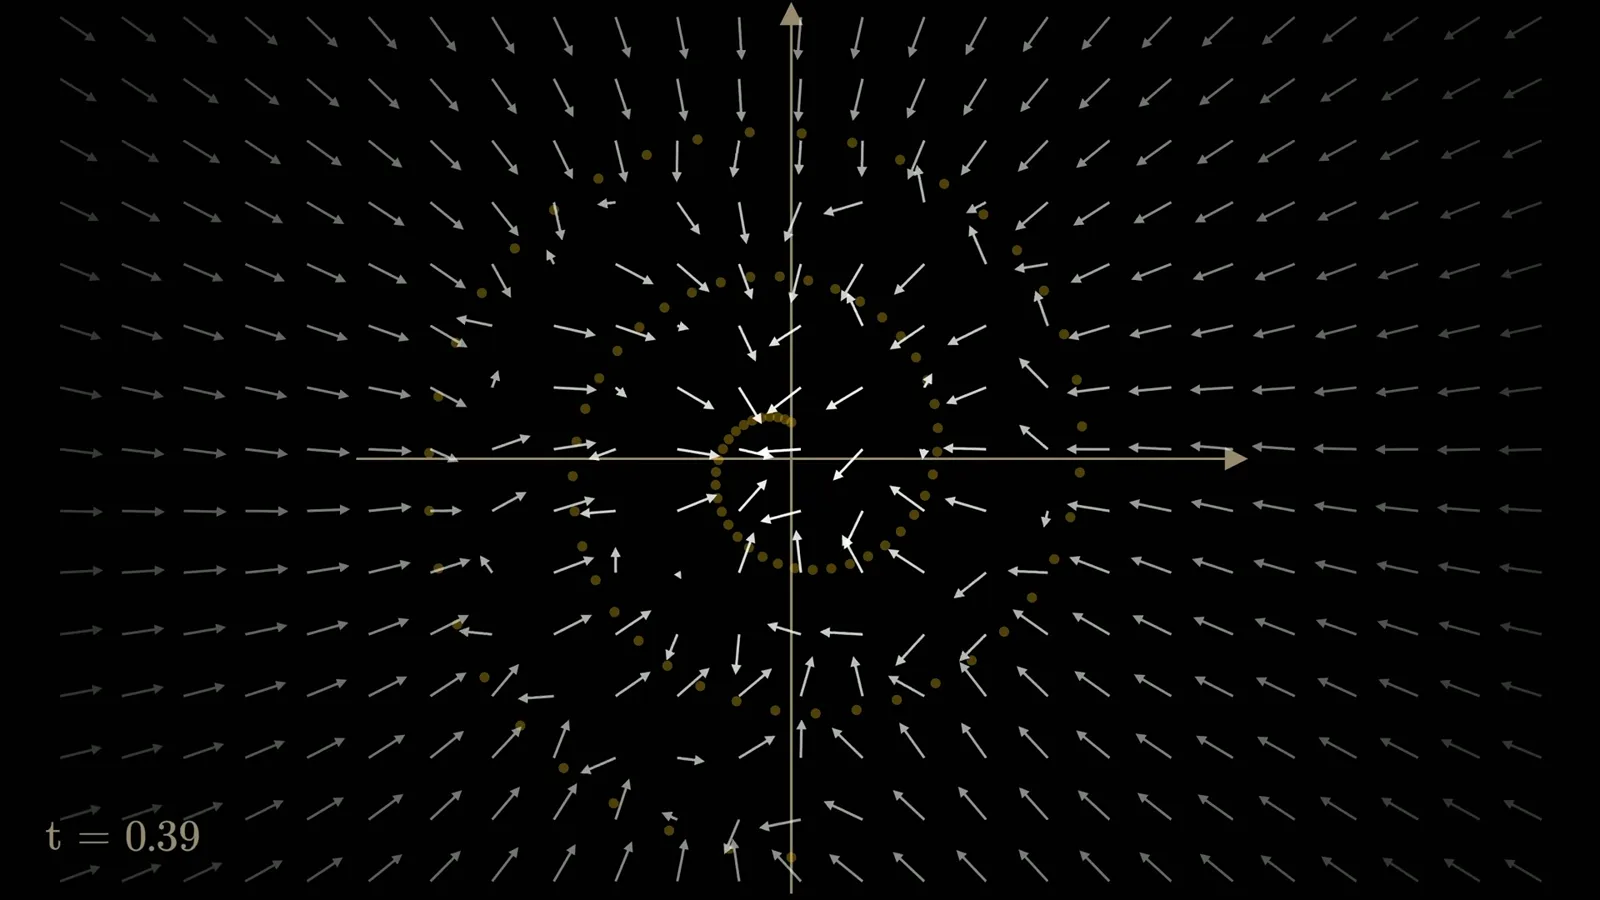
DDPM 采样时,从随机点出发,沿学到的向量场移动一小步,再加入按比例缩放的随机步。重复这一过程,点云会逐渐回到螺旋附近,随机步的尺度也随采样过程缩小。
如果在不改变 DDPM 其余更新规则的情况下删除随机步,Welch 的点会聚集在均值附近,而不是覆盖整个螺旋。他用这一现象帮助理解模糊平均图像,同时强调二维类比无法完整解释高维行为。
当步长足够小时,逆向转移可以近似为高斯分布。模型预测的是均值;加入适当缩放、均值为零的噪声,才能从转移分布采样,而不是每次都只取均值。这解释了随机 DDPM 过程中的噪声项。
早期 DDPM 的缺点是计算成本:要生成高质量图像,需要多次运行神经网络。后续研究表明,相关的确定性过程可以不在每一步注入噪声,仍生成高质量样本。
确定性采样
另一种轨迹引出 DDIM 和更少的生成步骤。
随机过程可以用随机微分方程描述。借助 Fokker–Planck 联系,研究者推导出一个常微分方程,在理论假设下,其随时间演化的概率分布与随机过程相同。单个样本的路径不一定相同。
实用的 DDIM 方法与 DDPM 相似,但除了省去随机添加外,还改变了步长缩放。这些更小且调度不同的步骤能更恰当地沿学到的场移动。它不等于从原始 DDPM 采样器中直接删除一行加噪代码。
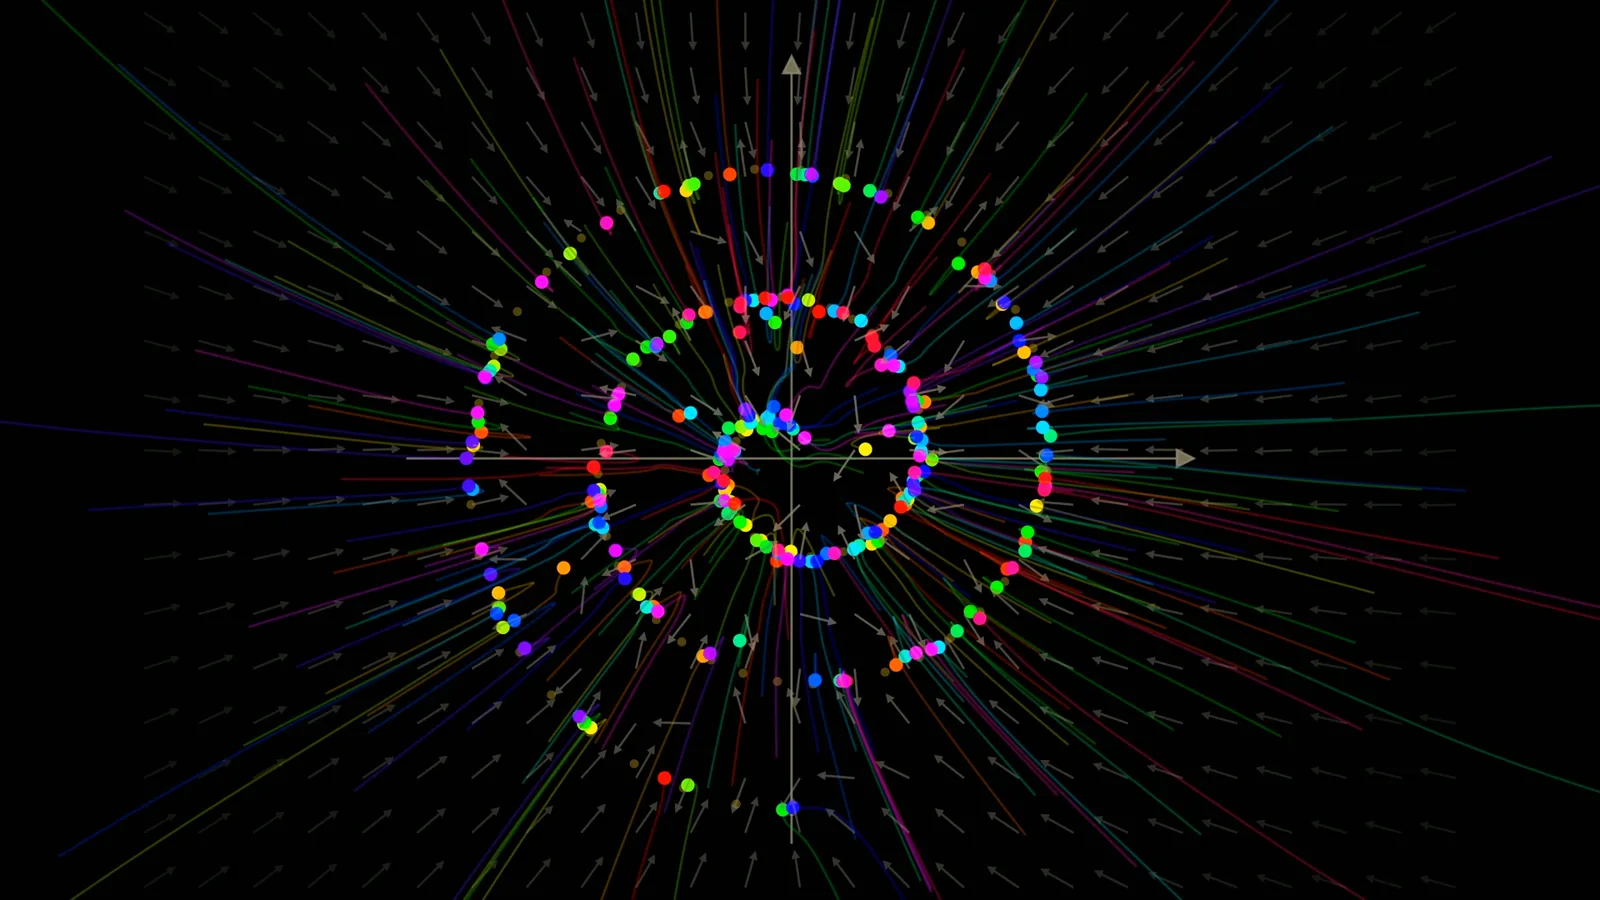
在螺旋例子中,DDIM 的确定性路径覆盖目标分布;在树的例子中,它重新生成连贯图像。同一个训练好的模型可以用更少步骤采样。理论结论涉及分布,而非逐张图像完全相同。
Welch 把 WAN 的方法与流匹配联系起来,然后回到文字控制。CLIP 可以表示提示词,扩散模型可以生成图像;结合这些思想,就能让文字表示影响生成轨迹。
条件输入与引导
文本嵌入、无分类器引导和负面提示词共同控制输出。
DALL·E 2 使用称为 unCLIP 的方法,借助共享图文表示引导图像生成。引导去噪器的一种通用方法是条件化:用图像与说明文字配对训练时,把文字信息作为额外输入。
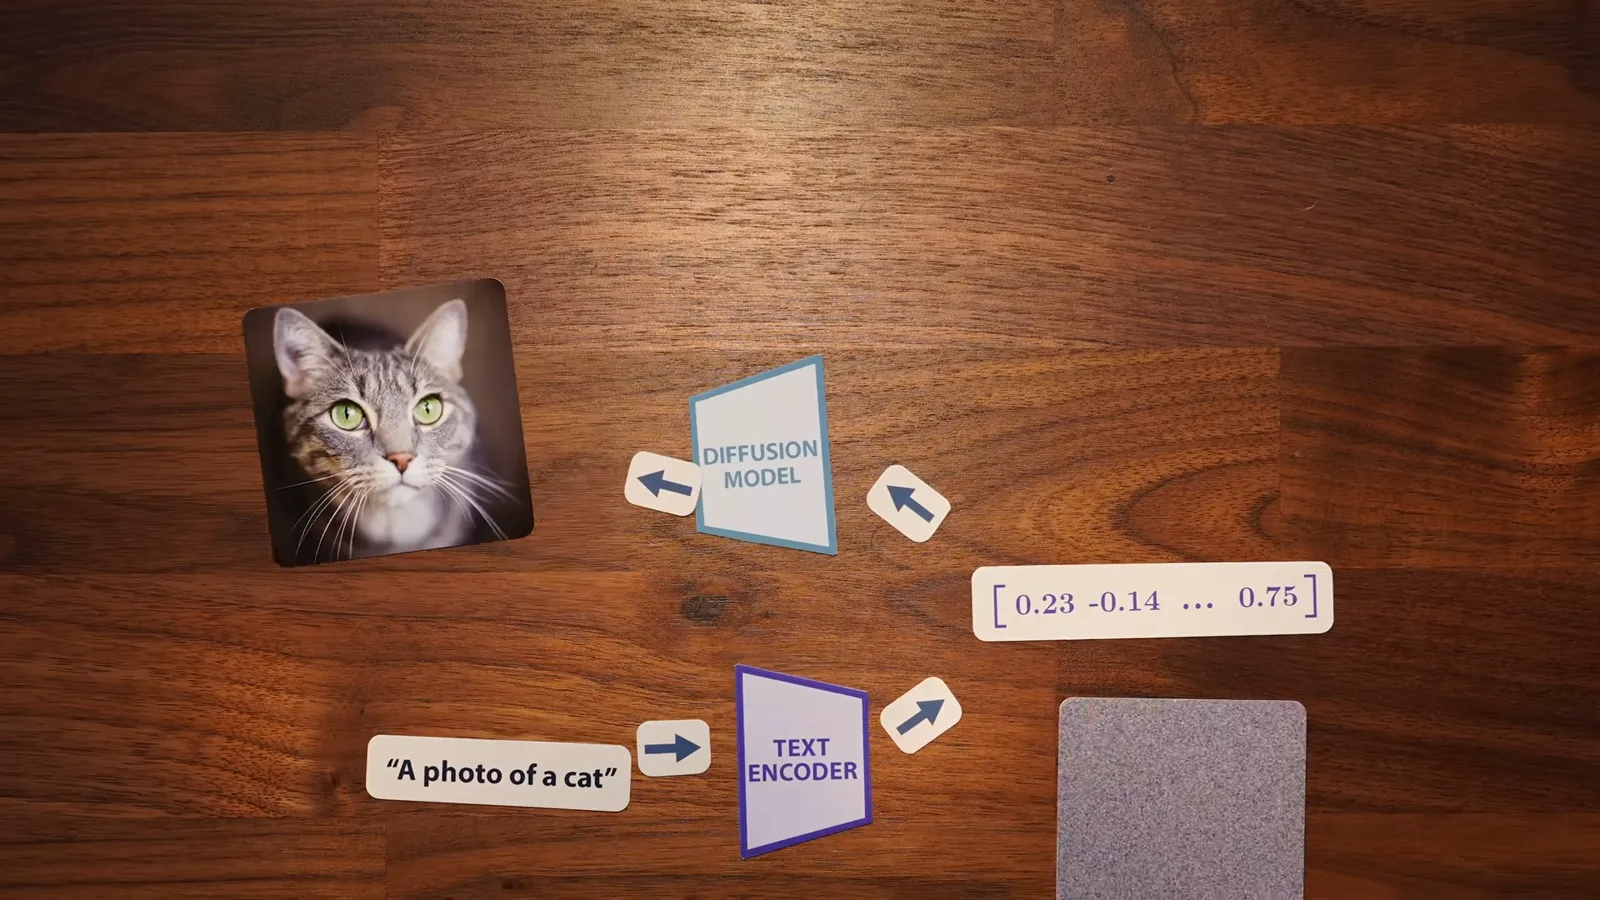
条件信息可以通过交叉注意力、向输入添加文本表示等不同方式传入。简介指出 Stable Diffusion 的一个细节:它使用较早的序列表示进行文本条件化,而不是简单使用最终的 512 维 CLIP 嵌入。
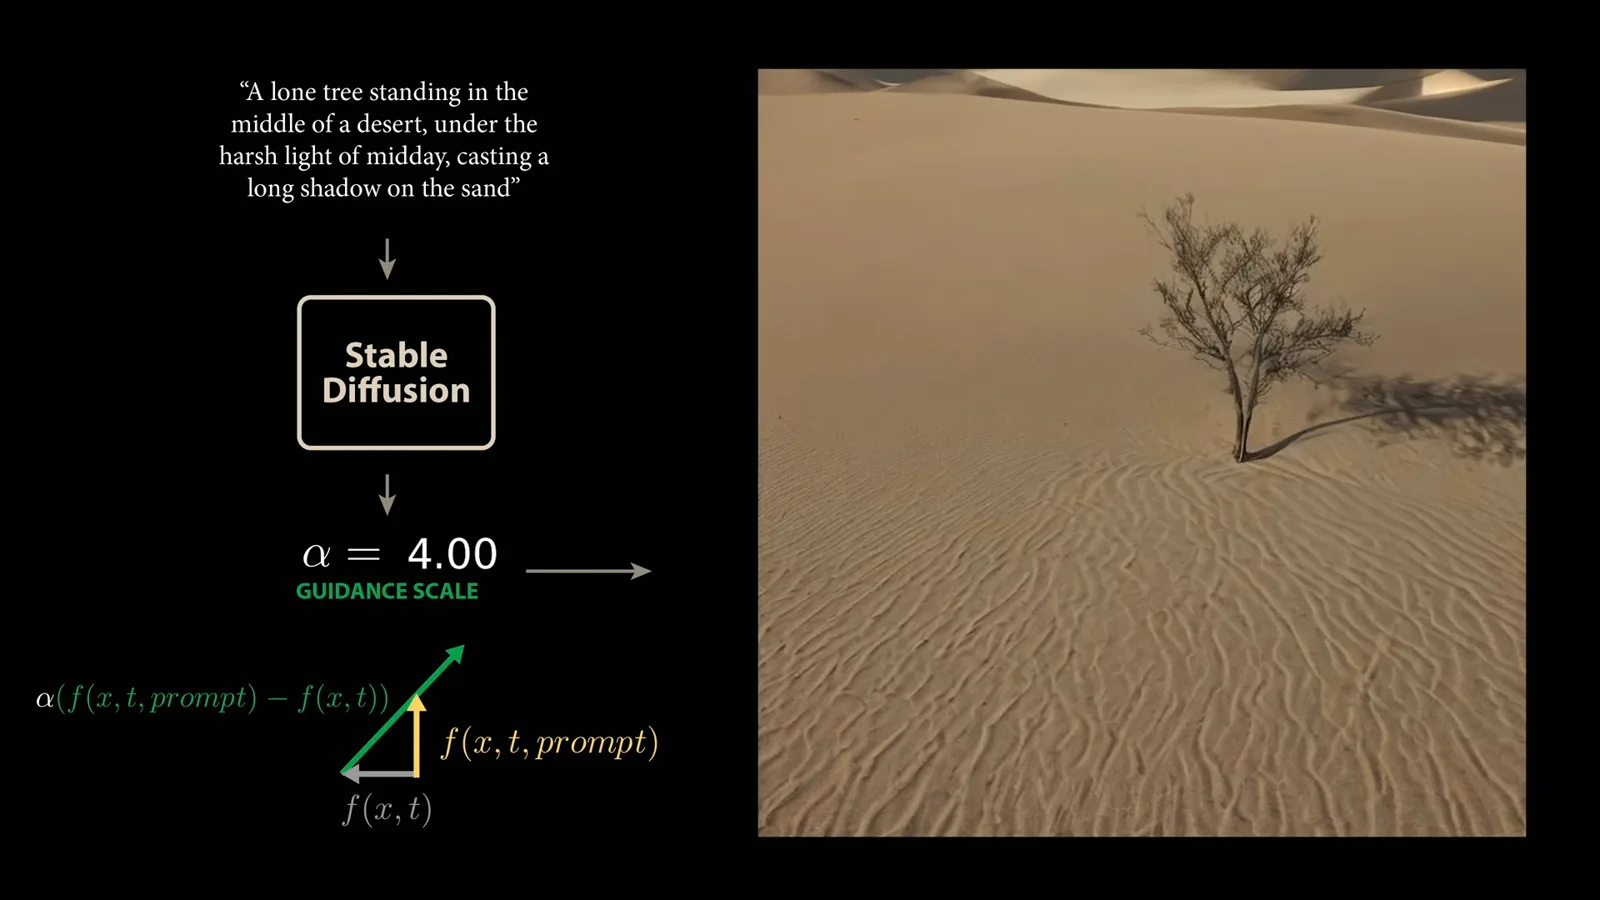
仅有条件输入不一定能强力保证提示词中的每个细节。Welch 的沙漠例子可能生成沙子和影子,却没有要求的树。把玩具螺旋分成人、狗和猫的区域后,可以看到条件轨迹并不总能到达目标区域。
无分类器引导比较两次预测:一次带所需条件,另一次不带条件。训练时会对部分样本省略条件,使同一网络可以产生这两类预测。
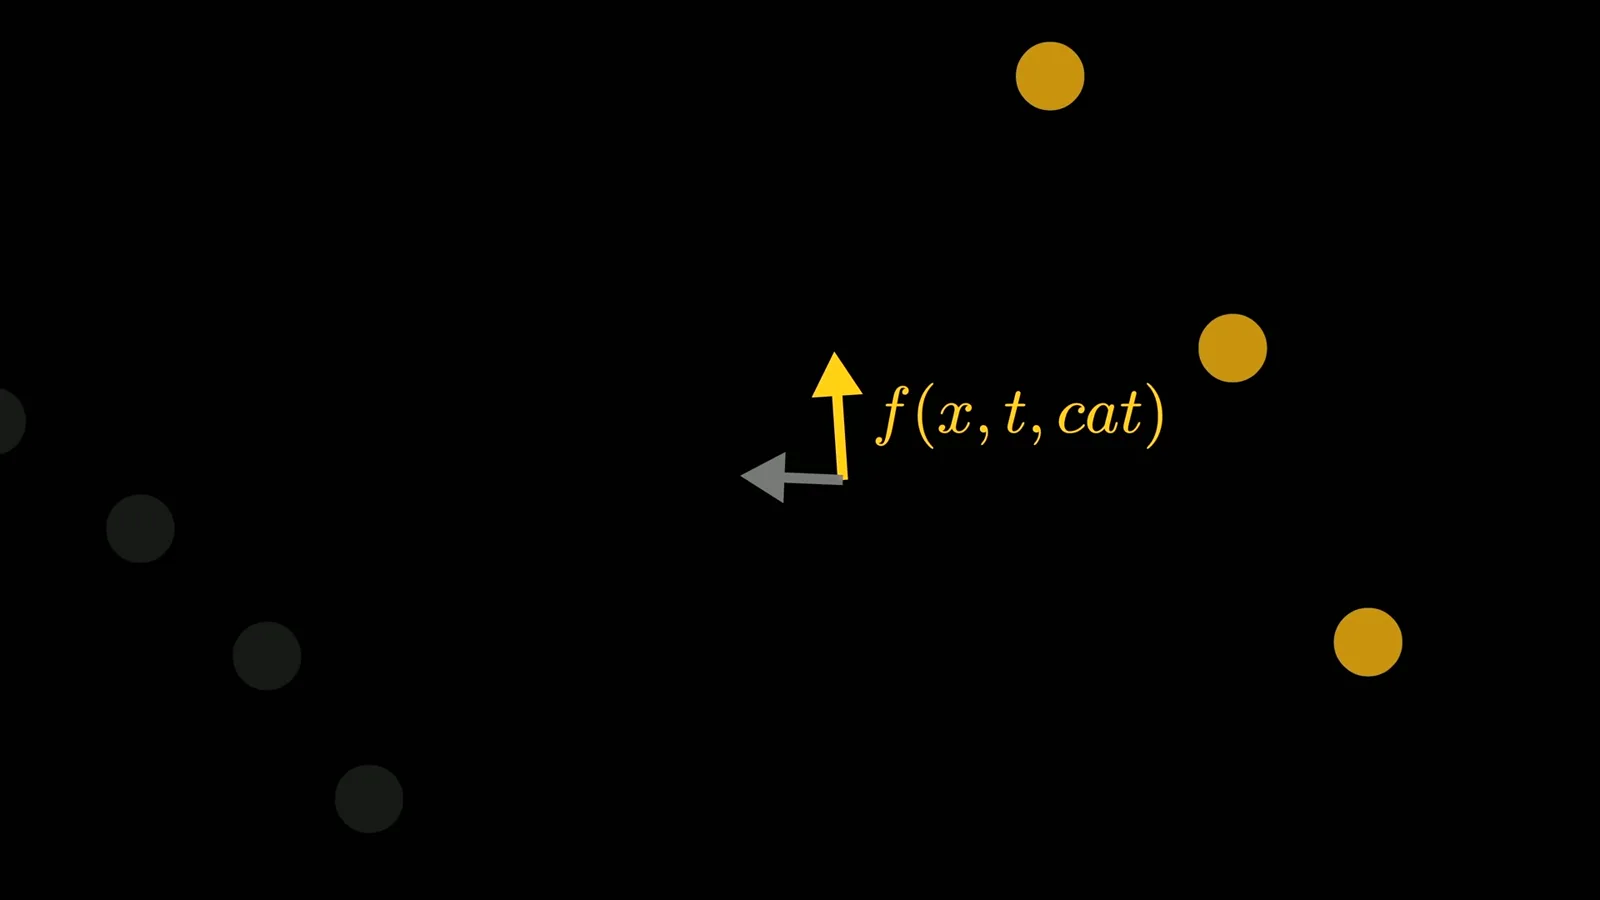
从有条件方向减去无条件方向,可以得到与提示词相关的差分;再放大差分并与基础预测组合。提高引导强度会使样本更明显地朝所需类别移动。不同实现采用的缩放约定可能不同。
在玩具数据中,引导后的猫和狗样本更可靠地落在各自区域。在沙漠例子里,提高引导强度让树出现并变得更详细。更强引导会改变结果;视频并未声称无限提高强度总能改善图像。
WAN 还使用负面提示词:它不再与空条件比较,而是提供不希望出现的特征描述,并引导生成远离该方向。Welch 提到多余手指、倒着走等例子,并展示去掉负面提示词会改变生成场景。
结语与特邀视频背景
Welch 回顾组合起来的思想,主持人介绍特邀系列。
令人惊叹的是,几项分别发展的思想能够结合起来:文本编码器表示提示词,学到的扩散或流向量场把噪声塑造成图像。容易在二维中画出的几何直觉,可以帮助理解更高维空间中的操作。
3Blue1Brown 主持人介绍 Welch 是 Welch Labs 背后的特邀创作者,并解释特邀系列是在他休育儿假期间委托制作的。其他计划中的视频涉及统计力学,以及现代艺术与群论的联系。
同频道的其他文章
 40:44EN → 简体中文
 3Blue1Brown· 2026年10月16日Grant Sanderson:现在是投身数学的最好时机Grant Sanderson, Constantin Kogler · 3Blue1Brown学生担心 AI 已经解决了数学。Grant Sanderson 却认为恰恰相反:即使机器证明定理的能力超过人类,数学这套制度依然有价值,而新人正迎来一个难得的机会,可以参与重塑它。
 51:55EN → 简体中文3Blue1Brown· 2026年9月18日AI 解不出的最后一道 IMO 题Grant Sanderson · 3Blue1BrownGrant Sanderson 带你走一遍 2025 年 IMO 第 6 题——前沿模型没做出来的铺砖谜题——以及要证明一种构造最优,需要怎样的视觉耐心。
 0:55EN → 简体中文3Blue1Brown· 2026年7月24日64 块方糖谜题:六组相等距离一个 4×4×4 的方糖块有三种颜色;证明总能找到六对同色方糖,且每对距离相等。
 2:25EN → 简体中文3Blue1Brown· 2026年6月12日香农如何测量英语的信息熵一场猜字母游戏帮助克劳德·香农估算英语文本的信息量,也揭示了预测与压缩之间的联系。
 1:02EN → 简体中文3Blue1Brown· 2026年6月10日月球机器人与最优二进制编码谜题四个方向出现的频率不同,每条指令最少需要多少比特?
 32:19EN → 简体中文3Blue1Brown· 2026年6月7日重新理解熵:预测为何有助于压缩语言从机器人的移动编码出发,理解前缀码、Shannon 信息量和语言的熵。