摘要
30 秒看懂
3Blue1Brown 讲述香农如何从统计短字母序列转向人类预测实验。由此得到的估计将英语的可压缩程度与预测下一个字符的能力联系起来。
- 1预测与压缩香农将英语的可压缩程度与下一个字符的概率联系起来。
- 2人类语言模型贝蒂·香农猜测文章中的字母,猜对时便用短横线代替字母。
- 3记录猜测次数香农扩大实验,记录参与者需要猜几次,并据此估计概率。
- 4每字符一比特的估计他估计,有至少100个字符的上下文时,英语理论上可能压缩至每字符约一比特。
要点建议
- 下一个字符越容易预测,它带来的新信息就越少,压缩也可以越高效。
- 较长的上下文很少在样本中重复出现,因此统计短序列无法可靠地测量它们对预测的帮助。
- 香农用人类猜测结果估算概率,并提出在充分上下文下英语可能接近每字符一比特。
- 现代压缩可以使用人工构建的预测模型,而不仅仅是测量人的预测能力。
全文
按章节阅读整理后的全文
01
从字母统计到人类预测
上下文越长,短序列统计就越稀疏。香农转而利用人的预测能力来研究较长上下文中的信息。
克劳德·香农将英语的可压缩程度与文本的可预测性联系起来。他早期的实验统计短序列后面出现的字符:例如,查找几本书中每一个“TH”,并统计其后出现的字母。
这种方法遇到长序列就会失效,尤其是样本中从未出现过的序列。但长序列提供更多上下文,使下一个字符更容易预测,文本也更容易压缩。因此,香农需要另一种研究这些概率的方法。
他找到了一位20世纪40年代就能使用的语言模型:妻子贝蒂。据说,他请她预测一段文字中的每个新字母。猜错时,他写下正确字母;猜对时,他写一条短横线。得到的字符串包含更少字母,但如果有一位预测方式相同的贝蒂,就仍然可以重建原文。
这只是一个开始,因为香农对信息的正式定义需要知道下一个字母的概率。在《印刷英语的预测与熵》一文中,他描述了有更多人参加的实验,记录他们猜中正确字母所需的次数。他将猜测次数与短序列统计结合起来,估计预测中隐含的概率。
02
从猜测次数估算熵
香农记录猜中所需的次数,并结合短序列统计。这一估计揭示了压缩与智能预测的联系。
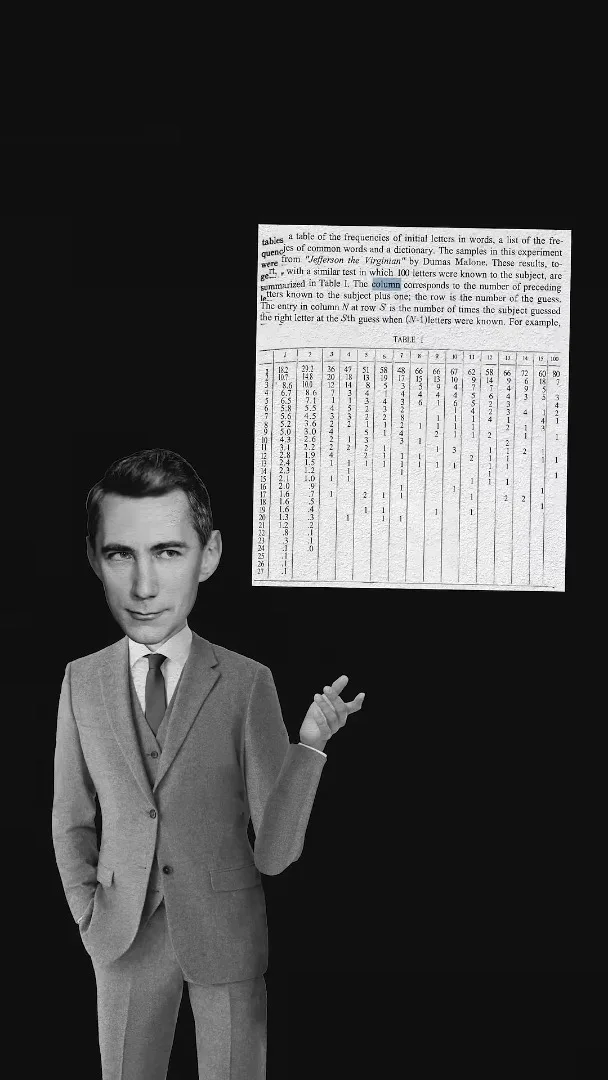
香农估计,在至少100个字符的上下文条件下,英语理论上可能压缩至每字符约一比特。为了得到这个估计,他不得不超越简单的数据分析,去探究某种智能。讲述者认为,今天要接近这一压缩极限,需要尝试构建预测智能;本片摘自一套进一步探讨这一联系的视频。
同频道的其他文章
 40:44EN → 简体中文
 3Blue1Brown· 2026年10月16日Grant Sanderson:现在是投身数学的最好时机Grant Sanderson, Constantin Kogler · 3Blue1Brown学生担心 AI 已经解决了数学。Grant Sanderson 却认为恰恰相反:即使机器证明定理的能力超过人类,数学这套制度依然有价值,而新人正迎来一个难得的机会,可以参与重塑它。
 51:55EN → 简体中文3Blue1Brown· 2026年9月18日AI 解不出的最后一道 IMO 题Grant Sanderson · 3Blue1BrownGrant Sanderson 带你走一遍 2025 年 IMO 第 6 题——前沿模型没做出来的铺砖谜题——以及要证明一种构造最优,需要怎样的视觉耐心。
 0:55EN → 简体中文3Blue1Brown· 2026年7月24日64 块方糖谜题:六组相等距离一个 4×4×4 的方糖块有三种颜色;证明总能找到六对同色方糖,且每对距离相等。
 1:02EN → 简体中文3Blue1Brown· 2026年6月10日月球机器人与最优二进制编码谜题四个方向出现的频率不同,每条指令最少需要多少比特?
 32:19EN → 简体中文3Blue1Brown· 2026年6月7日重新理解熵:预测为何有助于压缩语言从机器人的移动编码出发,理解前缀码、Shannon 信息量和语言的熵。
 0:48EN → 简体中文3Blue1Brown· 2026年3月25日子集和谜题:谁有必胜策略?从 1 到 100 中选十个整数,再寻找和相等的两个不同子集。