30 秒看懂
3Blue1Brown 从一个简单的压缩问题出发,建立熵的概念:编码长度与概率如何关联,语言中的上下文为何重要,以及 Shannon 的人类预测实验如何与现代语言模型相联系。
- 1平均 1.75 比特的移动编码前缀码利用指令概率不均等的特点,分配不同长度的码字。
- 2无歧义解码任何完整码字都不是另一码字的前缀,机器人可以边接收边解码。
- 3信息量与意外程度概率为 p 的事件对应的理想编码长度为 −log₂ p。
- 4上下文与小数比特短语中各字母的条件概率相乘,对应的信息量则相加。
- 5熵与压缩极限每个符号的平均信息量为预期无损编码长度设定下界,合适的分组编码可以逼近它。
要点建议
- 只要编码能够唯一解码,就可以给常见消息分配更短的码字。
- 概率为 p 的事件所含的信息量是 −log₂ p 比特。
- 熵是概率分布下的信息量期望,并为无损编码的平均效率设定界限。
- 上下文影响下一个符号的概率,因此语言需要条件概率和熵率。
- Shannon 对英语的估计取决于人类预测及实验上下文。
按章节阅读整理后的全文
压缩、预测与智能
旁白提出语言能被多高效地编码,并引入信息论。
文本最多能压缩到什么程度?3Blue1Brown 的旁白从 ASCII 每字符 8 比特说起,追问当编码利用语言中的规律时,什么决定了最终极限。
Claude Shannon 的信息论提供了回答方法。它的数学也出现在语言模型训练中:训练通常用交叉熵损失来优化下一个 token 的预测。
旁白先介绍预测与压缩的关系:好的概率模型可以帮助实现高效编码。他把“压缩就是智能”当作一个引人思考的观点,而非精确的定理,因为智能本身也难以定义。
机器人与前缀码
利用不同指令出现概率的差异,可以缩短平均编码长度,且不造成边界歧义。
先看一个简单问题:机器人收到彼此独立的移动指令,向上的概率为 1/2,向下为 1/4,向左和向右各为 1/8。发送比特有成本,因此目标是高效编码这些指令。
一种直接的方法是给四个方向各分配两比特码字。机器人把比特流每两个一组就能解码,但这种方法没有利用某些方向更常见的特点。
另一种编码将上、下、左、右分别表示为 0、10、110、111。它的期望长度为 1/2 × 1 + 1/4 × 2 + 1/8 × 3 + 1/8 × 3,即每条指令 1.75 比特。
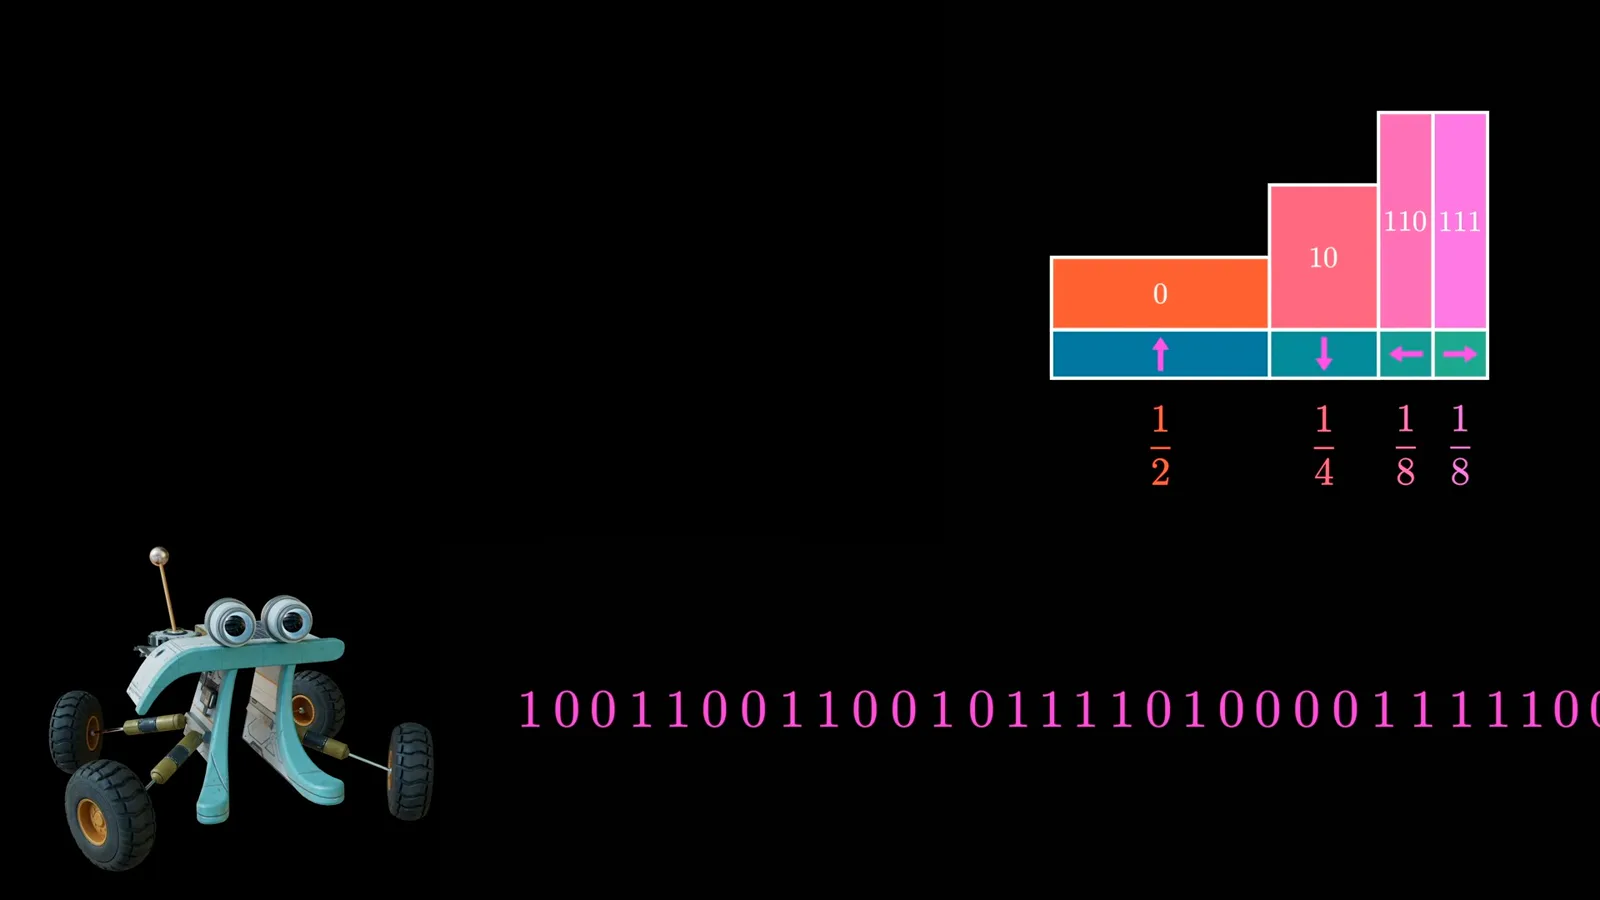
变长码字需要明确的边界。机器人持续读取直到得到一个完整码字:0 立刻表示向上,10 表示向下,110 和 111 则分别表示向左和向右。
关键在于,没有任何完整码字是另一个码字的前缀。这种前缀码可以在比特到达时逐步解码,无须猜测一条指令在哪里结束。
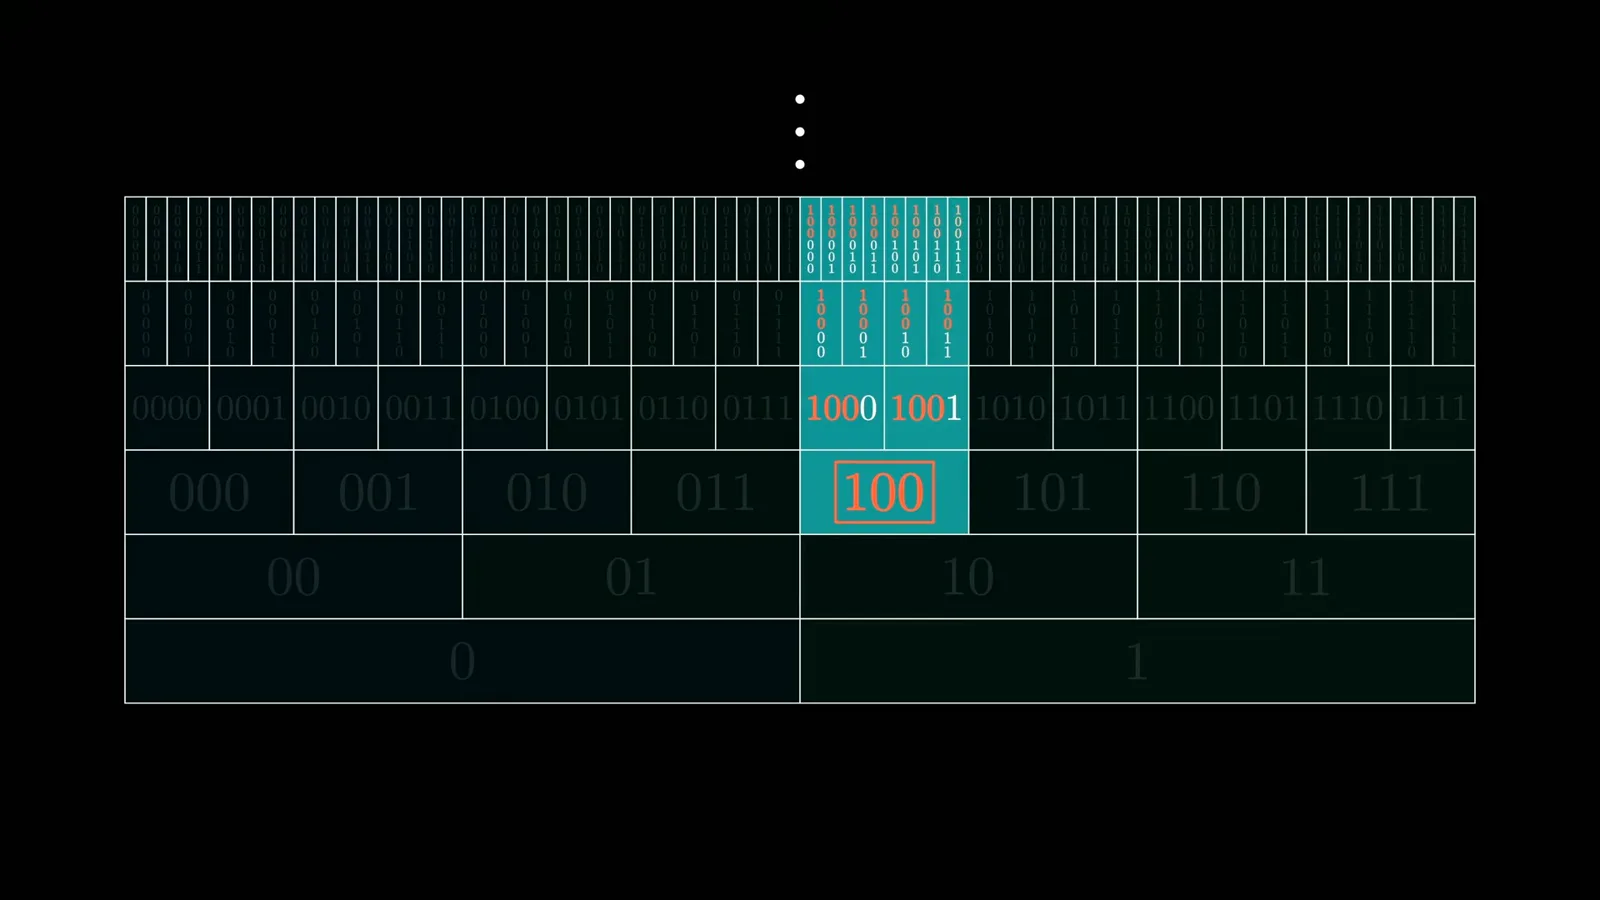
二叉树可以呈现这一约束。分配 0 会占用所有以 0 开头的码字;10 占用四分之一的空间,110 和 111 各占八分之一。这些比例与指令概率相匹配。
随机性与信息量
不可压缩的公平随机比特启发了概率负对数的概念。
第三位学生问,完美压缩器会产生什么输出。旁白从独立、公平的随机比特建立直觉:如果输出仍有可以预测的规律,就可能还有进一步压缩的空间。
在这个精心设计的机器人例子中,每个输出比特都像独立抛出的公平硬币:一半消息以 0 开头,在剩余码字之间继续选择时也保持同样的平衡。
为什么公平随机比特的平均长度无法再压缩?对于 n 比特,有 2^n 个等概率的字符串。在可唯一解码的无损方案中,要缩短某些可能结果,就必须通过延长其他结果来腾出空间。
二叉树让这种取舍变得直观:分配较短的码字会占据更多编码空间,把其他码字推向更深处。在这里,对于等概率消息,等长编码是最优的。
如果概率为 p 的事件获得理想长度 n,那么 p = 2^(-n),因此 n = −log₂(p)。Shannon 把这个量称为事件的信息量,也称惊异度。
即使 p 不是 2 的幂、理想值是小数,公式仍然有用。按这个定义,罕见事件携带的信息更多,几乎确定发生的事件携带的信息则很少。
小数信息量并不意味着单独的一个物理比特可以被拆开。编码意义涉及不同可能消息的平均长度,或一起编码的长序列;个别消息也可以分配更短的码字,但代价是其他消息变长。
语言与条件概率
上下文与小数形式的信息量将预测和整条消息的编码联系起来。
语言带来两个复杂因素:概率取决于此前的上下文,而且通常不会恰好对应 2 的幂。模型对某个短语之后的下一个字母给出的概率,可能与另一上下文中的概率不同。
整个短语的概率等于各个条件概率依次相乘。取负对数后,乘积变成求和,因此整条消息的信息量等于每个下一个字母所对应的信息量之和。
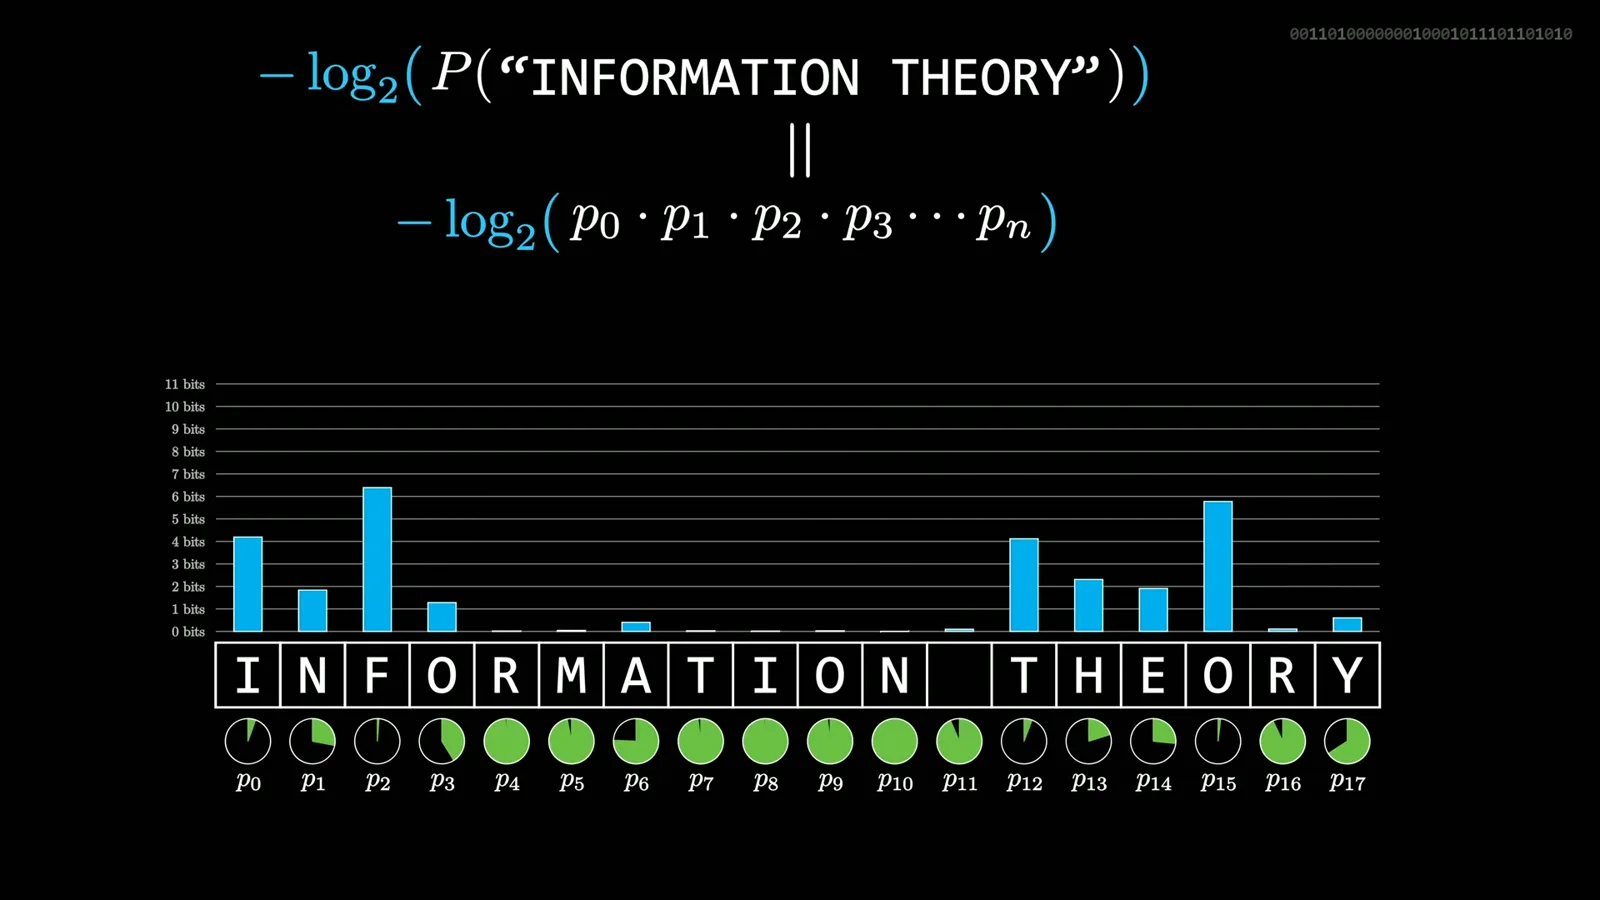
这些小数贡献可以累积为整条消息的高效编码长度,再取整为完整比特。旁白表示后续节目会展示具体的压缩算法。
难题是概率从哪里来。语言模型估计的概率不一定是语言的真实分布,而要为语言定义一个统一的“真实”分布本身也并不简单。
Shannon 最初研究 n-gram:统计书中“th”等短序列后面出现哪些字母。但上下文越长,样本就越稀疏,有些组合甚至从未出现在样本中。
Shannon 的人类预测器
人类猜字母的实验提供了一种估计语言可预测性的方法。
他还使用过一个人类语言模型。一个故事中,Shannon 让妻子 Betty 猜一段文字的下一个字母,并以不同方式记录猜对和猜错的情况。如果另一个完全相同的猜测者重复这一过程,就可以凭这份精简记录还原文本。
实验说明可预测性如何帮助压缩,但人未必每次都会作出完全相同的猜测。后来 Shannon 更系统地利用猜出每个字母所需的次数来估计概率。
关键是 Shannon 探测的是人脑中的语言模型,而不仅仅是统计语料中的字符。现代语言模型提供了另一种预测系统,不过其概率仍然只是模型的估计。
熵与熵率
符号的信息量期望给出编码下界,而语言需要考虑上下文的熵率。
熵关注每个符号的平均信息量。对于从固定分布中独立抽取的符号,熵为 H = −Σ pᵢ log₂ pᵢ。在机器人例子中,期望编码长度恰好等于熵,即每条指令 1.75 比特。
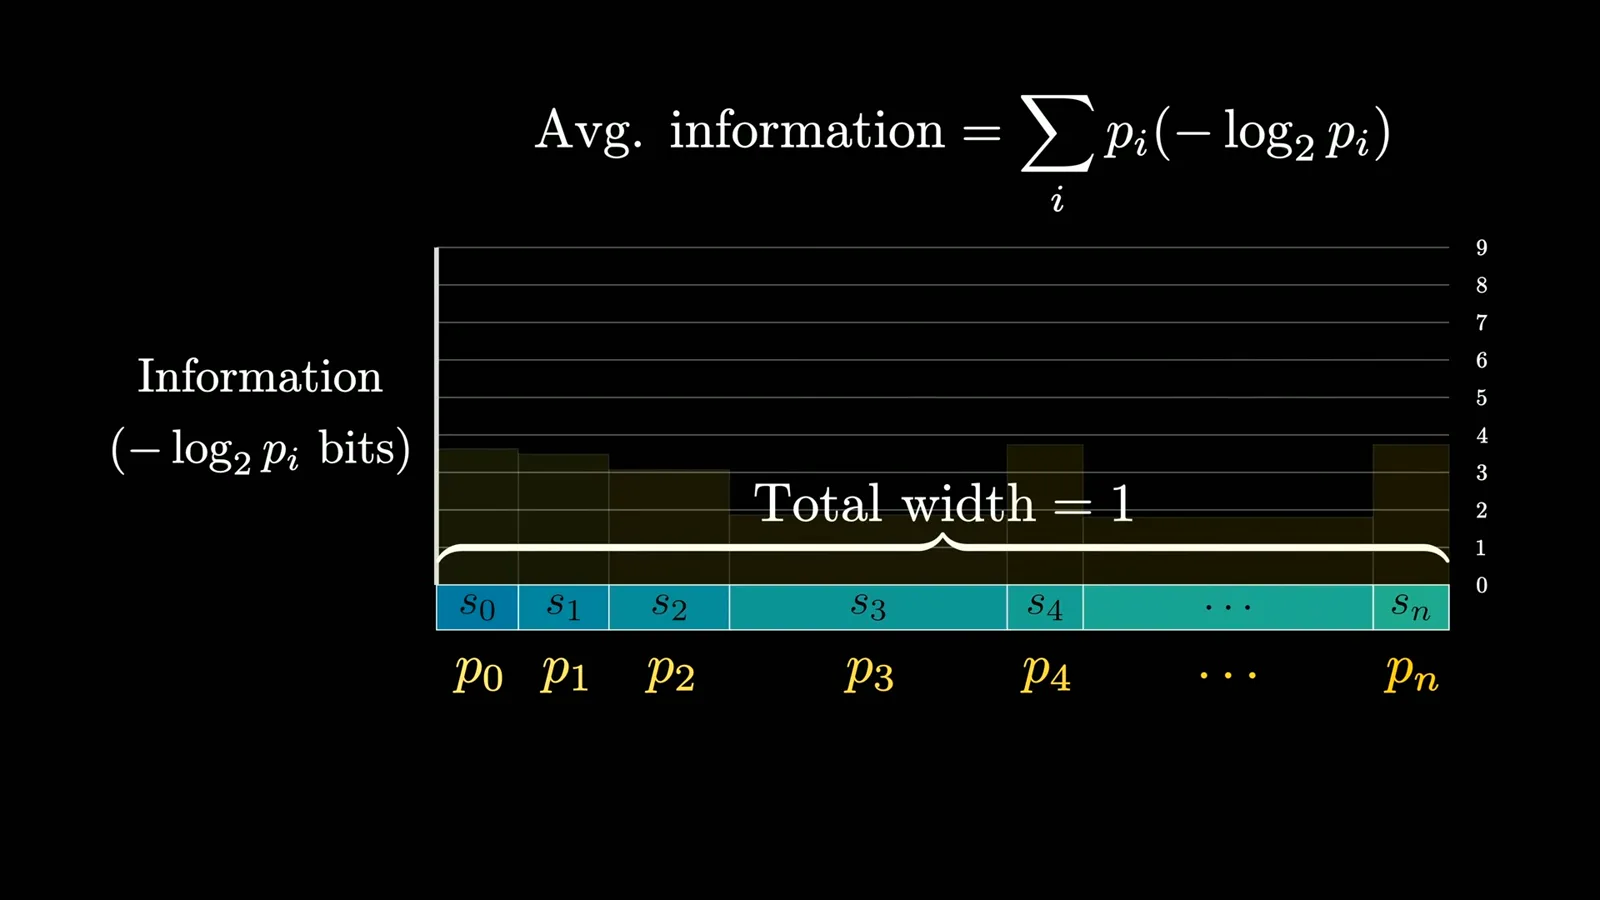
图示中,每个概率对应一个宽为 p、高为 −log₂ p 的柱形。总面积就是按概率加权的平均信息量。对于固定的可能结果集合,分布越均匀,熵就越高;若某个结果占主导,熵则较低。
在无损编码条件下,熵给出了每个符号预期比特数的下界。Shannon 的无噪声编码定理说明,在其假设成立时,分组编码可以任意逼近这一极限。
自然语言需要更一般的量:熵率。它考虑序列中的上下文,并对可能的消息求平均信息量。由于语言的底层分布无法精确知道,熵率要难算得多。
旁白提到,Shannon 在让人类猜测者看到至少 100 个前文字符时,估计英语每个字符约有 1 比特的信息量。这是与实验条件相关的估计,并非适用于所有文本的普遍常数。
后续节目将展示如何用语言模型辅助压缩,并解释模型训练中的交叉熵。第一部分则从编码问题出发,建立了概率、信息量和熵的联系。
同频道的其他文章
 40:44EN → 简体中文
 3Blue1Brown· 2026年10月16日Grant Sanderson:现在是投身数学的最好时机Grant Sanderson, Constantin Kogler · 3Blue1Brown学生担心 AI 已经解决了数学。Grant Sanderson 却认为恰恰相反:即使机器证明定理的能力超过人类,数学这套制度依然有价值,而新人正迎来一个难得的机会,可以参与重塑它。
 51:55EN → 简体中文3Blue1Brown· 2026年9月18日AI 解不出的最后一道 IMO 题Grant Sanderson · 3Blue1BrownGrant Sanderson 带你走一遍 2025 年 IMO 第 6 题——前沿模型没做出来的铺砖谜题——以及要证明一种构造最优,需要怎样的视觉耐心。
 0:55EN → 简体中文3Blue1Brown· 2026年7月24日64 块方糖谜题:六组相等距离一个 4×4×4 的方糖块有三种颜色;证明总能找到六对同色方糖,且每对距离相等。
 2:25EN → 简体中文3Blue1Brown· 2026年6月12日香农如何测量英语的信息熵一场猜字母游戏帮助克劳德·香农估算英语文本的信息量,也揭示了预测与压缩之间的联系。
 1:02EN → 简体中文3Blue1Brown· 2026年6月10日月球机器人与最优二进制编码谜题四个方向出现的频率不同,每条指令最少需要多少比特?
 0:48EN → 简体中文3Blue1Brown· 2026年3月25日子集和谜题:谁有必胜策略?从 1 到 100 中选十个整数,再寻找和相等的两个不同子集。