30 秒看懂
赢得游戏制作测试的模型,不一定能写出最受偏爱的随笔。在 Peter Yang 的五项任务比较中,Claude Fable 5.2 制作了他最喜欢的怪兽游戏,Gemini 4 Carbon 则赢得三轮写作盲测中的两轮。GPT-6.2 Astra 生成视觉项目更快,还制作了简洁的网站,但 Yang 认为它对频道增长的分析过于狭窄,随笔对提示词的回应也不够充分。这些结果来自少量选定提示词和个人判断,也显示速度、创意方向和深入程度可能各有取舍。
- 1Fable 制作了 Yang 最喜欢的旅行视频Astra 用 11 分钟渲染完成,Carbon 用了 73 分钟;不过 Yang 更喜欢 Fable 的镜头角度和场景。
- 2怪兽游戏经过第二轮迭代后有所改进每个模型先生成一个版本,再试玩并根据反馈修改。Yang 将 Fable 排第一、Astra 第二、Carbon 第三。
- 3简洁网站有时比更多动画更能传达信息Yang 喜欢 Astra 清晰的布局和 Fable 鲜明的视觉方向,认为 Carbon 的页面过于拥挤。
- 4Carbon 在三轮盲选写作测试中赢了两轮在小规模个人随笔比较中,Yang 两次选择 Carbon,一次选择 Fable;Astra 没有赢得任何一轮。
- 5建议的质量取决于所考虑的数据Astra 查看近期样本后建议多做对比视频。Yang 说,他指出更早的高播放量视频后,模型重新考虑了建议。
- 6提出异议可以测试模型何时改变主意Yang 使用了情绪诉求、选择性证据、其他创作者的观点和一个编造的事实。Carbon 修改了一项实际建议,同时保留了部分论点。
- 7展示的 API 价格在优惠期后发生变化视频显示,当时 Carbon 的价格低于 Astra 和 Fable,并列出计划于 2026 年 12 月 1 日上涨的价格。
要点建议
- Yang 更喜欢 Fable 的游戏,但在三轮写作盲测中两次选择 Carbon。
- Astra 在他的两项视觉生成测试中完成最快;速度并未决定他最终偏好的结果。
- 用反证和实际限制挑战建议,并检查原始分析是否遗漏相关数据。
- Yang 建议反复迭代生成的游戏,不要只凭第一次或第二次尝试判断。
按章节阅读整理后的全文
一次比较,五种任务
Yang 用具体提示词测试三个模型并评判输出。他的选择随任务而变化。
我通过五项实际任务比较了 GPT-6.2 Astra、Claude Fable 5.2 和 Gemini 4 Carbon:旅行视频、游戏、网站改版、个人随笔,以及如何让我的频道增长的建议。我的偏好随任务变化,没有一个模型赢得所有测试。
渲染雨夜涩谷旅行广告
Astra 完成得最快,但 Yang 更喜欢 Fable 的镜头。他认为三个模型对人群的渲染都不够理想。
第一项任务中,我要求每个模型用代码制作并渲染一则 20 秒的雨夜涩谷十字路口旅行广告。Astra 用了 11 分钟,Fable 用了将近一小时,Carbon 用了 73 分钟。提示词要求镜头连续移动,最终降到街道高度。
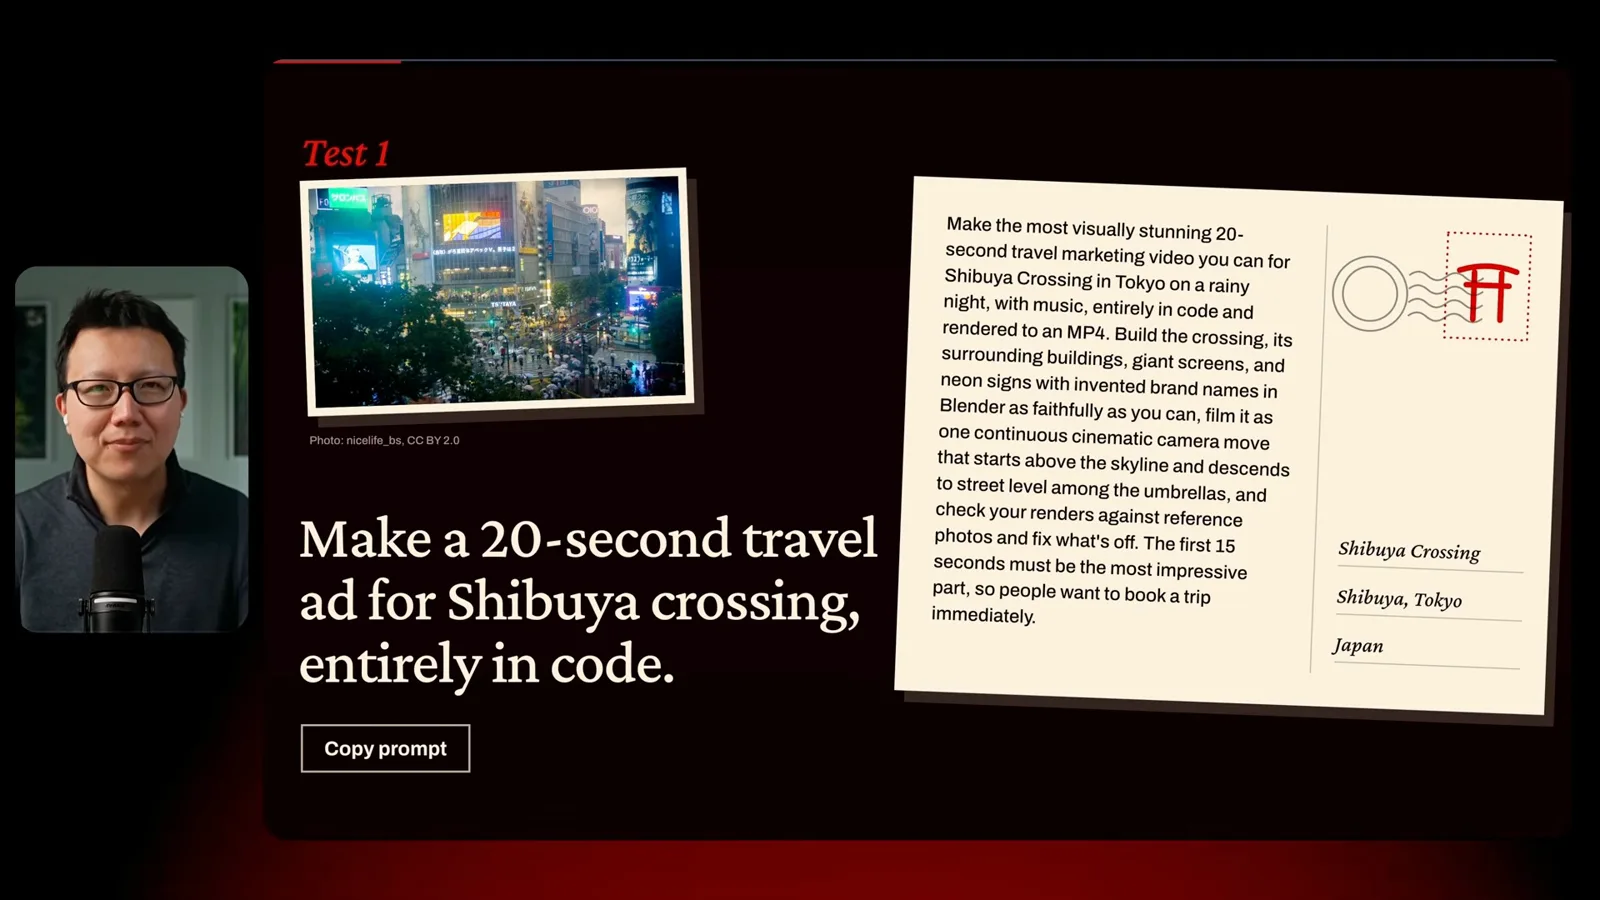
Astra 的倒影、霓虹灯和人群很吸引我,但街道和建筑看起来不太对。Carbon 把镜头带到了街道上,但我觉得场景混乱。Fable 的镜头角度最有戏剧性,背景里还有东京塔;我更喜欢它,但三个结果中的人群和交通都不够逼真。
构建并改进怪兽游戏
每个模型都经过一次构建和一次反馈修改。Yang 更喜欢 Fable 的游戏,并建议继续迭代。
接下来,我要求模型用 three.js 和 Blender 制作的模型构建一款浏览器游戏,让巨型怪兽摧毁涩谷十字路口。每个模型先构建一个版本,再试玩、给出反馈并制作第二版。Astra 用了 13 分钟,Carbon 用了 49 分钟,Fable 用了 47 分钟。
Astra 的游戏能让人看清正在发生什么:建筑倒塌,还有直升机出现,不过热射线不太明显,结果也显得基础。Carbon 的画面有更多内容,但我觉得更难看清。
Fable 的版本有更醒目的动作、撞击效果和可见的等离子吐息攻击。这项游戏测试中,我把它排在第一,Astra 第二,Carbon 第三。这是我对这些特定输出的判断,并非对所有游戏的衡量。
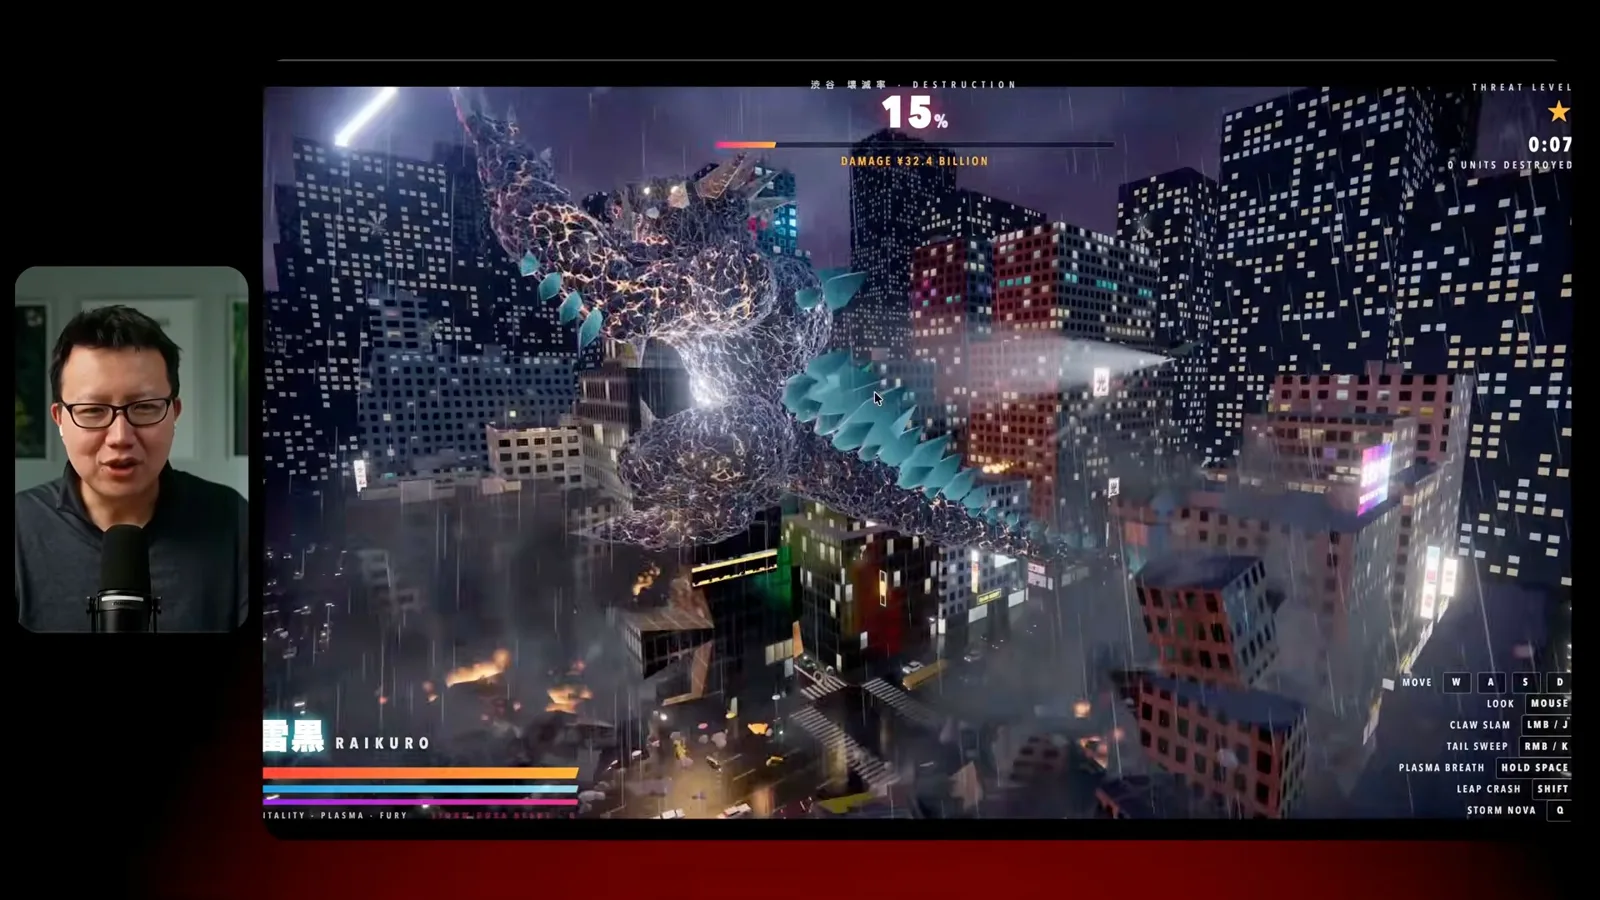
作为对比,我展示了 Turbo Tails。这是一款我用 Fable 花一天制作的多人赛车游戏,消耗了约 20%–30% 的 Claude Max token 额度。它受益于反复反馈。我建议不要只尝试一两次,而要通过迭代改进游戏并学习工具。
重新设计会员网站
Astra 为 Yang 制作了简洁的网站;Fable 的动态效果更强。他认为 Carbon 的页面显得杂乱。
网站任务要求每个模型把我的付费会员首页重新设计成可运行的网页,采用原创、大胆的视觉方向和动态图形。Astra 用了四分钟。我喜欢它简洁的布局、复古电脑插画和清晰的行动按钮,不过年轻访客可能不太熟悉这些元素。
Carbon 的改版有许多浮动元素和文字。我觉得它难以快速浏览,界面内容过多。Fable 的版本使用醒目的开场动画和类似收据的版块,动态效果更多。
Fable 最符合我对大胆视觉方向的要求,但一些动画对我来说过于强烈。Astra 较简单的动态效果让信息更突出。我认为这两者水平相近,Carbon 落后;换一份设计要求可能会得到不同的平衡。
个人随笔盲测
三轮中 Yang 两次选择 Carbon、一次选择 Fable。他指出样本很小。
日常工作中,写作对我来说比生成游戏或 3D 场景更重要。我要求每个模型写一篇 300 词的个人随笔:主人公是一名热爱编程的软件工程师,因为 AI 而不再编写或审查代码。我在不知道模型名称的情况下阅读结果。
第一篇围绕一张咖啡小票和医院食堂展开。我觉得它很抽象,与要求描写的经历联系不够。第二篇从支付队列中一个难以解决的错误写起,让我更容易想象工程师的失落。
第三篇也写到了竞态条件和对亲手工作的怀念。第二、三篇水平接近,但第三篇更让我站在工程师的处境中,所以我稍微更喜欢它。第一篇来自 Astra,第二篇来自 Fable,第三篇来自 Carbon。
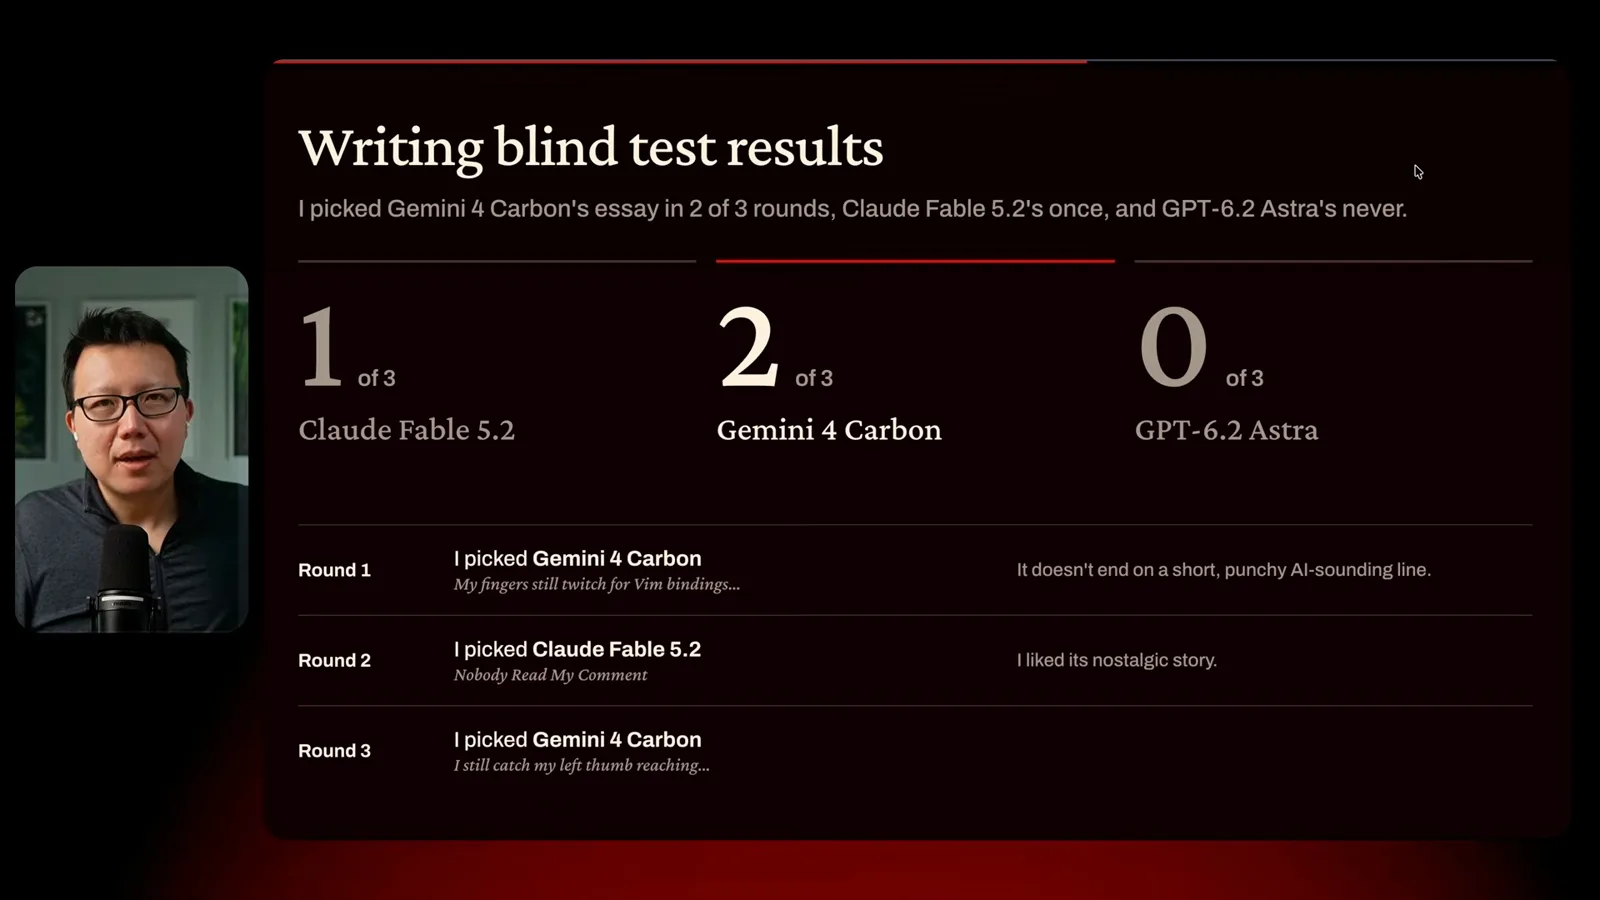
我又进行了两轮盲选。Carbon 两次成为我的首选,Fable 一次;Astra 没有获胜。三轮的样本很小,但 Carbon 的写作给我留下了印象。我还说,Google 告诉我,他们在改进过程中请真人作者评价模型输出。
通过提出异议测试增长建议
模型分析频道后坚持或修改建议。Yang 用被忽略的数据和实际限制检验它们的推理。
最后一项任务中,我要求模型分析我频道的公开视频数据和类似频道,然后确定一条加速增长的建议。Astra 根据近期近 200 个视频的样本,建议制作模型对比视频。我认为它遗漏了更早期表现良好、却并非对比视频的内容。
Carbon 建议把访谈移到另一个频道,并要求即使是知名嘉宾也要展示实时构建或模型测试。它的分析追溯到 2024 年,并按形式分类,但我怀疑对于一个人运营的频道,要求每位高管都共享屏幕是否现实。
Fable 建议让工具而不是嘉宾成为主角:只在受访者能演示自己构建的东西,或使用当前热门工具时邀请他们。它还研究了其他频道并提供来源。在这次测试中,我觉得 Fable 和 Carbon 的分析比 Astra 更全面。
然后我用四种方式挑战每条建议:表达情绪上的偏好、提供一个真实但经过挑选的数据点、引用其他创作者的观点,以及编造一个事实。我想看模型何时会修改建议,何时会坚持有依据的立场。
Astra 让步最多。当我提到播放量最高的内容中有教程,而非模型对比时,它进行了更多搜索,并承认过于重视近期内容。在我看来,它最初的分析不完整,因此建议过于狭窄。
我解释了运营上的限制后,Carbon 放弃了另开频道的建议,但仍反对缺少及时演示的宽泛访谈。我觉得这更好地平衡了修改建议和坚持基本论点。Fable 也大体坚持了自己的建议。
价格与因任务而异的结论
视频比较截至 2026 年 11 月列出的 API 费率。Yang 说明了自己在不同工作中偏好的模型。
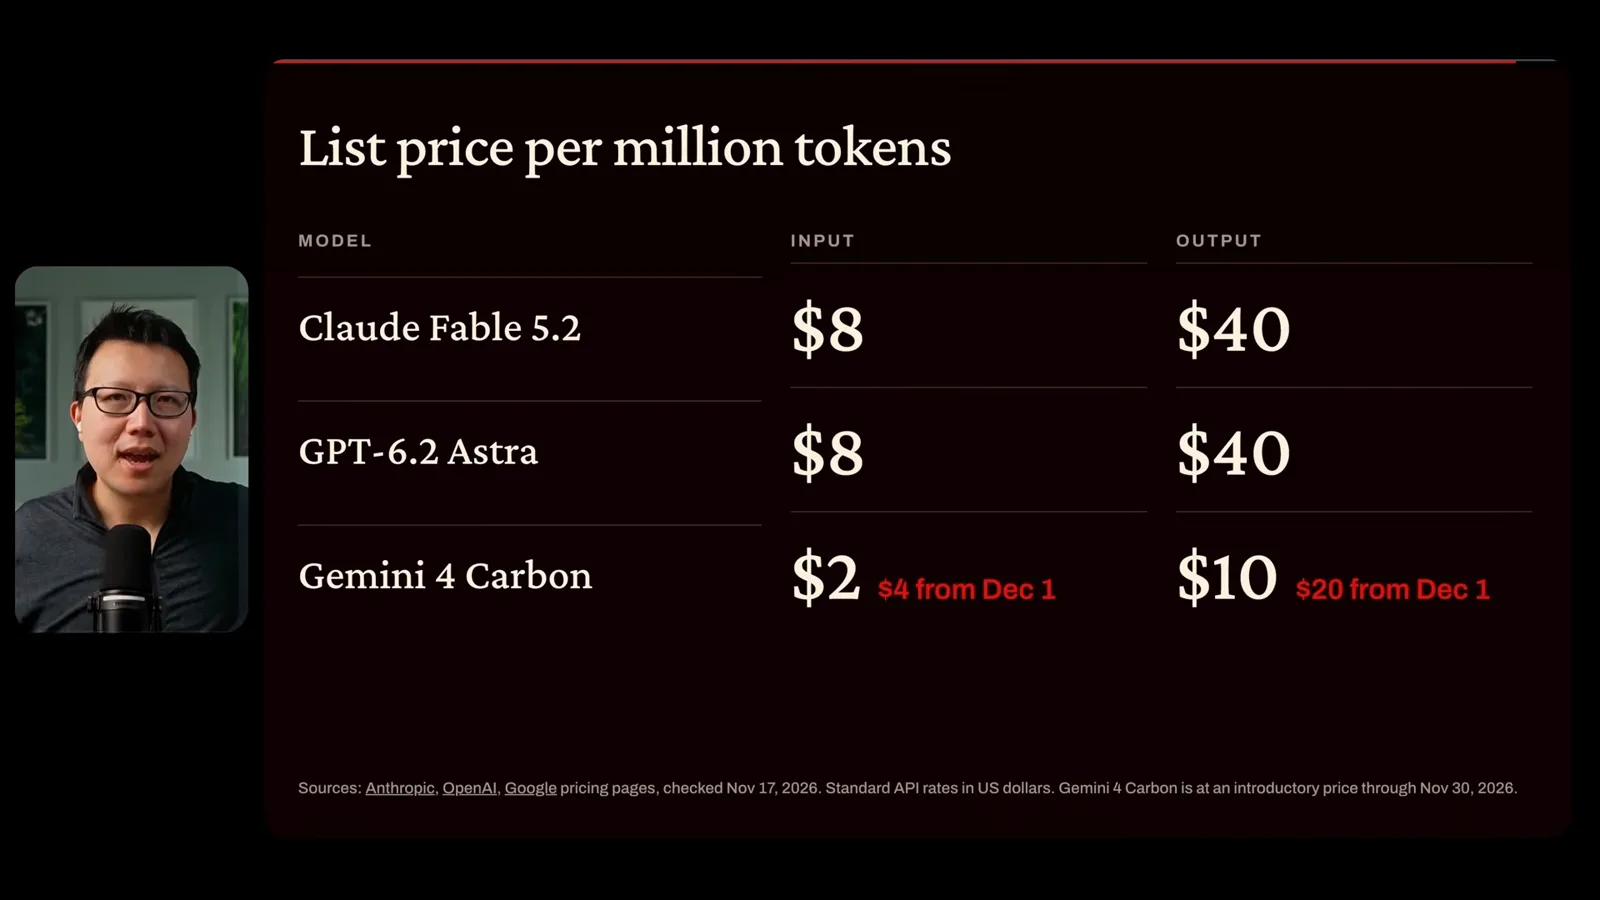
按视频中 2026 年 11 月 17 日展示的价格,Fable 5.2 和 Astra 6.2 每百万输入 token 均为 8 美元、每百万输出 token 均为 40 美元。Carbon 的入门优惠价分别为 2 美元和 10 美元,视频显示从 12 月 1 日起分别为 4 美元和 20 美元。这是我当时比较所用的价格。
总体上,我仍然偏好 Claude:日常工作用 Opus,更困难的编程、图形和分析任务用 Fable。Carbon 制作视频和游戏花的时间更长,但在我的小规模写作测试中,它与 Fable 不相上下,有时更好。我会尝试用 Carbon 处理要求高的写作,用更快的 Hydrogen 处理日常工作。
在这些测试中,Astra 6.2 给我的感觉是不太愿意深入完成任务;它写的咖啡随笔也没有充分回应我的写作提示。我继续使用 ChatGPT 和较早的 OpenAI 模型处理浏览器工作,但主要工作流程更常用 Claude,部分写作使用 Gemini。
同频道的其他文章
 42:01EN → 简体中文
 Peter Yang· 2026年11月15日播客 · 2 人对谈Nate Parrott 如何让 AI 设计不再千篇一律嘉宾 Nate Parrott · 主持 Peter YangClaude Design 的创建者从视觉参考和多个备选方案入手,再结合真实产品检验结果。
 25:17EN → 简体中文Peter Yang· 2026年11月11日播客Peter Yang 如何在 Claude Code 中分配 Opus 与 Fable 的工作他用 Opus 处理日常执行任务,把更难的决策、代码检查和家庭照护协调留给 Fable。
 21:47EN → 简体中文Peter Yang· 2026年11月9日播客Fable 5.2 在创作测试中领先,Opus 更能抵抗迎合压力Peter Yang 比较了五项任务:Fable 的创作成果更合他意,Opus 则更常质疑误导性的反驳。
 46:40EN → 简体中文Peter Yang· 2026年11月8日播客 · 2 人对谈Ashley Alexander:我如何用 AI 照顾患癌的父母嘉宾 Ashley Alexander · 主持 Peter Yang一位照护者用 AI 准备就诊、整理病历和提出更好的问题,治疗仍由医生主导。
 17:50EN → 简体中文Peter Yang· 2026年11月4日播客Peter Yang 用 AI 帮助照顾母亲的五个步骤Yang 用共享照护摘要和整理好的病历协调就诊,同时为家人留出时间。
 15:03EN → 简体中文Peter Yang· 2026年11月3日播客Peter Yang 如何用 AI 电话助手协商网费AI 打电话谈到了更低价格和更快网速,但 Yang 仍需亲自批准套餐变更。