30 秒看懂
在这段 2025 年 6 月的视频中,Matthew Berman 解读 Reddit 对 Anthropic 提起的民事诉讼,重点讨论所称的抓取行为、模型训练、用户隐私和 Reddit 内容授权的价值。他还质疑能否凭聊天机器人的回答可靠地确认其训练数据来源。 Anthropic 对 Reddit 的指控提出异议。联邦法院于 2026 年 3 月将案件发回加州州法院;2026 年 9 月,州法院法官允许三项诉讼请求继续进行,并支持对另外两项请求的异议,同时允许修改后重新提出。这些程序性决定既未认定指控属实,也不是关于责任的最终判决。
- 1起诉书Reddit 提起民事诉讼,诉讼请求包括违约和不正当竞争。Anthropic 否认这些指控。
- 2爬虫与隐私指控Reddit 指控 Anthropic 无视限制,在发表屏蔽名单声明后继续自动访问。这些说法仍有争议。
- 3训练数据与聊天机器人回答起诉书引用一篇 Anthropic 研究论文和 Claude 的回答;Berman 提醒,模型对自身的描述并非决定性证据。
- 4授权争议Reddit 主张未经授权的使用损害了其内容授权市场;Berman 讨论用户可能被分流,但没有声称对此进行过测量。
- 5请求的救济起诉书请求金钱救济和禁令等措施。提出救济请求不等于法院已经裁定给予救济。
要点建议
- Reddit 指控 Anthropic 未经授权访问并使用用户内容;Anthropic 对这些指控提出异议。
- 起诉书称,在 Anthropic 表示已将 Reddit 加入爬虫屏蔽名单后,其机器人又访问超过 10 万次;这个数字来自 Reddit 的主张。
- 聊天机器人对自身训练数据的回答不能可靠地审计实际使用了哪些数据。
- 删除源数据与消除其对已训练模型的影响,是两个不同的技术问题。
- 2026 年 9 月,三项诉讼请求通过初步异议,另两项获准修改;该裁定没有认定责任。
按章节阅读整理后的全文
针对 Anthropic 的民事诉讼
Berman 介绍 Reddit 的起诉书和诉讼请求。这些指控存在争议,后来的程序性决定也未解决实体问题。
2025 年 6 月,Matthew Berman 解读 Reddit 对 Claude 的开发公司 Anthropic 提起的民事诉讼。Reddit 指控对方未经授权抓取和使用用户内容;Anthropic 表示不同意这些指控,并将为自己辩护。Berman 阅读的[起诉书](https://redditinc.com/hubfs/Reddit%20Inc/Content/PDFs/Docket%20Stamped%20Complaint.pdf)所载指控是原告的立场,并非已认定的事实或刑事定罪。
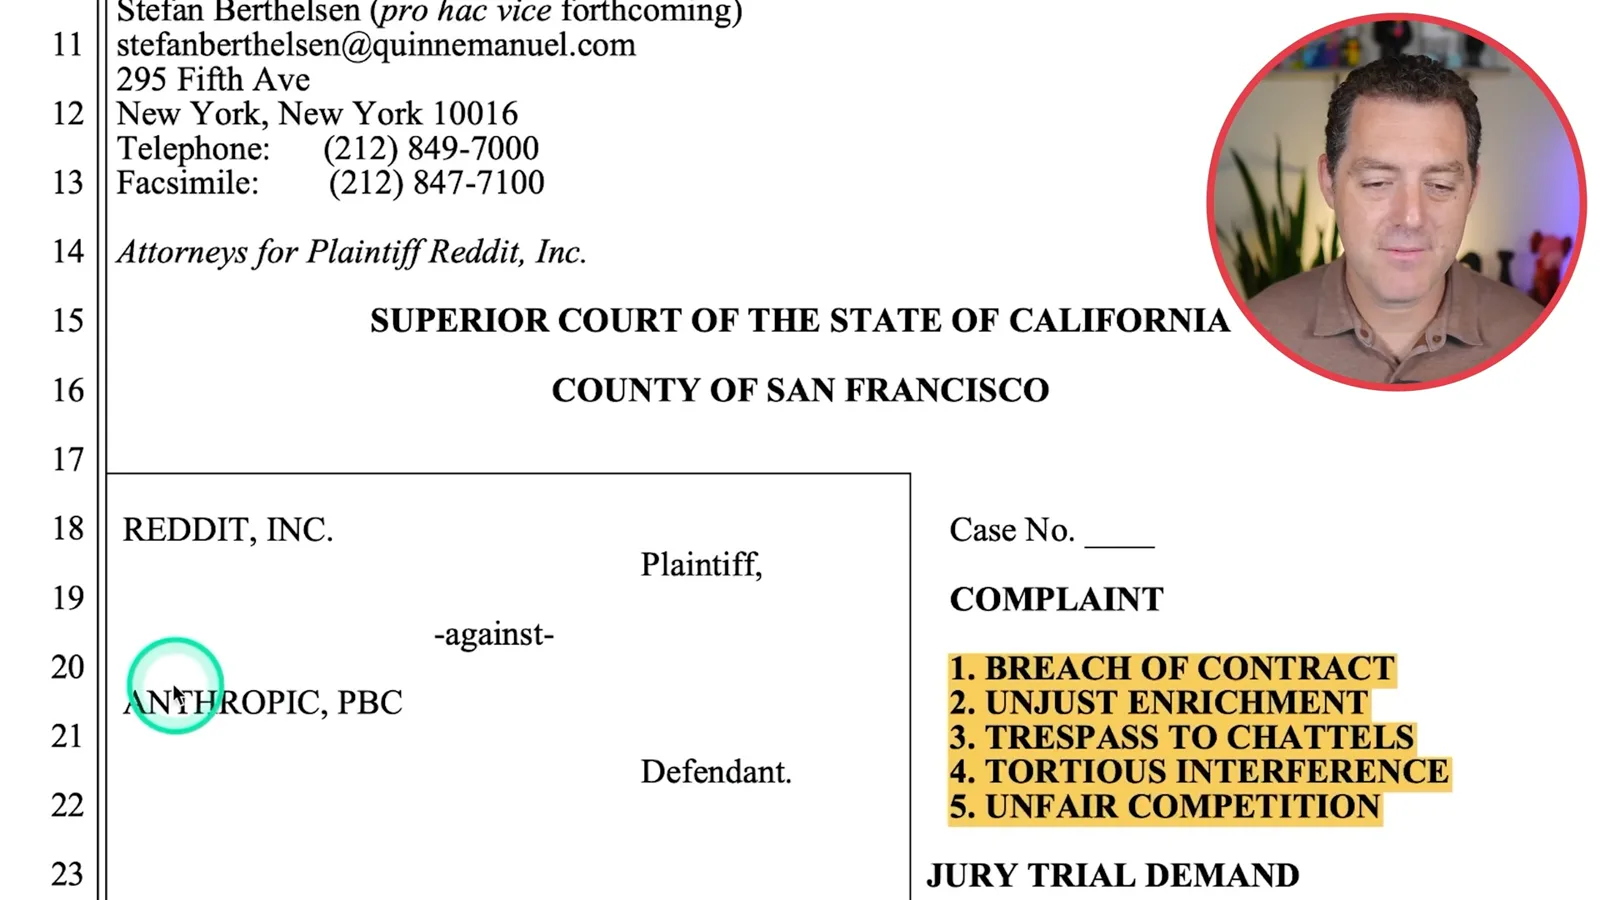
Reddit 在旧金山的加州高等法院起诉,提出违约、不当得利、侵犯动产、干扰合同关系和不正当竞争等诉讼请求,并要求陪审团审理。后续进展中,Anthropic 寻求将案件转入联邦法院;[联邦法院于 2026 年 3 月将案件发回](https://www.courthousenews.com/wp-content/uploads/2026/03/reddit-v-anthropic-remand-order.pdf)州法院。
起诉书以尖锐措辞对比 Anthropic 公开强调的诚信、安全与 Reddit 指控的行为。Berman 认同起诉书对该公司定位的批评。这种评价是他自己的观点;起诉书的措辞和 Berman 的认同都不能证明 Anthropic 违反协议或违法。
机器人、隐私与公开声明
起诉书质疑 Anthropic 关于个人数据和 robots.txt 的声明,并指控其在表示已屏蔽 Reddit 后继续自动访问。
Reddit 指控,尽管 Anthropic 公开表示无意用个人数据训练模型,但其仍在没有征得同意的情况下,故意使用 Reddit 用户的个人数据进行训练。Reddit 还指控 Anthropic 未遵守 robots.txt 指令。robots.txt 文件用于表达抓取偏好,但特定访问行为的法律效力是案件需要处理的问题,不能仅凭文件存在就认定。
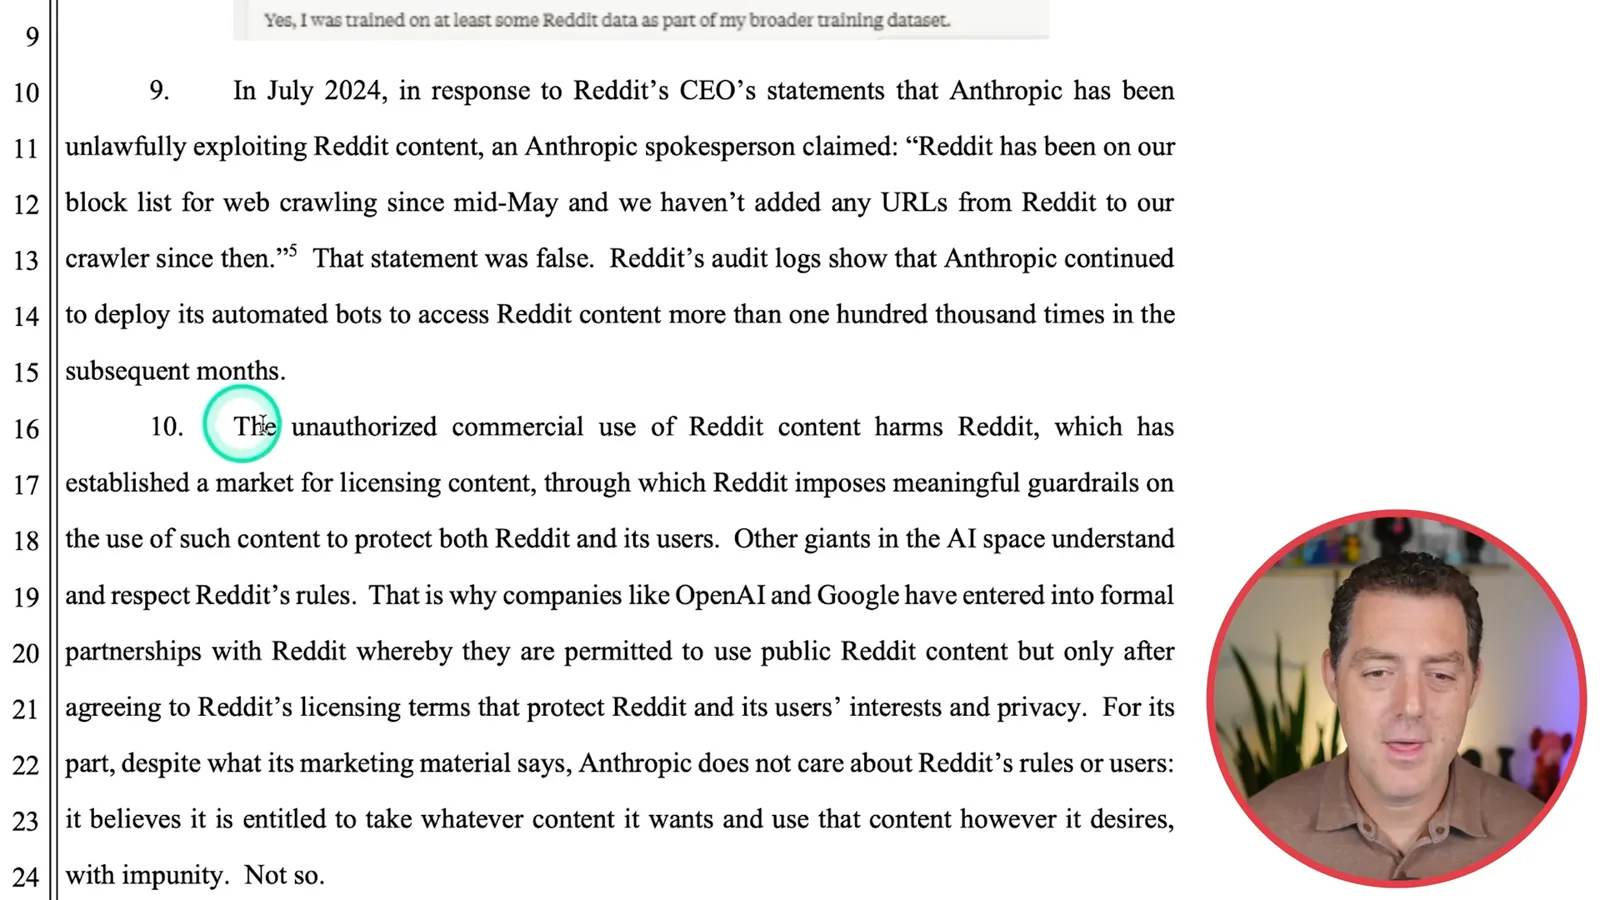
起诉书称,一位 Anthropic 发言人于 2024 年 7 月表示,Reddit 自 5 月中旬起就已列入其网页爬虫屏蔽名单。Reddit 指控,其审计日志显示 Anthropic 的机器人在接下来的几个月里访问其内容超过 10 万次。这是 Reddit 对自身日志的描述;视频没有独立查明每次请求获取了什么,也没有证实该声明是否虚假。
Reddit 还主张 Anthropic 没有同意其为用户寻求的保护措施,包括处理用户删除的帖子。Berman 认为,Reddit 与 YouTube 等社交平台一样,拥有特别有价值的人类创作信息。他对这些数据集经济价值的评价是市场观点,不是法律认定。
训练数据与授权
Reddit 引用研究和聊天机器人对话支持其诉求。Berman 思考模型自述作为证据的局限,并讨论经济损害。
Reddit 指控 Anthropic 早在 2021 年 12 月就使用 Reddit 帖子进行训练,并引用了包括首席执行官 Dario Amodei 在内的 Anthropic 研究人员共同撰写的研究。起诉书引用的研究讨论了偏好建模数据中的 Reddit 评论;这些内容对争议行为究竟有何意义,仍是 Reddit 诉讼主张的一部分。
起诉书还包含一段对话,其中 Claude 说自己使用过一些 Reddit 数据训练。Berman 质疑这种回答能否作为经得起推敲的证据:模型可能出错、生成没有依据的回答,或通过其他来源接触材料。聊天机器人对自身的描述不能可靠地审计其实际训练数据。
Berman 再次讨论 Reddit 关于屏蔽名单声明后自动访问仍在继续的指控。Reddit 主张未经授权的商业使用损害了其内容授权市场,并将 Anthropic 与自己同 OpenAI 和 Google 签订的协议作对比。特定行为是否未经授权、是否造成损害,都是诉讼中的争议问题。
Berman 思考用户是否会向 Claude 询问源自 Reddit 的信息,而不再访问 Reddit。他说自己仍重视直接阅读并参与讨论,但认为可能存在经济损害。这是他的解读,并非对流失流量的实测估计,也不是法院认定。
删除的内容与请求的救济
一段聊天机器人对话引出关于已删除帖子和训练后模型的问题。Berman 解读 Reddit 请求的损害赔偿和禁令。
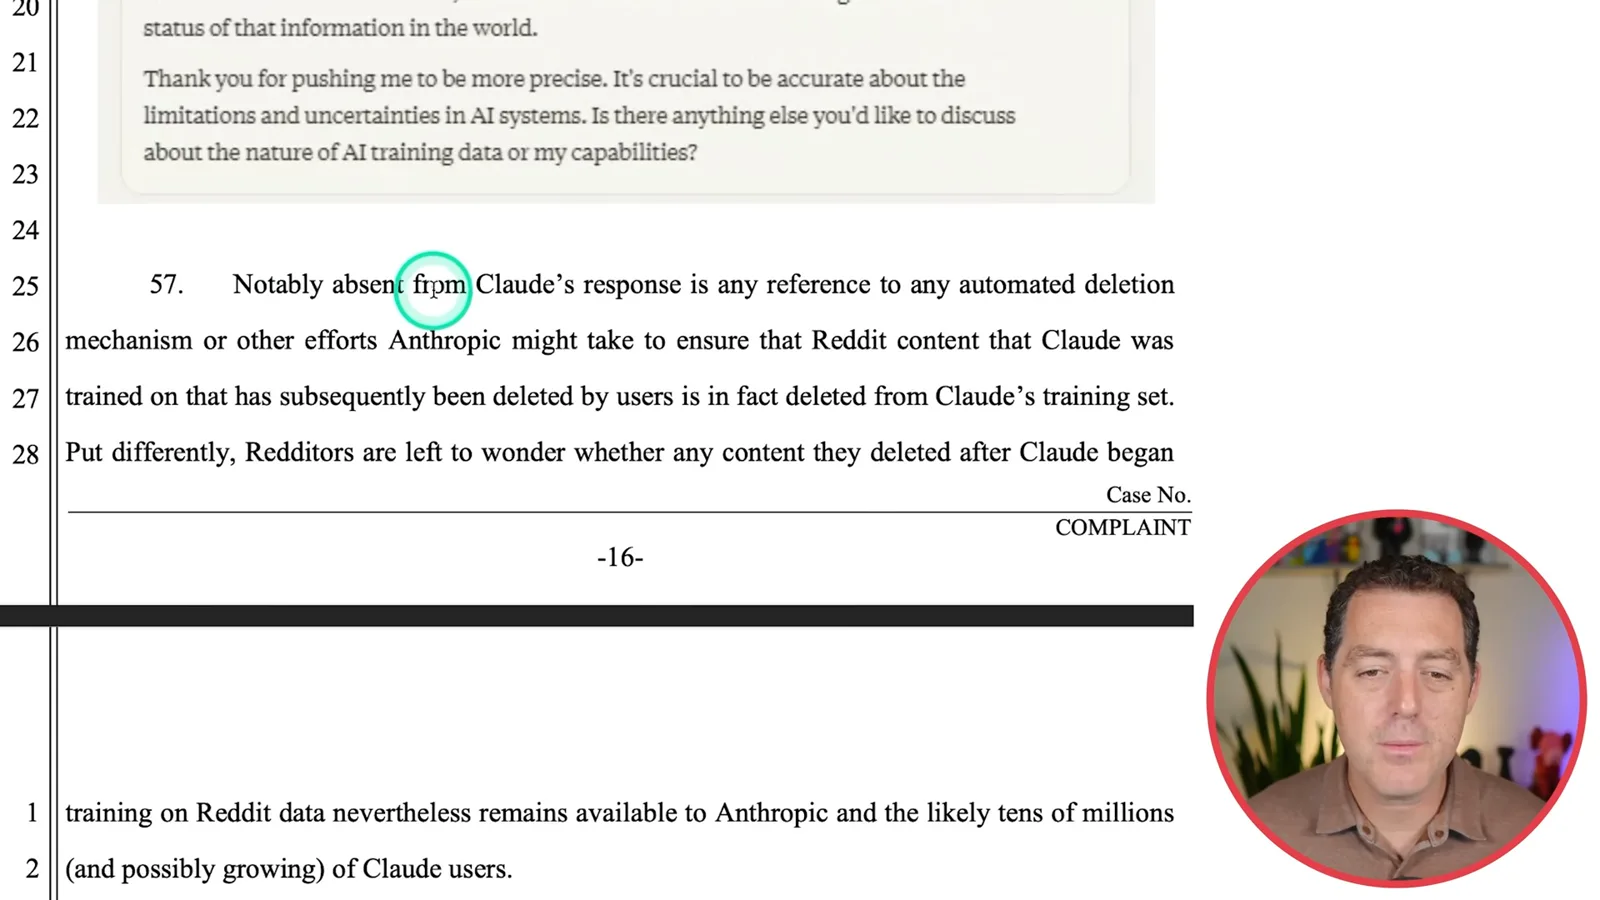
起诉书中的另一段对话询问 Claude 关于已删除的 Reddit 帖子。聊天机器人表示,它无法确定单条训练数据的原始来源或当前是否已删除。Reddit 认为,回答没有指出任何自动删除机制;但仅凭模型的回答不能确认公司内部的数据处理做法。
Berman 认为,训练完成后消除单条数据的影响很困难,并提出可能需要持续重新训练。这是他的技术判断,并非已证明无法实现:从存储的数据集中删除一条记录,与修改训练后的模型是两个不同的问题;移除或抑制模型已学信息的方法各有局限。
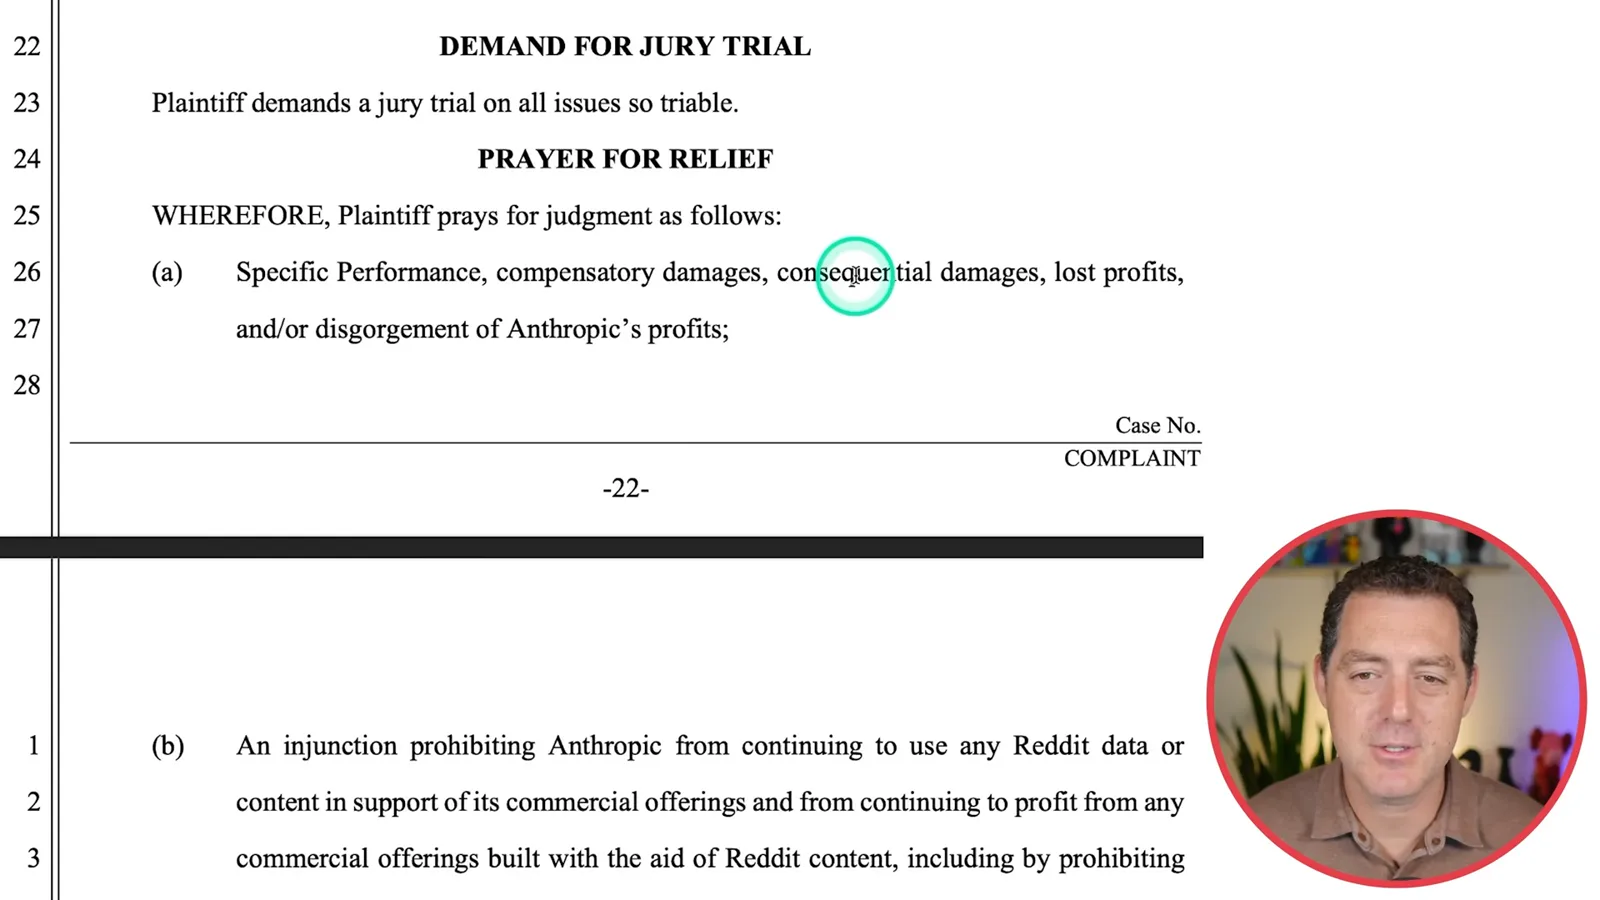
Reddit 请求的救济包括实际履行、补偿性和后果性损害赔偿、利润损失或追缴所得、禁止特定 Reddit 内容商业用途的禁令、返还、惩罚性赔偿及律师费。这些是请求,并非法院已作出的裁决。Berman 表示将继续关注诉讼进展。
作为后续背景,2026 年 9 月的一项[州法院程序性裁定](https://trellis.law/doc/290965239/order-overruling-demurrer-to-complaint-to-breach-contract-interference-with-contract-ucl-causes-action-sustaining-demurrer-with-leave-to-amend-to-unjust-enrichments-trespass-to-chattels-cause-action-see-scanned-order-for)允许合同、干扰合同和不正当竞争三项请求继续进行;法院支持对不当得利与侵犯动产两项请求的异议,同时允许修改后重新提出。该裁定审查的是诉状,并未判定 Reddit 的指控是否属实或 Anthropic 是否承担责任。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。
 1:03:37EN → 简体中文Matthew Berman· 2026年10月23日Matthew Berman 团队测试 Kimi K3.1:动画、游戏与图表Matthew Berman, Alex, Brian · Forward Future一场团队直播问答变成了对 Kimi K3.1 的非正式测试,内容涵盖个人智能体工作流、动态图形、浏览器游戏和基准图表。
 0:53EN → 简体中文Matthew Berman· 2026年10月22日Sam Altman 谈 AI 与新知识的发现Sam Altman · OpenAIAltman 预计,数学发现方面的进展将延伸到生物学、材料和能源领域。