30 秒看懂
Matthew Berman 希望本地 AI 成功,因为它能让用户控制数据、减少对少数供应商的依赖。但他认为,目前的硬件成本、设置难度和吞吐量让托管模型更适合自己的工作。他披露自己投资了 LM Studio。 他比较了示例硬件和云端成本,并认为操作系统的无缝整合以及设备与云端之间的混合路由,可能让更多人用上本地 AI。
- 1本地与开放权重本地描述推理运行的位置;开放权重模型也可以远程托管。
- 2控制与自主权将数据保留在设备上,并在不依赖供应商的情况下保有访问权,是 Berman 希望本地 AI 成功的原因。
- 3吞吐量很重要单块 GPU 必须在多个智能体之间分配吞吐量,因此并行工作是一项关键限制。
- 4取决于场景的成本比较他的图表采用了特定工作负载、硬件摊销和电费假设;结果并非普遍价格。
- 5混合模式的未来他提议由操作系统将敏感或适合的任务路由到本地,把更难的任务交给云端。
要点建议
- 本地推理和开放权重是不同概念:开放权重模型也可以部署在云端。
- 硬件成本、设置时间、推理速度和并发工作负载都会影响本地 AI 的经济性。
- 本地模型提供隐私、离线访问和自主权,托管模型则方便使用且更新迅速。
- Berman 认为目前主要用户是爱好者,并预计无缝混合路由能扩大使用范围。
按章节阅读整理后的全文
本地 AI 为何重要
Berman 解释了为何自己依赖托管服务工作,却仍希望本地 AI 成功。他区分了本地推理与开放权重模型。
目前,让普通人用本地 AI 取代托管服务订阅,在我看来并不合理。它可能很贵、设置困难,能力也不如前沿模型。但我希望它成功:如果本地 AI 失败,我认为权力平衡会面临更大的问题。
我应该是很容易被说服使用本地 AI 的人。我有大量计算硬件、技术经验和配置模型的时间,也关心数据控制权。但真正需要完成工作时,我还是会用 ChatGPT 或 Claude。现在的讨论常常聚焦于某人运行了什么模型,而不是用它完成了什么。
这引出了三个问题:本地 AI 适合谁?如果它最终行不通,会发生什么?实际经济账又算不算得过来?我希望每天都能用它,也重视它的好处。不过,在花几千美元买 GPU 或电脑之前,值得先考虑这些取舍。
本地 AI 和开放权重 AI 是两回事。本地模型在自己的电脑上运行,断网后仍能回答问题。开放权重模型则可以供他人运行,但也可能部署在数据中心,通过互联网提供服务。即使不在本地运行,我也大力支持开放权重。
一些开放权重模型非常出色,已经接近前沿水平,但最强的模型通常非常庞大。它们往往无法装进消费级硬件,即使专业设备也可能吃力。要高速运行超大模型,可能需要成排的 GPU 和巨额投入。
好处与实际限制
数据控制、访问权和离线使用是本地 AI 的吸引力。成本、模型大小、速度和并行工作则让选择变得复杂。
数据主权是我希望本地 AI 成功的一个原因。使用托管服务时,你会把信息发送给服务商。我已经把生活中的许多信息交给在线服务,因此并不总是把这视为决定性问题,但我可能低估了本地控制的价值。
访问权是另一个顾虑。实验室可以更改规则,也可以切断它不喜欢的用途。我曾因 Anthropic 限制通过订阅使用 OpenClaw 而感到沮丧;即使其他供应商更宽松,它的商业利益也可能改变。这些问题对个人很重要,对企业则可能至关重要。
本地模型还能离线工作。对我来说,这通常是小概率场景,因为我有稳定的网络;但硬盘上的模型可以成为紧急情况下有用的备份。那时,能获得一些信息可能比使用最快、最强的前沿模型更重要。
有人认为本地 AI 可以省下订阅费。我认为,把硬件算进去之后,它不一定比每月支付 20 或 100 美元更便宜。不过,我喜欢拥有智能使用权的想法:如果大家都依赖少数实验室,权力可能会以令我不安的方式集中。
目前,我最关心的是完成工作,而本地 AI 还无法满足我的需求。最接近前沿水平的开放权重模型体积很大。量化可以缩小模型,让它适配较小的机器,但会牺牲一些质量,推理速度和并行能力仍然受限。
一块 GPU 必须在并发智能体之间分配算力。一台能运行一个模型的机器,未必有足够吞吐量让五到十个智能体同时工作。你可以用多个系统或 GPU 搭建接近家庭数据中心的设备,但硬件成本和设置时间会大幅上升。
展示本地模型的人并不总会说明每秒生成多少 token。对我来说,每秒 15–30 个 token 除了简单问答之外几乎不够用;70–100 个则实用得多。这是我个人工作中的偏好,多个智能体还得共享可用吞吐量。
本地系统可以全天运行。如果你已经买了昂贵的硬件,保持设备忙碌有助于将前期成本摊到三至五年。托管订阅有额度限制,持续高强度使用可能需要更贵的套餐或额外付费。
设置与硬件经济账
Berman 讨论学习成本,并披露自己投资了 LM Studio。他比较了 GPU 和 Mac Studio 的估算数据。
学习成本也很高。我当过多年工程师,一直自己组装电脑,但仍觉得本地 AI 很难配置。我享受部分折腾过程,却更希望把大部分时间用来完成工作,而不是让机器做好工作的准备。
我投资了 LM Studio,这家公司致力于让本地模型更容易使用。我认为它的产品是最易用的之一,但它仍须处理不同的 NVIDIA 芯片、操作系统、模型大小和架构。要为所有组合打造统一而简单的体验并不容易。
我用一个闭源模型帮助计算本地 AI 的经济账,比较了 GPU 和 Mac Studio。以下是视频录制时的估算,并非保证价格或性能。硬件供应、模型选择、量化方式和工作负载都可能改变结果。
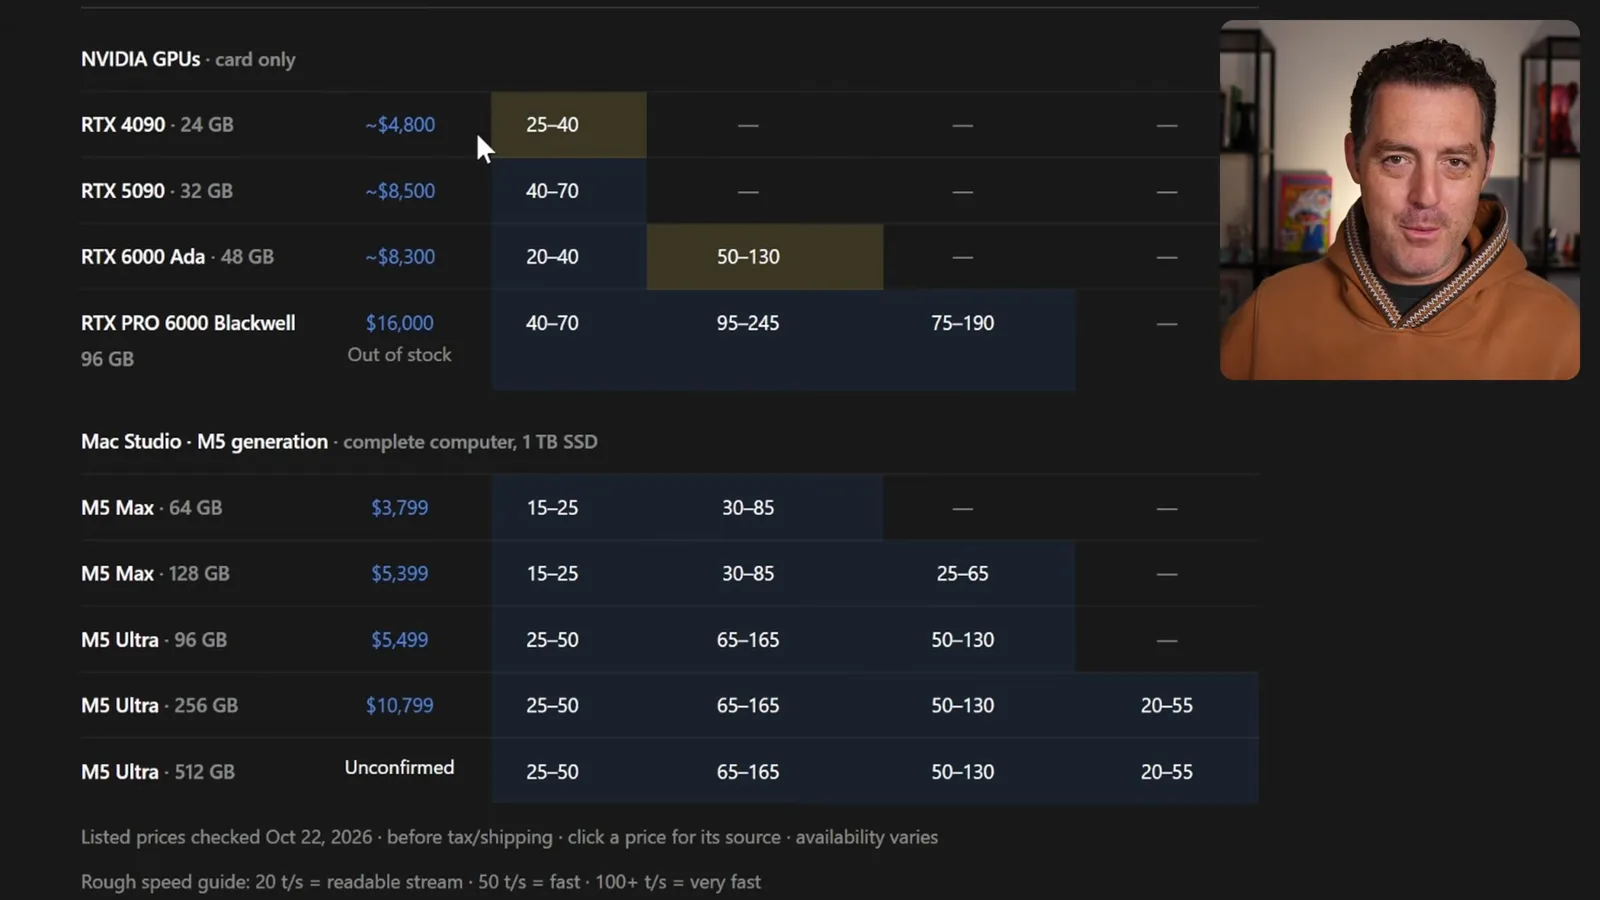
我的表格显示,RTX 4090 约为 4800 美元,运行较小的 Qwen 3.8 27B 模型时每秒生成约 25–40 个 token。约 8500 美元的 RTX 5090 运行同一模型时达到每秒 40–70 个 token。单路使用还算实用,但并发任务必须共享硬件。
表中 RTX 6000 Ada 约为 8300 美元,运行 Qwen Coder Next 时估计每秒生成 50–130 个 token。售价 16000 美元的 RTX Pro 6000 Blackwell 还可以更快,但购买它是一笔重大投入。这些单路估算不代表多个智能体同时运行时,每个都能达到同样速度。
最新的大型开放权重模型可能需要大幅量化才能放进这些设备。即使质量损失不大,也需要纳入权衡。一块预计使用三四年的 16000 美元显卡,必须与无需同等设置和维护的订阅服务比较回报。
对配备 256 GB 或 512 GB 内存的 Mac Studio,我的表格估计大型模型每秒可生成约 20–55 个 token。速度达到上限时,单项任务可能还算可用,但高级用户可能希望多个智能体同时工作。当时的硬件供应和报价都存在不确定性。
比较成本与质量
图表在特定工作负载下比较本地硬件与托管模型成本。Berman 讨论供应限制和开放模型的激励机制。
我在特定假设下画了一张成本与基准质量的对比图:每天 1000 次请求,每次 4000 个输入 token、1000 个输出 token,持续 30 天。本地估算将一台 4000 美元的机器分摊 36 个月,假设没有转售价值,并计入电费。比较结果高度依赖这些假设。
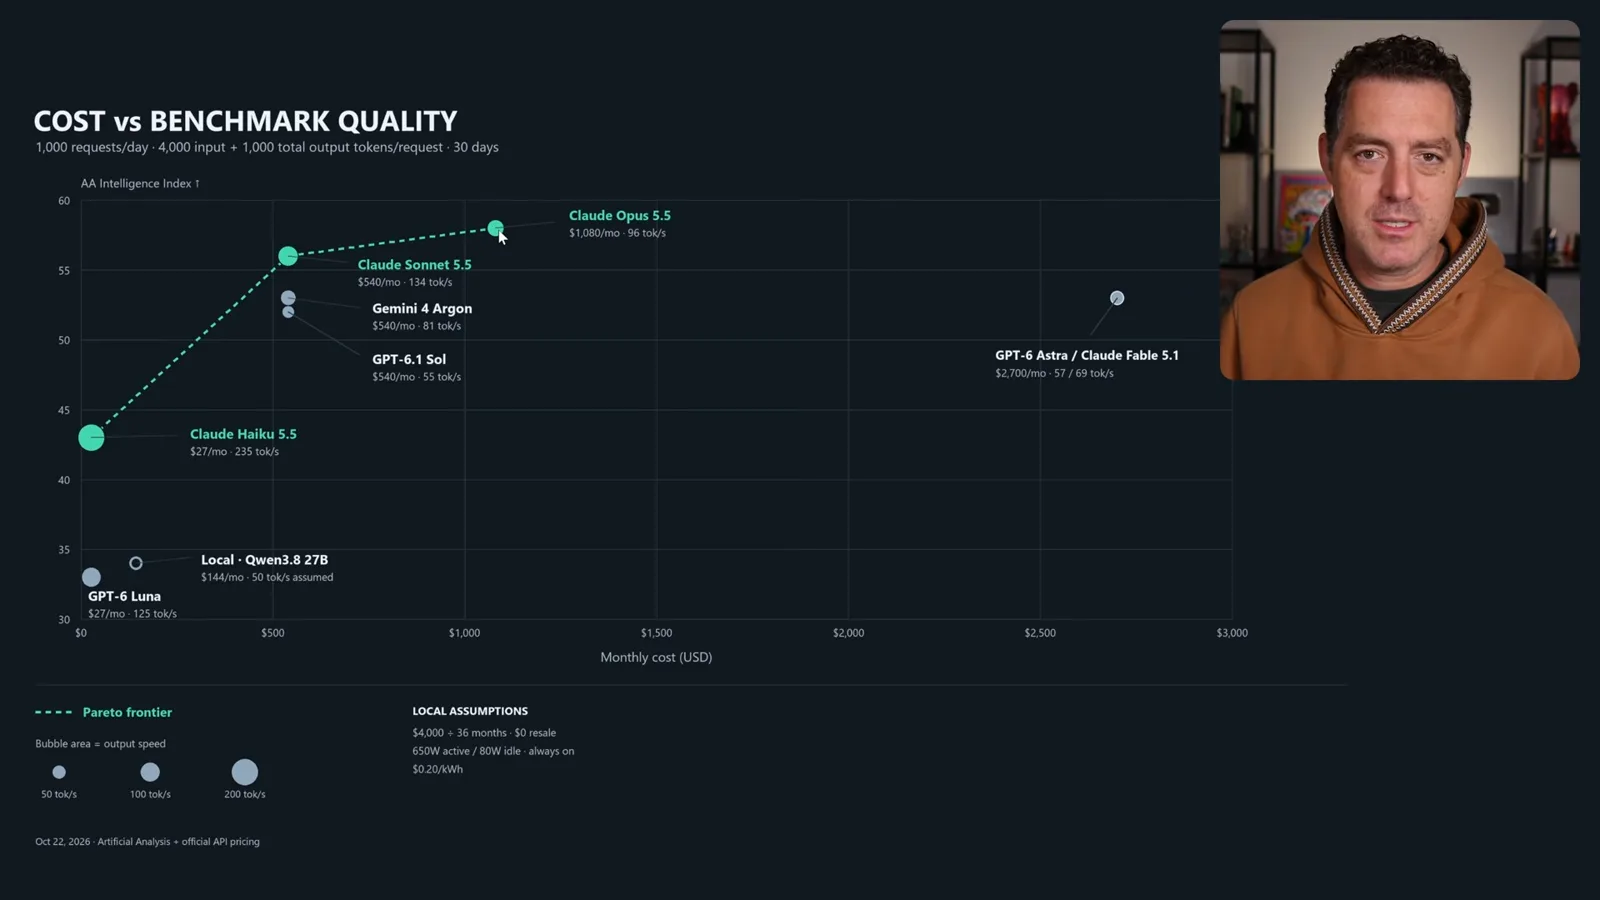
图中本地 Qwen 3.8 27B 的成本为每月 144 美元,速度约每秒 50 个 token,Artificial Analysis 智能指数约为 34。Claude Haiku 5.5 的点位是每月 27 美元、每秒 235 个 token,指数得分更高。这些是图中场景的估算,并非普遍适用的订阅价格。
在我画出的帕累托前沿上,入选的点都是托管的专有模型。除了价格和速度,它们还提供简单的体验:打开应用即可使用,跨设备同步,并持续获得模型更新。即使我曾批评过一些供应商,这些好处也让我很难用本地服务取代它们。
经济账难算的一个原因是大型数据中心对 GPU 和内存的需求。我认为这会限制供应、推高消费级硬件价格,但同一芯片的模型质量和每秒 token 数并没有因此提高。对购买家庭硬件的人来说,性价比就变差了。
我还看到了开放权重实验室的商业模式难题:训练可能花费数十亿美元,但其他供应商可以直接运行公开权重,无须承担最初的训练费用。NVIDIA 已在生态中投入巨资并收购公司,我认为这可能为投资者提供某种保障。我也提到了中国的开放权重模型,认为其资金环境有所不同。
我担心,这两种环境都不一定能为实验室提供强烈动力,让它们发布供人们在家运行的前沿模型。开放权重公司可能需要靠提供推理服务盈利。这是我对激励机制的理解,并不能证明不存在可持续的商业模式。
爱好者与混合模式的未来
他将本地 AI 折腾与超频作比较,并提议在本地和云模型之间无缝路由。
我认为目前本地 AI 尤其适合爱好者。我自己也在运行,并享受设置、调优和实验的过程,但真正工作时仍经常转向托管模型。这让我想到超频:对许多人来说,挖掘性能的过程本身就是乐趣所在。
本地 AI 爱好者可能需要技术知识、可支配收入、维护时间,以及对这个领域的兴趣。作为爱好,这没有问题,但我希望数据控制和减少权力集中等好处,也能惠及不喜欢配置机器的人。
我更看好的未来是混合模式。Microsoft、Apple 和 Google 可以将本地模型整合进操作系统,让普通用户不必考虑究竟运行的是哪个模型。敏感文件或断网场景可以在本地处理,云服务不可用时也能无缝回退。
随着小模型进步、硬件效率提高,更多工作可以转移到设备端。我认为企业使用中也能看到开放模型 token 用量与闭源供应商收入之间的区别。本地路由器可以为每项任务选择合适的执行位置。
环境式助手可以在本地处理适合的工作,把更难的请求发往云端,而不必让用户管理这一决定。许多助手任务并不需要最强模型。我认为这样的混合模式可以让本地 AI 服务更广泛的人群。
智能体仍然面临持久、隔离和安全运行环境的问题。云端智能体拥有自己的全天候环境,这一点很有吸引力。我仍然看好本地 AI,希望它成功,尽管目前它还不适合我完成工作的方式。
同频道的其他文章
 25:50EN → 简体中文
 45:08EN → 简体中文
 0:32EN → 简体中文
 12:14EN → 简体中文
 10:36EN → 简体中文
 17:37EN → 简体中文