30 秒看懂
Apple 在 M5 Pro 和 Max 中复用同一款 CPU 晶粒,分别搭配两种尺寸的 GPU 晶粒;Ultra 则组合了两颗 CPU 和两颗大型 GPU 晶粒。SemiAnalysis 及其 STEEL 实验室发现,这些芯片通过混合键合,利用硅中介层连接并排的晶粒,以直接接触的铜连接点取代焊料凸点。讲述者预计,更小的连接点能提高带宽和能效。Ultra 自身采用何种互连,仍是根据 Max 晶粒和 Apple 公布的密度数据作出的推断:实验室尚未检查过 Ultra。
- 1新晶粒按功能拆分,而非连接两颗完整芯片讲述者将新设计与此前把两颗功能完整的 Max 晶粒连接起来的 Ultra 封装区分开来。
- 2一种 CPU 晶粒可搭配两种尺寸的 GPUM5 Pro 将 CPU 与较小的 GPU 组合,Max 使用较大的 GPU,Ultra 则各连接两颗 CPU 和大型 GPU 晶粒。
- 3小型 GPU 的核心数、缓存和内存宽度减半大型晶粒有 40 个 GPU 核心、48 MB 系统缓存和 512 位接口;小型晶粒分别为 20 个、24 MB 和 256 位。
- 4混合键合无需焊料凸点即可连接相邻晶粒Apple 采用 TSMC 的面对面工艺,通过直接相连的铜接点将小芯片键合到硅中介层。
- 5第二个接口为推测 Ultra 如何连接两组 Max 提供线索实验室尚未拿到 Ultra。它根据 Max 的第二个接口和 Apple 公布的连接密度增幅推断封装方式。
要点建议
- M5 Pro 和 Max 使用相同的 CPU 晶粒,但搭配不同的 GPU 晶粒。
- 与传统焊料微凸点相比,混合键合能在相同面积内容纳更多连接点。
- 讲述者推断 Ultra 也使用混合键合,但实验室尚未检查过这款芯片。
- 小型 GPU 晶粒的核心数、系统缓存和内存接口宽度均为大型晶粒的一半。
按章节阅读整理后的全文
M5 为何改变小芯片的排列方式
讲述者区分了连接完整 Max 芯片与将 CPU 和 GPU 功能分配到不同晶粒这两种方式。Apple 将三种晶粒设计组合成 Pro、Max 和 Ultra。
M5 Pro、Max 和 Ultra 不仅架构相同,还共用硅片。我称其为 Apple 首个真正的小芯片设计:公司以前也在 Ultra 芯片中连接过晶粒,但这一代将不同功能分配到了不同的晶粒上。SemiAnalysis 买来这些芯片,由我们的 STEEL 实验室拆解并检查其封装。
此前的 Ultra 设计将两颗完整的 Max 芯片连接起来。每颗 Max 晶粒本身都能独立工作。我的区分在于,小芯片设计旨在优化各晶粒的面积,以提高良率,并将系统的不同部分放到相互协作的独立晶粒上。
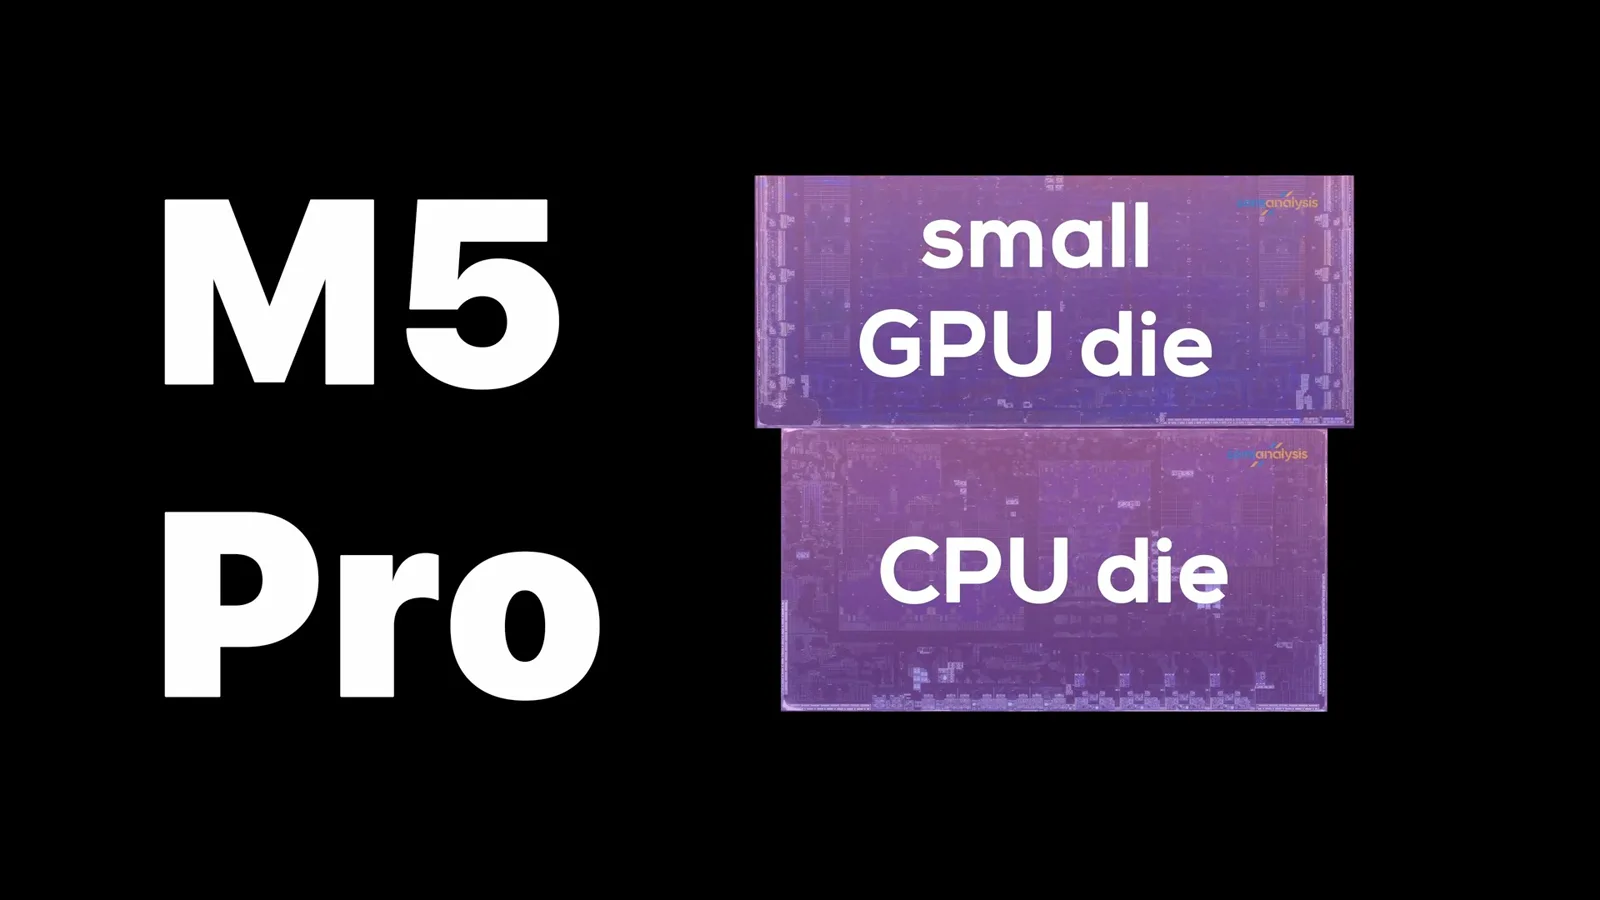
Apple 制作了三种晶粒设计:一种 CPU 和两种尺寸的 GPU。Pro 将 CPU 晶粒与较小的 GPU 搭配,Max 则搭配较大的 GPU。Ultra 组合了两颗 CPU 晶粒和两颗大型 GPU 晶粒。
共用 CPU 晶粒的内部结构
这颗晶粒包含 18 个 CPU 核心及共享缓存,还有神经网络引擎、显示和外部接口。讲述者着重介绍了高速 I/O 占用的面积。
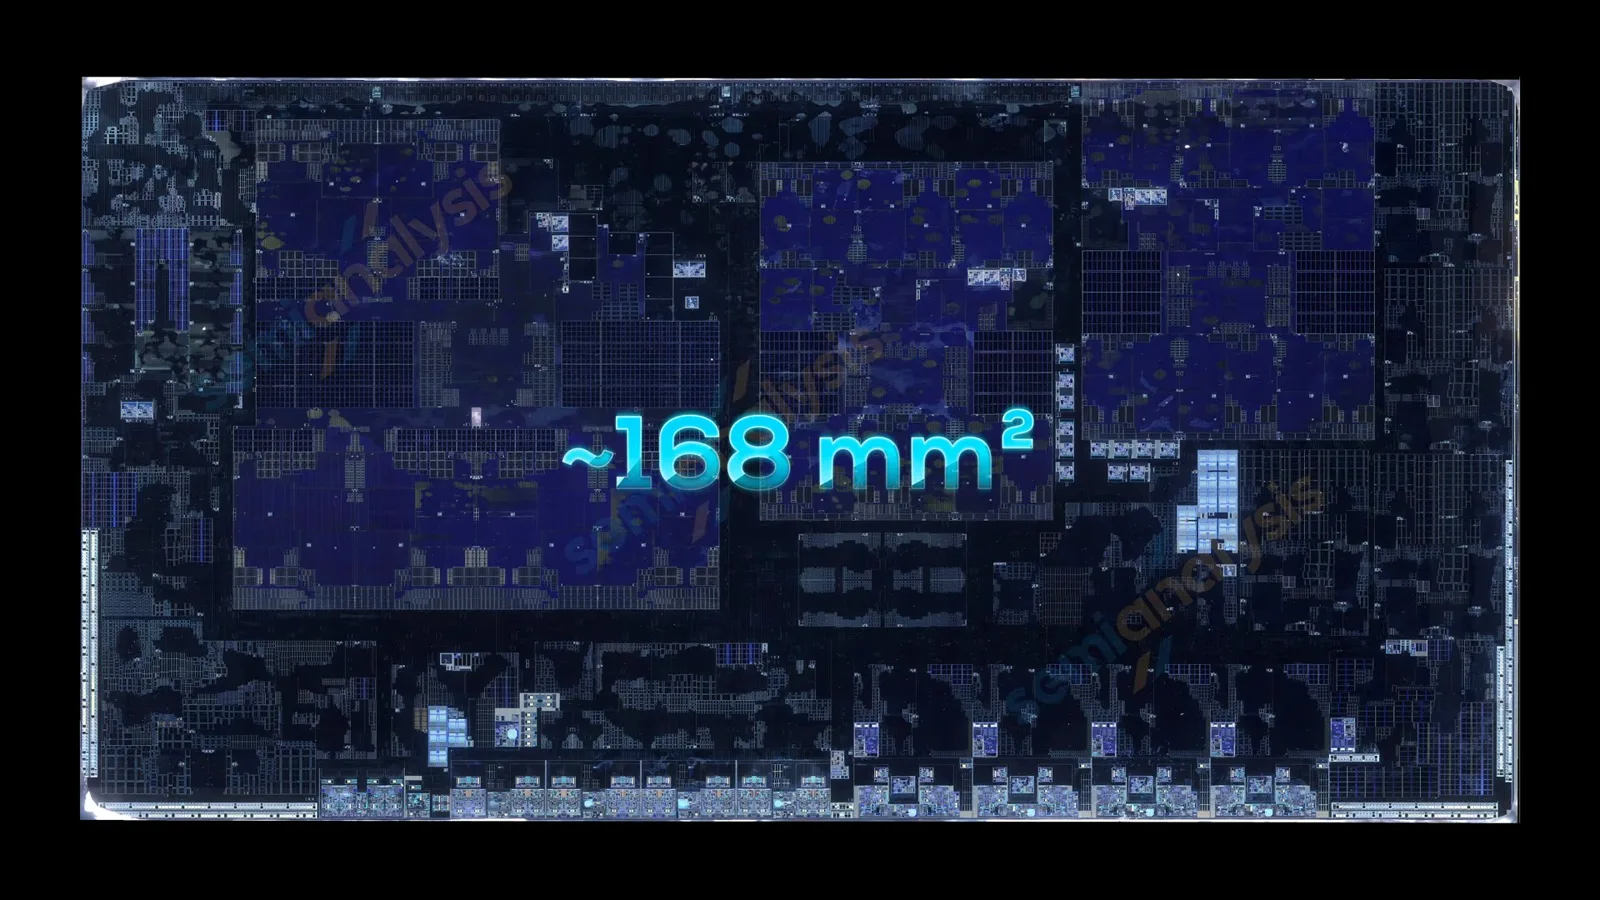
共用的 CPU 晶粒采用 TSMC 的 N3P 工艺制造,面积约为 168 平方毫米。它有 18 个 CPU 核心,分为三个集群:六个 S 核心围绕一个共享的 16 MB 缓存;12 个较新的 P 核心在内部称为 M 核心,分成两个对称的六核心组。
每个 S 核心都有一个专属的 1 MB 二级缓存分片。每个六核心 M 集群有 8 MB 共享缓存,每个集群还有一个专用 AMX 单元。这样的划分或许可以为了电源管理而关闭整个集群;这颗 CPU 晶粒没有 E 核心。
M 核心左侧是一颗 16 核心的 Apple Neural Engine。Ultra 有两颗 CPU 晶粒,因此神经网络处理能力翻倍。晶粒的其他部分还有四个显示引擎和一排输入输出接口。
I/O 包括摄像头和传感器接口、一条四通道显示接口,以及 16 条 PCI Express 通道,后者看来很可能是第 5 代。四个 Thunderbolt 5 物理接口占据了可观的硅片面积,其控制电路也是如此。晶粒中还有 NAND 控制器,以及安全隔区中的 AES 引擎。
沿上边缘有一条细长的条纹结构:这是连接另一颗晶粒的物理层。要理解这种连接为何重要,先来看看两款 GPU 晶粒。
两款 GPU 晶粒同出一脉
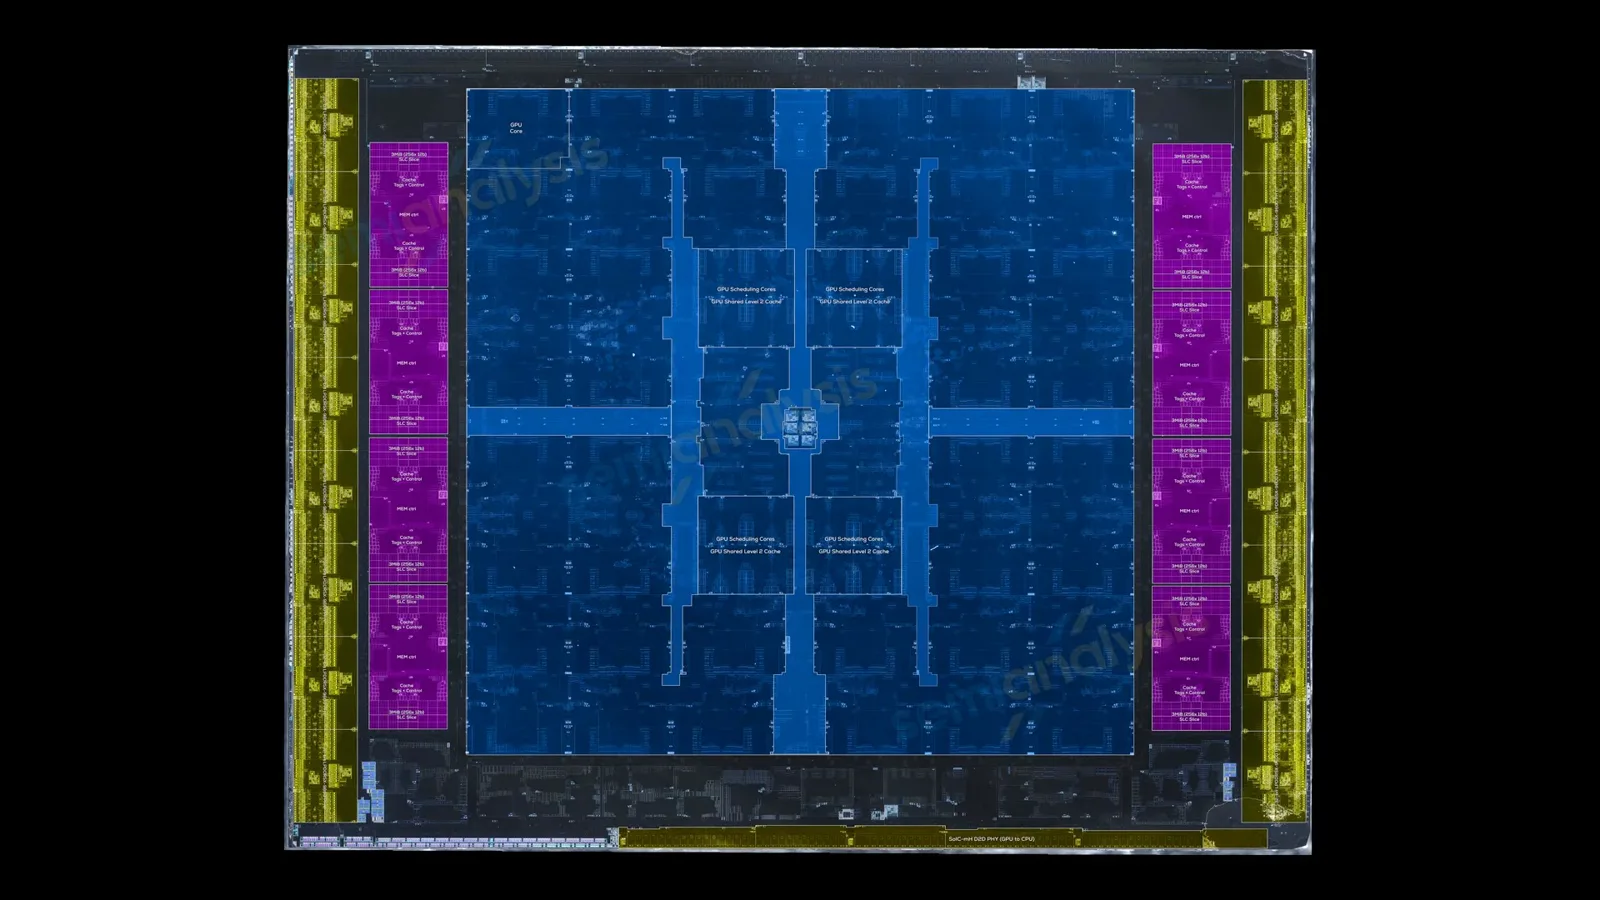
大型 GPU 晶粒的面积约为小型晶粒的两倍,多项资源也是两倍。两者都有与 CPU 连接的匹配接口。
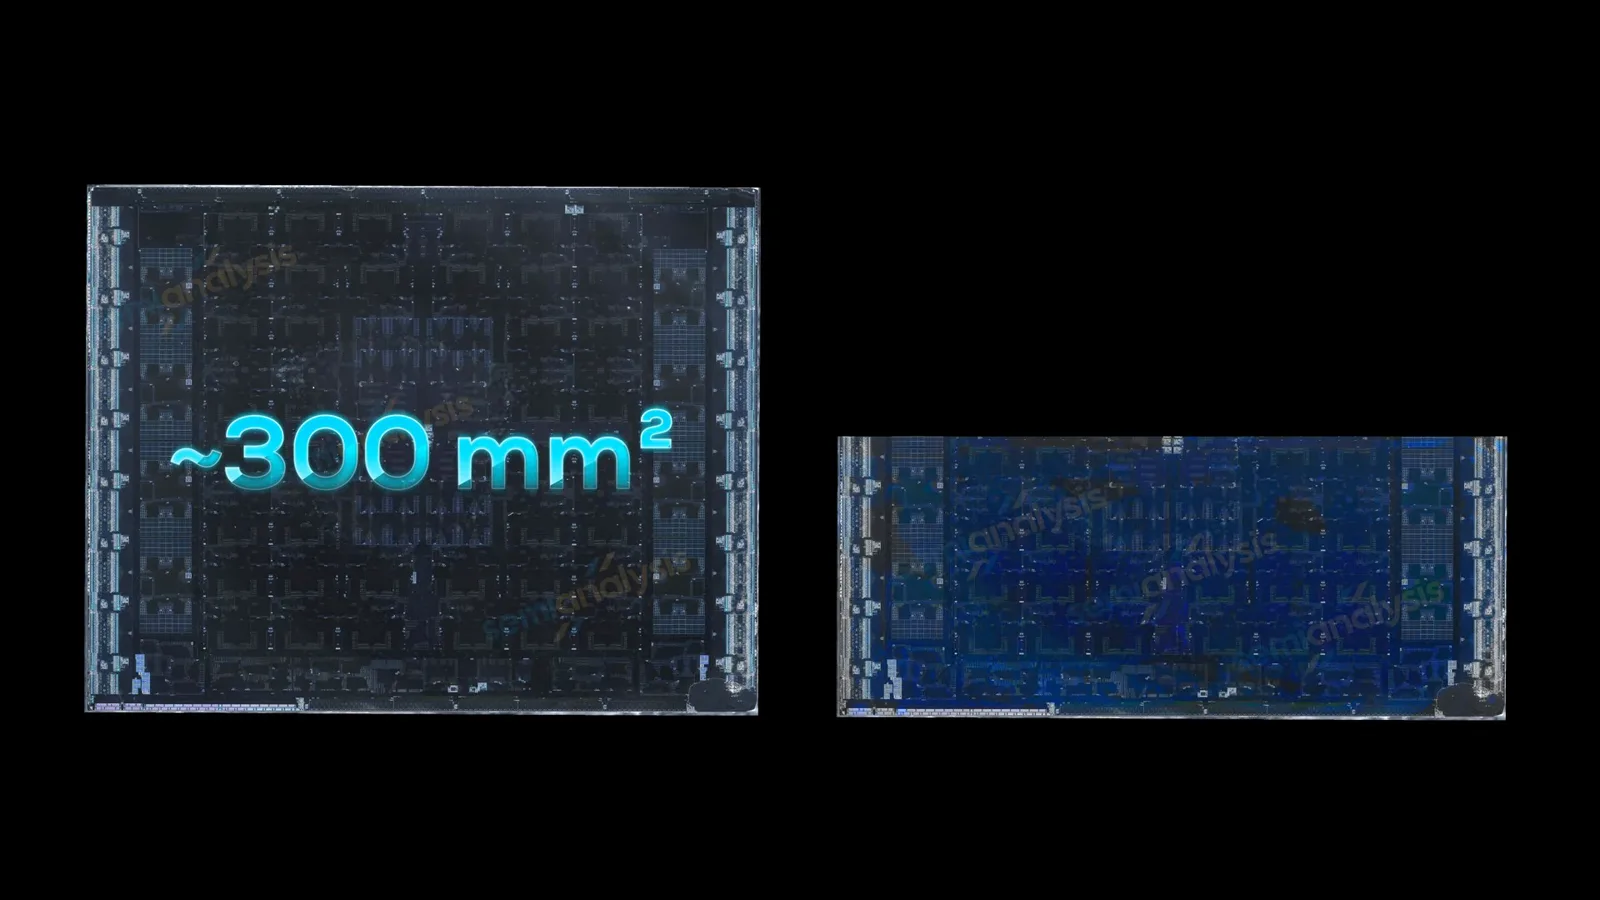
两款 GPU 晶粒都采用 N3P 工艺。大型晶粒面积约为 300 平方毫米,小型约为 157 平方毫米。大型 GPU 有 40 个核心、48 MB 系统级缓存和 512 位内存接口;小型晶粒的这三项均为一半。接口附近的一些媒体加速逻辑保持相同。
按照封装中的排列方式,CPU 和 GPU 晶粒相邻边缘上的物理接口相互匹配。Apple 使用 TSMC 的 SoIC-mH 来连接它们,TSMC 也将这种工艺称为 SoIC-X 面对面键合。
混合键合通过中介层连接晶粒
TSMC 的面对面工艺将晶粒并排放置。直接连接的铜接点可以比焊料凸点更精细,从而提高连接密度。
混合键合曾用于将缓存晶粒堆叠在计算晶粒上。这里的小芯片则并排放置,并键合到经过特殊处理的硅中介层上。“mH”这个名字指的是将它们水平模封。
传统的中介层连接使用微凸点,即成品晶粒与中介层之间的微小焊料接点。接点尺寸限制了连接的密度,晶粒间传输的数据也必须经过这些接点。
混合键合则将晶粒和中介层上露出的铜接点对齐,接点周围是绝缘材料。加热使铜膨胀并直接结合。讲述者说,焊料微凸点的间距约为 25 微米,未来可能降到 18 微米;混合键合则可以低于 10 微米,在先进工艺中接近 3 微米。
更密集的连接有望实现高带宽、低延迟和更节能的数据传输。讲述者认为,将晶粒并排放置而非堆叠,也能避免堆叠带来的散热问题。
推断 Ultra 的更大连接接口
实验室尚未检查 Ultra,但大型 GPU 晶粒上有第二个接口。Apple 公布的密度数据使讲述者推断该接口也使用混合键合。
实验室尚未拿到 M5 Ultra。不过,Max 的大型 GPU 晶粒上,在 CPU 连接接口的对面还有一个更大的第二接口。其相似的结构表明,这可能是另一条混合键合连接。
Apple 表示,UltraFusion 将两个双晶粒 Max 组件连接起来,连接密度提高了六倍以上。此前的 M3 Ultra 使用局部硅互连,其焊料微凸点实测间距约为 25 微米。讲述者计算后认为,新密度意味着间距约为 10 微米或更小,并由此推断它采用了混合键合。
讲述者认为,并排布局符合 Apple 对散热的重视,并猜测 Apple 可能与 TSMC 共同完成了这一实现。根据这项分析,直接铜接点和更高的密度减少了数据传输所需的能量,并提高了潜在带宽。
同频道的其他文章
 51:27EN → 简体中文
 SemiAnalysis· 2026年11月13日播客 · 3 人对谈NVIDIA 更换 CEO:对华芯片政策与执行能力成为焦点嘉宾 Jordan Schneider · 主持 Jordan Nanos, Dylan Patel嘉宾讨论芯片制造管制、云端访问,以及黄仁勋离任后 NVIDIA 能否保持执行优势。
 42:39EN → 简体中文SemiAnalysis· 2026年11月4日播客 · 4 人对谈美国中期选举可能如何改变 2028 年数据中心建设嘉宾 Maya Barkin, Wayne Ma, Jeremie Eliahou Ontiveros · 主持 Jordan NanosSemiAnalysis 分析许可、电网成本和地方反对声音如何影响美国数据中心项目。
 51:52EN → 简体中文SemiAnalysis· 2026年11月3日播客 · 3 人对谈GDPx 如何测试前沿 AI:SemiAnalysis 新基准的设计过程嘉宾 Max Kan, Andrew Megalaa · 主持 Jordan NanosGDPx 团队解释任务质量、领域选择、评分,以及公开审查与保密评估之间的取舍。
 55:06EN → 简体中文SemiAnalysis· 2026年10月27日播客 · 4 人对谈Anthropic 的 S-1:收入、算力成本与规模竞赛SemiAnalysis 嘉宾解读 Anthropic 的申报文件,讨论算力经济性、客户集中度与竞争。
 34:35EN → 简体中文SemiAnalysis· 2026年10月23日播客 · 3 人对谈SemiAnalysis 谈 ASML 的 hybrid bonding 专利、HBM 经济账和下一代设备生态嘉宾 Sherry Zhang, Howie · 主持 Jordan NanosJordan Nanos、Sherry Zhang 和 Howie 审视一种轨道式键合设计:把晶圆送到芯片处,并说明这项技术能否落地,取决于精度、洁净度、经济账,以及一条正在变化的供应链。
 34:47EN → 简体中文SemiAnalysis· 2026年10月20日播客 · 3 人对谈SemiAnalysis 为何上调 2027 年数据中心预测嘉宾 Jeremie Ontiveros, Reyk Knuhtsen · 主持 Jordan NanosJeremie Ontiveros 和 Reyk Knuhtsen 解释他们的项目级模型、建设风险,以及未来可能出现的供需失衡。