30 秒看懂
Jordan Nanos 采访 Max Kan 和 Andrew Megalaa,讨论与专业合作伙伴共同构建、覆盖 11 个领域的 GDPx 基准。他们介绍公平性、金融交易资料室任务、安全拒答、评分选择,以及用基准分数预测就业的局限。
- 1困难与不公平如果评分器只接受多个有效解法中的一种,就可能错误地把成功判为失败。
- 2专业合作伙伴团队表示,它使用专业供应商的任务,并剔除了未通过质量检查的任务或合作伙伴。
- 3真实交易资料室金融任务取自包含数千个文件及特定时间上下文的交易环境。
- 4评分选择二元分数反映是否完成,部分得分展示各组成部分的进展。
- 5公开与保密任务公开有助于审查;保留部分任务有助于减少直接针对基准调优。
要点建议
- 如果评分器拒绝有效解法,困难的任务仍可能不公平。
- GDPx 针对选定的高价值前沿领域,而非所有工作的代表性样本。
- 二元分数和部分得分回答不同问题,应结合解读。
- 安全限制和模型配置会影响观测结果。
- 保密任务减少针对基准调优的机会,但也限制独立审查。
按章节阅读整理后的全文
GDPx 的发布与定义
团队介绍发布过程,并解释为什么公平性与难度不同。
Jordan Nanos 与 Max Kan、Andrew Megalaa 讨论 SemiAnalysis 的前沿 AI 基准 GDPx 的发布。团队说,在任务临时修订和漫长的模型运行之后,他们直到发布前几小时才看到最终排行榜。
合作伙伴使用少量模型校准难度,基础设施团队则运行更大规模的评估。嘉宾说,一项任务及其评分可能需要一天,发布期限也部分受到预期的新模型发布影响。
团队的出发点是对热门基准的不满。嘉宾认为,一些任务看似困难,是因为它们不公平或规定不清;识别这些问题需要检查运行过程并判断模型为何失败。
他们用编程例子区分困难与不公平:如果两种方法都能修复错误,但验证器只接受其中一种,另一种正确方案就会被误判为失败。问题在于提示词与评分器不匹配,并不一定是模型能力不足。
嘉宾说,评估可能包含许多此类问题,重复运行并审阅记录很费力。他们对具体基准的批评是自己的判断,本次对话并未独立验证所述缺陷比例。
合作伙伴与领域
基准使用专业任务,覆盖 11 个选定的高价值领域。
SemiAnalysis 希望有一种可重复比较新模型的方法,但没有假定自己能独立编写数百个高质量任务。团队与 14 家专业数据供应商合作,审查其提交内容,并在质量检查中淘汰了一些候选供应商。
基准聚焦团队认为能够吸收昂贵前沿智能并产生高回报的领域。他们同意许多日常任务不需要最强模型,但预计芯片设计、生物学和网络安全等领域仍会需要更强能力。
Nanos 列出 11 个领域:递归自我改进、芯片设计、网络安全、生物学、金融、法律、量化交易、硬件设计、材料科学、对齐和软件工程。
团队说,领域选择经过内部讨论和与实验室人员交流,同时考虑经济相关性与可验证性。他们征集样例任务并检查质量;在选择合作伙伴时也会判断任务是否具有代表性。
一些合作伙伴是成熟的数据公司,另一些则是独立专家。嘉宾特别提到基于研究人员自身工作的材料科学任务,以此说明专业知识如何塑造评估。
专家、模型行为与结果
嘉宾讨论出人意料的结果、人类基线及安全拒答的影响。
据介绍,一位材料科学贡献者发现,模型获得正确上下文后,解决了他起初认为过难的问题。团队说,这位贡献者随后不得不设计更难的一组任务。
Megalaa 描述自己随着编程模型进步而改变的预期。他说自己从亲自编写大部分代码转向更高层工作,但仍认为人的判断可以改善模型独立工作的结果。
嘉宾认为其他技术领域可能出现类似时刻,但单个结果不能证明模型总体上优于专家。他们讨论一个据称超过已发表参考结果的材料科学子任务,以及如何定义可比的人类基线的困难。
Nanos 展示材料科学评估所报告的每任务成本。嘉宾说,模型的解法可能富有创造性或出人意料,因此认真验证很重要:陌生的方法可能正确,也可能失败。
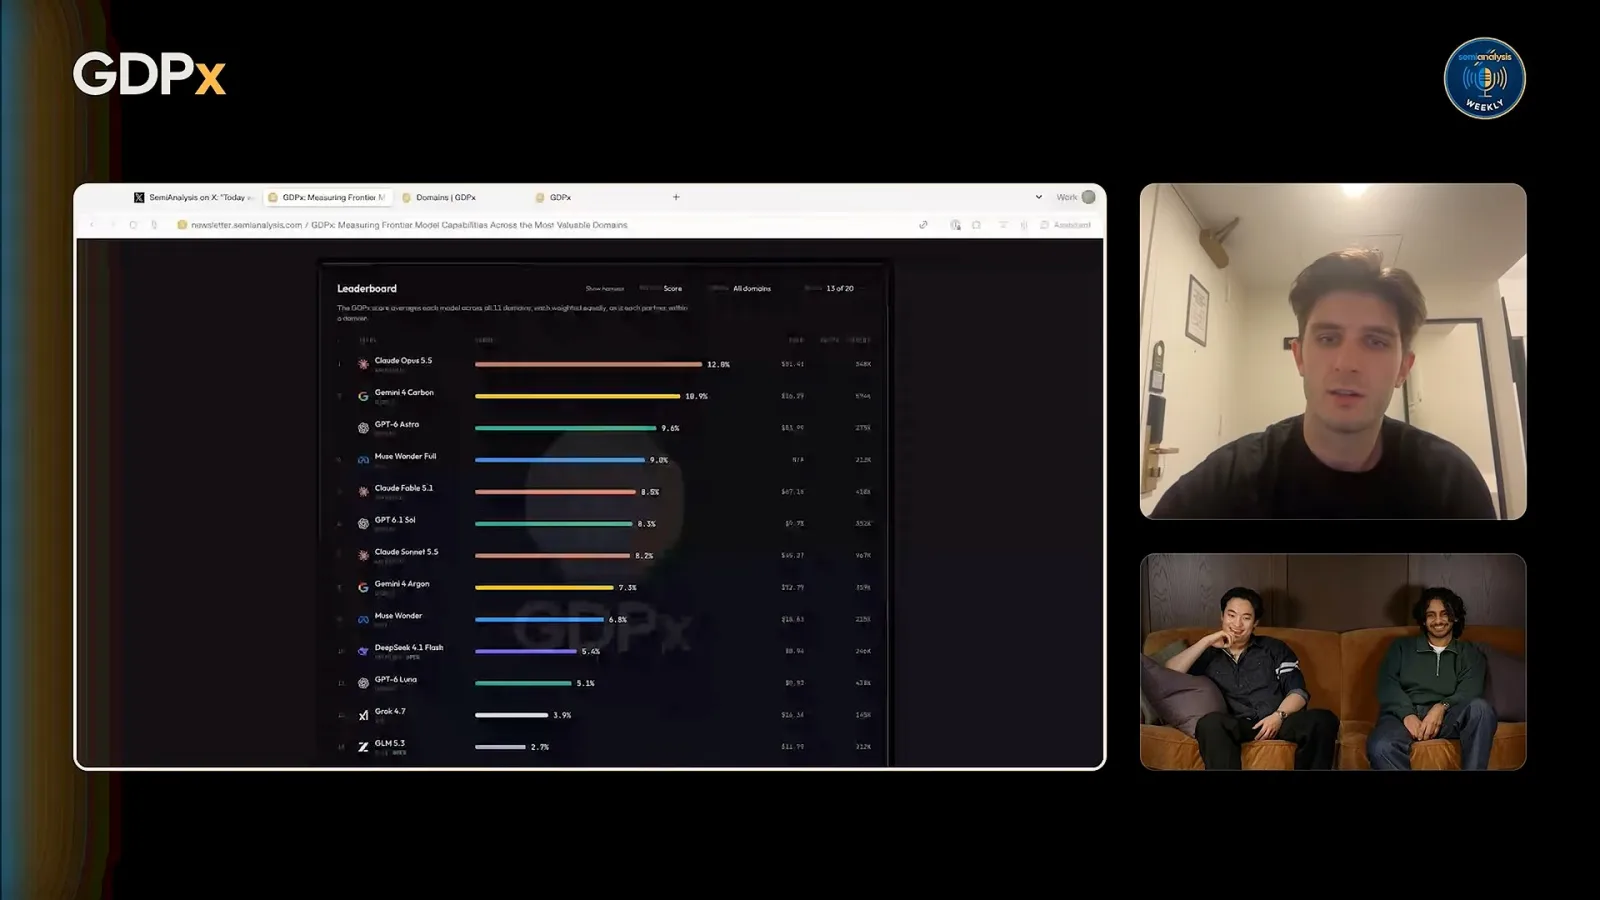
讨论转向排行榜。团队同时提供总体视图,以及排除生物学、网络安全和对齐的过滤视图,因为安全分类器可能阻止一些模型尝试这些领域的任务。
他们说,拒答会影响观测分数,即便底层模型可能具备相关能力。团队选择突出包含所有领域的视图,同时认为过滤功能有助于用户结合自己的情境解读结果。
几位嘉宾讨论网络安全结果以及模型和安全设置的访问差异。他们认为实际可获得的访问权限可能显著影响表现;结果应结合实际测试配置阅读。
金融与评分
交易资料室示例说明真实上下文以及二元评分和部分评分的区别。
GDPx 有意围绕困难的前沿工作设计,而非代表日常工作的样本。团队的经济判断是:即使便宜系统能处理许多常规任务,高价值领域仍可能愿意为更强能力付费。
嘉宾说,金融和法律结果令他们意外。一些候选任务不真实或不公平,因此被淘汰;金融专业人士帮助判断保留下来的例子是否类似真实工作。
一家金融合作伙伴基于真实私募股权交易构建了环境,交易涉及一家家族经营的零食企业。团队描述了约 4000 份交易资料室文件,以及来自相关参与方工作的真实任务。
环境可以重现某项工作被分配时资料室的状态。在一种失败案例中,模型漏掉了一封更改相关数字的邮件,因而生成了错误的交付物。
Nanos 问起评分。对于金融任务,基准将详细的组成部分检查与最终二元分数结合:一个包含大量错误数字的工作簿可能不能作为完成的专业交付物使用。
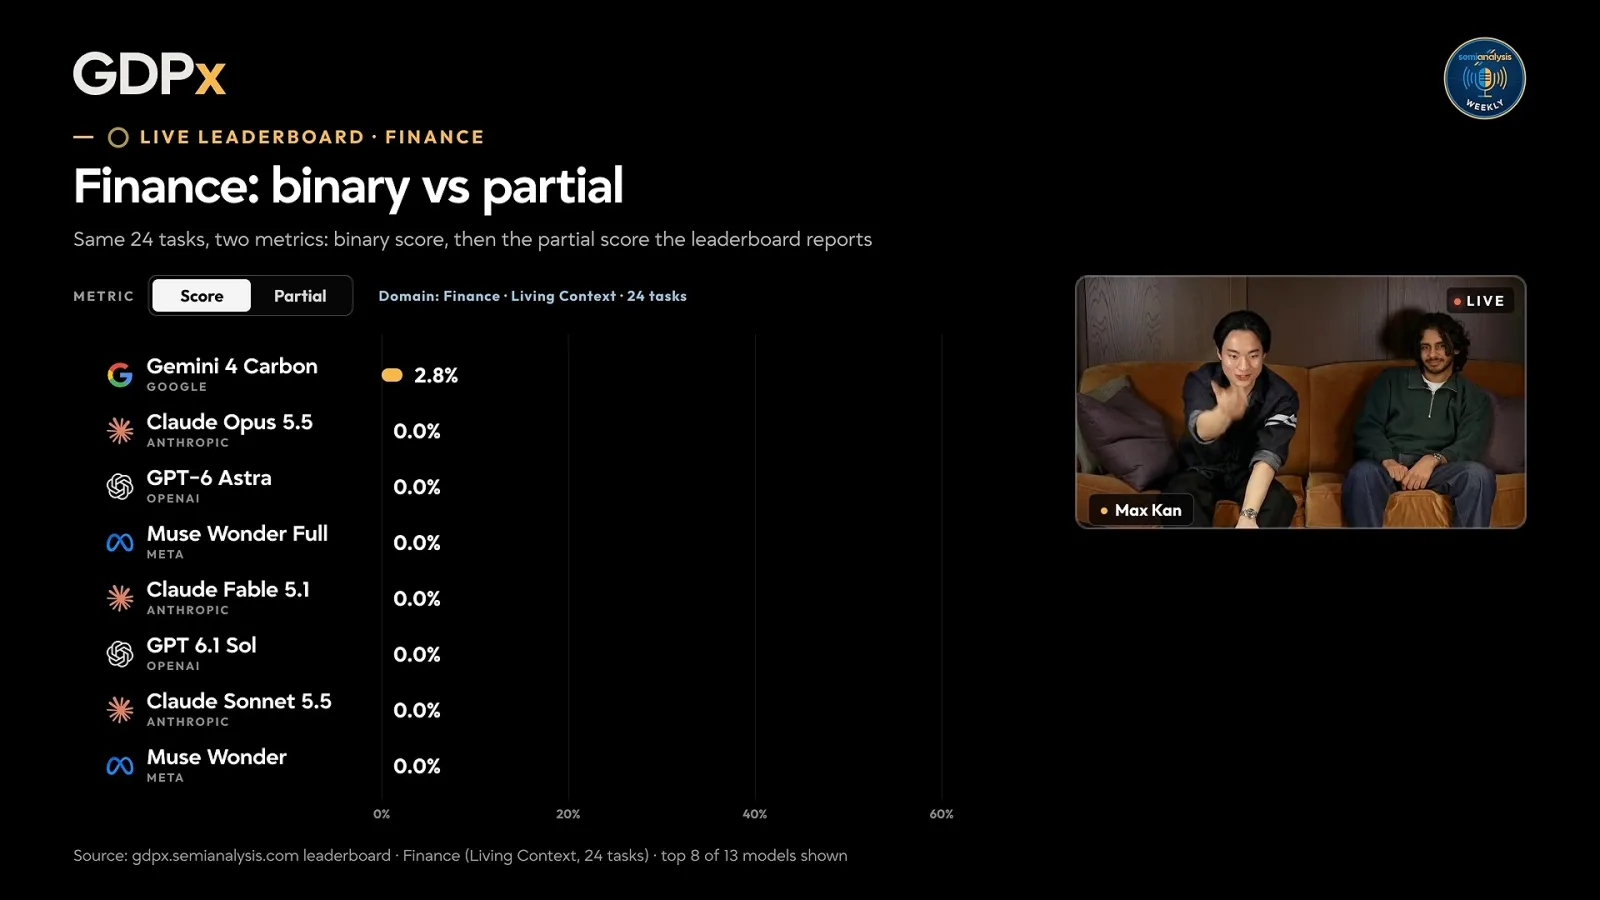
同一组金融任务也可以显示部分得分,从而揭示二元评分中的零分所掩盖的进展。嘉宾说,部分分和二元分差距很大,也可能暴露最终要求不公平或过于狭窄的任务。
其他领域在更适合时采用连续评分。团队以芯片设计优化为例:结果可以根据其在基线与目标之间的改善程度获得相应分数。
嘉宾认为,金融和法律业务的利润结构以及竞争情境,仍可能支持为更强模型付费。这是对需求的预测,并非基准分数本身直接得出的结论。
就业与模型比较
嘉宾讨论不确定的就业影响及模型排名的局限。
被问到 GDPx 对就业意味着什么时,团队强调它没有覆盖许多人担忧的客服等职业。因此,它不能单独预测整个经济中的失业情况。
嘉宾讨论了人的判断与模型能力互补的一段可能时期。他们也考虑了未来团队规模可能大幅缩小的情形,但表示任何就业替代的规模和时间仍不确定。
他们担心初级员工和实习生可能失去一些以往提供经验的、定义明确的任务。他们也提出另一种可能:人们利用智能体尝试更有雄心的项目,而不是简单重复过去的工作。
嘉宾对人们会多广泛地接受这一转变意见不同。一位对人们利用工具提升目标感到乐观,另一位认为许多工作者主要希望完成工作后回家。双方都承认结果尚未确定。
回到排行榜,Megalaa 说他对某个模型的使用体验大致与表现相符,而另一个模型在部分材料和工程任务上尤其强。嘉宾强调,不同模型各有长处。
他们讨论 Gemini 4 Carbon,并对哪种过滤比较最有用展开讨论。他们对实验室的排名包括对未发布系统的判断和推测;基准实际只衡量被评估的版本和设置。
公开程度与下一步
团队解释公开与保密的取舍,以及未来版本计划。
Nanos 问为什么团队每个合作伙伴只公开一项任务及一次运行记录,而将其他任务保密。更多公开有助于外部专家审查质量,但公开任务也更容易成为模型训练或调优的目标。
团队希望通过样例、详细方法和质量检查说明提供一定透明度,同时不暴露所有任务。保密任务减少了基准污染的一条路径,但也限制独立审查。
对于未来版本,团队计划评估新模型、增加合作伙伴和任务,并随着模型能力变化重新审视领域。团队也希望测试更多推理设置,并保持仪表板更新。
嘉宾将 GDPx 描述为首个迭代版本,并邀请更多人参与评估与维护。Nanos 最后感谢团队解释其方法和初步结果。
同频道的其他文章
 55:06EN → 简体中文
 SemiAnalysis· 2026年10月27日播客 · 4 人对谈Anthropic 的 S-1:收入、算力成本与规模竞赛SemiAnalysis 嘉宾解读 Anthropic 的申报文件,讨论算力经济性、客户集中度与竞争。
 34:35EN → 简体中文SemiAnalysis· 2026年10月23日播客 · 3 人对谈SemiAnalysis 谈 ASML 的 hybrid bonding 专利、HBM 经济账和下一代设备生态嘉宾 Sherry Zhang, Howie · 主持 Jordan NanosJordan Nanos、Sherry Zhang 和 Howie 审视一种轨道式键合设计:把晶圆送到芯片处,并说明这项技术能否落地,取决于精度、洁净度、经济账,以及一条正在变化的供应链。
 34:47EN → 简体中文SemiAnalysis· 2026年10月20日播客 · 3 人对谈SemiAnalysis 为何上调 2027 年数据中心预测嘉宾 Jeremie Ontiveros, Reyk Knuhtsen · 主持 Jordan NanosJeremie Ontiveros 和 Reyk Knuhtsen 解释他们的项目级模型、建设风险,以及未来可能出现的供需失衡。
 44:12EN → 简体中文SemiAnalysis· 2026年10月14日播客 · 3 人对谈GLM 5.3、稀疏注意力与推理成本嘉宾 Kimbo Chen, Wenyao Gao · 主持 Jordan NanosSemiAnalysis 讨论内存瓶颈、AMD 和 NVIDIA 的推理结果、后训练以及对中国芯片的支持。
 1:23:18EN → 简体中文SemiAnalysis· 2026年10月9日播客 · 2 人对谈谁来为 AI 基础设施建设融资?嘉宾 Daniel Nishball · 主持 Jordan NanosSemiAnalysis 分析预计的资金需求、GPU 租赁经济性,以及支持数据中心融资的担保。
 50:13EN → 简体中文SemiAnalysis· 2026年10月7日播客 · 3 人对谈SemiAnalysis 如何比较 AI 订阅额度嘉宾 Max Kan, Andrew Megalaa · 主持 Jordan Nanos从 token 计费、缓存密集型工作负载出发,理解按 API 价格折算订阅价值所依赖的假设。