30 秒看懂
Gemini 4 Neon 解决了开发者 Theo 项目中的实际问题,改变了他对 Google AI 模型的看法。他说,在一个 Rust 工具项目中,其他模型难以兼顾体积和速度,而 Neon 将二进制文件从 47.44 MB 缩减至 7.97 MB,同时改善了性能。它还诊断了一台运行缓慢的电脑,并绕过了仪表盘显示故障。Theo 看重它清晰汇报进度和持续专注任务的能力,不过它在一项架构基准测试和 3D 演示中的表现并不一致。
- 1Neon 找到持续拖慢磁盘速度的一项配置Theo 用这个问题测试模型已有数周。Neon 找到一项格式化配置,解释了他几台机器之间的大部分速度差异,并清楚地呈现了推理过程。
- 2消失的仪表盘源于集成故障,工作其实已完成Neon 发现仪表盘已经渲染,只是被适配器隐藏。它用截图作为临时解决办法,并在收到请求后提交修复。
- 3僵持一周后,项目同时变小又变快Theo 说,Astra 将二进制文件缩小了 46%,但速度也慢了 56%。面对同一个目标,Neon 报告称它把文件从 47.44 MB 缩小到 7.97 MB,同时提高了速度。
- 4交互式计划让复杂设计更容易审查Neon 按照详细要求,用 HTML 页面说明 Lakebed 的源码恢复方案,包括工作流程和设计取舍。
- 5代码审查和架构说明得到不同结果Theo 指出,在一项架构评估中,72 条陈述有 10 条错误;在代码审查测试中,Neon 则给出了 21 个有效发现和 5 个看似合理的发现。
要点建议
- 用有明确衡量目标的真实棘手项目测试智能体,不要只凭一项基准测试判断。
- Theo 说,Neon 将他的 TS-Rust 二进制文件从 47.44 MB 缩减至 7.97 MB,同时让完整测试套件运行时间减少 48.6%。
- 模型能解释自己的工作并持续专注任务,会让长期开发任务更容易审查。
- 区分代码库说明和代码审查:Theo 在两种评估中看到了不同的优势。
- 智能体看似停止工作时,检查周边工具的集成;Theo 遇到的显示故障隐藏了已经完成的仪表盘。
按章节阅读整理后的全文
Theo 为什么改变了对 Gemini 的看法
Theo 曾批评早期 Gemini 模型,而 Neon 在实际开发任务中的表现让他感到意外。他披露了自己的经济关联,并说明比较模型时考虑的价格和背景。
我原以为这又是一次 Gemini 的小幅更新,但 Gemini 4 Neon 改变了我的看法。Google 的这个中型模型在我的开发工作中比预期更有用,有时还解决了让其他模型陷入僵局的问题。我在真实项目中对它做了大量测试,而不只是试用发布时的示例。
说出我的看法之前,先披露一下:Google 通过 YouTube 广告向我付费,我也有与 X 相关的收入。我以前对 Gemini 的批评很严厉,所以想展示让我改变看法的实际工作。我已经大量使用 Neon,却很难找到它的极限。
Google 将 Neon 定位为一个较小的模型,基准测试成绩出色,并能以较低价格完成大量工作。Theo 提到,其输入价格为每百万 token 3 美元,输出为每百万 token 15 美元,缓存输入的价格更低。按他的比较,这明显便宜于 Opus。
早期 Gemini 模型的分数虽然亮眼,我仍持怀疑态度:我发现它们会偏离思路、犯基本错误,合作体验也不好。在我的使用中,Neon 给人的感觉不同。它能跟随任务、清晰汇报进展,长时间工作也不会出现同样程度的偏离。
到目前为止,我试过编程、调查以及一些操作电脑的任务。我还发现,它对可能造成破坏的操作相当谨慎。对我来说,重要的不只是回答听起来舒服,而是模型能否保留足够的上下文,做出有用的决定并解释清楚。
诊断电脑变慢的原因,让工作过程更易读
Neon 找到了一项持续拖慢磁盘速度的配置。Theo 看重它清晰的汇报,因为这让长期运行的智能体任务更容易检查。
其中一项测试涉及一台电脑:它的磁盘操作不知为何一直很慢。我用同一个问题测试模型已有数周。Neon 检查了系统,找出一项格式化配置,解释了不同机器之间很大一部分速度差异。它给了我具体的调查方向,而不是又一份泛泛的速度诊断。
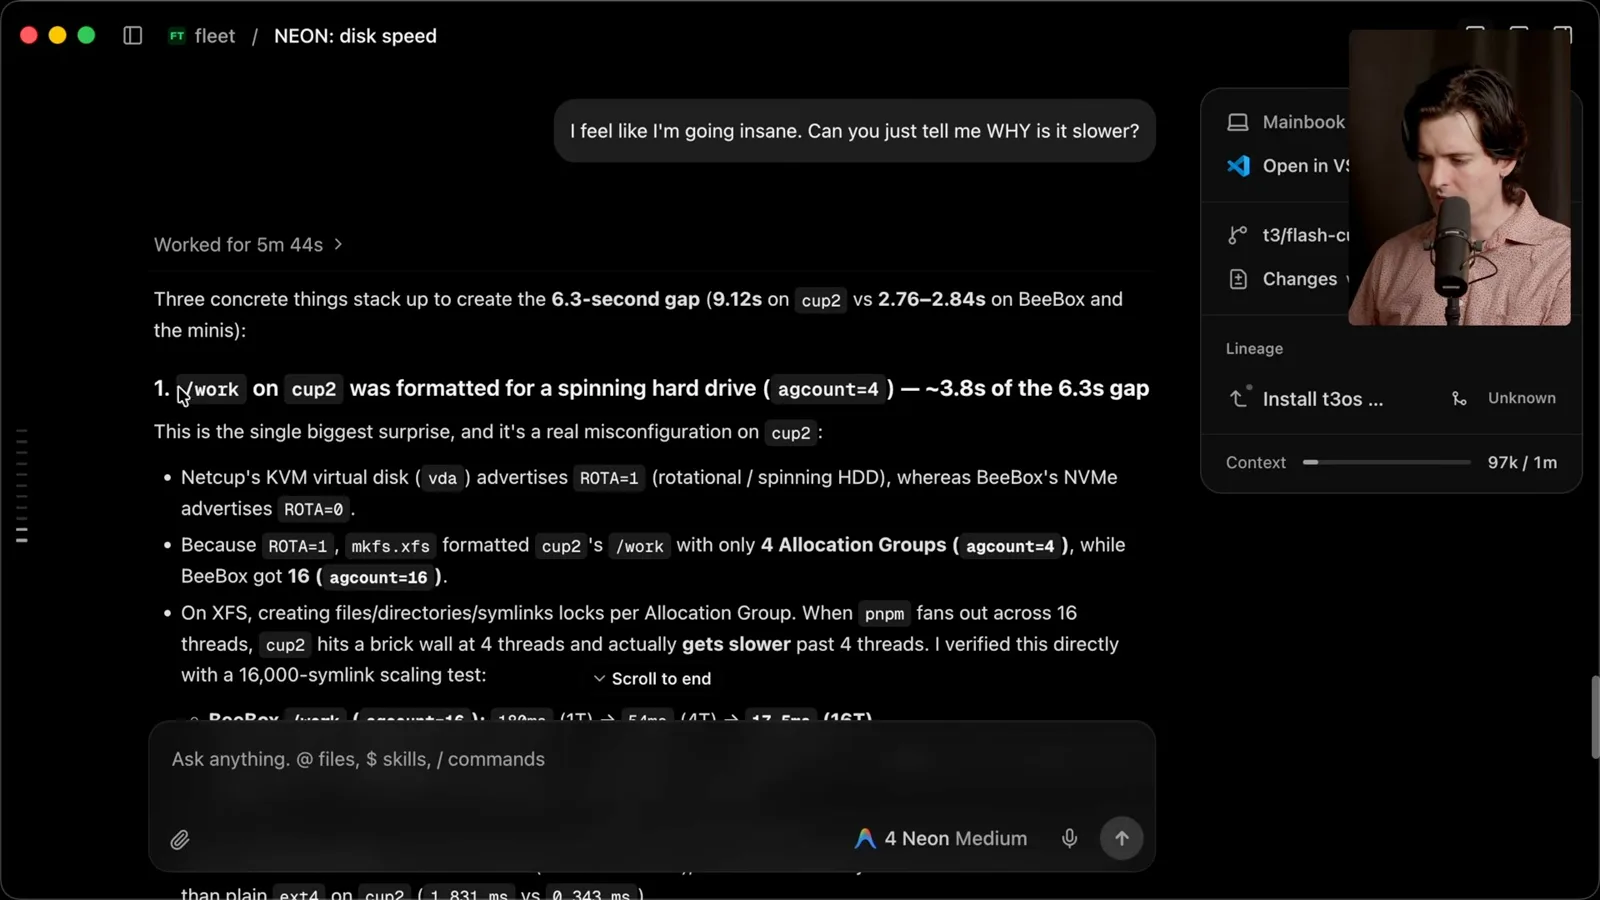
它的回答也很容易读:不同原因分开列出,各自造成的影响有量化,下一步该做什么也很清楚。智能体独立工作很长时间时,这种表达方式很重要,因为我回来后需要弄明白它做了什么、哪些事情需要我关注。
我还用 Neon 完成另一项实际工作:停用一台准备送给朋友的机器。它找到了相关笔记,指出还有哪些工作没有完成。回答足够具体、条理也很清楚,我不必从一堆智能体输出里费劲寻找信息。
从源码恢复方案到消失的仪表盘
Neon 帮忙规划 Lakebed 的源码恢复功能,并配置了另一台开发机。仪表盘看似消失时,它诊断了适配器并给出临时解决办法。
我的 Lakebed 项目提供构建小型共享应用的服务。我想加入源码恢复功能,这样就不用记住项目存在哪台电脑上。我让 Neon 审查一份此前和其他模型一起制定的计划。Astra 赞同 Neon 提出的设计,于是我把这项工作转交给了 Neon。
接着,我让 Neon 在一台用于开发的 Windows 电脑上配置 Gemini 和 Antigravity 适配器。它工作时,我又补充了一条指令:配置完成后通知某个正在进行的对话线程。它配置好机器,在 T3 Code 中确认可用,找到线程并发送了消息。
另一项任务一开始看起来失败了。我要求它将 T3 Code 代码库中的拉取请求和问题做成交互式可视化。智能体似乎两次停了下来,我便让它继续。它调查后发现,仪表盘其实已经渲染,只是适配器出了问题,导致输出没有显示在聊天中。
Neon 自己渲染了 HTML,截取屏幕并展示截图,以此绕过显示问题。它解释了输出丢失的位置;在我的要求下,它还发起了一个拉取请求,修复底层工具的问题。它既完成了原始任务,又追查了故障原因,这让我印象深刻。
我确实遇到了一个较小的问题:一条原本要调用我的 full-stop 和 council 技能的请求,被当成普通文本处理。我不知道原因在模型、Antigravity 集成还是其他地方。除了成功的例子,这一点也值得一提。
连贯性与 TS-Rust 优化测试
Theo 所说的连贯性,是指输出易于理解并持续专注任务。他比较了不同模型在缩小工具包体积、同时提高速度这一难题上的表现。
用 Neon 在 T3 Code 中完成实际代码更改后,我把它加入了开发工作中会咨询的模型组合。我认为它是能够与 Opus 竞争的模型。与以前的 Gemini 相比,变化大到让我开玩笑说 Google 本可以把它叫作 Gemini 5。
我反复提到的区别是连贯性。我的意思是,模型的输出易读,能理解请求、专注任务,也能和我或其他智能体协作。这不只是聊天体验是否愉快的问题:它会影响一个长期任务能否沿着正确方向推进,最终交付我能用的成果。
根据我的经验,Neon 的连贯性很强,也能解决困难的编程问题。举个例子,我有一个叫 TS-Rust 的项目,用 Rust 重写了与 TypeScript 有关的工具。我希望大幅缩小工具包,同时让类型检查速度超过竞争工具。
我给 Astra 设定了一个直接的目标,让它工作了七天多。它将工具包缩小了 46%,但也让速度慢了 56%。我把重点转向速度后,它又撤销了体积方面的成果;我停止它的工作后,Opus 花了几天时间让项目稍微快了一些。
接着我给了 Neon 同一个总体目标。大约十小时后,它报告称二进制文件从 47.44 MB 降到了 7.97 MB,缩小约 5.95 倍,热启动结果也快了很多。我没有想到一个中型模型能在这个项目上如此迅速地取得这样的进展。
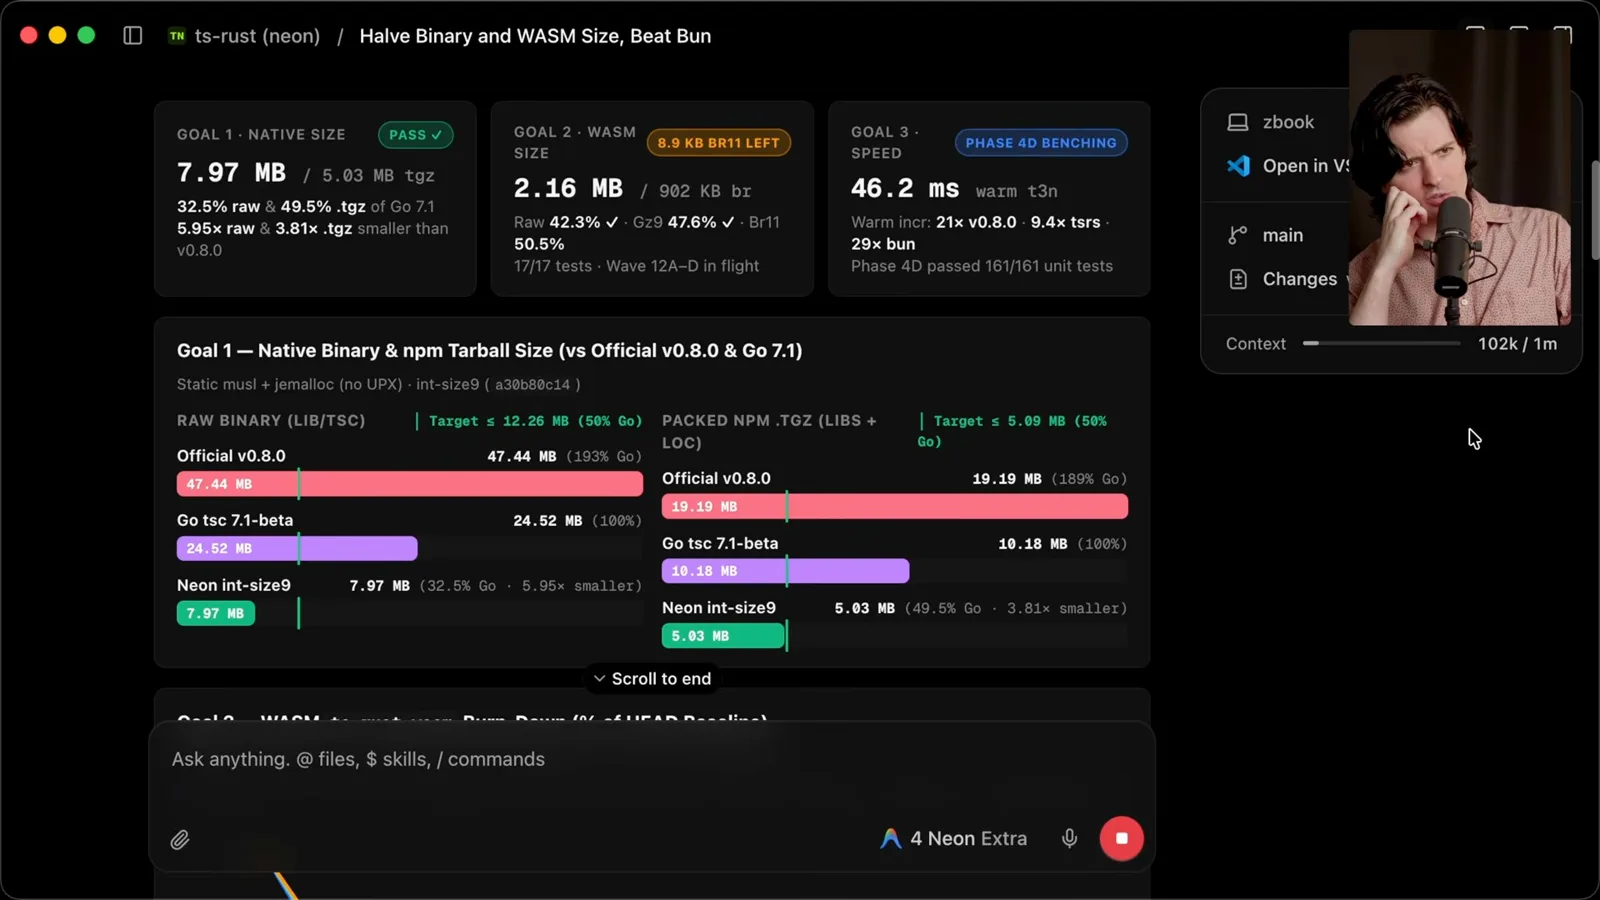
报告显示,完整基准测试套件的运行时间减少了 48.6%,整体速度约提高到 1.5 倍。有些热启动场景的提升还要大。这些是该项目及其测试中的结果,并非对所有模型或所有编程任务的总体排名。
交互式方案与各有高低的基准结果
Neon 把技术设计转化为交互式 HTML 说明。Theo 随后比较架构、代码审查和 3D 测试,结果各不相同。
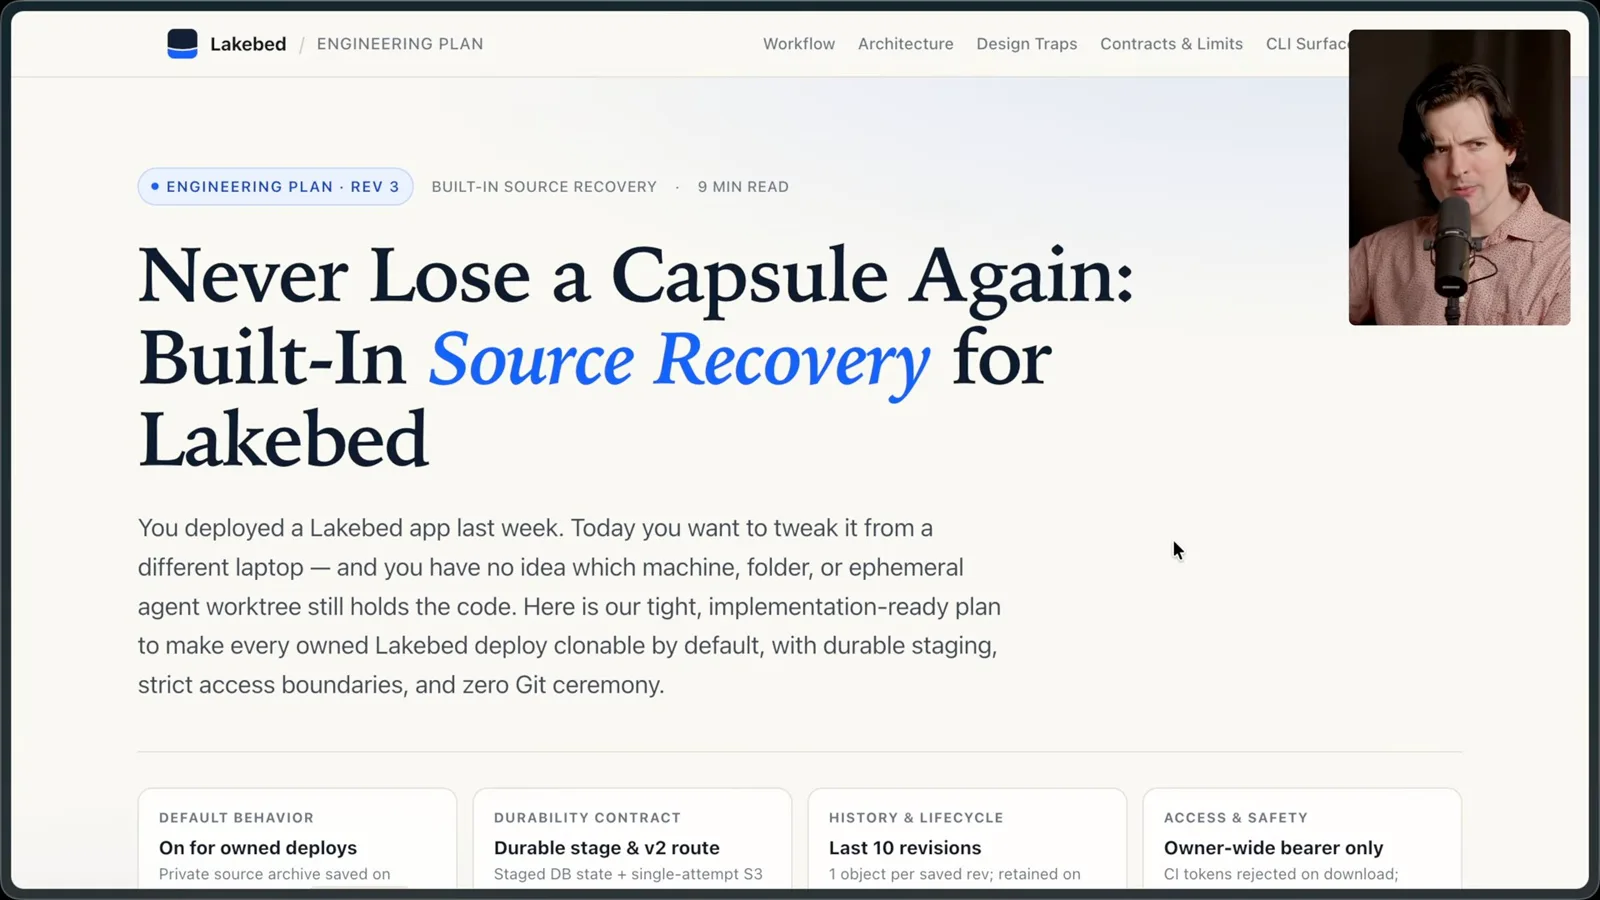
另一项测试是看 Neon 能否用一个美观、实用的网页解释复杂的工程方案。我曾尝试让其他模型用这种格式写计划。我想要的不只是一份普通文档,而是一份交互式说明,让人更容易检查设计及其取舍。
提示词要求它用 HTML 页面说明 Lakebed 的源码恢复计划,我还写明了重点和呈现方式。模型经常会抓住长提示词里的某个次要问题不放,或者忽略要求的格式,所以完整遵循指令也是测试的一部分。
Neon 生成的页面有清晰的标题、对用户问题的解释,以及工作流程、架构和设计陷阱等部分。它把这个页面当成真正给人阅读的东西来写。对我来说,这个结果让复杂的实施方案容易审查得多。
并非每项评估都对 Neon 有利。在一项要求模型描述代码库架构的基准测试中,它的 72 条陈述有 10 条错误。我也越来越怀疑能否只依靠这项测试,因为根据我的经验,模型可能分数很高,却对代码库做出经不起推敲的陈述。
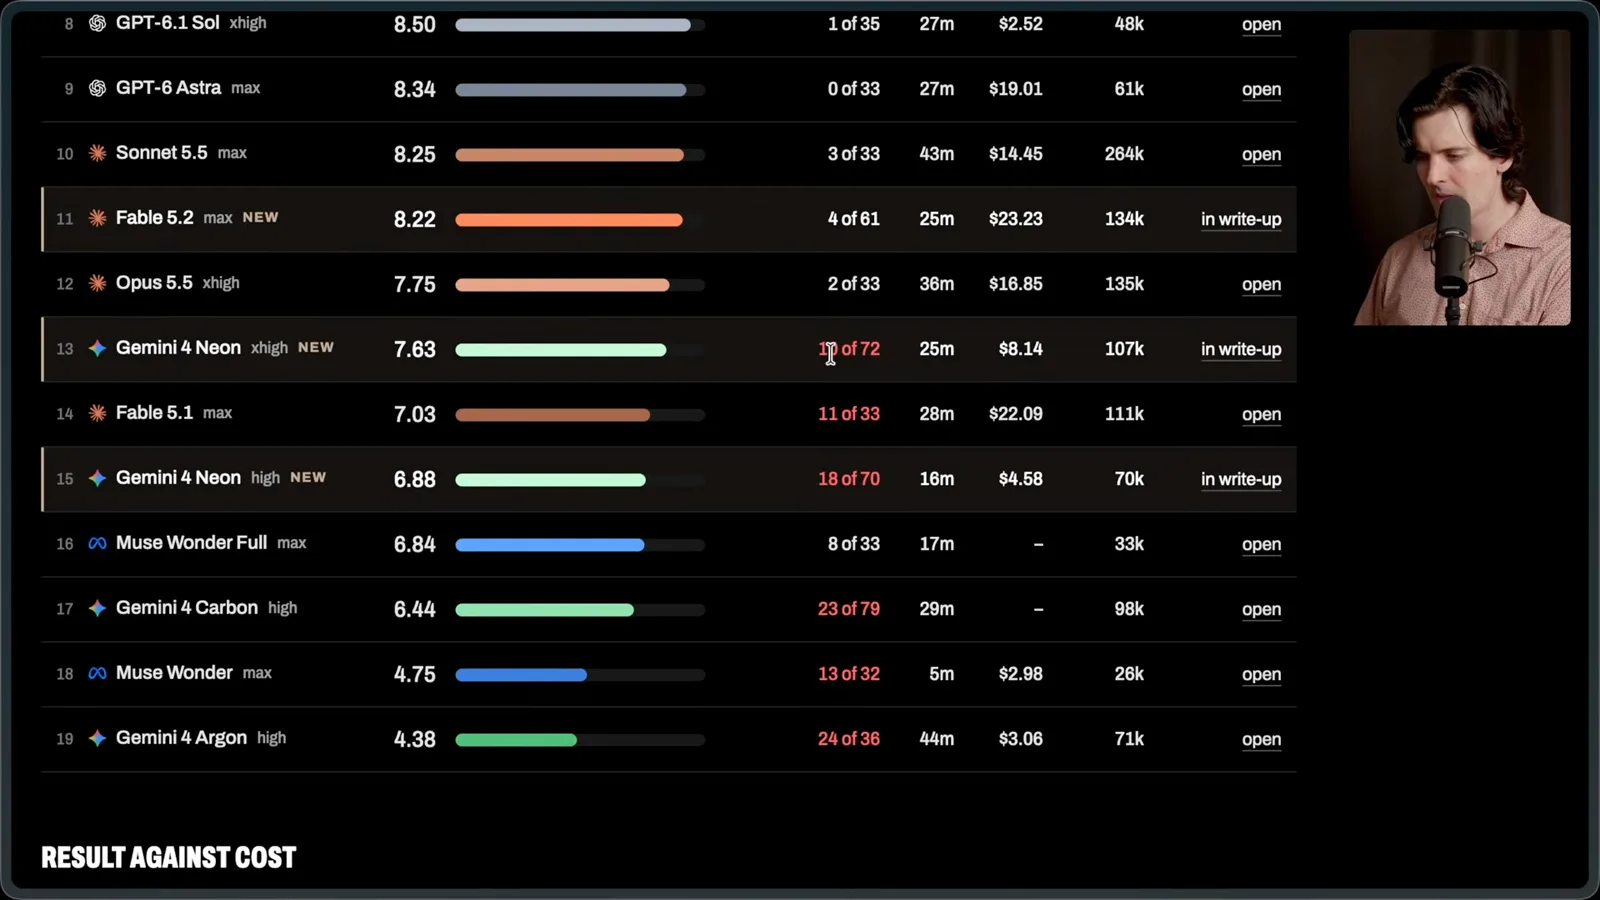
解释代码库与审查某一次具体的更改并不相同。在一项代码审查测试中,Neon 给出了 21 个有效发现和 5 个看似合理的发现;我认为它的信噪比比以前的 Gemini 模型好得多。这种反差让我觉得,任务本身和评估它的方式都很重要。
我还尝试了一个生成 3D 游戏的提示词。最初的结果不如我见过的其他模型最好的示例。把 Neon 调到更高设置后,效果有所改善,生成的游戏也能运行,但我不会用这次演示作为认定它是最佳模型的理由。
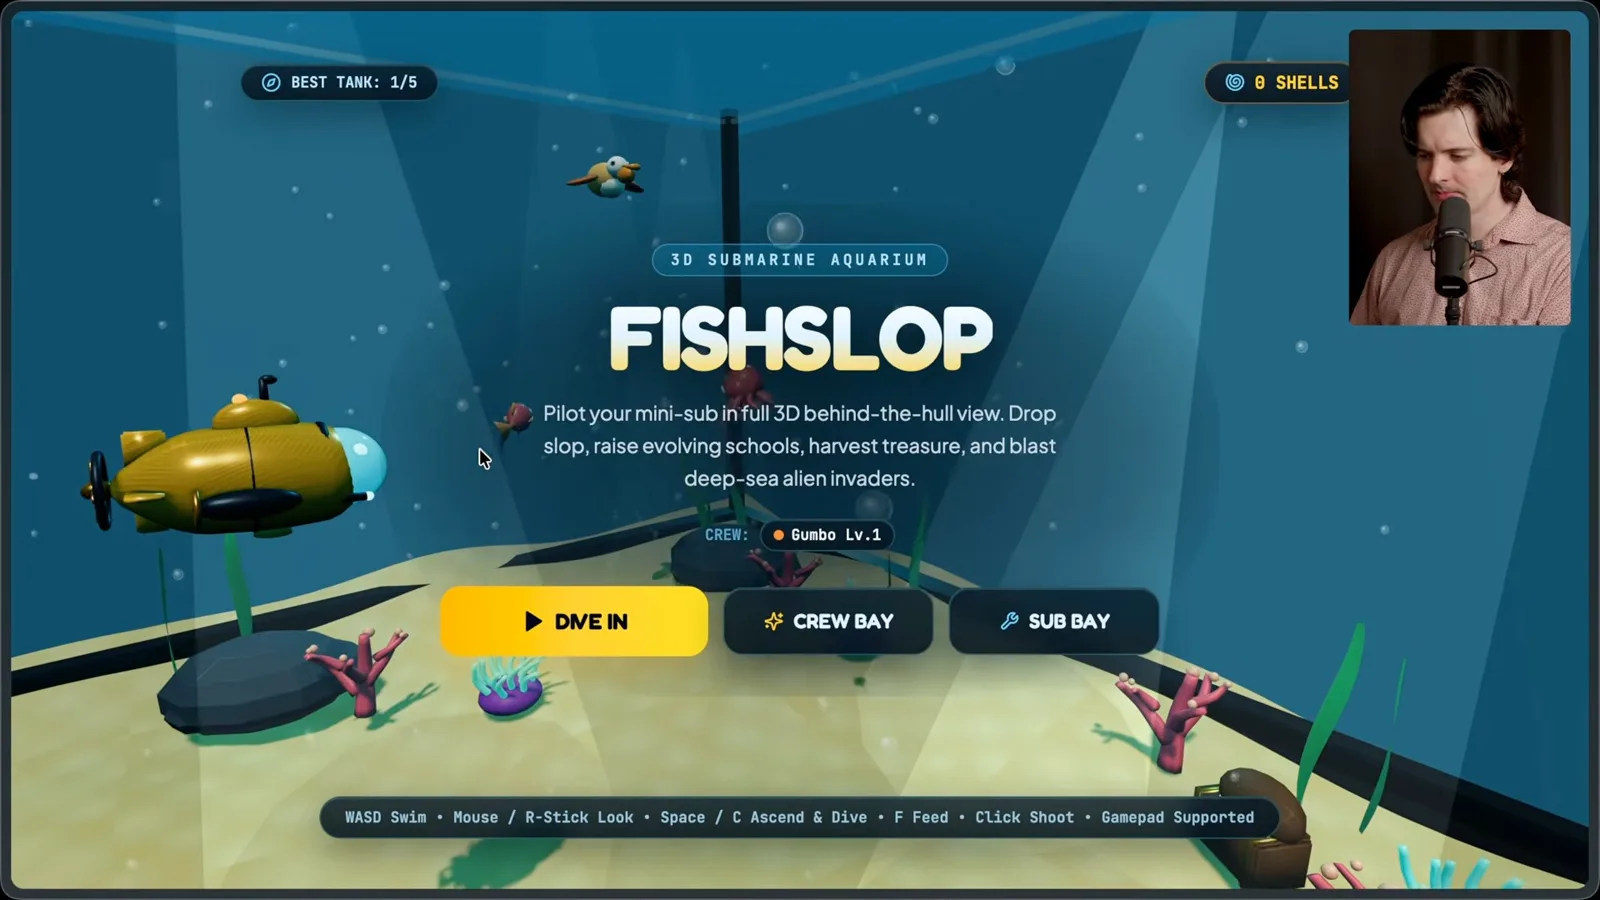
这些基准测试和演示都是有用的证据,但它们不会抹去我亲眼看到 Neon 在自己代码库中完成的工作。我的判断是,它尤其擅长持续进行实际开发工作,也擅长解释发生了什么。其他模型在某些测试或输出形式上仍可能更强。
这次改进为何让 Theo 意外
Theo 推测 Google 工程师的反馈可能发挥了作用,同时承认自己不了解内部情况。他最后鼓励读者用自己的工作测试这个模型。
这种进步从何而来?我不了解内部情况,因此接下来只是基于交流和观察的推测。我猜 Google 工程团队提供的反馈比简单地说模型表现不好要具体得多。
我怀疑,一个中型模型提供了整合反馈的机会,反馈来自构建和使用周边工具的人。按我的推测,这些工程师非常喜欢这个结果,希望尽快发布。这只是对可能发生之事的解释,并不是我能证实的事实。
无论原因是什么,我使用得越久就越受触动。Google 将 Neon 描述为中型模型,但在我的日常工作中,它的连贯性提升让我感觉像是跨越了一个代际。考虑到以前一些 Gemini 版本让我多么沮丧,这种对比尤其明显。
我仍然认为早期模型值得受到我当时的批评。一家公司可能先发布让人用起来沮丧的模型,后来又做出好用得多的模型。我的看法发生变化,是因为我用新模型解决了自己关心的问题,而不是因为我改变了标准。
我通过 T3 Code 使用 Neon,我们正在发布针对 Antigravity 集成的修复。正如仪表盘被隐藏的事件所示,周边工具仍有一些不完善的地方。我很感谢开发者的反馈似乎促成了一个更容易合作的模型。
如果有人不明白我为什么看重模型的连贯性,这是我找到的最好例子:工作过程始终容易理解,模型也持续关注实际任务。你可以在自己的真实项目中试试 Neon,看看它的表现。我的使用体验出乎意料地好。
一个 Google 中型模型竟然成为我做这类工作时用起来最愉快的模型,我现在仍觉得意外。我打算继续测试并分享发现。试试看,也告诉我它对你来说好不好用。
同频道的其他文章
 28:16EN → 简体中文
 Theo - t3․gg· 2026年11月19日Theo:当 AI 写代码时,我们失去和得到什么Theo Browne · Ping LabsTheo Browne 怀念亲手编程的技艺,同时认为 AI 奖励好奇心,让更多人能够创造。
 45:45EN → 简体中文Theo - t3․gg· 2026年11月18日Theo Browne:Astra 6.2 擅长审代码,实际工作却令人抓狂Theo Browne · Ping LabsAstra 6.2 在 Theo Browne 的测试中得分很高,但含糊的回答、停滞的任务和资源消耗让他没有将其设为默认编程智能体。
 27:57EN → 简体中文Theo - t3․gg· 2026年11月16日Theo Browne:用不同 AI 模型审查同一项改动Theo Browne · Ping LabsBrowne 的 council 工作流让不同模型审查并测试代码,但反复审查可能消耗大量 token 并扩大改动范围。
 42:19EN → 简体中文Theo - t3․gg· 2026年11月13日Opus 还是 Fable?按任务选择编程模型Theo Browne · Ping LabsTheo Browne 比较两种 Claude 模型,解释细致测试与探索性第二意见如何共同解决性能问题。
 19:39EN → 简体中文Theo - t3․gg· 2026年11月13日Theo 测量编程延迟后重新评价 Gemini 4 CarbonTheo Browne · T3他的智能体运行记录显示,等待响应开始耗时较长,部分审查未完成;他希望 Google 调查托管与缓存行为。
 29:37EN → 简体中文Theo - t3․gg· 2026年11月11日Theo 在 Gemini 4 Carbon 中找到安全用途,日常编码仍有困扰Theo他的测试显示,Carbon 的代码分析错误说法少于 Argon,但延迟与可靠性仍让他更倾向使用其他模型。