30 秒看懂
Theo Browne 不再为每个任务不断寻找“最佳” AI 模型,而是让不同模型家族审查同一项改动。他的 council 工作流让审查者检查并运行代码、打分,并向编码智能体反馈,之后才把拉取请求交给他。他说,这种方法发现了被误删的回归测试和访客分享功能中的安全漏洞,但他也遇到过失控的循环:一个任务启动了数百个子智能体,改动规模大幅膨胀。他建议限制审查轮数,并明确要求防止范围蔓延。
- 1不同模型家族能在同一改动中发现不同问题Browne 的 council 让训练方式不同的模型审查同一项改动,而不是试图为每项任务挑选完美模型。他说,不同方法经常能发现不同的问题。
- 2审查者为工作打分,并可以要求再进行一轮编码智能体把审查委派给多个模型;选定的分数门槛可以决定何时将工作交回用户。Browne 的 full-stop 工作流会在人类合并之前停下。
- 3他的审查模型在多轮之后给出了更高的分数对至少经过两轮评分的改动,Opus 的平均评分从 7.4 升至 8.9;Muse 和 Sol 均升至 9.1。这些是模型对他工作作出的审查评分。
- 4审查者发现了访客分享功能中的三个安全漏洞Browne 说,审查发现了回滚后仍可访问 HTML、撤销权限后仍显示缓存内容,以及会话检查和读取之间的竞态问题。
- 5让审查者运行并测试改动,而不仅仅阅读差异他的智能体可以使用工作电脑、向实现改动的智能体提问,并在拉取请求准备好之前验证行为。
- 6不设限的审查循环可能消耗大量资源并扩大改动一个任务启动了 600 多个子智能体,并让一个约 1000 行的拉取请求膨胀到 2 万多行。Browne 希望限制轮数,并明确控制范围蔓延。
- 7目标是在代码准备好时再打扰人Browne 希望智能体在提交给人之前先验证自己的工作,减少人需要观察并引导每个中间步骤的情况。
要点建议
- 针对复杂改动,让不同模型家族参与审查,而不是不断为每项任务选择特定模型。
- 让审查者可以运行代码,并向实现改动的智能体提问。
- 设定审查目标和最大轮数;如果工作反复打转,就停止循环。
- 留意 token 消耗:Browne 说,审查循环经常在两三天内用完一份每月 200 美元订阅的每周额度。
- 模型评分只是审查者自己对改动的评价,并非安全性的独立证明。
按章节阅读整理后的全文
使用多个模型,无需不停手动切换
Browne 介绍了如何在自己交付的代码中使用多个模型。他的 tstack 技能借鉴了 pstack,并适配自己的订阅和工作流程。
我使用很多 AI 模型,但并不建议不停地在它们之间切换,也不建议建立复杂的路由器,为每项任务挑选“正确”的模型。现在我交付的大部分代码会以另一种方式涉及多个模型:它们从不同角度参与同一项工作。
我从 Lauren Tan,也就是 Poteto 创建的 pstack 获得灵感。这组技能帮助人们跨模型处理更有挑战性的任务。我自己的 tstack 借鉴了其中喜欢的想法,并针对日常工作和现有订阅进行了调整,其中包括 full-send、full-stop、sol-loop 和 council。
随着我用这些工具编写更多代码,我发现模型之间存在差异,调用模型的技能也有不同的边界。这种差异对我建立的审查流程很重要。
让不同模型家族参与 council 审查
Council 让不同模型审查同一项改动,并用分数门槛判断何时停止。Browne 解释了他的智能体运行框架如何委派审查并记录评分。
我想重点介绍的技能叫 council。使用者的感受并不一致:有些人觉得它很适合审查,也有人认为额度消耗太高。我认为它很有用,但也有重要的限制。
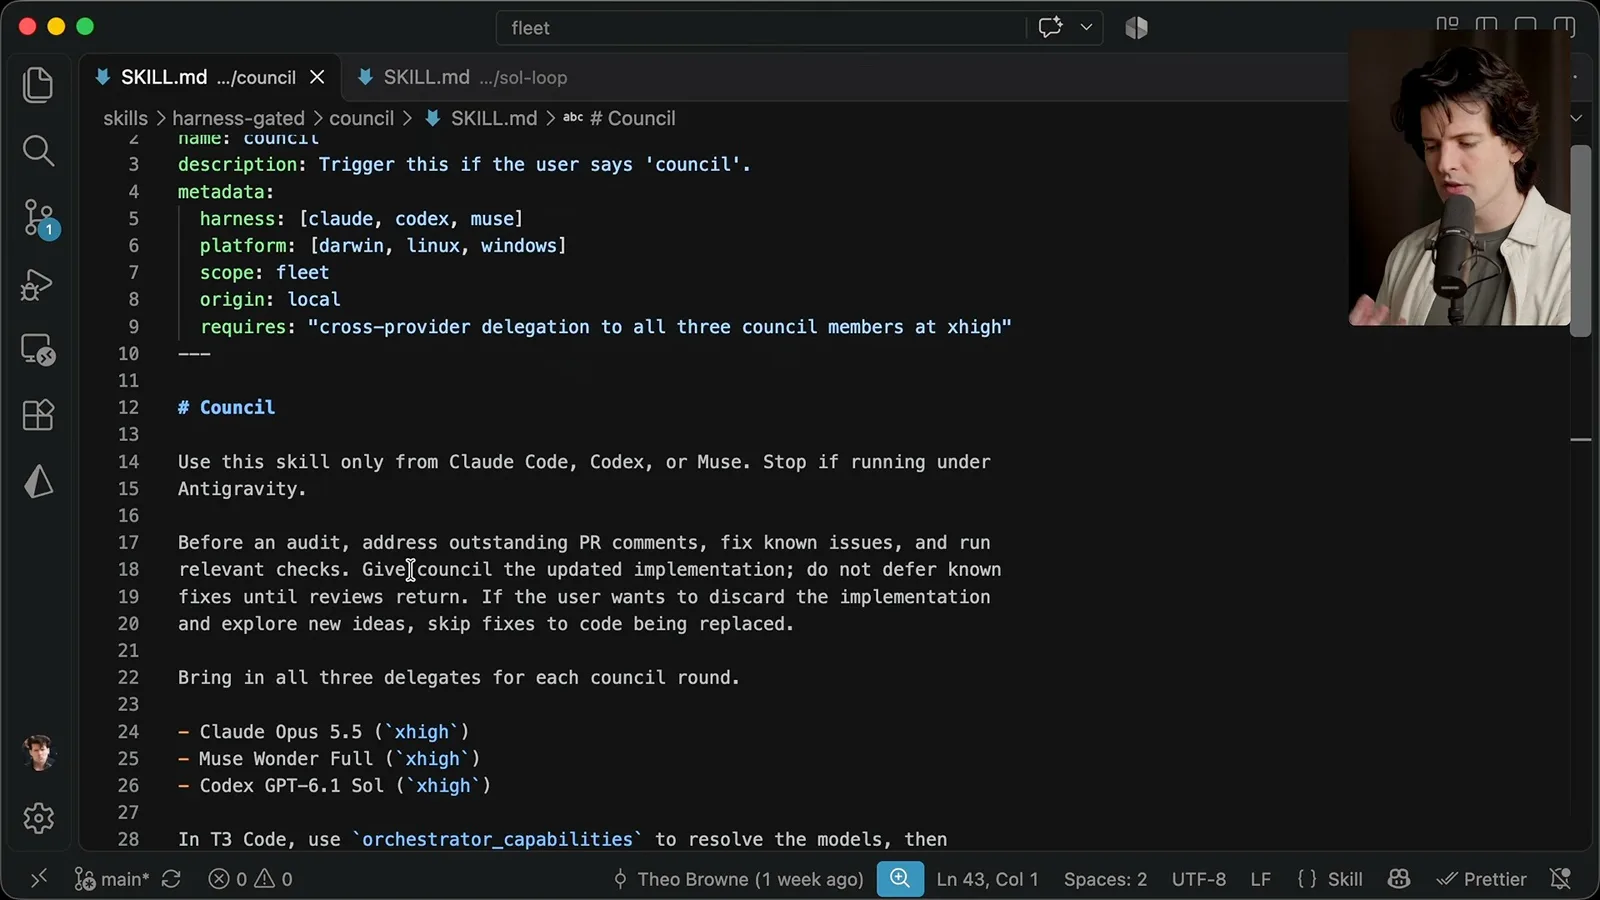
基本思路是让来自不同家族的模型对同一项改动提出反馈。我认为,同一家族的模型行为可能比较相似,因此让它们审查可能像在一天的不同时段请同一个人审查。我的目标是让真正不同的方法参与复杂改动的审查。
一旦选定默认编码模型,我仍然很少切换,除非另一份订阅还有可用额度。我并不是建议长期遵循“这个模型处理数据、那个模型处理界面、另一个模型写文章”这样的规则。有意思的是把它们对同一项工作的不同视角结合起来。
我最初构建 council,是为了比较 Muse、Sol 和 Opus 的反馈。在我的工作中,每个模型都发现过其他模型遗漏的有用问题。审查界面设计时,这些差异也很有帮助:一个模型可能给设计打 9 分,另一个却只打 5 分。
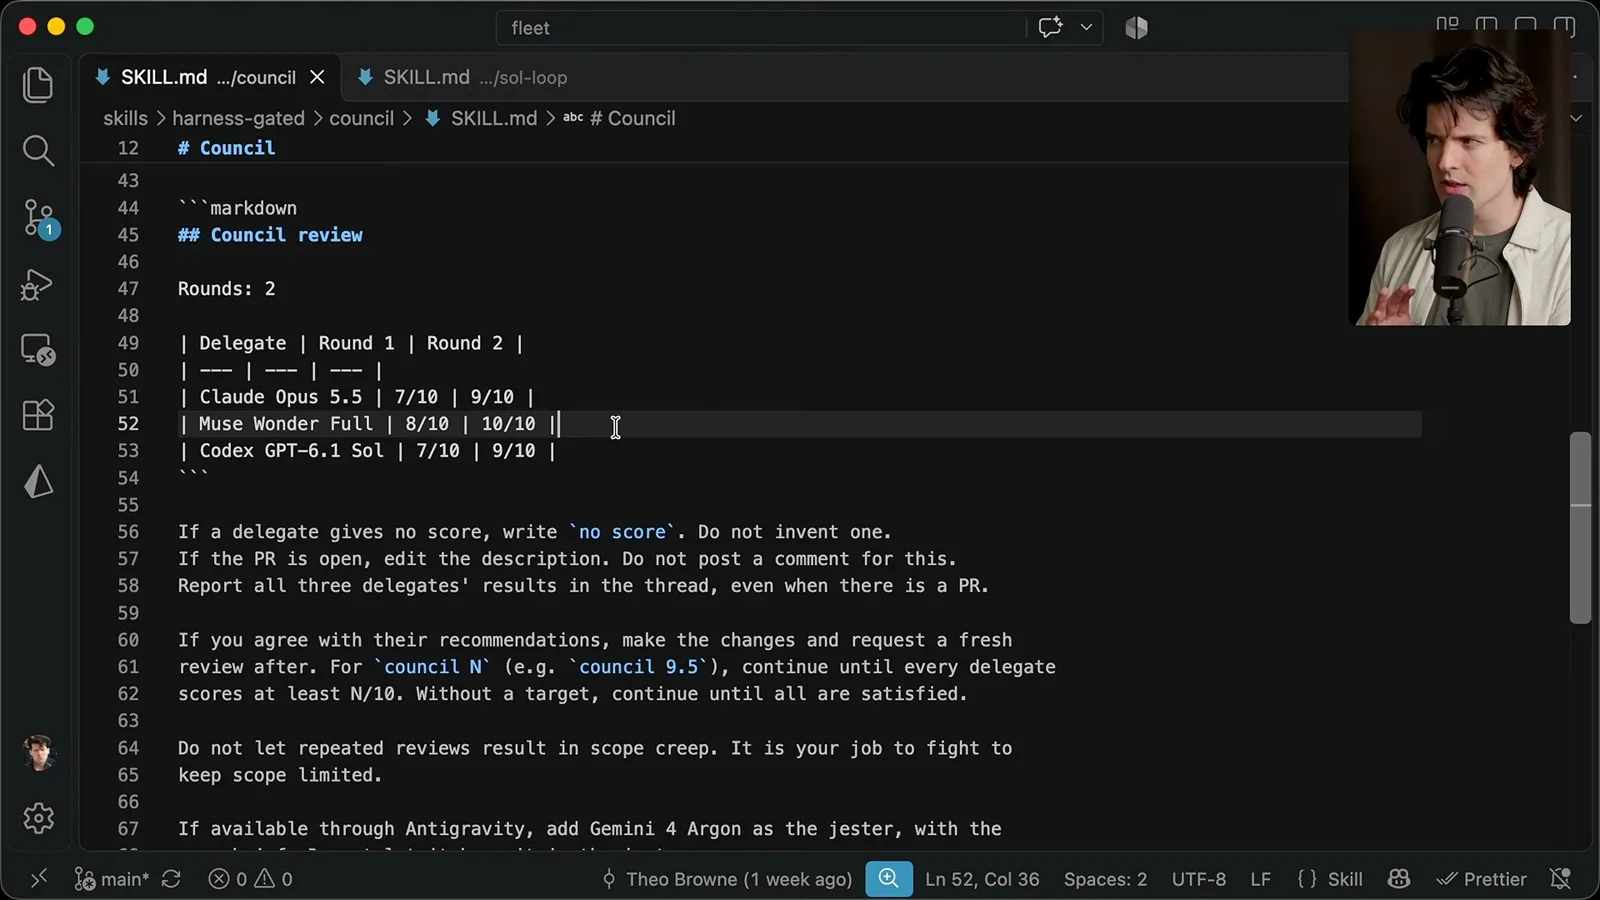
这个工作流需要一个主智能体,并且它所在的运行框架要能调用其他模型进行审查。我通常让审查者按 1 到 10 分打分:1 分表示应该放弃改动,10 分表示看不出不合并的理由。最低分数由任务决定。
例如,我可以提出修改要求,并加上“full-stop with council 9.5”。Full-stop 会让智能体尽力验证改动并准备拉取请求,但在合并前停下,由我检查。Council 则增加一项要求:所有审查者都达到指定分数,智能体才认为工作完成。
在 T3 Code 中,一个运行框架可以调用另一个,因此主智能体可以通过 Claude Code 启动 Claude 模型,通过 Codex 启动 OpenAI 模型,并通过 Muse 自己的运行框架启动 Muse。审查分数会记录在拉取请求中,让我看到哪些模型审查过、给出了什么评价。
我有时还会让 Gemini 作为额外审查者参与,但在自己的设置里以不同方式处理它的分数。我遇到的一些问题与 Gemini 的智能体协议和 T3 Code 之间的集成不完整有关;我说过,这项集成正在改进。
使用这些审查的价值需要与 token 消耗一起衡量。Council 之前,我用过更简单的 sol-loop:让 Opus 实现改动,再让审查细致的 Sol 提出反馈;两者反复交换修改和意见,直到都认为工作做好。
实际工作中的审查评分与发现的漏洞
Browne 展示了审查模型在多轮中的评分,以及测试删除、访客分享和中断失败的例子。审查者可以运行代码并与实现智能体交谈。
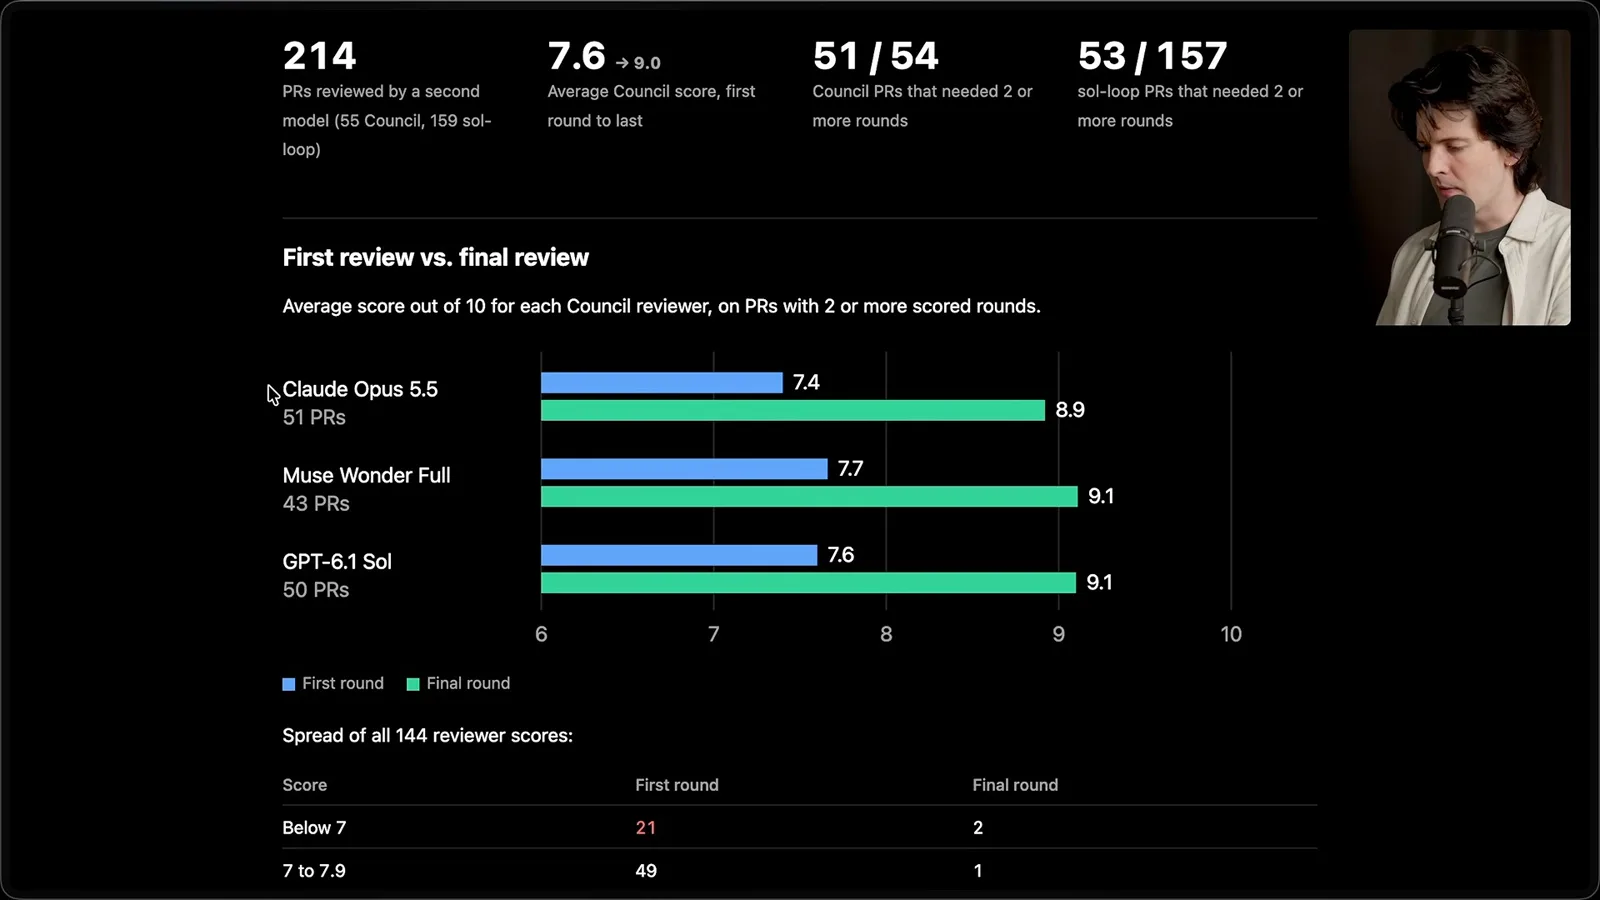
我查看了自己工作中的 council 记录。在至少经过两轮评分的拉取请求中,Opus 的平均评分从 7.4 分升至 8.9 分,Muse 从 7.7 升至 9.1,Sol 从 7.6 升至 9.1。Opus 经常正是编写了自己最初评分最低的代码的模型,因此单独安排一次自我审查也可能改变模型发现的问题。
在 144 个审查评分中,21 个最初低于 7 分,最后只有两个仍低于 7 分;128 个最终达到 9 分或以上。这些是审查模型在我工作过程中给出的分数,而不是对缺陷率的独立测量。
一个例子是删除低价值测试。Muse 负责删除,Opus 则审查测试是否有价值,并发现有些被移除的保护措施曾防止旧错误复发。另一次测试改动中,Opus 发现恢复的三个测试实际上不可能失败。审查角色提出的问题与实现角色不同。
在开发 T3 Code 的访客分享功能时,我花时间审查架构并反复修改实现。该功能允许用户通过链接分享线程,让访客查看内容,并在获得批准后提交提示词。正确处理访问边界并不容易。
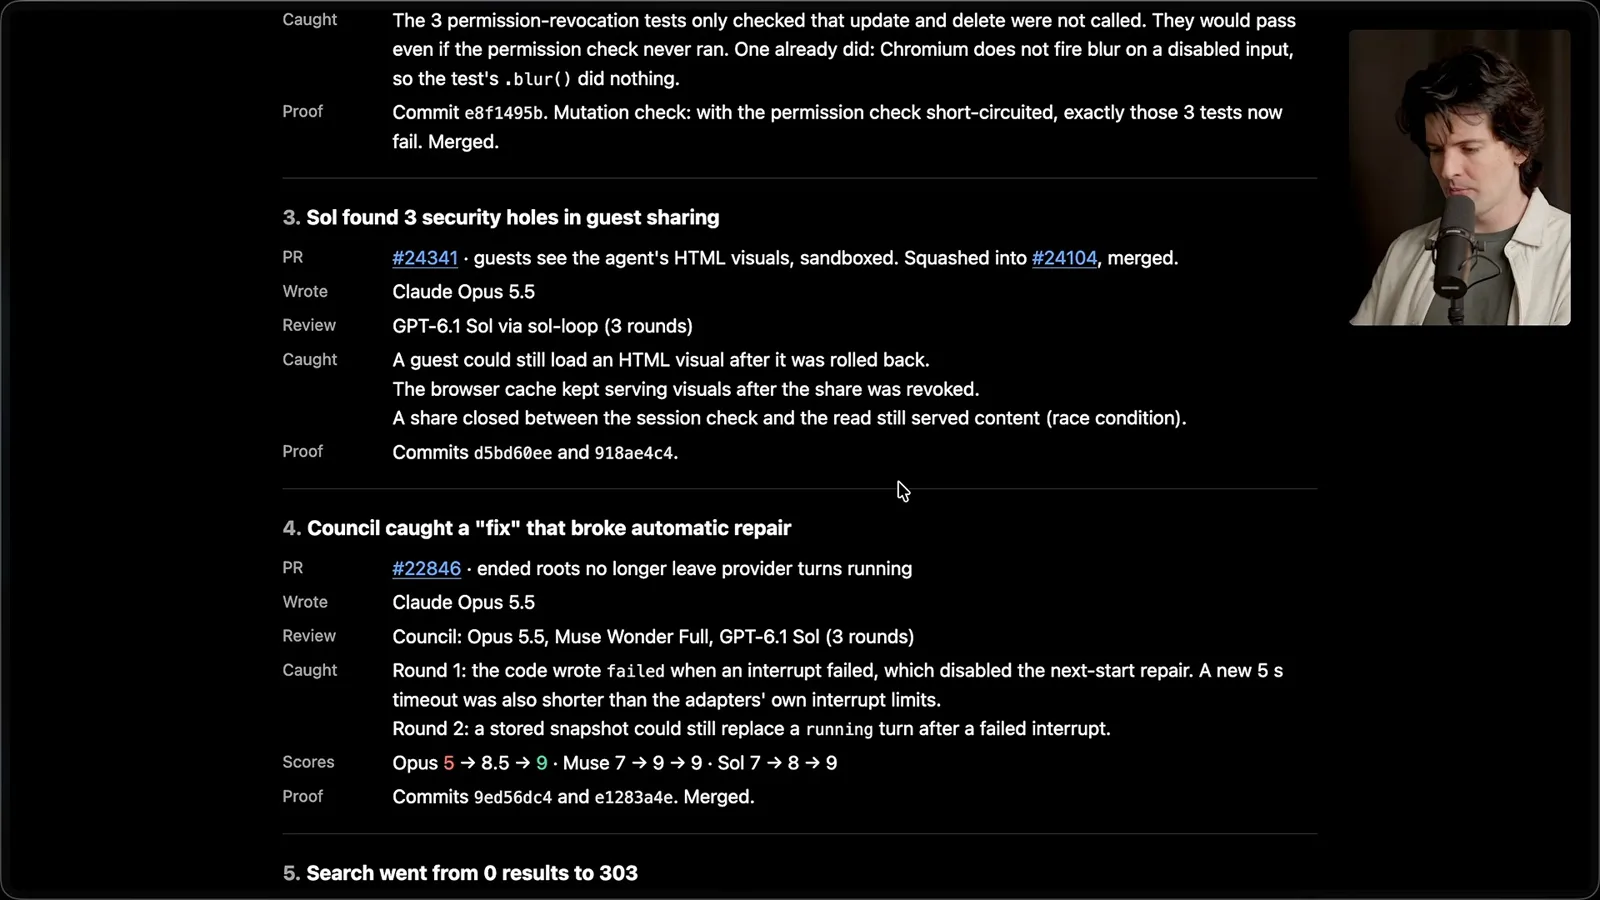
Sol-loop 发现了三个安全问题:访客在 HTML 可视化内容回滚后仍可加载它;权限撤销后,浏览器仍可能显示缓存内容;分享在会话检查与读取之间关闭时,竞态条件仍可能导致内容泄露。
另一次审查涉及异常中断后仍处于运行状态的轮次。Opus 最初给自己的实现打了 5 分,三轮审查后打了 9 分。审查者发现,中断失败可能阻碍修复步骤,旧快照也可能覆盖正在运行的轮次或用户的引导指令。
这不同于在拉取请求提交后让机器人只检查代码差异。审查智能体可以使用编写代码的电脑,运行并测试改动,向实现智能体提问,讨论它们发现的问题。它们不仅有上下文可读,也有能力进行验证。
根据某个人的偏好进行审查
他让审查者根据某人可能的偏好评价改动,其中包括根据 Cory Quinn 反馈重新设计 Tailscale 设置。他当时尚未把修改后的拉取请求发给 Quinn。
审查标准也可以定制。我曾让智能体评估问题的严重程度、改动未来造成问题的可能性,以及我可能多么不喜欢它。这种方式会损失信息,但可以帮助引导智能体的工作贴近我的偏好,而多个模型可能发现不同的不匹配之处。
我为 Cory Quinn 修改 Tailscale 设置时尝试了类似方法。他使用 T3 Code,企业账户配置复杂。我做出了一个自认为合适的方案给他看,他却说这与他想要的正好相反。
我把他反馈的截图交给正在工作的智能体,允许它放弃现有修改,包括整个拉取请求。我让它在需要时研究他的公开文章,围绕他可能喜欢的方案重新设计,并再次请 council 按这个标准审查。
我设定的目标是每个审查者都至少打 9.5 分。新的拉取请求已经提交,但我还没有再次发给 Quinn。因此,我认为他会更喜欢新方案仍只是预测,依据是智能体的反馈,而不是他的回应。
Token 成本与失控的审查循环
反复审查会消耗大量模型额度。Browne 描述了失控的循环,并认为工作流需要限制轮数和范围。
第一个限制是成本。我主要在 council 中大量使用 Muse,而不是在日常编码中经常使用它,但每周都会用完每月 200 美元套餐的每周额度,通常两三天就用完。这些反馈循环会消耗大量 token。
第二个限制是迭代失控。有几次编码智能体无法让审查者达成一致,却持续运行了 50 多轮。有一个线程在至少 20 轮审查中启动了 600 多个子智能体,却没有取得有用的进展。
同一项改动从约 1000 行增长到 2 万多行,因为智能体试图满足每一个边缘情况。每次扩张都会让下一轮有更多代码需要审查,也让发现小问题的机会增加。我希望设置最大轮数,在进展停滞时停止,并控制范围蔓延。
我发现 Opus 通常愿意在循环没有进展时停下来告诉我,而按我的经验,Sol 可能会继续追究小问题,直到拉取请求大得难以合并。我也在尝试降低推理强度,看看不那么彻底的审查效果如何。
如果每个 token 都要按完整 API 价格付费,我不会使用目前这个版本的工作流。叠加订阅让它对我来说更可行,但 token 消耗非常大,应该纳入决策。
工作准备好时再让人介入
他的目标是让智能体先验证代码,再请求人的关注。他认为,盯着每条中间推理记录可能引发不必要的干预。
这些技能背后的目标是让智能体尽可能完成验证,并准备好可合并的改动,然后再打扰我。除非我正在调试界面本身,否则不想盯着每个线程运行。
最近,我在处理 T3 Code 的线程界面时观察了一条 Opus 推理记录。它看起来明显朝着错误方向前进,于是我发送了纠正。就在我发送的同时,智能体给出了我想要的结果;我的干预反而让它困惑,因为它已经做了我要求的事。
这段经历进一步让我倾向于在线程需要我之前不去干预。智能体应该拥有测试自己工作的工具和资源,然后才把拉取请求交回来审查。我估计,我打开的这些线程生成的拉取请求中,约有 80% 可以立即合并。
即便 council 只让改动可以直接合并的概率提高几个百分点,在我的情况下,我也认为 token 成本值得。其他人不必采用我特定的技能或工具;目标是建立一个以更少打扰带回可用代码的工作流。
我已经把这些技能放进公开仓库,希望收到反馈:它们在哪里有效、消耗多少额度、在哪里失败。人们与智能体协作的方式正在快速变化,我自己的偏好不足以证明什么方法对每个人都有效。
同频道的其他文章
 42:19EN → 简体中文
 Theo - t3․gg· 2026年11月13日Opus 还是 Fable?按任务选择编程模型Theo Browne · Ping LabsTheo Browne 比较两种 Claude 模型,解释细致测试与探索性第二意见如何共同解决性能问题。
 19:39EN → 简体中文Theo - t3․gg· 2026年11月13日Theo 测量编程延迟后重新评价 Gemini 4 CarbonTheo Browne · T3他的智能体运行记录显示,等待响应开始耗时较长,部分审查未完成;他希望 Google 调查托管与缓存行为。
 29:37EN → 简体中文Theo - t3․gg· 2026年11月11日Theo 在 Gemini 4 Carbon 中找到安全用途,日常编码仍有困扰Theo他的测试显示,Carbon 的代码分析错误说法少于 Argon,但延迟与可靠性仍让他更倾向使用其他模型。
 48:20EN → 简体中文Theo - t3․gg· 2026年11月10日Fable 5.2 能力强大,但 Theo Browne 日常编程仍更喜欢 OpusTheo Browne · T3经过一天测试,Browne 比较基准成绩、使用限额,以及仍需人工检查的错误。
 45:21EN → 简体中文Theo - t3․gg· 2026年11月9日Theo:AI 编程时代,维护开发环境成了重要工作Theo Browne · Ping Labs从 Twitch 到 T3 Code,Theo 认为工程师需要消除阻碍智能体的摩擦,并建立有效反馈。
 42:14EN → 简体中文Theo - t3․gg· 2026年11月6日Theo Browne:Claude Code 如何审阅自己的变更Theo Browne · Ping LabsTheo 将 Anthropic 的分层审阅流程与 T3 Code 对比,重点讨论验证、回滚和 agent 审阅的停止规则。