30 秒看懂
Theo Browne 发现 Claude Opus 5.5 适合细致测试和日常编程,而 Fable 5.2 更常提出非常规方案,或帮助结束反复审查。他说,在 T3 Code 的性能问题中,Opus 建立了测试环境,Fable 发现持续携带历史记录的问题,使部分情况下传输的数据减少约 150 倍。他只使用 Fable 两天,建议读者根据自己的任务、推理强度和订阅限制进行比较。
- 1订阅限制改变成本比较Browne 认为,套餐包含的用量可能让实际任务成本与 API 价格差异很大;结果取决于套餐和工作负载。
- 2更高的推理强度不一定更好他在很多 Opus 任务中偏好高强度,并说最高强度可能对简单问题做过多工作。
- 3他观察到 Fable 与 Opus 输出速度接近他测得 Fable 约每秒 106 个词元,Opus 约 112 个,并非原本预期的巨大差距。
- 4两个模型找到性能修复的不同部分Opus 建立测试环境;Fable 识别出长历史记录的问题,并建议将目标与线程分开。
- 5愿意交付的模型也可能遗漏问题在他的审查中,Fable 有时遗漏报告;Browne 衡量了遗漏的重要性,同时承认更宽松审查的风险。
要点建议
- 用自己的任务测试模型:更大的模型并非在所有任务上都更好。
- 用细致的模型建立复现并检查边界情况;陷入困境时尝试第二种视角。
- 估算每项任务成本时,分别比较订阅上限与 API 定价。
- 为审查循环设置停止规则,避免细小反馈使改动不断膨胀。
按章节阅读整理后的全文
按任务和实际成本比较模型
Browne 将编程模型比较集中在 Opus 与 Fable,并认为订阅价格会改变实际成本。他的示例反映个人用法。
Theo Browne 认为,随着选择增多,挑选编程模型变得更难。对目前的工作,他将实际选择缩小到 Claude Opus 5.5 和 Fable 5.2,同时承认有些人可能有特定理由选择其他模型。
Browne 认为,订阅额度可能让每项任务的实际成本与公布的 API 价格大不相同。他认为 Claude 订阅的使用量相对价格尤其划算;计算结果取决于用户的套餐、工作负载和限制。
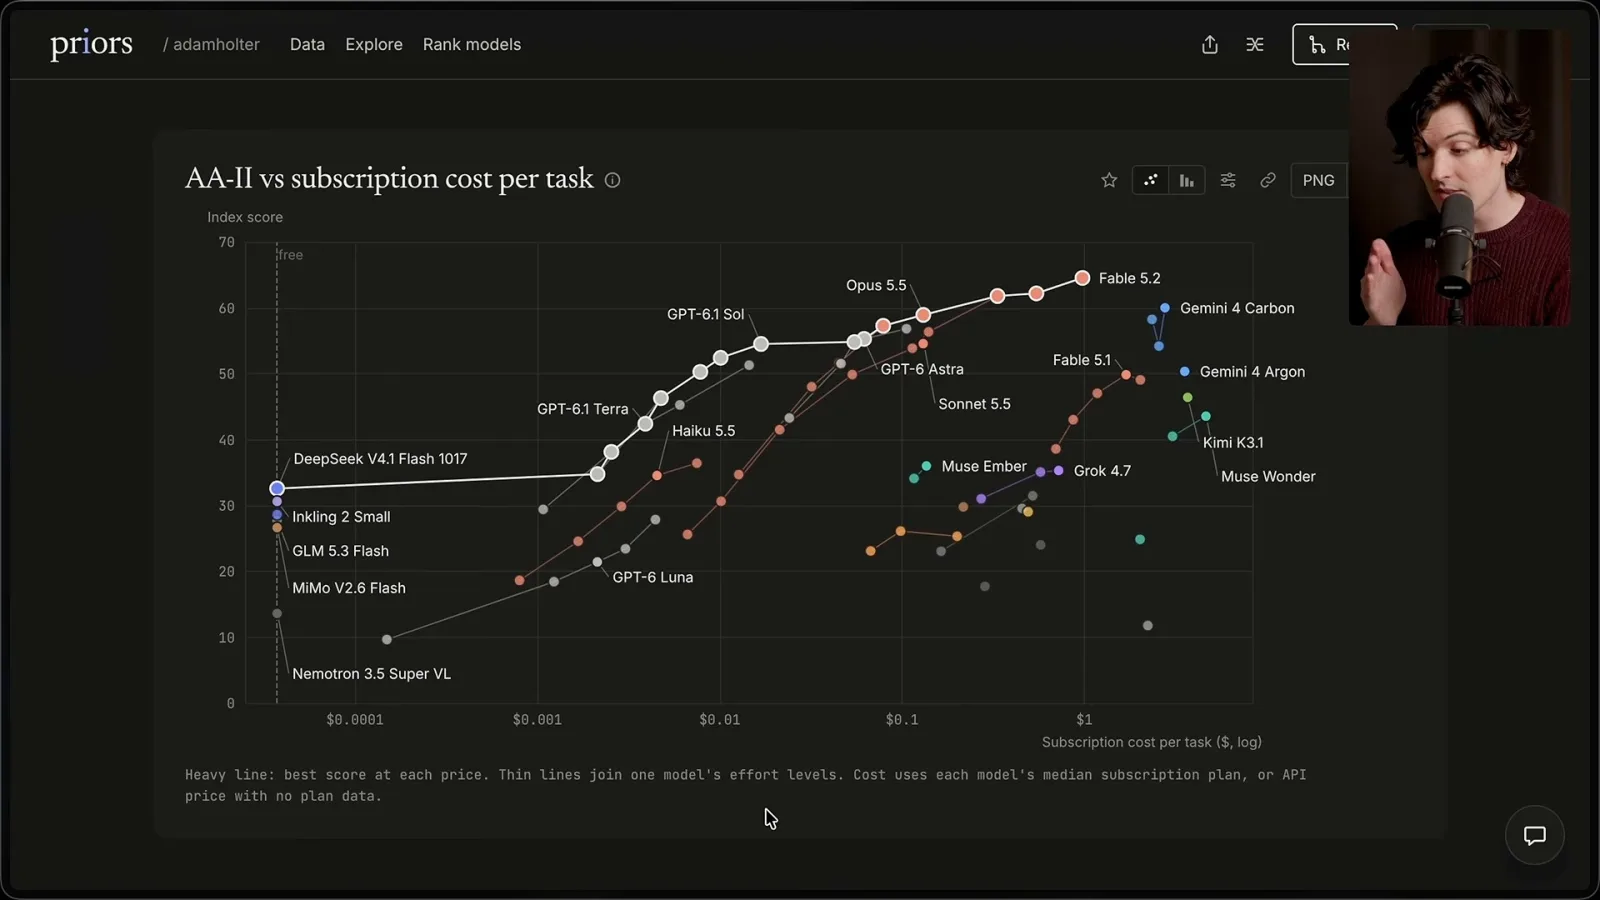
他展示了一张比较模型评分和估算订阅任务成本的图。在他看来,Opus 在两者之间表现均衡;他也说性能和价格可能变化,基准测试未必等同于真实编程表现。
他强调,订阅可能让昂贵模型的使用成本低于按 API 词元单价估算的结果。他的结论基于视频中选取的比较方式和套餐。
他的简略建议是:大多数工作用 Opus,最难的任务用 Fable。但在他自己的比较中,Opus 在某些情况下胜出,Fable 也会遗漏细节,因此他不把更大的模型视为全面升级。
不仅选模型,还要选择推理强度
他阅读 Anthropic 的指南,在许多任务中偏好高强度。模型过度思考时,更多推理可能浪费工作或降低质量。
Browne 阅读了一份 Anthropic 模型选择指南。指南列出 Haiku、Sonnet、Opus 和 Fable,并称 Mythos 面向安全和生命科学研究,访问受限。他指出,Mythos 与 Fable 使用相同的底层模型,但防护措施不同。
一项演示要求四个模型编写 Python 程序重建一张图片。Browne 注意到画面底部的文字被播放器控件遮挡,认为这类呈现细节是 Fable 可能忽略的。
指南建议从中等推理强度的 Opus 开始。Browne 觉得中等强度有时结束得太快,检查不够。尝试多个设置后,他在许多任务中更喜欢高强度,并建议按需要从中等强度往上调。
指南默认中等强度;Browne 建议先从这里开始,检查或推理不足时再提高。他偏好高强度,来自自己的工作流程。
推理强度更高并不必然更好。Browne 说,最高设置即使对简单问题也可能强制大量推理;他引用了一些基准测试,称 Fable 在最高设置下不如较低设置。他将其比作对日常选择过度思考。
规范清楚不代表任务简单:迁移和性能工作仍可能有难以发现的约束。根据自己的任务成本和结果,Browne 不赞成仅因为范围已经写清楚就选择 Sonnet。
在他称为 Fish Slop 的任务中,Sonnet 消耗了足够多的输出词元,导致总成本上升,尽管其词元单价较低。他认为它可能适合作为范围明确的工具,而非默认交互模型。
他认为 Haiku 适合大量模式匹配,或在整个代码库中寻找特定情况。虽然指南建议在某些委派工作中使用较小模型,他不会选择它来写代码。
指南建议在特别困难的技术问题和长时间无人值守的运行中使用 Fable,并建议将较大模型的较低强度与较小模型的较高强度进行比较,不要假设每次增加推理强度都是最佳选择。
Browne 希望模型未来能自行调整推理强度,让用户不必再选择级别。但他说,目前这个选择仍有意义。
Browne 在困难的验证工作中使用超高强度,例如 Windows 开发和分析大量日志。模型需要复现问题、测试边界情况或充分调查后再提出修改时,他尤其看重这种设置。
他认为 Opus 更倾向于反复检查,并找出 Fable 可能略过的细节。这种细致也有代价:任务边界不清晰时,模型可能做过多工作。
订阅上限与输出速度
API 价格与订阅额度不能互换。Browne 观察到 Fable 的输出速度接近 Opus。
指南将普通工程工作分配给 Opus,大量简单任务分配给 Haiku,困难迁移和研究分配给 Fable。Browne 说 Opus 也能协调大型迁移:他曾用它以 Rust 重写编译器,并委派子代理。
指南中 Fable 高强度比 Opus 最高强度每项任务更便宜的比较采用 API 定价。Browne 说订阅上限会改变计算:在他的套餐中,Fable 有单独的每周限制,更多额度可以用于 Opus。
他给出了自己对 200 美元订阅所含用量按 API 价格折算的估计,认为差距可能大于简单的二比一。这些是他的观察,并非对具体额度的承诺。
延迟是另一项权衡。指南建议在有人等待交互式回答时使用较低强度,并提到新一代模型的输出速度有所提高。
Browne 报告说,他观察到 Opus 每秒输出约 112 个词元,Sonnet 约 145 个,Haiku 约 255 个。他原本预期 Fable 慢得多,但测得约每秒 106 个,与 Opus 接近。
他将自己的测量与 Artificial Analysis 的数据比较,表示 Fable 的输出速度落在他观察到的 Opus 范围内。这些是观察值,不保证每位用户和每项任务都有相同响应时间。
细致的学生与探索性的学生
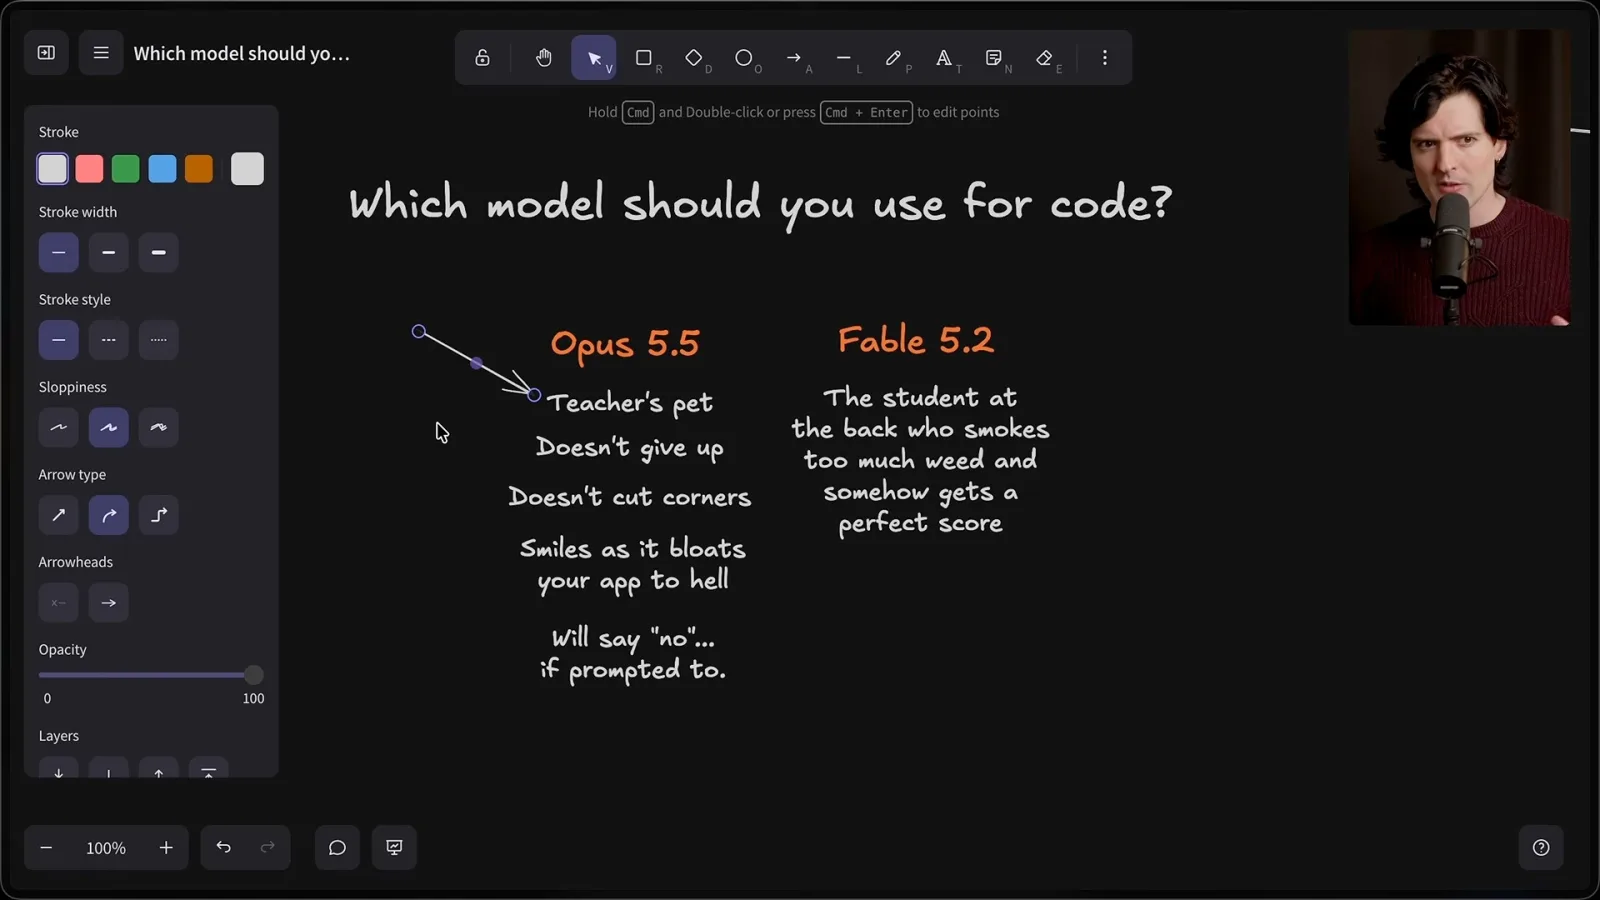
Browne 用学生作比喻,形容 Opus 细致、Fable 更愿意尝试非常规方案。他提醒自己使用 Fable 的时间还很短。
按他的经验,Opus 和 Fable 都能很好地使用工具、协调工作并执行长期任务。他提醒自己只使用 Fable 5.2 约两天,对 Opus 则熟悉得多,今后的看法可能变化。
他把 Opus 拟人化为勤奋的学生:遵循指令、检查工作并坚持完成,但也可能让项目膨胀,或继续执行作用不大的反馈。倾向于配合并不意味着它总会质疑原任务。
Browne 还希望代理在长对话和多次上下文压缩后仍能解释自己的工作。他认为,清楚说明任务与仅仅继续行动是两回事。
他发现一个有用的提示词调整:如果模型认为想法合理就继续,否则提出替代方案。在他的经验中,这比自动执行请求更能给反对意见留出空间。
学生的比喻也指出一种失误:代理即使勤奋,仍可能漏掉问题。他说,在适当时候要求模型提出异议,提高了回答的实用性。
他把 Fable 比作另一种学生:能找到出人意料的巧妙答案,却可能跳过细节。这个比喻是他描述观察到的行为的方式。
他提到一种课堂测试:要求学生行动前读完整张试卷。在他的比喻中,Opus 更可能遵循指令,而 Fable 可能走捷径;在其他情况下,捷径也可能有用。
如果必须仔细阅读所有要求和边界情况,他倾向选择 Opus。如果任务需要新方法,而且操作者能够独立检查结果,Fable 可能更有用。
从两种视角修复性能问题
Opus 建立复现环境,Fable 找到了历史记录保留问题。Browne 用它说明组合模型的收益和局限。
T3 Code 的一个性能问题展示了如何组合使用两者。运行时间长的对话线程加载变慢,Browne 希望模型在不同机器和环境中复现问题并测试修复方案。
他说 Opus 建立了有用的测试环境,改善了几个情况。但长线程开头一个未完成的任务清单仍导致系统包含全部历史记录,Opus 起初没有识别出多余数据的来源。
随后 Browne 让 Fable 验证已有工作、探索边界情况并提出方案。它识别出持续存在的任务清单问题,建议将目标与庞大的历史记录分开传递。他说,这让部分情况下的数据传输量减少约 150 倍。
在他的并行实验中,Fable 虽找到了有用的修复方案,建立测试环境却没有那么全面。这个例子体现了两种模型组合使用、互相检查工作的价值。
Browne 提醒,代理可能不断根据审查反馈行动,即使评论只是小问题。缺乏停止规则时,小改动可能膨胀成大项目。他调整审查循环来限制这种增长。
知道什么时候审查已完成
选择细致还是宽松的审查取决于风险。Browne 描述如何借助第二个模型打破循环,同时认识到遗漏问题的可能。
他比较了两位人类审查者:一位熟悉代码库,会检查每个棘手边缘;另一位经验广泛,判断更快。高风险工作他会选细致的审查者,需要决定能否交付时则可能选另一位。
代码库专家可能针对过去的故障和本地约定留下许多评论;经验丰富的外部人员可能更关注整体模式并迅速批准。Browne 认为,两种方式都不适用于所有改动。
在这个比喻中,Opus 是细致的审查者,Fable 更愿意认为修改已经足够好。Browne 重视两种风格,但他说 Fable 可能漏掉真实问题,而 Opus 可能把时间花在不太重要的边界情况上。
他的粗略区分是结果是否容易验证。对语言迁移等工作,他预计细致的模型能根据测试不断改进;对于视觉设计或寻找非常规方案,他认为 Fable 更可能给出多样选择。
他建议从 Opus 开始,结果不满意或建议过于相似时尝试 Fable。他也遇到过反向切换后解决问题的情况,因此不认为存在固定的能力上限。
他推测两种模型行为不同的原因,包括训练方式可能不同。他将其作为个人解释,而非关于 Anthropic 训练方法的已证实信息。
对反复审查仍未完成的改动,他有时让 Fable 判断剩余问题是否值得继续处理。他说 Fable 更愿意认为改动已可交付,这有助于打破小修小补的循环。
在他自己的审查评测中,Fable 有时会漏掉 Sonnet 和 Opus 找到的问题。Browne 说,他检查了遗漏报告,发现其中一些不太重要或不正确,但也承认更宽松的行为可能让真实问题漏过。
Browne 注意到,以模型为裁判的系统可能奖励指出所有问题的审查者。因此他会查看底层评论,而不是单凭分数作出最终排名。
Browne 说,到目前为止,Fable 建议合并的改动都运行正常,但他明确表示这一情况可能改变。他的实际建议是根据风险选择审查者,代理陷入循环时再引入第二种视角。
同频道的其他文章
 29:37EN → 简体中文
 Theo - t3․gg· 2026年11月11日Theo 在 Gemini 4 Carbon 中找到安全用途,日常编码仍有困扰Theo他的测试显示,Carbon 的代码分析错误说法少于 Argon,但延迟与可靠性仍让他更倾向使用其他模型。
 48:20EN → 简体中文Theo - t3․gg· 2026年11月10日Fable 5.2 能力强大,但 Theo Browne 日常编程仍更喜欢 OpusTheo Browne · T3经过一天测试,Browne 比较基准成绩、使用限额,以及仍需人工检查的错误。
 45:21EN → 简体中文Theo - t3․gg· 2026年11月9日Theo:AI 编程时代,维护开发环境成了重要工作Theo Browne · Ping Labs从 Twitch 到 T3 Code,Theo 认为工程师需要消除阻碍智能体的摩擦,并建立有效反馈。
 42:14EN → 简体中文Theo - t3․gg· 2026年11月6日Theo Browne:Claude Code 如何审阅自己的变更Theo Browne · Ping LabsTheo 将 Anthropic 的分层审阅流程与 T3 Code 对比,重点讨论验证、回滚和 agent 审阅的停止规则。
 41:02EN → 简体中文Theo - t3․gg· 2026年11月5日Theo 谈 PewDiePie 的本地 AI 项目、训练数据与模型安全Theo, PewDiePie对 Ajax 和 Odysius 项目的一次视频回应,延伸出自愿提供数据、智能体轨迹、微调和本地模型取舍的讨论。
 31:44EN → 简体中文Theo - t3․gg· 2026年11月3日Theo:用迭代评审改善智能体生成的界面Theo一项 T3 Code 实验利用多个模型评审、截图和反复修改改善界面,同时暴露了主观评分的局限。