30 秒看懂
Theo Browne 说,仔细审查自己的编程智能体使用记录后,他改变了对 Gemini 4 Carbon 的评价:在他使用的可比任务中,它比其他模型慢约五倍。他展示的记录包含四轮完成的审查和五轮被其他智能体提前停止等待的审查,因此这些数字并非普适基准。他认为,每次响应开始前的延迟会在多步骤工作流中累积,并另外提出缓存可靠性和成本问题。一位 Google 代表表示,他们的工作负载没有出现相同的缓存行为。
- 1他根据自己的任务把估计修正为慢约五倍Browne 说,审查可比的编程工作记录后,他发现延迟比此前视频中描述的更大。
- 2单次响应图表遗漏了智能体工作流中的反复延迟他说此前图表只测量较窄的服务器端时间区间,而且许多任务并非多轮智能体运行。
- 3九轮审查中,有五轮在 Carbon 完成前结束他展示的数据包括四轮完成的比较和五轮被停止的运行。他曾指示父智能体不要等待,因此这些运行的完整耗时未知。
- 4每个步骤开始响应前的等待会不断累积在展示的一条编程线程中,画面显示答案开始前平均等待约 11 秒;演示是单个步骤,而非完整任务。
- 5另一项缓存测试显示一个 Gemini 工作负载存在未命中展示的 Gemini 4 Argon 测试中,228 轮有 167 轮完全命中缓存。一位 Google 代表表示,他们的工作负载没有显示相同行为。
要点建议
- 衡量完整的多步骤智能体工作流,包括每次响应开始前反复出现的等待,而不只是服务器端生成时间。
- 被停止的运行属于未完成观察,不能据此确定任务完成本来需要多久。
- 提示词缓存行为和延迟可能因端点及工作负载而异,应在实际使用环境中复现结果。
- Browne 愿意向服务提供商分享提示词和运行记录,帮助诊断问题。
按章节阅读整理后的全文
实际编程工作后的修正评价
Browne 说,自己使用时模型的速度明显低于此前评论中所认识到的水平。他也提出了成本问题。
在此前关于 Gemini 4 Carbon 的视频中,我的评价比自己原本打算的更积极。我重视它在某些安全工作中似乎限制较少,但回顾自己的使用记录后,我认为自己低估了它在编程工作流中的延迟。
在我审查的可比工作中,Carbon 的速度持续比我使用的其他模型慢约五倍。这是我自己任务中的观察,并非经过控制的普适基准。我认为这一差异足以改变我的推荐。
价格也让我担忧:我说该模型的价格计划在 12 月 1 日翻倍。我还想区分模型本身的能力和托管服务的使用体验。DeepMind 的一些人愿意听取反馈,据我了解他们正在处理速度问题。
为什么多步骤运行能显示更多延迟
范围较窄的响应时间图表遗漏了反复等待。他的审查比较包含被父智能体提前停止的未完成运行。
我此前使用的一张图衡量的是服务器接受请求后到响应完成的时间。其中许多任务并非多轮智能体工作流。这种视角遗漏了编程智能体反复发起模型请求和工具调用时会一再出现的延迟。
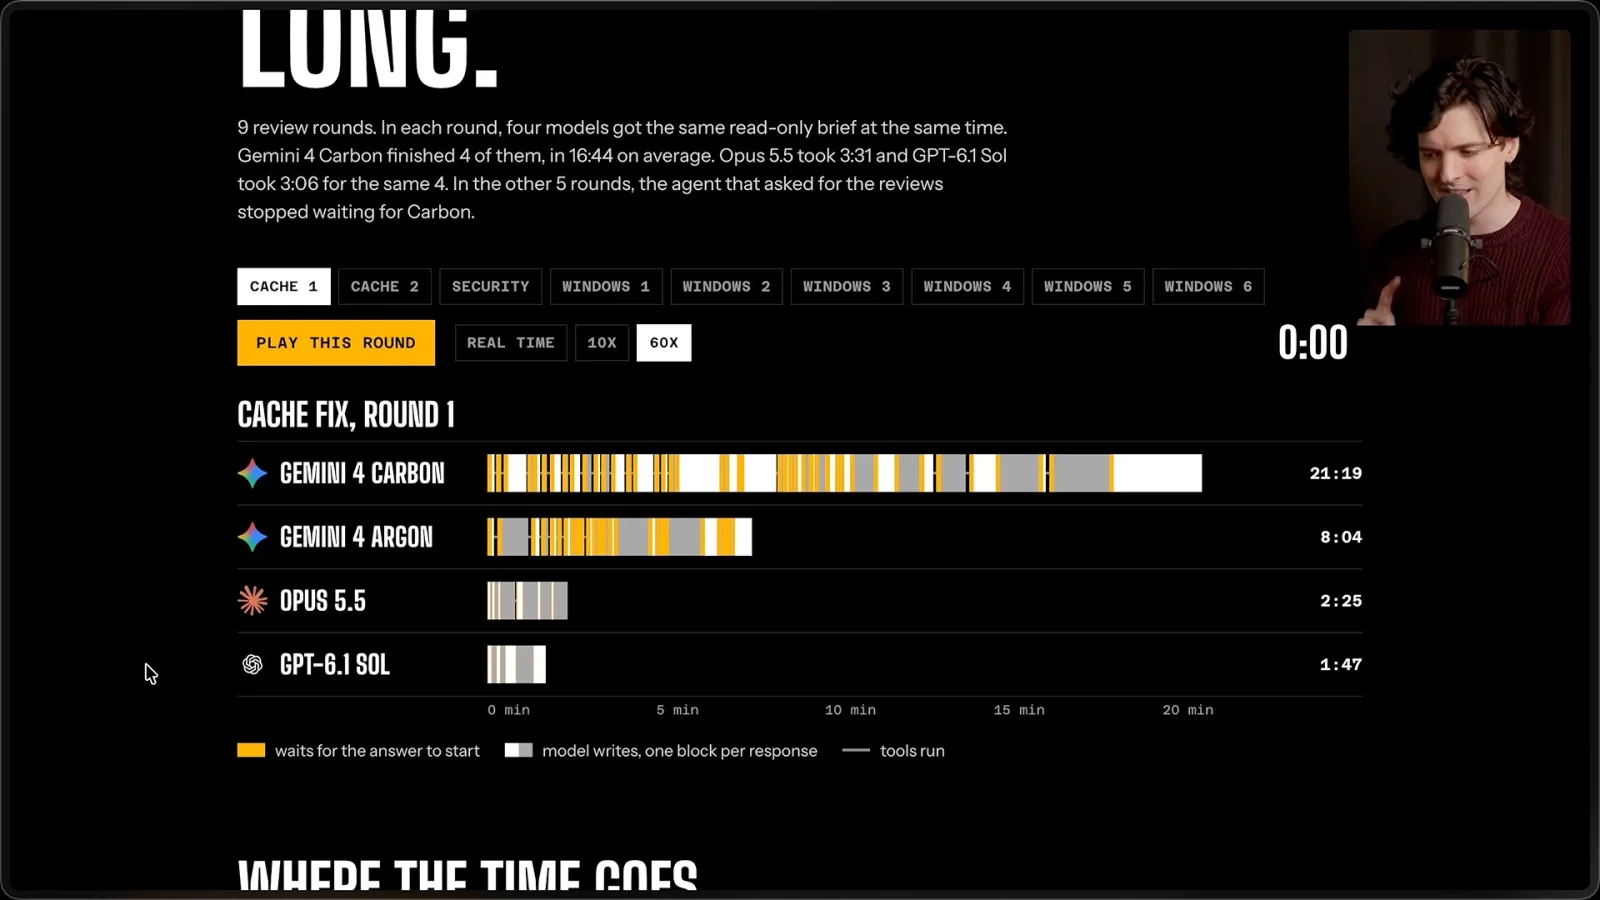
我检查了九轮审查,多种模型在每轮同时收到相同任务说明。画面显示 Carbon 完成了其中四轮,平均用时 16 分 44 秒;在相同四轮中,Opus 用时 3 分 31 秒,GPT-6.1 Sol 用时 3 分 6 秒。其余五轮中,父智能体停止等待 Carbon。
我曾修改智能体指令:如果还有其他工作要做,就不要继续等待 Carbon。这意味着未完成的运行无法告诉我们那些审查完成本来需要多久。我没有等待全部运行结束,因此无法精确测量完整差距。
响应开始之前的等待
Browne 演示单个步骤,并认为反复的启动延迟可能主导更长的编程任务。他将问题与此前的托管延迟问题作比较。
输出速度和工具调用行为都可能造成延迟,但我认为样本中最大的问题出现在响应开始之前。在展示的编程线程中,Carbon 平均需要约 11 秒才开始响应。在许多步骤中重复等待,可能显著延长智能体任务。
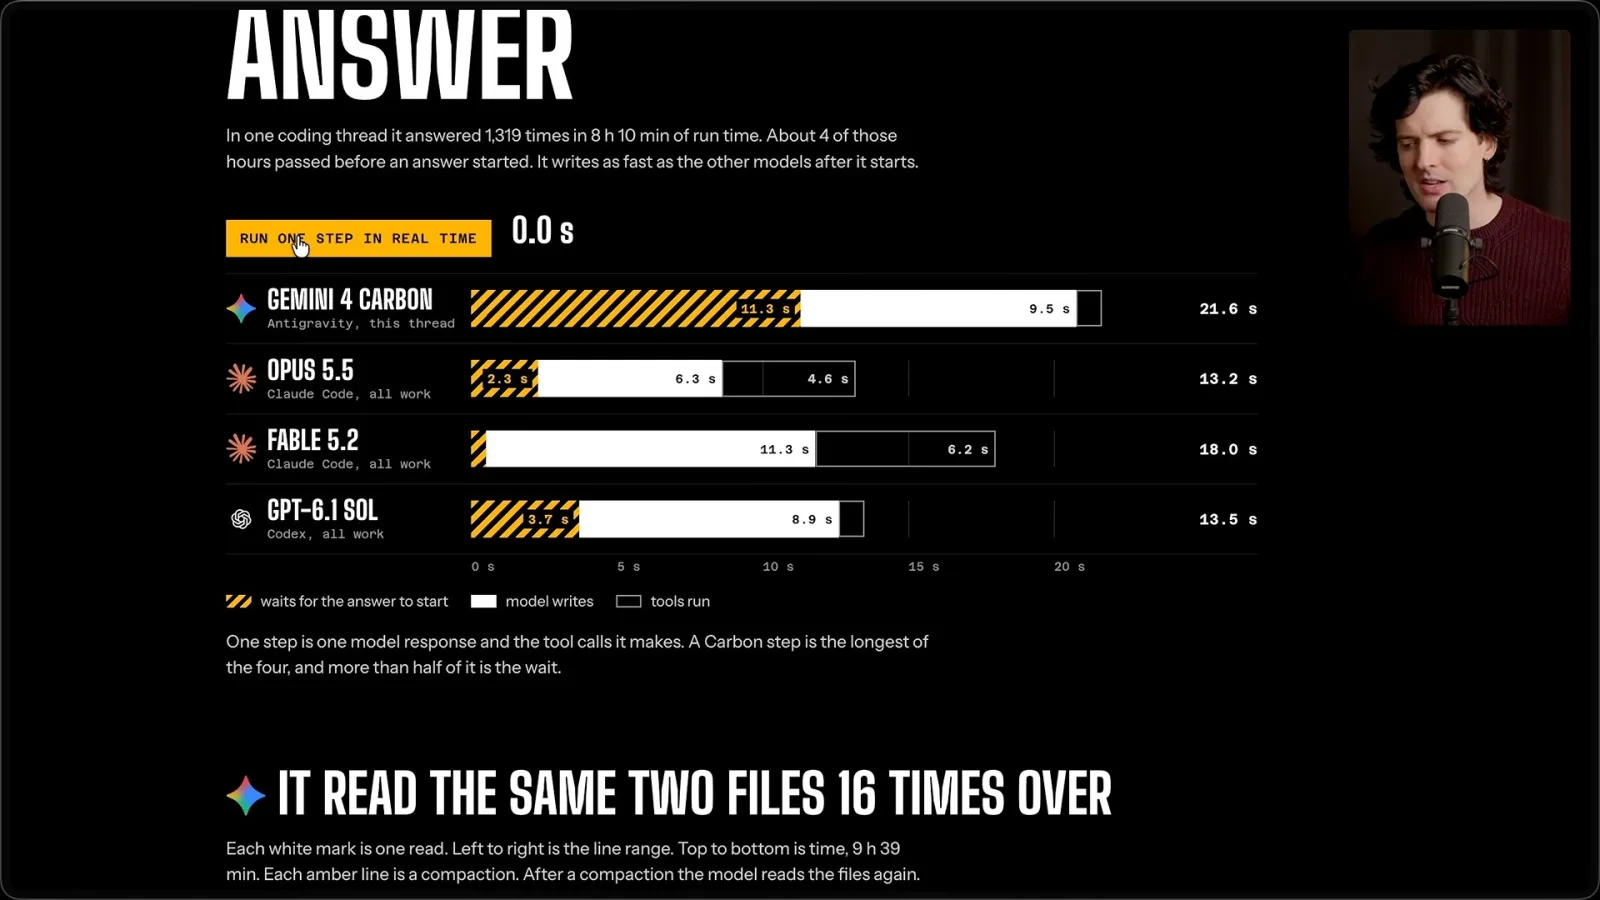
我实时演示了一个步骤,并与其他模型比较。这个例子只是一次响应及其工具调用,并非完整编程任务。我还说,在我的部分工作中 Carbon 需要更多步骤,这会使重复的启动延迟进一步累积。
我以前也见过托管延迟问题:我描述了一段时期,Azure 托管的 OpenAI 模型有时需要比平常长得多的时间才输出第一个词元。我说该问题后来得到修复,也希望 Google 团队获得足够信息来调查这次的问题。
预填充、传输与缓存行为
与 Google 开发者的讨论指出,提示词处理与网络传输是不同的问题。Browne 还介绍了一项缓存测试,以及关于其普遍性的分歧。
在与一位 Google 开发者讨论时,我建议减少重复请求的开销,并将其与另一种编程工具使用的持久连接作比较。对方指出,生成输出前处理长提示词的预填充也需要时间。我同意,仅改变网络传输方式可能无法解决问题。
进一步查看后,我说 Carbon 有时等待开始响应的时间,比另一个模型完成响应的时间还长。我也观察到相同文件被反复读取。两种行为都可能增加任务总耗时,但各自的原因和影响仍需进一步调查。
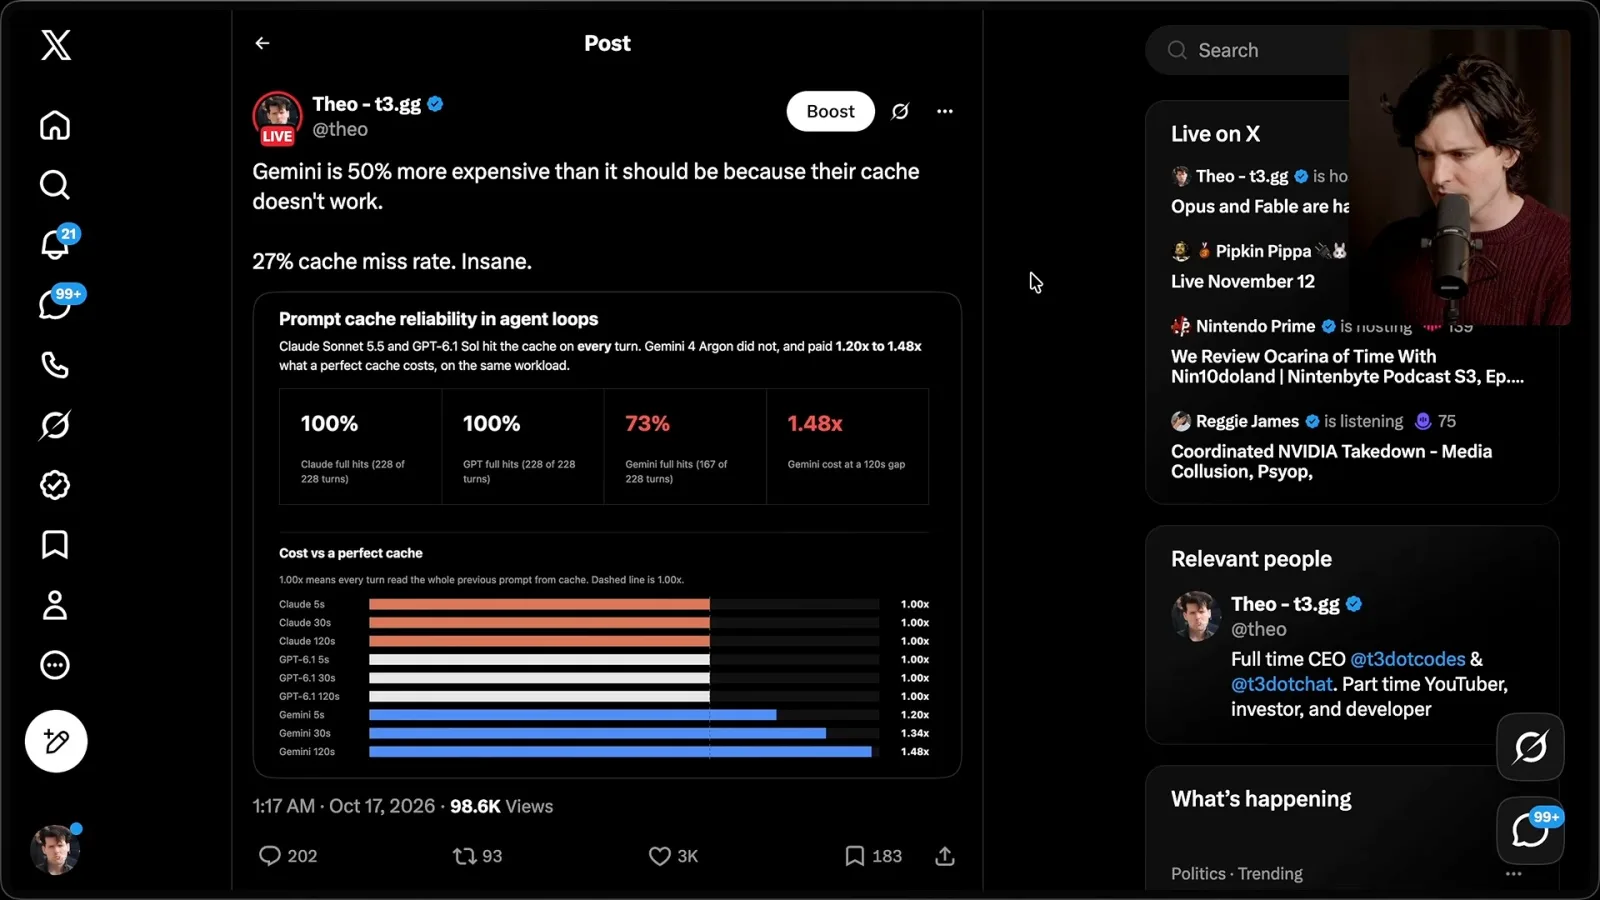
我另外提出提示词缓存问题。画面展示的一项 Gemini 4 Argon 测试中,228 轮有 167 轮完全命中缓存,而展示的其他模型均为 228 轮全部命中。画面估计缓存未命中会增加成本。这是该工作负载的结果,并非每次 Gemini 请求的实测未命中率。
一位 Google 代表回应说,他们的工作负载没有显示相同行为。我表示愿意分享提示词、环境和运行记录,帮助团队复现并修复问题。另一条回应承认延迟与成本之间存在权衡,并表示服务应该做得更好。
端点差异与实际使用决定
Browne 提出集成和端点问题,表示愿意分享数据,并解释为什么目前不把该模型用于日常工作。
我还讨论了用户报告的订阅访问和托管 API 端点之间的差异,以及推理强度出现在模型标识符中造成的集成摩擦。这些报告需要针对具体端点和工作负载评估,不能单独确定我观察到的延迟原因。
我修正后的结论是:对于我目前的编程工作流,延迟、成本和可靠性问题加在一起,超过了我发现的优点。我希望有更多能力强的竞争者,也欢迎改进,但目前不会把这个模型用于日常工作。
同频道的其他文章
 42:19EN → 简体中文
 Theo - t3․gg· 2026年11月13日Opus 还是 Fable?按任务选择编程模型Theo Browne · Ping LabsTheo Browne 比较两种 Claude 模型,解释细致测试与探索性第二意见如何共同解决性能问题。
 29:37EN → 简体中文Theo - t3․gg· 2026年11月11日Theo 在 Gemini 4 Carbon 中找到安全用途,日常编码仍有困扰Theo他的测试显示,Carbon 的代码分析错误说法少于 Argon,但延迟与可靠性仍让他更倾向使用其他模型。
 48:20EN → 简体中文Theo - t3․gg· 2026年11月10日Fable 5.2 能力强大,但 Theo Browne 日常编程仍更喜欢 OpusTheo Browne · T3经过一天测试,Browne 比较基准成绩、使用限额,以及仍需人工检查的错误。
 45:21EN → 简体中文Theo - t3․gg· 2026年11月9日Theo:AI 编程时代,维护开发环境成了重要工作Theo Browne · Ping Labs从 Twitch 到 T3 Code,Theo 认为工程师需要消除阻碍智能体的摩擦,并建立有效反馈。
 42:14EN → 简体中文Theo - t3․gg· 2026年11月6日Theo Browne:Claude Code 如何审阅自己的变更Theo Browne · Ping LabsTheo 将 Anthropic 的分层审阅流程与 T3 Code 对比,重点讨论验证、回滚和 agent 审阅的停止规则。
 41:02EN → 简体中文Theo - t3․gg· 2026年11月5日Theo 谈 PewDiePie 的本地 AI 项目、训练数据与模型安全Theo, PewDiePie对 Ajax 和 Odysius 项目的一次视频回应,延伸出自愿提供数据、智能体轨迹、微调和本地模型取舍的讨论。