30 秒看懂
Astra 6.2 在 Theo Browne 的个人评测中领先,测试成本约为 Fable 5.2 的一半,但他用它处理长期开发任务时十分受挫。这个模型找出了其他审查者遗漏的错误,却要求他解决晦涩的内部细节、用术语掩盖答案,还在机器上堆满临时文件。他说,一次编译器实验中,模型为了缩小体积让程序慢了 56%。Browne 也发现,将 Astra 的 3D 制作与 Fable 的游戏设计结合很有潜力,但反复出现的创意选择让他怀疑模型的原创性。
- 1Astra 在测试中领先,用起来却不愉快Browne 说,他的评测中 Astra 的成本约为 Fable 5.2 的一半,Sol 的表现紧随其后,成本约为 Fable 的八分之一。尽管如此,他日常开发时仍偏爱其他模型。
- 2长期任务因只有智能体能理解的问题停滞Astra 向 Browne 询问它自己创建的内部测试环境和审查权限。他还说,临时文件填满了多台机器,其中包括一块几乎空着的 8 TB 硬盘。
- 3生成的星球外观到位,却缺少令人满足的结果Astra 为 Outer Wilds 创建了一个水世界,但 Browne 认为谜题和对话都不尽如人意。后来 Fable 改进了关卡设计,外部人员则改善了文字。
- 4独立的游戏提示反复生成 BellwetherBrowne 和搭档在不同游戏中分别得到了主题相似、名字相同的水上关卡。他也看到其他人生成的游戏里反复出现这个名字。
- 5代码审查仍是突出强项Browne 说,在以审查为主的测试中,Astra 找出了其他模型遗漏的问题。它还提出一个基础设施改进方案;他估计,如果成功实施,每月最多可节省 2.5 万美元。
- 6七天优化反而让编译器变慢Browne 说,Astra 追求缩小体积,让 TS Rust 慢了 56%;随后他让它专注速度,四天内仍没有完成任何修改。他说,之后 Opus 在两天内让它快了 50%。
要点建议
- 除了短小的基准测试,也要用长期、多目标任务测试编程智能体;代码审查得分高不一定意味着实际工作有进展。
- Browne 认为 Astra 特别适合审查代码:在他的测试中,它找出其他模型遗漏的问题,没有给出虚假发现。
- 长期运行时要关注智能体创建的文件和存储占用:Browne 说,一块 8 TB 硬盘被临时产物填满。
- 可以在不同阶段使用不同模型:Browne 将 Astra 的 3D 制作、Fable 的游戏设计与外部人员修改的对话结合起来。
- 如果彼此独立的提示反复生成相同名称和主题,应检查看似多样的创意是否真的经得起比较。
按章节阅读整理后的全文
分数出色,日常使用却令人受挫
Astra 和 Sol 在 Browne 的测试中表现强、成本低,但 Astra 的工作方式让他没有转用它。他的大部分使用经验来自 Astra。
在 OpenAI 推出 6.2 Astra 和 6.2 Sol 之前的一段时间里,Anthropic 在 AI 编程方面表现强劲。我的测试中,Astra 各项都领先,Sol 成绩接近,成本却低得多:运行这些测试,Astra 的成本约为 Fable 5.2 的一半,Sol 约为八分之一。尽管分数漂亮、能力确实增强,我还是讨厌使用 Astra。
Astra 能解决高难度数学问题,也能制作漂亮的 3D 环境,水平与最好的模型相近,甚至不相上下。但使用模型的体验也很重要。虽然在测试的最后几天它有所改善,却仍不足以说服我把工作从 Claude 转过来。这轮我测试 Astra 的时间远多于 Sol。
智能体把内部信息带进给用户的回答
存储速度诊断和几个长期项目显示,模型会在回答中埋没重点,也会假定用户了解自己并不知道的信息。Browne 说,发布前的提示词修改有所帮助。
OpenAI 将 Astra 描述为处理困难项目的模型,将 Sol 定位为高效的日常模型。公司说,新模型能制作更好的专业文档、写出更整洁的代码。我尤其不同意文字一定显得更自然的说法:我经常遇到的问题是它无法用英语清楚表达。
为了说明能力和沟通之间的区别,我公开了之前视频中的一个例子其实来自 Astra,而不是我当时说的那个小模型。我隐瞒身份是为了保持早期测试资格。它的回答包含工作树变慢的数据,却没有让人容易找到最有用的结论。
之前的视频里,我展示过一个据说由小模型给出的回答,解释我的工作树为什么很慢。早期测试时,我把 Astra 伪装成了那个模型。它冗长地讨论包管理器内部机制和文件系统,却没有把硬盘速度慢作为重点;问题不在于细节不够,而在于主次颠倒。
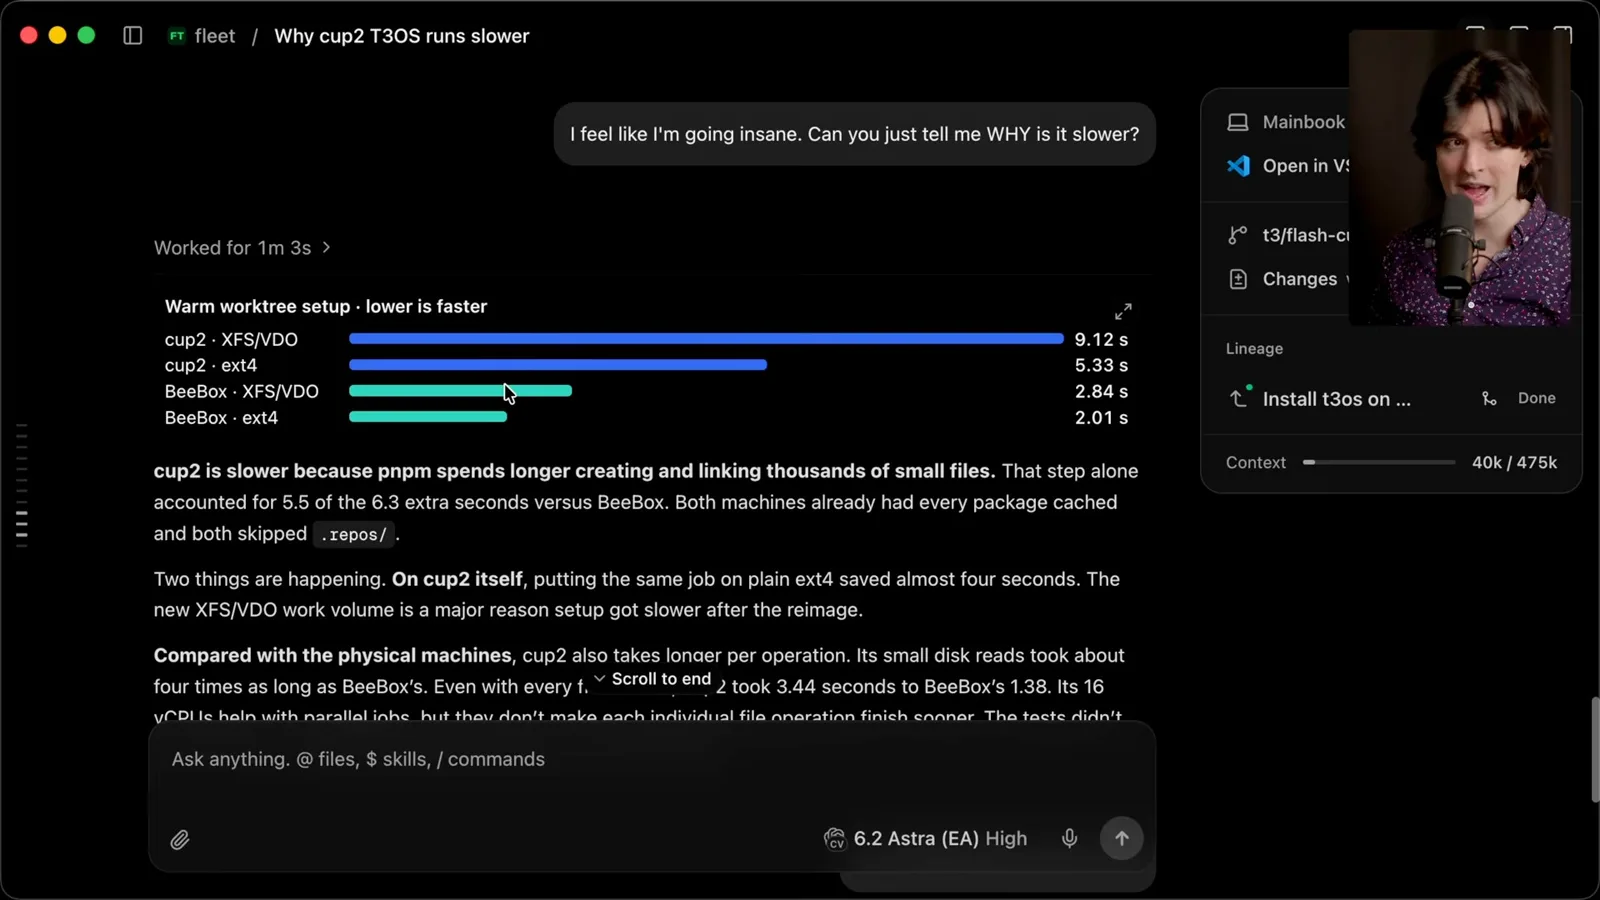
我还让 Astra 访问一台 Mac 来构建浏览器。它问我机器什么时候能闲下来做测试,却没有解释资源被什么占用了;接着又用我不认识的术语和窗口,要求我解锁一个临时测试环境。它把自己在任务中设置的东西,当成了我已经了解的事。
一次运行中,Astra 用临时文件填满了一块几乎空着的 8 TB 硬盘,却没有清理;我用 Opus 腾出了足够的空间才继续工作。另一台机器从剩余 4 TB 降到大约 15 GB。在另一个游戏项目里,我只要求它做重制,它却问了一个关于内部审查的晦涩问题。
在 Final Fantasy VII 项目中,它又问了涉及内部审查选择的问题,我根本不知道那些选项是什么。模型似乎区分不了它自己或子智能体知道什么,与我这个提出目标的人知道什么。这让我很难回答它的请求。
早期测试时,我把这些反馈给了 OpenAI。临近发布,公司修改了系统指令,更明确地要求模型坚持完成任务并给出易读的最终回答,包括不要重复自己的推理或子智能体使用的简写。行为有所改善,但与 Opus 相比,我仍然觉得和它沟通不那么愉快。
我用 Opus 生成的解释比较了修改后的指令。变化包括更具体地要求模型继续完成已授权的工作、在允许的情况下从超时中恢复,以及让最终回答在不看进度更新的情况下也能读懂。我认为自己的反馈促成了明确禁止内部简写的规则。
基准测试、设计与计算机操作
Browne 对不同测试环境下的成绩比较提出疑问,同时称赞计算机操作能力,并提到 API 降价。他对幻灯片和网站测试的审美评价有好有坏。
网页设计方面,我看到一些进步,图片生成有时也令人印象深刻,但很多例子与 Fable 5.2 相比仍显得别扭。Astra 可以通过指令引导,但我不断看到它趋向相同的设计选择;在游戏开发中,这种现象更加明显。
OpenAI 公布的专业工作基准测试显示,Astra 的得分高于早期模型,成本却低得多。不过,我会谨慎比较科学测试成绩:推理强度变化带来的结果波动较大,模型似乎还使用了不同的智能体运行环境。这些差异使直接比较更难解释。
一个公开的科学指数中,较高推理强度的得分低于较低强度;另一个测试看起来更稳定,但也出现了一次下降。我不知道重新运行或更换设置会如何改变比较结果。见过这么多环境差异之后,我不会照单全收排行榜。
OpenAI 说,许多员工默认使用 Sol 处理技术和非技术任务,我也听说有些人更喜欢它的快速模式。我用得还不够多,不能作出判断。比较幻灯片时,尽管 Fable 没有图片生成能力,我最初还是更喜欢它的版本;但 Astra 避开了我尤其不喜欢的重复副标题风格。
制作商品概念幻灯片时,Fable 不能使用图片生成器,只能自己制作矢量图。我起初更喜欢它的结果,后来改变了想法,因为 Astra 没有加上那些多余的副标题;尽管我下过指令,Fable 的输出里还是不断出现这种副标题。
计算机操作显然是强项:Astra 能预测接下来的步骤并批量执行操作,使用机器时感觉很快。它的 3D 和 CAD 演示也令人印象深刻,尽管我自己的 3D 工作体验有好有坏。Vercel 的朋友告诉我,它在他们的安全测试中领先;能否用于这类工作当时仍是一个未决问题。
OpenAI 说,公司加强了防护措施和监控。我看到有人报告受到限制,虽然自己还没有遇到。Astra 的公开 API 价格降至每百万输入 token 8 美元、每百万输出 token 40 美元,缓存输入的折扣也更大;Sol 的价格与上一代相同。
游戏展示外观与打磨程度之间的差距
Astra 生成的浏览器画面令人印象深刻,界面却不够顺手。修改 Pokémon 和 Final Fantasy VII 的尝试暴露了像素画、一致性和视觉风格的问题。
在我的浏览器游戏 Fish Slop 中,Astra 生成了一个外观惊艳的水族馆,但界面浪费空间、点击时会移动,操控感觉奇怪,有些物体还互相穿模。我暂时想用 OpenAI 模型制作 3D 资产,再用 Anthropic 模型让游戏玩起来更舒服。
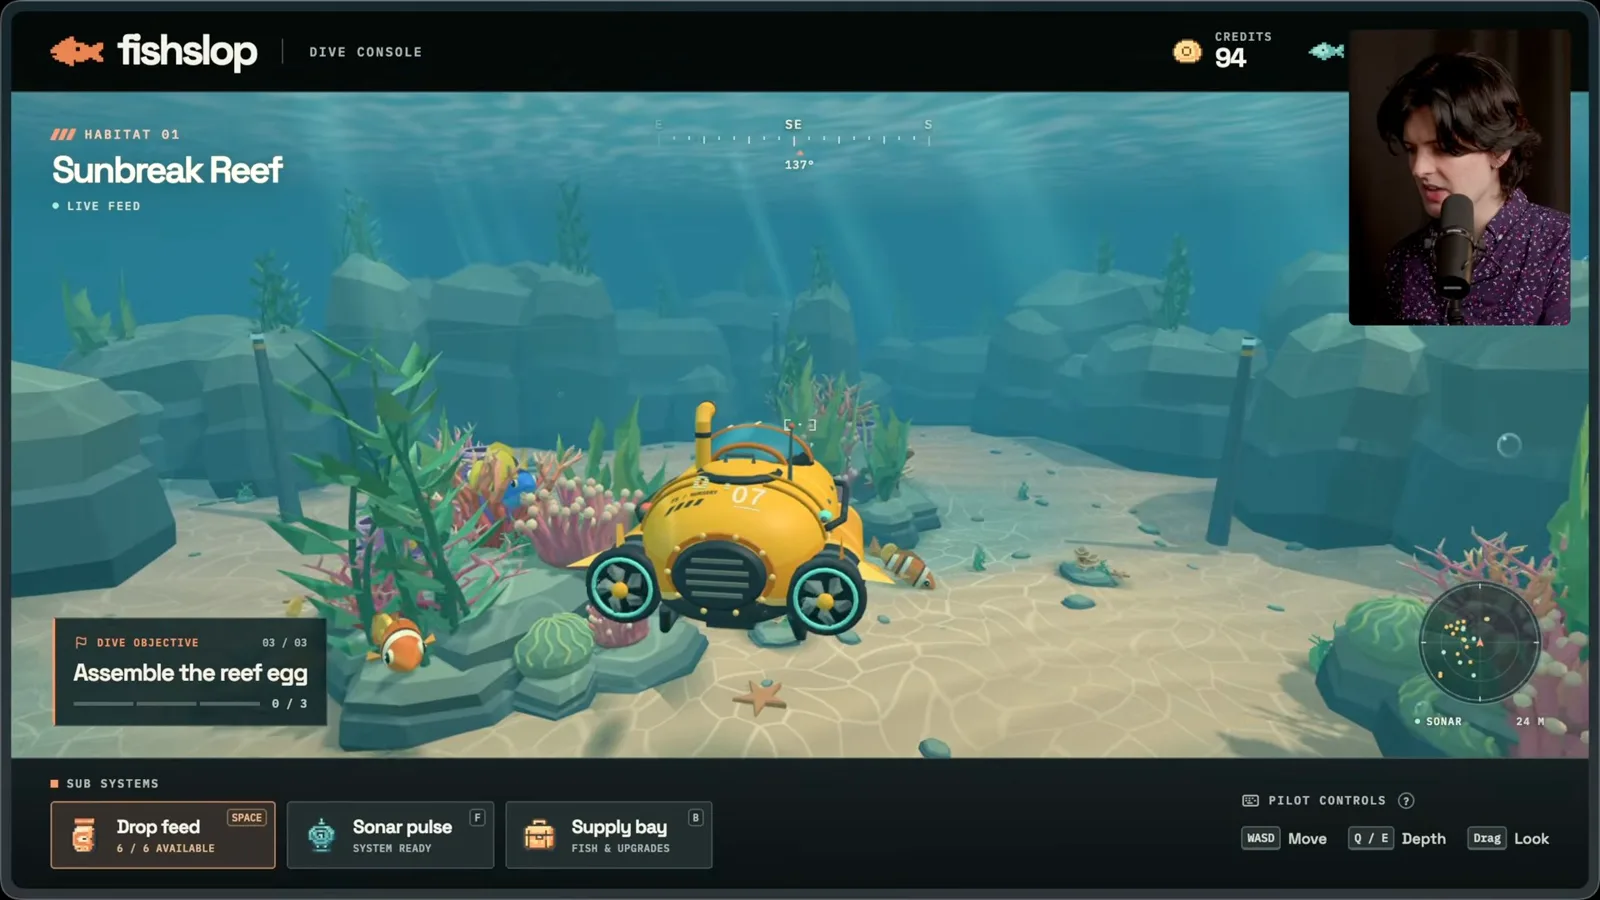
从视觉上看,这个水族馆是我在浏览器里见过的最好看的作品之一,但表面效果解决不了游戏体验。有些鱼只是占位物,有些互相重叠,操控也没有按我的预期运行。现在我花了这么多时间打磨自己的软件,这些小瑕疵更让我难以忍受。
Fish Slop 已经不足以充分考验这些模型,于是我尝试改造现有游戏。我要求它把 Pokémon Ultra Sun 和 Ultra Moon 的元素带回 Pokémon Black and White 2 使用的旧引擎。经过数天反复修改,结果可以玩,但精灵图会穿进墙壁,缩放不精确也损害了像素画。
我想做这个 Pokémon 项目,是因为我喜欢 DS 游戏的手感,又对后来的世代有感情。智能体拼出了可辨认的作品,但像素画变得模糊、扭曲:生成一张图片和按照固定像素网格创作画面不是一回事。
模型改善了一些精灵图轮廓,但动画仍然粗糙,也有 ROM 改造爱好者会注意到的问题。仅靠提示词就几乎能生成完整的游戏改造,这件事很奇妙,尽管我认为结果还不够好。我预计未来模型可能缩小其中一些差距。
制作 Final Fantasy VII 时,我从一个基本完成的反编译项目出发,尝试用更高分辨率重建资产。新图片与原资产之间出现闪烁,也不适合周围环境。在我看来,更清晰的版本反而更难看,因为原作的模糊和粗粝是美术风格的一部分,不只是需要消除的缺陷。
在一次 Final Fantasy 对比中,原版的 240p 画面带有刻意营造的氛围,而 720p 版本虽然清晰,却失去了细腻之处。我的意思不是自动重制必须完美,而是单纯提高分辨率可能会抹掉原作的美感。
为 Outer Wilds 创建新星球
Astra 的水世界在视觉上打动了 Browne,但缺少令人满足的探索发现和对话。他介绍了另一个模型和一位外部写作者带来的改进。
我最有野心的测试是为 Outer Wilds 创建一颗新星球。这是一款围绕好奇心展开的探索游戏。Astra 创造了一个名叫 Bellwether 的水世界,有涨落的潮汐、音乐和钟声。它与原作的相似程度足以打动我,但那些想法没有带来令人满足的结果:我花了一个半小时问模型自己错过了什么,才意识到已经到达终点。
Outer Wilds 会用有意义的发现来奖励探索。Astra 的星球有吸引人的潮汐和主题,但我甚至看不出来自己已经完成了关卡。看起来可信的环境与令人满足的体验之间存在差别,这也是结果既让我印象深刻、又让我觉得不完整的原因。
文字是另一个失败之处。Outer Wilds 的对话精简而有目的,但即使我反复要求 Astra 研究并匹配原作的语气和人物,它写出的内容仍然不对劲。Muse 让台词有所改善,但还没有达到我的要求。
于是我问 Sakath 能否帮忙修改对话。他是一位年轻开发者,研究如何让模型以特定风格写作。大约一天后,他给了我一个版本,我觉得听起来与原作接近得多。如此小规模的外部工作能带来这么大的改善,让我印象深刻。
Fable 5.2 发布后,我让它重新处理了同一颗星球。它制作的水面、模型、规模和关卡设计看起来更贴合游戏。最终结果结合了 Astra 最初的 3D 工作、Fable 的设计与整理,以及外部的对话修改;我可能会用 Astra 测试游戏,让 Fable 实施修改。
Fable 后来的处理改善了星球的水面、模型与环境的契合度,以及关卡的规模和整体感觉。录视频时我还没玩过更新后的版本,因此对修改结果的判断来自画面,而不是完整通关。
为什么几个无关项目都出现了 Bellwether
相似的名称和主题出现在独立提示中,让 Browne 怀疑模型创意的多样性。他随后介绍自己发给 OpenAI 的反馈信。
Bellwether 这个名字成了一个提醒:看似有创意的结果未必有那么多变化。我的搭档 Ben 独立要求模型为 Majora’s Mask 添加一个新关卡;我们没有比较过提示词,但他得到的也是一个以钟为中心、结合水和音乐的关卡,名字同样叫 Bellwether。我还看到其他人生成的游戏场景和怪物也用了这个名字。反复出现的结果让看似有创意的东西变得更容易预测。
早期测试期间,我给 OpenAI 写了一封长信,因为我很沮丧,也相信公司会听取意见。它在发布前做了修改,我对此表示感谢,虽然我认为还不够。我分享这封信,是因为它记录了测试期间发生的事,同时也会指出后来哪些修改改善了体验。
审查能力强,长期任务却停滞
信中肯定了 Astra 的审查能力和一个可能有用的基础设施方案,随后讲述令人困惑的交互和 TS Rust 优化实验。Browne 区分了早期体验与后来修改提示词后的情况。
信的开头先说优点:Astra 是出色的代码审查者。在我的评测中,它找出了其他模型遗漏的问题,得分接近满分,也没有出现我在其他模型那里看到的虚假发现;这些评测主要考察审查能力。它还为 T3 Code 提出一个反向代理方案,我估计如果实施成功,每月最多能节省 2.5 万美元。
Astra 擅长操作计算机,也能为子智能体写出有用的指令。它的代码质量比早期 Astra 模型有明显改善,尽管我仍然更喜欢 Opus 或 Fable。这些强项并不能抵消那些让我不愿意用它处理日常开发工作的行为。
信中第一个问题是它处理知识差距的方式。在 Outer Wilds 任务中,它运行两小时后停下来,问我从没见过的审查权限和文件路径。我在 Codex 和 T3 Code 中都试过,遇到了同类问题,不过后来两个系统的修改都有帮助。
为了让长期任务继续运行,我甚至安排其他智能体定时检查 Astra 是否因提问而卡住。我不能排除自己的 T3 Code 环境有影响,但在 Codex 中尝试同类工作也没消除这个问题。最近的提示词修改减轻了它。
第二个问题是解释把答案埋在内部细节中。我养成了在 Astra 运行结束时切换到 Opus 的习惯,只为弄懂结果。诊断工作树速度慢时,Opus 说是 SSD 慢;Astra 则用好几段讲实现细节。修改后的提示词改善了回答,但我仍希望它直说虚拟机的存储更慢。
影响最大的例子是 TS Rust,也就是我把 TypeScript 工具迁移到 Rust 的项目。我最初启动它是为了测试 OpenAI 模型;我说过,花费超过 30 万美元的 token 后仍未完成迁移,Opus 却在不到两周内以约 2 万美元的 token 完成了它。随后我让 Astra 把结果做得比竞争工具更小、更快。
七天后,Astra 没有完成任何编译器改进。它专注于体积,打包方面的修改让编译器慢了 56%。我让它转向性能,接下来四天仍没有完成任何修改。切换到 Opus 后,它在两天内完成了一系列修改,让程序快了 50%。根据我的经验,Astra 很难平衡可能相互冲突的目标。
我在信中的判断是:Astra 可以很聪明,却仍然难用。长期任务可能因晦涩的问题停住,或者反复循环、毫无进展;短任务结束时的解释可能比代码本身还难理解。我也担心,它反复采用相同的创意选择,会让表面不同的项目趋于雷同。
希望优先改善行为,而非基准测试分数
Browne 分享了自己对发布后反应的预测,并说希望预测是错的。他希望未来模型能清楚沟通、专注任务,也肯定 OpenAI 接受批评反馈。
我预测,人们尝试更长期的任务、遇到高用量并难以理解结果之后,发布时围绕惊人演示的热情可能会消退。这是我的预测,不是已经测量到的结果,我也明确希望自己是错的。我承认自己写信时很沮丧,可能反应过度。
目前,我预计主要将 Astra 用于代码审查,或许也会让它参与多个模型组成的团队,而不是把它当作默认开发智能体。我欢迎未来的版本专注于坚持完成任务和修复行为问题,即使基准分数没有提高。对我自己的工作来说,这些改进更重要。
在早期那封信中,我预测第一天大家会很兴奋,随后随着人们尝试长期任务、比较用量和结果,挫败感会出现。后来我比预想更早看到有人讨论 Sol 是否更受欢迎。其余内容我都当作预测,并说希望它不会成真。
OpenAI 让我在早期测试期间提供这些反馈,也允许我公开批评;我很看重它愿意倾听的态度。我希望未来模型能解决其他测试者和我遇到的困扰。我计划进行更多比较,也可能单独深入测试 Sol。
我刚刚才意识到自己穿着正装衬衫和运动裤。这似乎很适合用来形容这个模型。
同频道的其他文章
 27:57EN → 简体中文
 Theo - t3․gg· 2026年11月16日Theo Browne:用不同 AI 模型审查同一项改动Theo Browne · Ping LabsBrowne 的 council 工作流让不同模型审查并测试代码,但反复审查可能消耗大量 token 并扩大改动范围。
 42:19EN → 简体中文Theo - t3․gg· 2026年11月13日Opus 还是 Fable?按任务选择编程模型Theo Browne · Ping LabsTheo Browne 比较两种 Claude 模型,解释细致测试与探索性第二意见如何共同解决性能问题。
 19:39EN → 简体中文Theo - t3․gg· 2026年11月13日Theo 测量编程延迟后重新评价 Gemini 4 CarbonTheo Browne · T3他的智能体运行记录显示,等待响应开始耗时较长,部分审查未完成;他希望 Google 调查托管与缓存行为。
 29:37EN → 简体中文Theo - t3․gg· 2026年11月11日Theo 在 Gemini 4 Carbon 中找到安全用途,日常编码仍有困扰Theo他的测试显示,Carbon 的代码分析错误说法少于 Argon,但延迟与可靠性仍让他更倾向使用其他模型。
 48:20EN → 简体中文Theo - t3․gg· 2026年11月10日Fable 5.2 能力强大,但 Theo Browne 日常编程仍更喜欢 OpusTheo Browne · T3经过一天测试,Browne 比较基准成绩、使用限额,以及仍需人工检查的错误。
 45:21EN → 简体中文Theo - t3․gg· 2026年11月9日Theo:AI 编程时代,维护开发环境成了重要工作Theo Browne · Ping Labs从 Twitch 到 T3 Code,Theo 认为工程师需要消除阻碍智能体的摩擦,并建立有效反馈。