30 秒看懂
餐厅智能体可能推荐一家评分很高的店,却无法满足有过敏、饮食或时间限制的客人。Annie Wang 演示如何直接检查需求,而不是枚举所有有效答案:自定义 ADK 指标按需求全部得到满足的人所占比例评分,只有达到 1.0 才通过。她用已知答案测试评估器,检查一次刻意设置的失败运行,并在 pytest 和 CI/CD 中复用评估配置。
- 1好的餐厅计划要满足每位客人,而不只是评分高群组可能有饮食、过敏、预算或时间方面的要求。不同推荐都可能有效。
- 2需求检查器可以接受参考集中没有列出的答案检查器根据群组需求评估提出的计划,无须事先写出每一家可接受的餐厅。
- 3评估依据与检查方法应分开选择比较器使用参考答案,检查器使用具体要求;两者都可以使用确定性代码或模型裁判。应通过审阅过的例子评估模型裁判。
- 4按需求全部满足的客人比例评分,并要求达到 1.0everyone_ate 指标中,6 位客人有 3 位满意时得分为 0.5。通过阈值为 1 意味着计划必须适合所有人。
- 5信任评估器之前,先用已知答案测试两份有效计划都应通过,满足 6 人中 3 人的计划应失败,不完整答案也应失败。
- 6在 pytest 中运行同一评估,并将其设为部署检查测试复用案例集和完整评分配置,其中包括自定义指标的注册。
要点建议
- 根据用户的限制条件定义成功;当顺序很重要时,也要评估工具操作。
- 当许多不同答案都可能有效时使用需求检查;其他情况下,参考答案比较仍然有用。
- 无论评估使用参考答案还是具体要求,都可以独立选择确定性代码或模型裁判。
- 用已知通过、失败和不完整的答案测试评估器,再用它判断智能体。
- 重复测试案例,保留新发现的失败,并在部署流程中运行检查。
按章节阅读整理后的全文
为结果与智能体行动定义成功
餐厅推荐必须满足每位客人;对使用工具的智能体,可能还需要评估行动顺序和记忆。
Annie Wang 演示如何为 AI 智能体定义成功、选择评估方法、构建并测试自定义评估器,并在开发和部署期间运行。示例是一个为一群人推荐餐厅的智能体。
附近一家评分很高的餐厅未必是成功的推荐。有些客人可能吃素、有过敏症、预算有限或需要提前离开。真正的要求是制订适合所有人的晚餐计划。
由于语言模型每次运行的回答可能不同,同一请求可能产生不同的计划。只要都满足这群人的需要,两份计划都应通过。如果智能体有查看菜单或预订餐位的工具,评估还可以检查它是否在预订前确认了饮食需求。
这些行动的顺序构成智能体的轨迹。在多轮对话中,评估可能还需要检查智能体是否记住了较早提出的限制条件。首先要决定评估最终计划、生成计划所采取的步骤,还是两者都评估。
Google 的 Agent Development Kit(ADK)提供内置评估指标。回答可以按措辞与已核验的参考答案比较,也可以由语言模型比较含义;工具调用则可以与预期调用、参数和可调整的顺序要求进行比较。
与参考答案比较,或检查具体要求
ADK 提供基于参考答案的指标,而需求检查可以接受任何满足群组需要的计划。代码和语言模型裁判是两种方法都能使用的实现选择。
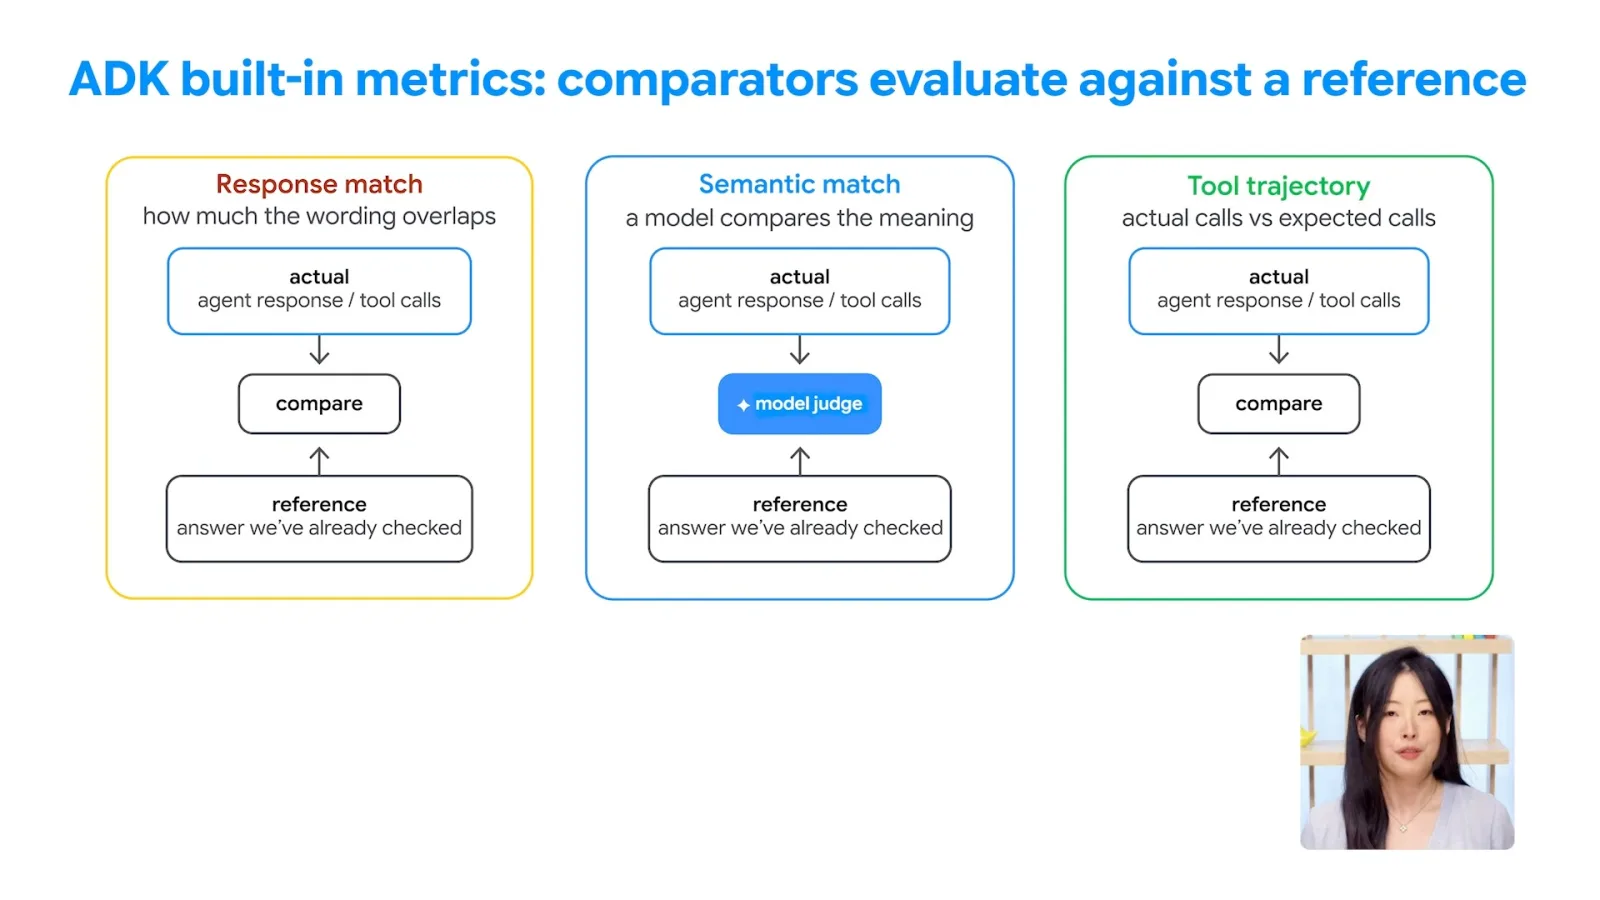
这些基于参考答案的检查称为比较器。黄金数据集将测试请求与可信答案配对,但适合一组人的餐厅计划可能不适合另一组人;即使面对同一组人,也可能有多个可接受的选择。
检查器则根据明确要求检验提出的计划。对于晚餐智能体,它可以利用这群人的需求和餐厅信息检查菜单、价格与时间。任何满足要求的计划都可以通过,无须事先列入批准答案的清单。
选择以什么为依据评估,与如何实现检查是两个独立决定。确定性规则可以在素食客人没有合适菜品时判定计划失败,并对相同事实给出相同结果。另一种方式是让语言模型根据评分标准和提供的餐厅事实判断计划。
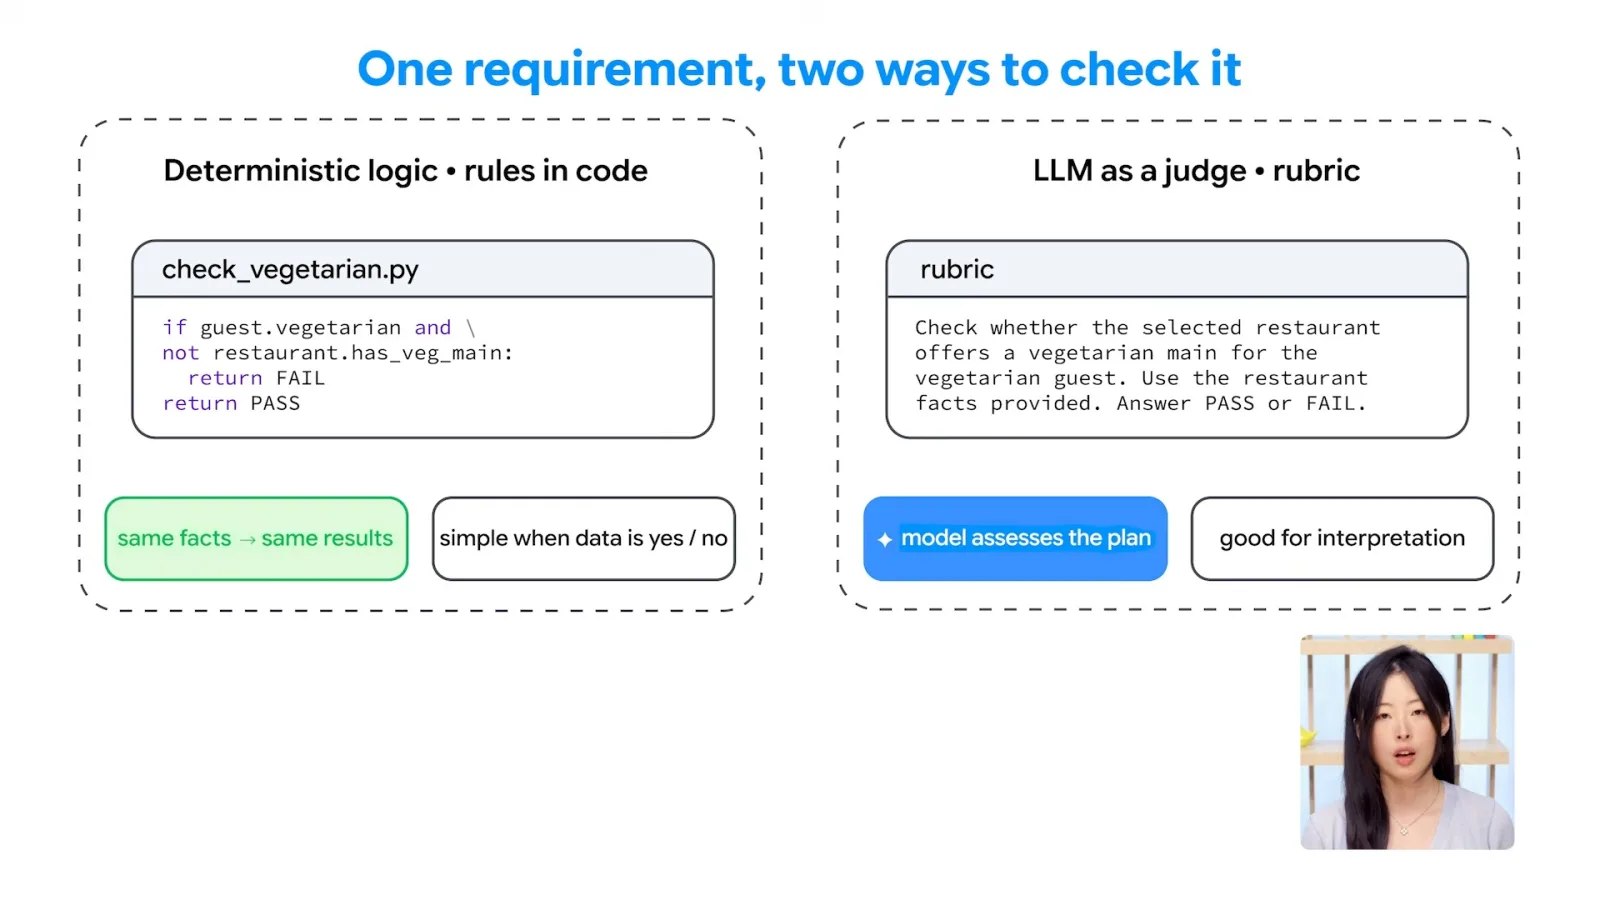
对于简单、结构化的是非事实,用代码检查很直接。模型裁判可能有助于判断清晰度等需要解释的要求,但也应该用人工审阅过的例子检验它的判断。ADK 内置针对回答、工具使用和多轮对话的评分标准模型裁判。
构建并验证 everyone_ate 指标
自定义 Python 指标按需求全部得到满足的人所占比例评分,阈值为 1。用已知通过、失败和不完整的计划测试评估器本身。
在演示中,Wang 使用 Python,因为客人和餐厅信息已经结构化。智能体预先收到固定信息,然后提出一家餐厅和一个时间。检查涵盖每个人适用的饮食需求、过敏情况、预算、距离、口味辣度偏好和时间限制。
只有满足某个人的全部要求,计划才算对这个人成功。自定义指标 everyone_ate 用满意的人数除以总人数:6 人中满足 3 人得分为 0.5,满足全部 6 人得分为 1。通过阈值设为 1,评估器还会记录失败原因。
ADK 调用自定义 Python 指标时会传入已记录的交互和评估设置。函数读取群组 ID,获取对应需求,并解析智能体的 JSON 提案,找出餐厅和时间。
评分前,评估器先检查两个字段是否存在且有效。餐厅未知或缺少时间都会导致失败,评估器不会替智能体编造计划的一部分。函数执行检查,将分数与阈值比较,再返回总体和各轮评估结果;逐人说明写入单独的详情文件。
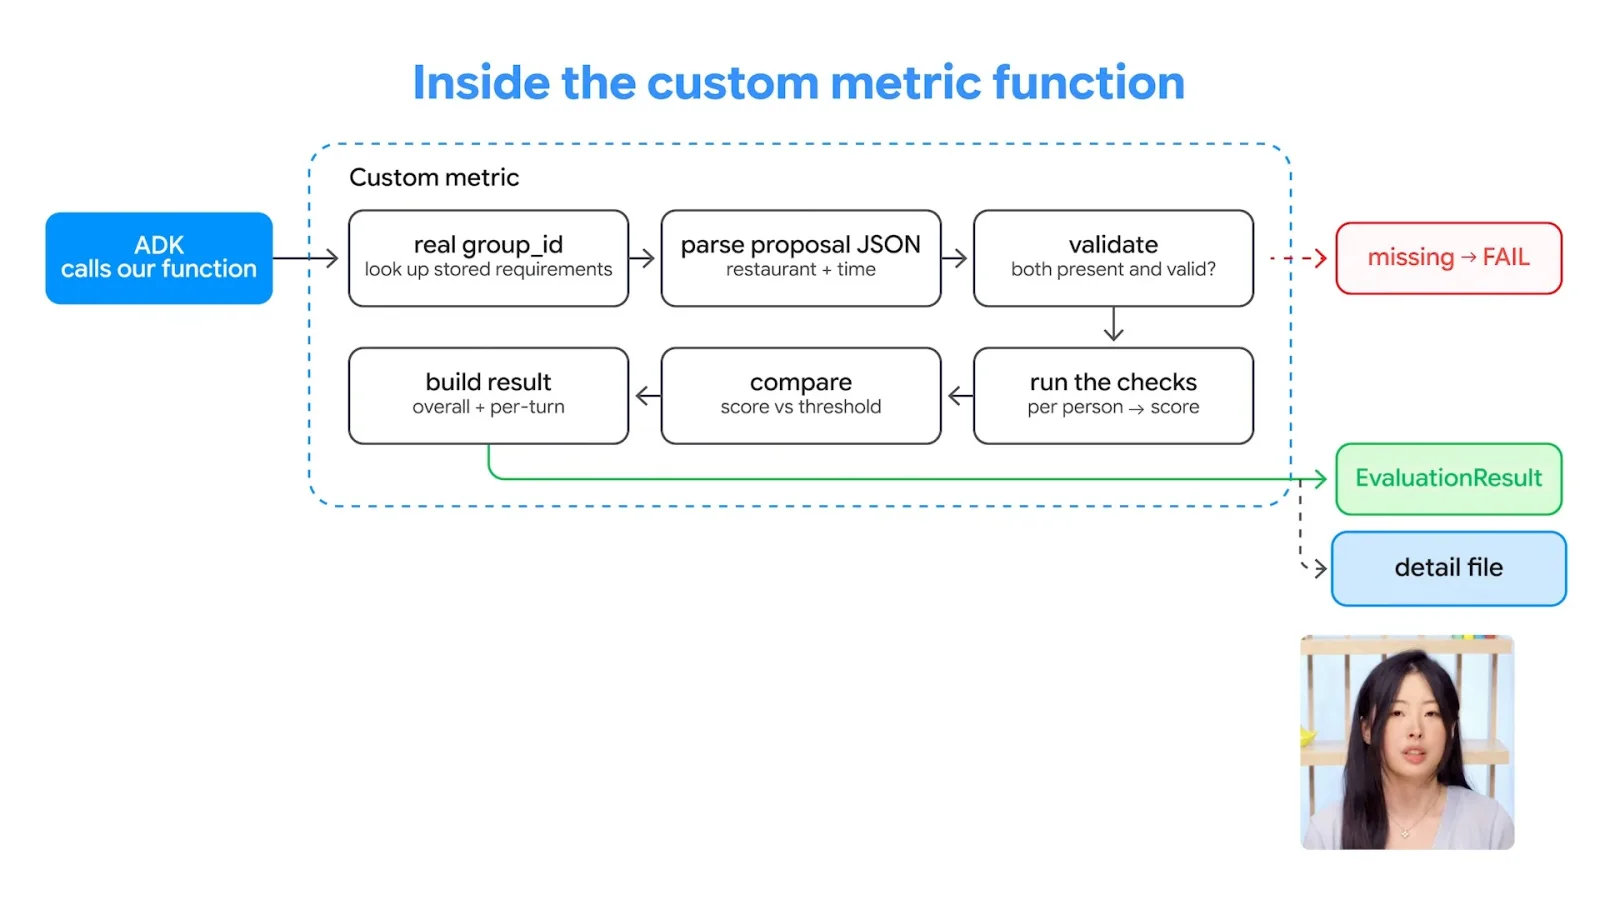
评估配置 JSON 选择 everyone_ate、设置阈值并指定 Python 函数。将评估器用于智能体之前,Wang 先测试结果已知的答案:满足 6 人中 3 人的计划应得 0.5 分且失败;两份不同的有效计划都应得 1 分并通过;不完整的答案也必须失败。
运行评估并从失败中学习
演示中优先考虑评分的智能体只满足了 6 个人中的 3 人。Wang 建议使用稳定标准比较版本,重复重要案例,并保留新发现的失败案例。
adk eval 命令接收智能体、评估配置,以及包含测试请求的评估集 JSON。ADK 运行选定请求,然后将记录的交互传给检查器。
在刻意设置了缺陷的演示中,智能体优先考虑评分,选择评分最高的餐厅。详情文件指出素食、过敏和时间方面的问题;计划只满足 6 人中的 3 人,得分 0.5,低于阈值 1,因此评估失败。
Wang 建议调查智能体为何偏重评分,修改其指令或代码,再使用相同案例和成功标准重新评估,以比较不同版本。重复重要案例以检查一致性,增加需求组合不同的群组,并保留部分案例以检查泛化能力。
把新发现的失败保存为未来测试案例。在 adk web 浏览器界面中,注册自定义指标,从 Eval 选项卡选择晚餐案例和 everyone_ate,将阈值设为 1,再检查结果和被评估的对话。
在 pytest 和 CI/CD 中运行智能体评估
测试复用评估集和评分配置,其中包括自定义指标。它可以成为部署前必须通过的检查。
pytest 测试可以复用存放案例的评估集 JSON 和用于评分的配置 JSON,其中包括自定义指标的注册信息。测试加载完整设置,从 Python 调用 ADK 的 AgentEvaluator;随后 pytest 报告评估是否通过。
同一个 pytest 命令可以成为部署前必须通过的 CI/CD 检查,让评估失败的版本无法部署。Wang 总结了四个步骤:定义成功、选择检查什么及如何检查、用已知答案验证评估器,以及随着智能体变化反复运行评估。她补充说,这类检查以后还可以指导智能体自我改进。
同频道的其他文章
 23:57EN → 简体中文
 Google Cloud Tech· 2026年11月10日让 AI 构建的应用更容易调试的六个前端概念Devin Chasanoff · Google CloudDevin Chasanoff 用交互式游戏追踪器说明数据存放位置、计算值和组件之间的通信。
 41:04EN → 简体中文Google Cloud Tech· 2026年11月9日Google 如何测试 Gemini 4,并用智能体维护代码Tulsee Doshi, Smitha, Rody Davis, Luke, Mollie, Billy, Annie · Google DeepMindTulsee Doshi 介绍分阶段发布和长时间任务;演示则用子智能体审查 Web、Android 和 iOS 代码。
 17:27EN → 简体中文Google Cloud Tech· 2026年11月9日修复混乱应用:先定义状态,再向智能体下指令Devin Chasanoff · GoogleDevin Chasanoff 先梳理健身界面的状态、转换和测试,再让智能体修改应用。
 11:59EN → 简体中文Google Cloud Tech· 2026年11月3日用两个 AI 智能体把原型变成前端设计规范Devin Chasanoff · GoogleDevin Chasanoff 将规划和文档记录分开,让 Gemini 在应用开发前帮助用户完成设计。
 11:16EN → 简体中文Google Cloud Tech· 2026年10月29日让 AI 智能体动工前,先核对规范并设置检查点Devin Chase · GoogleDevin 演示如何发现需求冲突、比较默认假设与建议,并制定分阶段实施计划。
 12:26EN → 简体中文Google Cloud Tech· 2026年10月28日让 AI 智能体拥有两种长期记忆Annie Wang · Google CloudAnnie Wang 区分精确事实与语义偏好,并让较慢的记忆提取避开实时语音的关键路径。