30 秒看懂
Google DeepMind 的 Tulsee Doshi 说,Gemini 4 开发采用了频繁的内部测试,并在广泛开放前分阶段向网络防御人员提供访问。她介绍了 Carbon 在减少编造和网页设计方面的改进,建议用 AI 质疑而非取代人的思考。后续 Antigravity 演示分派不同平台的子智能体查找过时代码,并由只读审查者和最终报告提供检查。
- 1网络防御人员在广泛发布前测试保护措施Doshi 说,分阶段发布让 Google 能够压力测试保护措施并收集反馈。
- 2Carbon 针对编造和网页设计反馈进行改进Doshi 说,Carbon 改进了易用性、编码和网页视觉效果,而 Argon 仍然有用。
- 3一家医院的漏洞被识别并修补Doshi 介绍了与 Wiz 的 Scan for Good 项目合作,保护患者记录的工作。
- 4用模型质疑自己的想法Doshi 建议询问论证遗漏了什么或可能带来什么后果。
- 5平台策略指导并行的代码维护智能体Davis 定义支持版本,分派平台工作者,并使用只读审查者。
要点建议
- 除了基准测试,也用重复出现的真实任务测试模型检查点。
- 在广泛部署能力较强的系统前分阶段开放并收集防御人员反馈。
- 让智能体删除兼容代码之前,先定义平台支持策略。
- 只给审查智能体必要的权限,并检查其报告。
- 用模型质疑自己的推理,而不是把它当作事实的最终来源。
按章节阅读整理后的全文
分阶段开发和发布 Gemini 4
Doshi 介绍员工测试、长时间任务和向防御人员提前开放。
Google Cloud Show 介绍 Gemini 4 Argon 和 Carbon。主持人说,Argon 面向深度推理和多步骤工作;内部团队曾看到 Carbon 连续数天处理复杂代码问题。
主持人还提到,在特定的作弊和间接提示词注入评测中,没有攻击成功。这是所列测试的结果,不代表可以防御所有攻击。
Smitha 采访 Google DeepMind Gemini 模型家族产品负责人 Tulsee Doshi,讨论模型开发、发布和使用。Doshi 此前领导 Google 的负责任 AI 产品工作。
Doshi 说,Google 在 Gemini 4 开发期间扩大了内部实时测试。有天早晨,她看到早期员工测试者发来的热烈反馈;当时她自己还没有充分测试那个模型检查点。
她说,频繁发布和收集用户反馈一直是团队的做法,但 Gemini 4 的内部迭代速度更快。团队在更大范围发布前,利用员工反馈改进模型检查点。
从发布公告到全面开放之间的间隔,让网络防御人员能提前使用模型,压力测试模型及其保护措施。Doshi 说,这种分阶段流程有助于在广泛开放前收集反馈。
与 Gemini 3 相比,Doshi 预计长时间运行的任务最能体现区别。她把持续性描述为遇到障碍或边缘情况时寻找解决办法,而不是放弃、反复询问用户或谎称问题已经解决。
Doshi 说,Carbon 进一步改善了易用性,包括减少编造、改进网页应用的视觉设计、编码和安全代码生成。她也认为 Argon 仍适合日常使用,并建议开发者自己尝试 Carbon。
网页开发展示了这种迭代:用户喜欢 Argon 的 3D 可视化,但反馈其网页视觉设计较弱。Doshi 说,Carbon 已加入部分改进,团队会继续吸收反馈。
Google 与现已成为 Google 一部分的 Wiz 合作进行网络安全评测和早期测试。Doshi 说,Wiz 的 Scan for Good 项目使用这些模型协助一家医院系统识别并修补漏洞,避免数十万份患者记录可能被暴露。
她认为,优先向防御人员开放既能发挥模型的安全能力,也能让较小的群体先测试保护措施,帮助团队在扩大访问范围前学习和改进。
用模型辅助写作和批判性思考
Doshi 分享个人工作流程,并提醒不要把判断外包给模型。
Doshi 自己写作时,会在 Antigravity 中用语音转文字模型记录想法,再让 Argon 整理成可编辑的文档。她认为这是通过写作理清思路并邀请他人反馈的一种方式。
采访者提到一次 Fortran 到 Rust 的迁移以及 Chrome 补丁对比。Doshi 说,Argon 在 Google 内部可用后,智能体参与的代码提交增加了 30%;她认为更有持续性的工具可以给开发者更多创造空间。
为了比较模型检查点,Doshi 会反复测试一个用于管理育儿事务的个人应用,涉及付款、健康预约和可视化。她还让模型汇总数据生成文档或幻灯片,再附加具体要求进行编辑。
她给非工程师的建议是,把模型当作思考伙伴,而不是事实的最终来源。先提出自己的想法,询问遗漏了什么或可能产生什么后果,再亲自迭代草稿。
Argon 和 Carbon 这两个元素名称旨在区分不同模型,同时保持共同主题。Doshi 还谈到为舞蹈保留时间,以及作为家长如何保护孩子的批判性思考、创造力和人与人之间的关系。
在 AI Studio 中改造应用
演示者修改棋盘,并为赛车游戏添加共享排行榜。
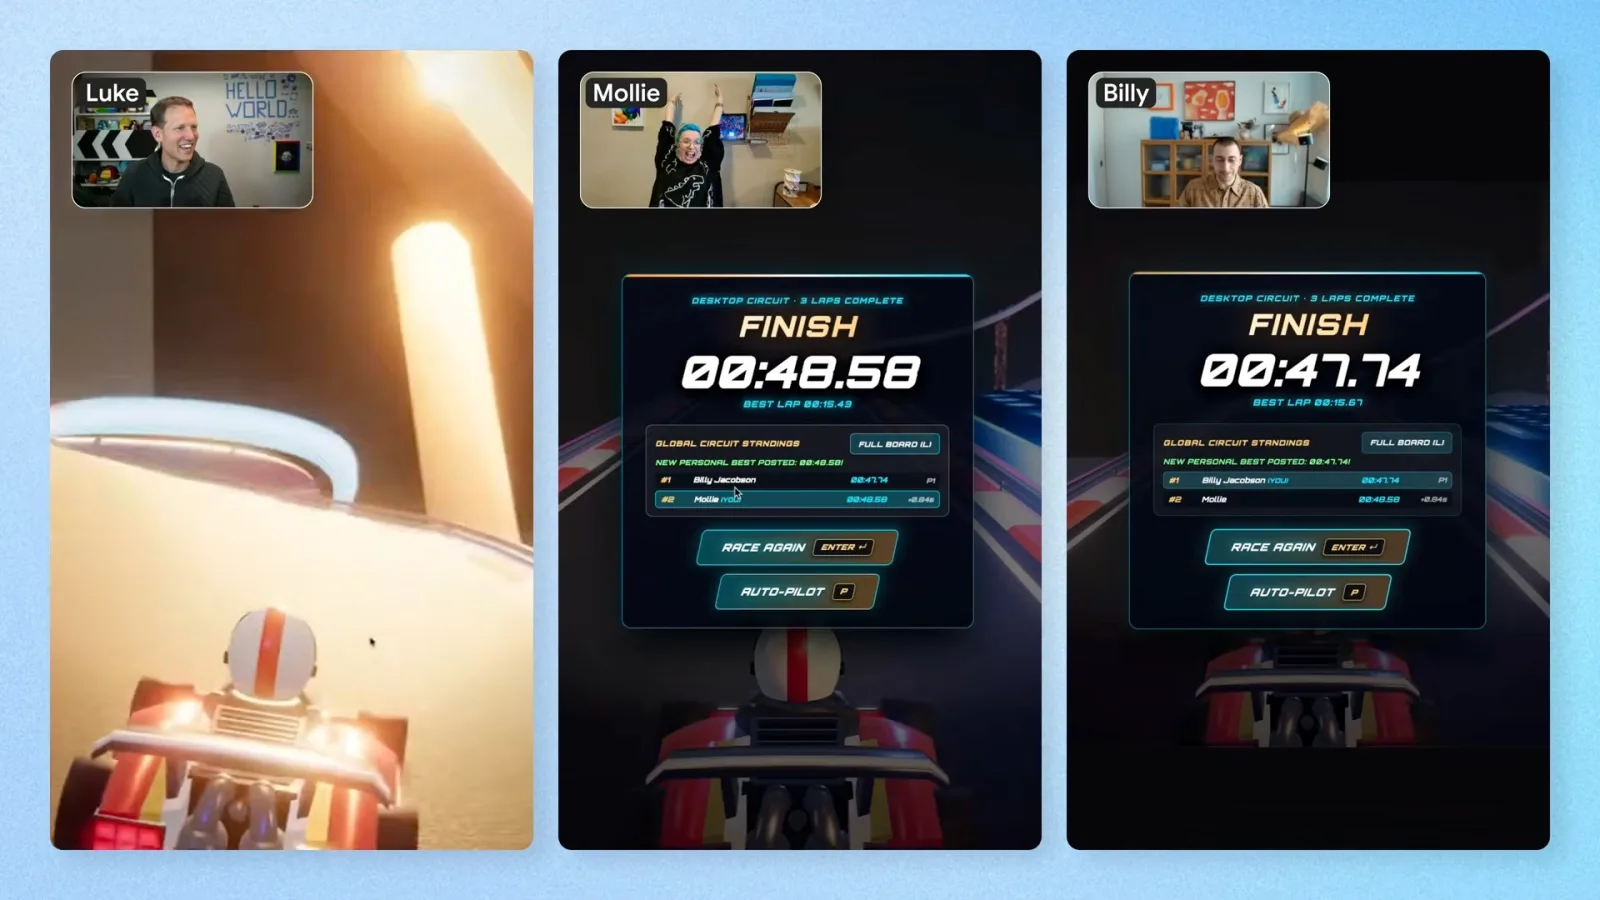
节目随后切换到 AI Studio 演示。Luke、Mollie 和 Billy 查看一个缺少常见坐标标记的 3D 棋盘应用。一人让 Argon 把符号替换成字母和数字,另一人要求将棋子改成明亮的霓虹色。
随后他们给赛车游戏加入共享排行榜和登录功能。演示接受了 Firebase 与 Firestore 的设置,参与者比赛并查看共享成绩。他们说,以前添加身份验证需要更多开发工作。
用 Antigravity 子智能体审查旧代码
可配置的工作流程检查多个平台并返回报告。
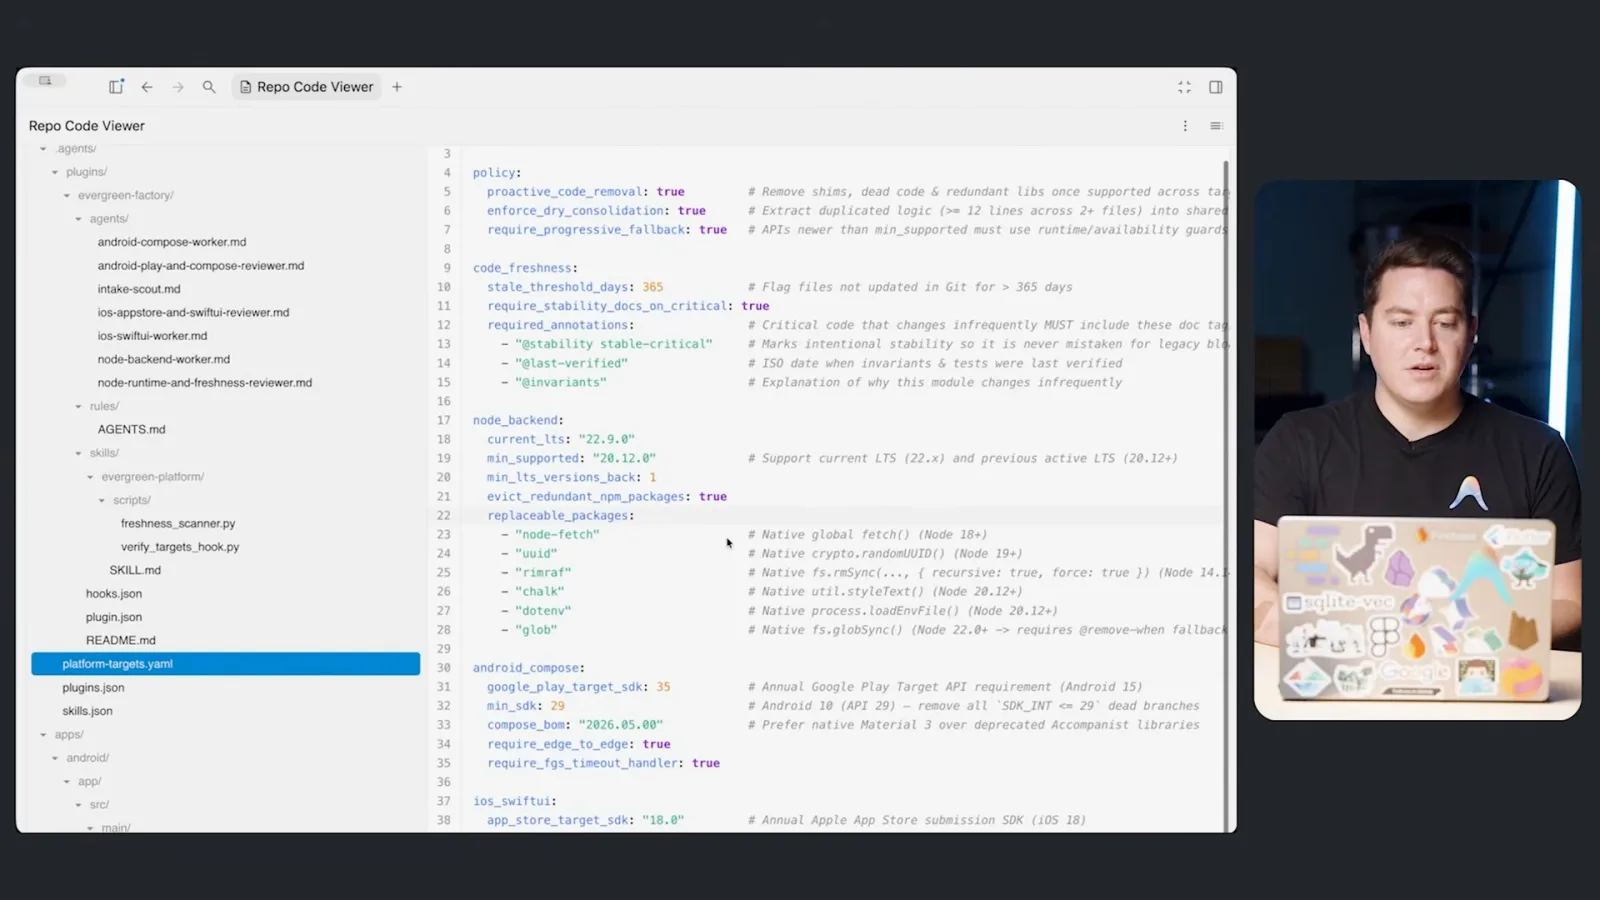
Rody Davis 演示一个 Antigravity 工作流程,用于维护 Web、Android 和 iOS 代码。当受支持的平台版本升级后,它会查找过时 API、兼容代码和不再需要的 polyfill。
工作流程用 Markdown 定义平台版本策略和自定义子智能体。不同工作者分别处理 Node、Jetpack Compose 和 SwiftUI;共享配置规定需要支持多少个版本。
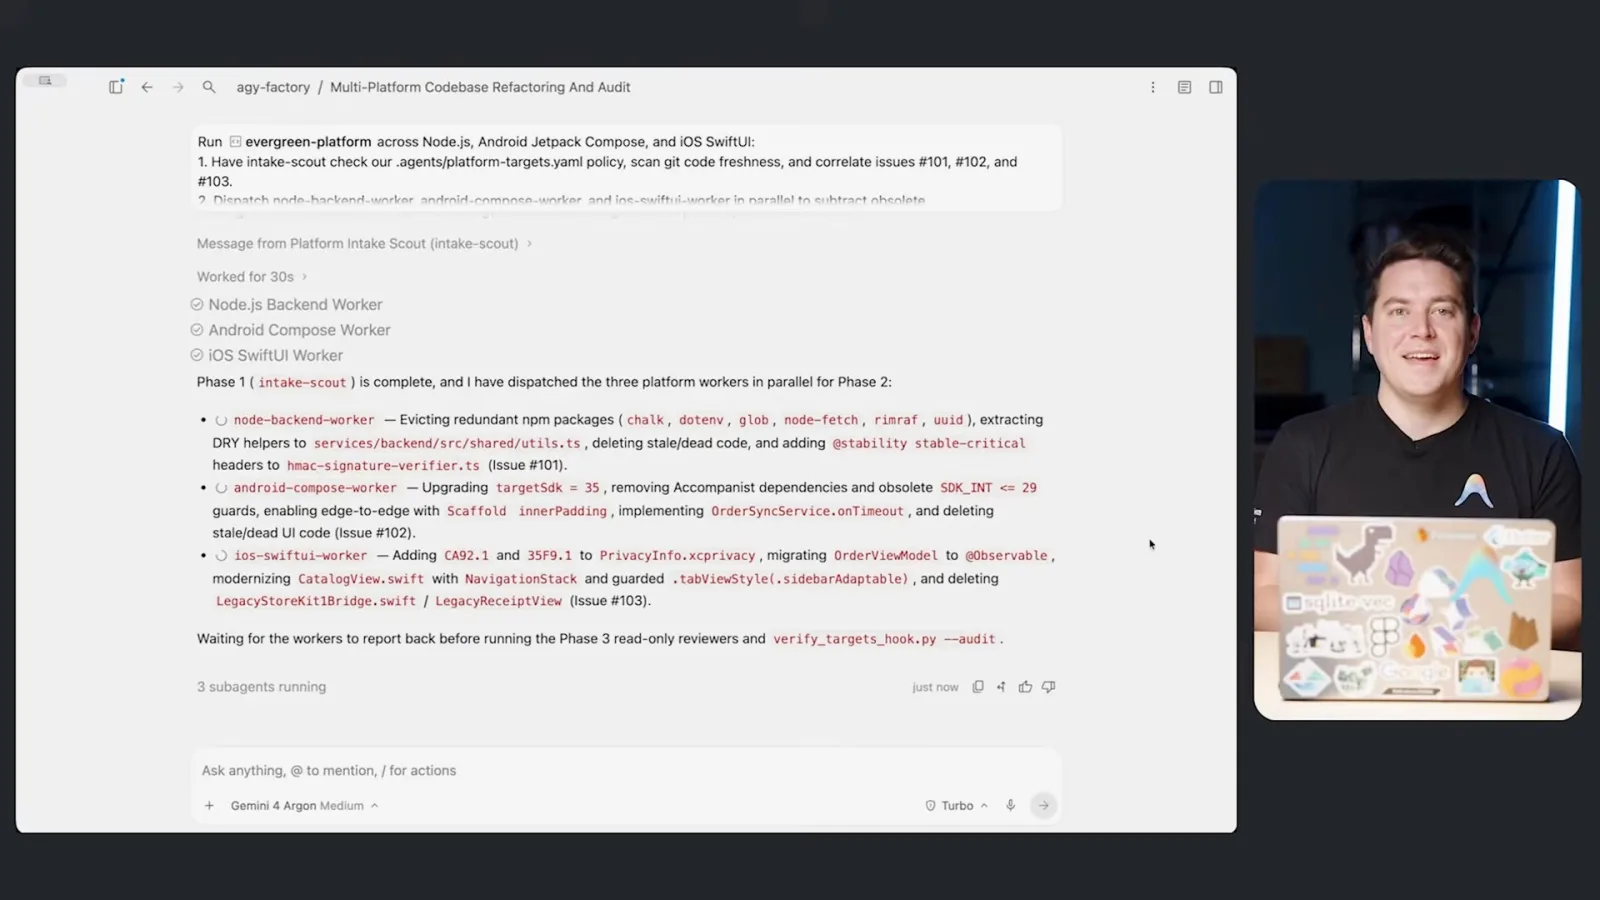
Davis 使用中等工作强度的 Argon,针对示例问题和代码库调用工作流程。主智能体先检查策略,再分派平台工作者。真实团队可以接入自己的工单来源。
Davis 将人的角色比作现场主管:检查工作、在质量下降时停止流程,并改进操作程序。子智能体使用各自的上下文,可以并行工作,同时向主会话报告进度。
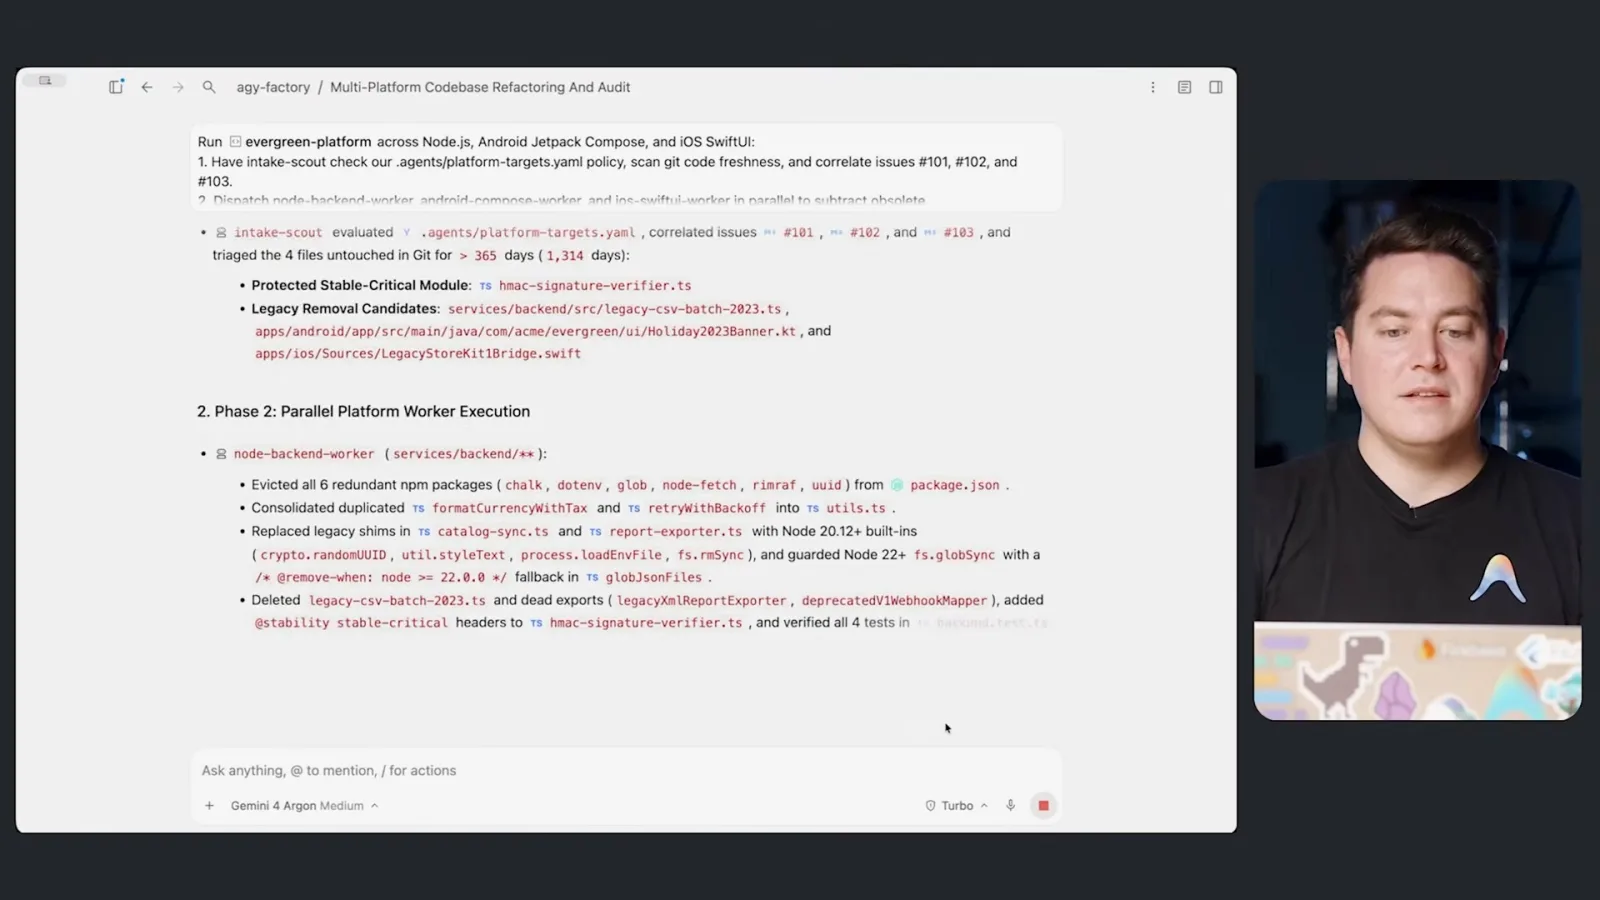
审查子智能体被配置为只读,因此它们只能检查变更,不能写代码。Antigravity 允许用户查看各个会话,并向子智能体发消息以引导或停止它。
最终报告记录各工作者完成的事项,包括删除的旧 API 和基于 Git 历史的代码新鲜度评估。Davis 建议使用自动化面板按计划或围绕平台发布周期重复审查。
对于更长时间的工作,Davis 提到 Teamwork Preview 和 /boost 命令。他说前者使用多组子智能体,后者则采用更线性的流程,按需创建子智能体。
同频道的其他文章
 17:27EN → 简体中文
 Google Cloud Tech· 2026年11月9日修复混乱应用:先定义状态,再向智能体下指令Devin Chasanoff · GoogleDevin Chasanoff 先梳理健身界面的状态、转换和测试,再让智能体修改应用。
 11:59EN → 简体中文Google Cloud Tech· 2026年11月3日用两个 AI 智能体把原型变成前端设计规范Devin Chasanoff · GoogleDevin Chasanoff 将规划和文档记录分开,让 Gemini 在应用开发前帮助用户完成设计。
 11:16EN → 简体中文Google Cloud Tech· 2026年10月29日让 AI 智能体动工前,先核对规范并设置检查点Devin Chase · GoogleDevin 演示如何发现需求冲突、比较默认假设与建议,并制定分阶段实施计划。
 12:26EN → 简体中文Google Cloud Tech· 2026年10月28日让 AI 智能体拥有两种长期记忆Annie Wang · Google CloudAnnie Wang 区分精确事实与语义偏好,并让较慢的记忆提取避开实时语音的关键路径。