30 秒看懂
多模态智能体应从结构化记录中查找购买记录、日程等精确事实,使用语义搜索回忆不那么精确的偏好。Google 的 Annie Wang 介绍了在会话开始时加载两类信息、立即写入明确的事实变更,以及异步提取长期模式的方法。原始音频和视频是否保留是另一项存储决策,不会自动成为智能体记忆。
- 1精确事实和用户偏好需要不同的检索方式日程和购买记录适合结构化存储;偏好则可能需要根据历史上下文进行相似度搜索。
- 2相似的记忆不能代替准确的购买记录Wang 建议,精确事实应查询数据库,涉及用户通常偏好的问题则可使用语义检索。
- 3是否保存原始音视频是另一项决策媒体可用于回放或审计,但智能体记忆通常保存从中提取的相关含义。
- 4让记忆提取避开实时音频路径模型可以在会话中或会话后异步提取语义记忆,而不延迟对话。
要点建议
- 用数据库精确查询事实,用语义搜索查找偏好或模式。
- 不要把一次随口说的话当作永久偏好。
- 异步执行模型记忆提取,避免阻塞实时音频。
- 将原始媒体的保留与从中提取记忆的决策分开。
按章节阅读整理后的全文
决定什么信息应跨会话保留
Wang 通过穿搭助手区分短期对话上下文与持久的事实、偏好。
Annie Wang 提问,多模态智能体在会话结束后应记住什么。穿搭助手示例展示了目标:利用顾客的愿望清单和过去购买记录,为即将到来的晚餐推荐服装。
对话中保留的上下文类似短期记忆:它在会话期间有用,但不会自动延续到下一次。设计问题是哪些信息值得为未来会话保留。
Wang 区分精确事实和语义理解。有日期的活动或购买记录可以存成带 ID 的结构化记录;喜欢简洁穿搭这样的偏好,则可能是多次对话中逐渐显现的模式。
为不同查询存储事实和语义理解
结构化数据库回答精确问题,向量搜索检索相关模式。原始媒体是否保留需要单独决定。
对于精确事实,她建议使用 PostgreSQL、MySQL 或 Cloud SQL 等结构化数据库。查询日程时需要返回实际活动,而不是语义相近的记录。
对于不那么结构化的理解,向量存储可以按含义检索相关记忆。例如,即使用户提问与记忆的措辞不同,也能找到与晚餐有关的穿搭偏好。
向量存储是一类技术,并非单一产品:PostgreSQL 内可以使用向量搜索,也可以使用 AlloyDB 等服务。Wang 还介绍 Agent Engine Memory Bank 这一托管选项,它能从历史会话提取有用信息并持续更新记忆。
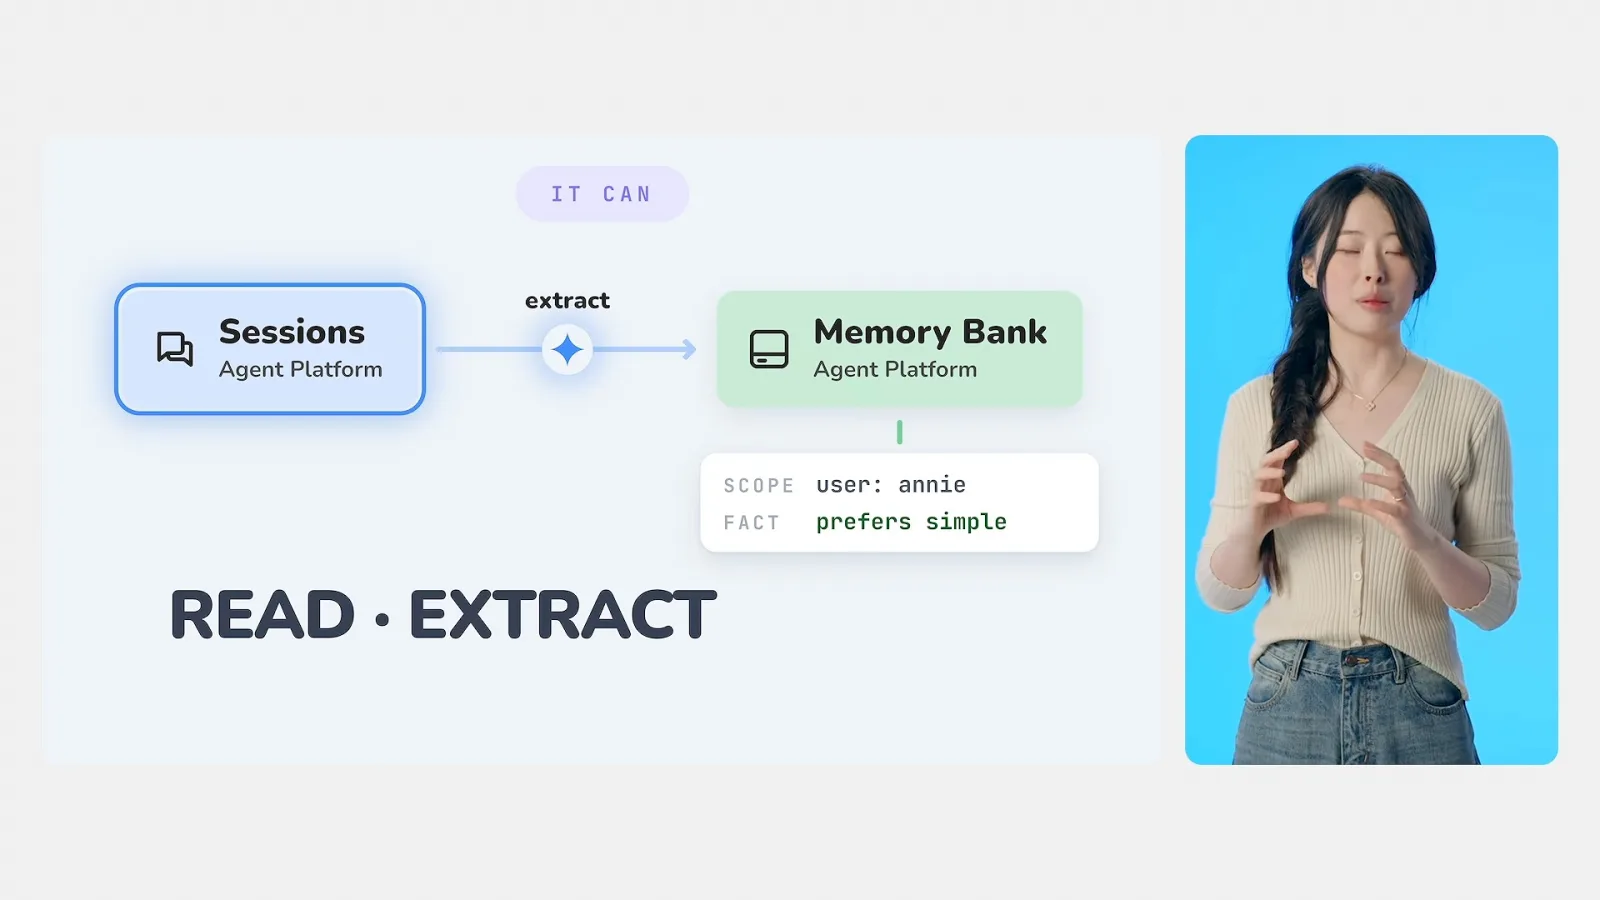
把所有事实都放进相似度搜索,在答案必须精确时会出问题。关于购买记录的问题应查询数据库,关于平时晚餐穿什么的问题则可以使用语义回忆。
原始视频帧和音频波形与智能体记忆是两回事。应用可能为了回放、审计、调试或训练保留媒体,但记忆层通常需要的是从信号中提取的有用含义,而不是所有原始画面和声音。
加载和更新记忆,同时避免阻塞音频
智能体在会话开始时读取两类上下文,写入明确变更,并异步提取语义记忆。
会话开始时,智能体可以先加载即将发生的活动、愿望清单等结构化事实,再检索偏好和舒适度要求等相关语义记忆。两类信息共同为回答提供上下文。
Wang 建议及时保存明确的事实变更:用户要求把一件西装外套加入愿望清单时,智能体调用工具,立即把变更写入数据库。
长期偏好需要更多判断。今天随口说喜欢黄色,不应自动变成永久的风格偏好;反复出现的行为或用户的解释能够提供更强的信号。
记忆提取可以在对话期间或结束后进行。按较短间隔提取可能得到更清晰的记忆,也能在用户提前离开时保留信息;Memory Bank 支持会话中生成记忆。
对实时语音智能体而言,基于模型的提取比简单数据库写入更慢,不应阻塞音频。Wang 建议在一轮对话之后或会话结束后异步执行,让提取避开对延迟敏感的路径。
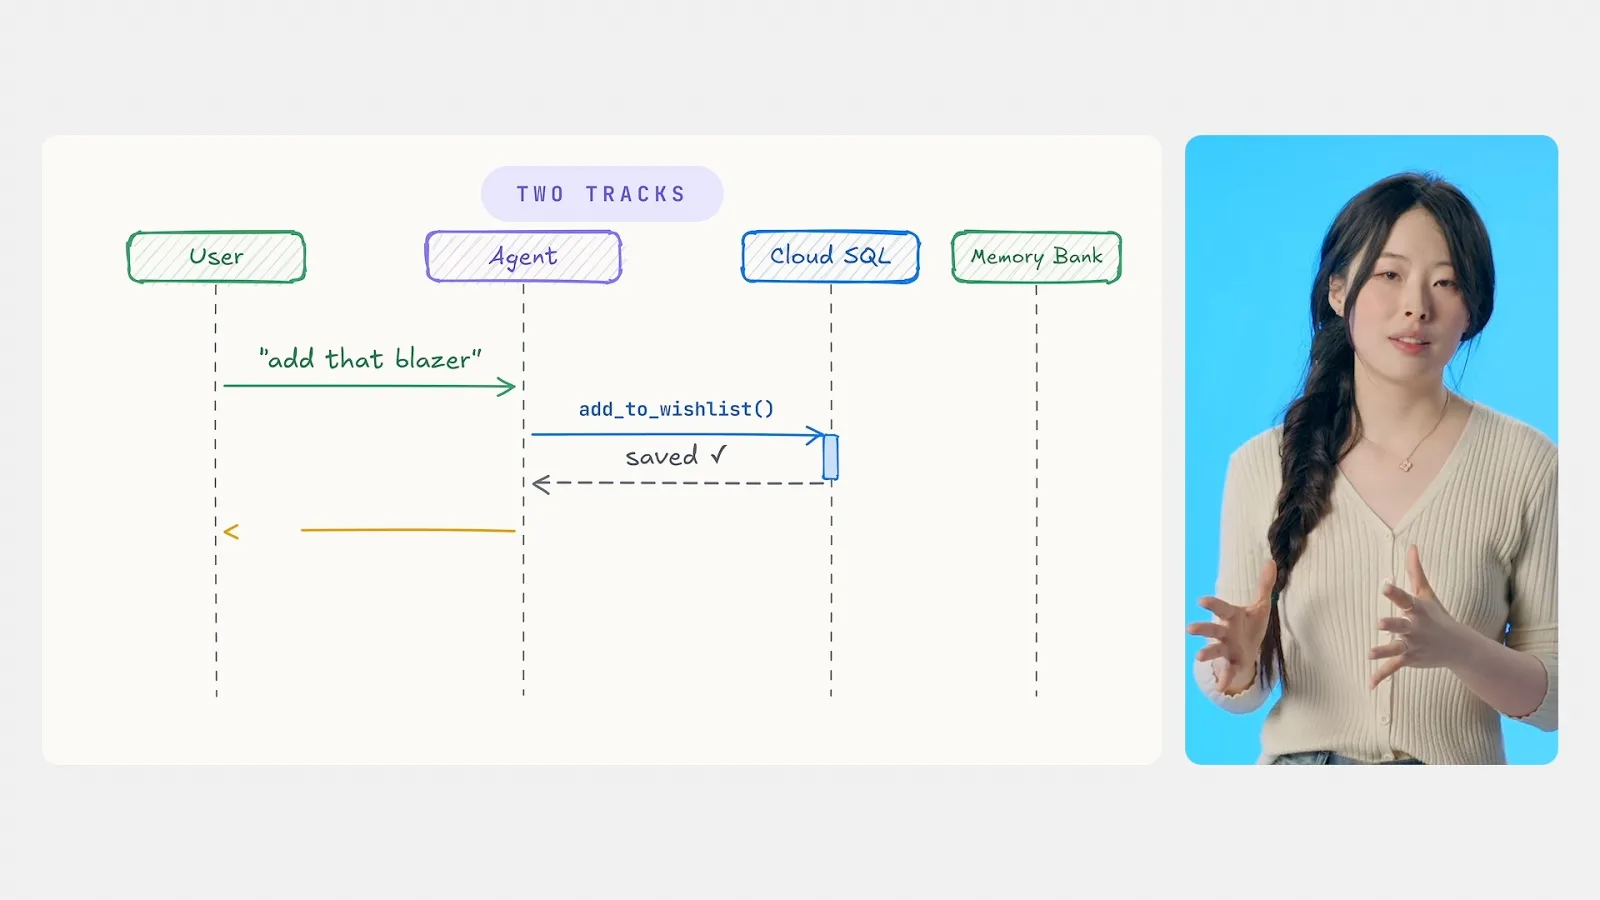
在她的演示中,结构化事实立即写入,语义理解则在会话结束后提取。下次会话再加载两者:读取上下文、写入变化,并将有用信息带到下一次。
同频道的其他文章
 17:27EN → 简体中文
 Google Cloud Tech· 2026年11月9日修复混乱应用:先定义状态,再向智能体下指令Devin Chasanoff · GoogleDevin Chasanoff 先梳理健身界面的状态、转换和测试,再让智能体修改应用。
 11:59EN → 简体中文Google Cloud Tech· 2026年11月3日用两个 AI 智能体把原型变成前端设计规范Devin Chasanoff · GoogleDevin Chasanoff 将规划和文档记录分开,让 Gemini 在应用开发前帮助用户完成设计。
 11:16EN → 简体中文Google Cloud Tech· 2026年10月29日让 AI 智能体动工前,先核对规范并设置检查点Devin Chase · GoogleDevin 演示如何发现需求冲突、比较默认假设与建议,并制定分阶段实施计划。