30 秒看懂
Michael Shimeles 所说的“软件工厂”是把自己的工程工作流写进智能体指令,而不是让智能体无人看管地持续运行。每个任务使用独立工作树;智能体按选定结构开发、提供行为证据,并处理自动拉取请求审查的反馈。Shimeles 仍亲自测试功能,客户项目还由团队成员审查代码。他也讨论了对话式规划、模型成本,以及错误的初始假设为何会让长时间自主运行白费功夫。
- 1独立工作树让多个智能体处理不同任务,减少文件冲突Shimeles 为每个新任务从主分支创建工作树。他的指令也提醒:工作树不会隔离端口或数据库等共享资源。
- 2服务层模式让他和智能体更容易理解代码他的开发技能将编排与可复用的具体操作分开。他偏好一致的命名和结构,以减少重复并提高可读性。
- 3验证从复现已报告的缺陷开始他要求智能体提供修改前后的视频、截图或测量数据。对于非视觉性能工作,他展示时间比较,而不是截图。
- 4功能仍需人亲自测试Shimeles 说,尤其在真实用户或客户依赖软件时,他会亲自使用功能。客户项目也由团队成员审查代码。
- 5自动审查反馈驱动有上限的修改循环智能体处理可执行的拉取请求评论并请求再次审查,在达到目标分数或迭代上限时停止,最终把 PR 交给他检查。
- 6对话可以成为他眼前的规划文档Shimeles 在开发前与智能体充分讨论想法。对于以后需要的设置步骤,他会要求写成持久的 Markdown 文件。
- 7工具改善后工作流可能精简,但个人偏好仍在他先不带指令测试新模型,再加入自己的工作流。两人都认为,记录个人偏好的技能仍可能有价值。
要点建议
- 用独立工作树隔离并行任务,同时记住端口和数据库等资源仍可能共享。
- 对于报告的缺陷,修复前先复现,修复后保留证据;不适合截图时使用测量数据。
- 自动审查分数可以引导下一轮检查,但 Shimeles 仍会亲自测试功能。
- 长时间运行前先讨论假设;需要日后参考的设置步骤写成持久文档。
- 根据任务及其后果选择模型和验证力度。
按章节阅读整理后的全文
隔离并行工作
Shimeles 将自己的工厂定义为一组指令和技能。独立工作树减少文件冲突,但不能隔离所有共享资源。
Michael Shimeles,也被称为 Ras Mic,对完全自主的“软件工厂”持怀疑态度:一开始的错误假设可能贯穿整个长时间运行过程。他更愿意用这个词描述一组指导智能体的工作流指令、技能和工程偏好,而他自己仍参与其中。
他的工作流旨在适用于不同模型和工具。AGENTS.md 文件说明他希望智能体如何工作,不同技能负责各个阶段。他认为,模型可以自行检查代码库,了解许多结构细节。
第一阶段为新功能或修复创建从主分支分出的 Git 工作树。这样多个智能体可以处理不同任务,减少对同一文件的冲突。他演示了终端标签页中同时运行的多个智能体。
工作树技能还要求智能体获取并验证代码库状态,同时提醒它:工作树隔离的是文件,不是开发服务器端口或共享数据库等资源。Shimeles 说,他曾用 AI 帮助编写 Git 指令。
按可读结构开发
他的服务层模式将编排和可复用函数分开。他选择这一方式是为了便于理解并减少重复。
开发阶段调用代码结构技能。Shimeles 偏好服务层模式:操作和边界负责协调业务规则与时机,可复用的具体操作放在服务中,并使用明确输入和结构化返回值。
他选择这种结构,部分原因是方便自己或其他开发者日后阅读。一致的函数名也能让智能体更容易发现已有行为,可能减少重复函数。他承认,工程师对架构选择有不同看法。
证明行为,并亲自测试
针对缺陷,智能体记录修改前后证据;其他工作可以使用截图或测量。Shimeles 亲自测试功能,客户项目也有人审查。
验证阶段,证据驱动技能会尝试在修复前复现已报告的缺陷,并在修复后记录结果。在受支持的环境中,它可以录制行为视频。这有助于区分可复现的缺陷与暂时无法确认的报告。
对于视觉变化,修改前后技能可以截图;对于无法用图像展示的性能变化,他展示测量数据。例如,某次页面导航时间从约 815 毫秒降到约 60 毫秒。他用这些材料评估声称的改进。
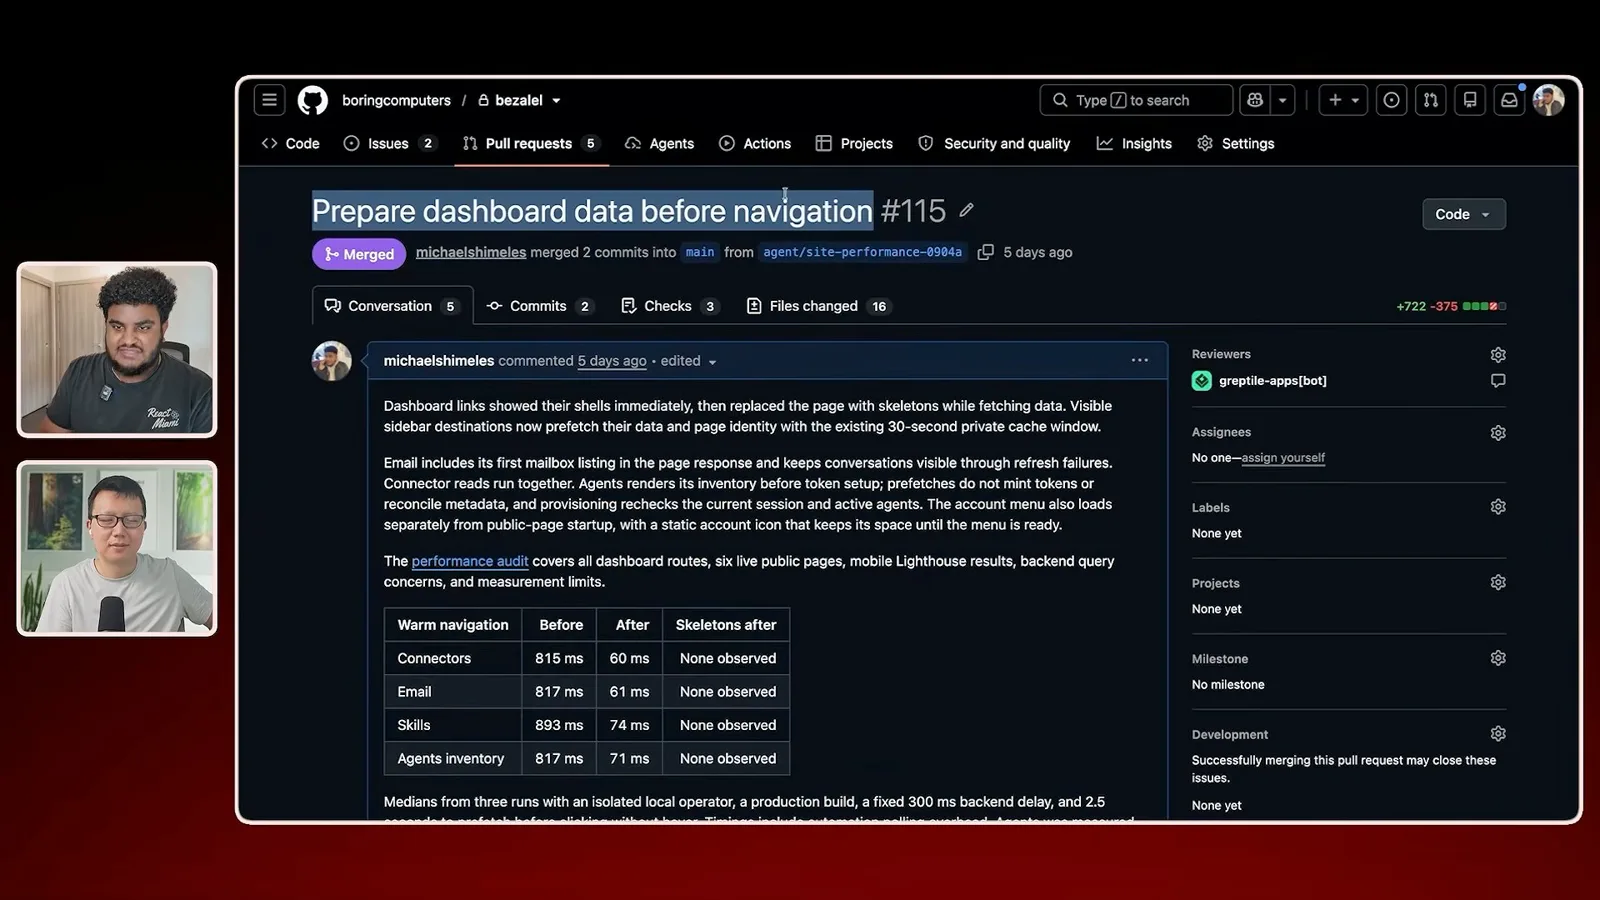
如果没有此前的缺陷需要复现,智能体可能只记录最终行为。Shimeles 说,证据步骤有时会让智能体发现改动没有改善结果,并继续工作。部分录制工具取决于操作系统和已安装的软件。
按他的经验,有些模型会自动遵循所有阶段,另一个模型有时需要提醒才会运行审查循环。他尚未确定原因在模型还是自己的指令。因此,他会监控工作流,而不是假设每一步都已执行。
尤其当其他人使用软件时,Shimeles 仍会亲自测试功能。客户项目的代码也由团队中的开发者审查。对于只供自己使用的小工具,如果能满足需要,他可能采用更快、更简单的流程。
他介绍了如何在不同机器之间分配工作:Linux 电脑处理部分任务,Mac 则用于面向用户的工作和计算机操作测试。他还希望通过手机工作并在不同模型间切换,这些需求影响了他的设置。
通过自动审查循环交付
审查智能体评论拉取请求,编码智能体在迭代上限内修改。Shimeles 最终自行检查结果。
交付阶段使用 Greptile 自动审查拉取请求。当审查者留下可执行反馈或置信分数低于他的目标时,编码智能体会修改代码、重新执行合适的证据检查、推送改动并请求再次审查。
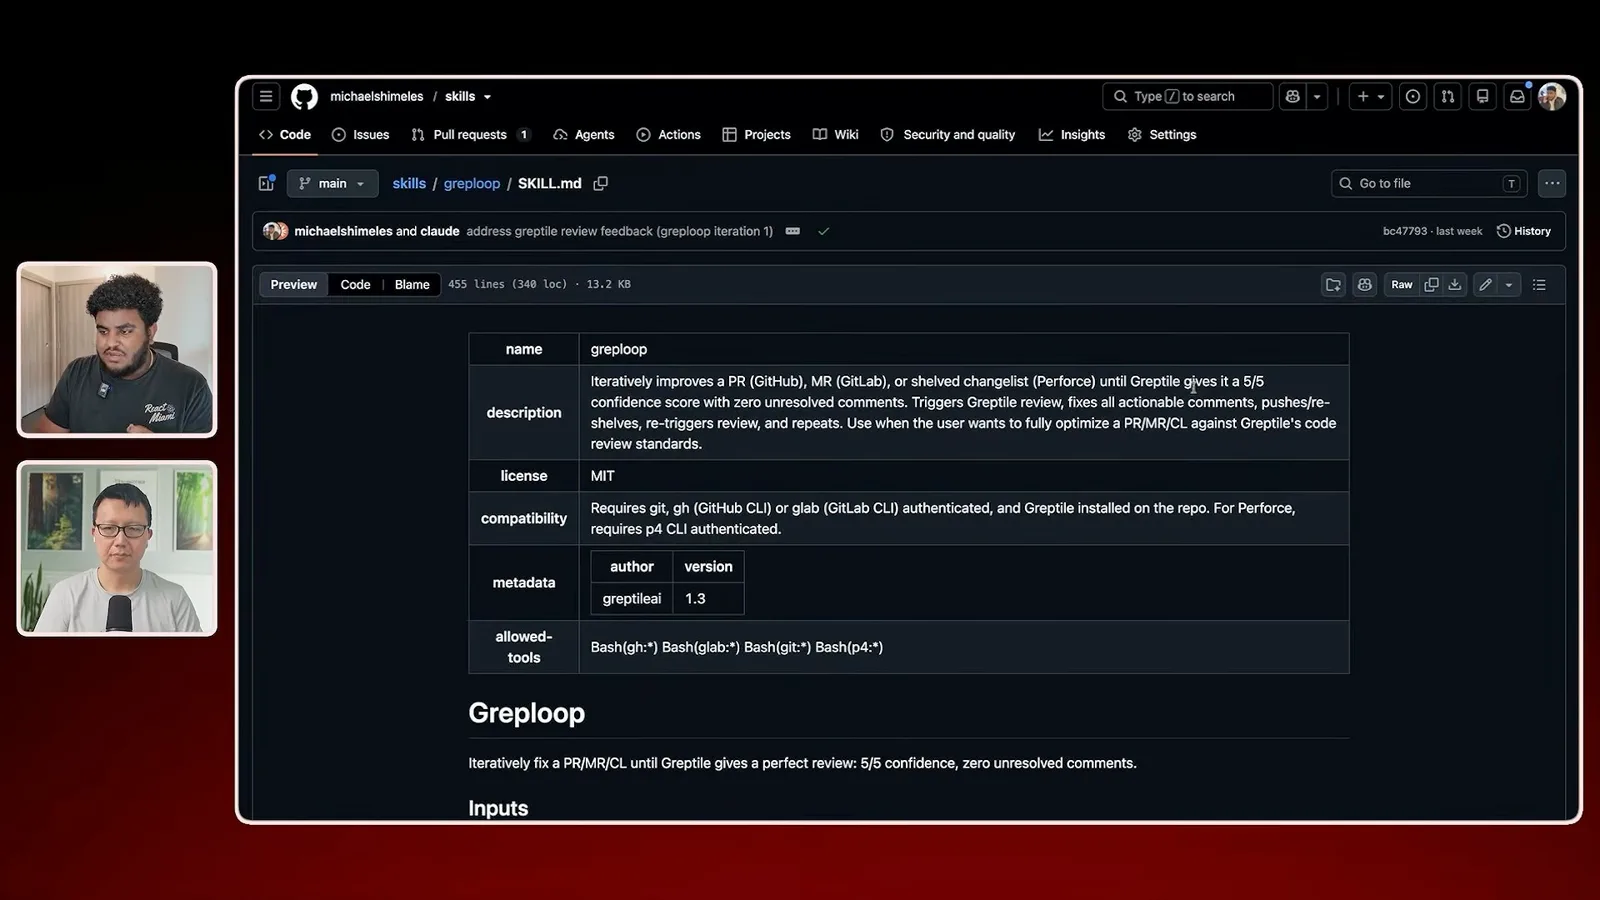
循环在达到目标或迭代上限时停止;他的版本最多允许十轮。随后他收到拉取请求和证据供自己检查。审查分数是流程的一部分,但他仍决定要测试和合并什么。
Shimeles 将流程概括为:隔离、按约定结构开发、证明缺陷或结果,再提交拉取请求并处理审查。Yang 指出,后两个阶段侧重验证。Shimeles 说,他不相信智能体一次就能把所有决定都做对。
对于个人截图工具或图片共享工具,他可能跳过完整流程,因为出错后果较低。Yang 指出,即使是个人项目,如果早期假设错误,让智能体整夜运行也可能浪费功夫。Shimeles 同意,在智能体走得太远前需要沟通。
规划、模型选择和未来的工作流
他通过讨论规划想法,并在需要时保存笔记。他还分享了自己对模型能力、成本和定期安全检查的观察。
规划时,Shimeles 会花几分钟与智能体讨论想法;对话就成为眼前的规格。当某些设置步骤需要以后回来查看时,他会让智能体在相关项目目录写一份 Markdown 文件。
被问到个人项目是否需要工作树和拉取请求时,他说,当风险较低时,速度和探索可能更重要。如果开发者正在练习技能,或在为其他用户开发,可以选择更严格的流程。
谈及模型选择,他说自己使用的一种模型在性能审计、安全检查和计算机操作测试中很有帮助。他举例说,一次对支付应用的审计发现了严重问题,并呼吁为真实用户运营应用的人进行安全检查。
在界面设计方面,他发现提供视觉参考可以改善结果。他说自己更喜欢另一种模型写出的代码,而偏好的审计模型在某些其他任务上更强。这些是个人工作流中的观察,不是普遍排名。
他使用终端工具,部分原因是这样切换智能体和模型时操作方式更熟悉。由于最强模型的订阅可能昂贵,他建议按任务选择模型,在足够胜任时用较小模型处理日常工作。
对于客户应用,Shimeles 会定期运行安全检查。他也在搭建跨多台机器的家庭实验室智能体工作区。Yang 指出,当定时任务分散在设备和云服务中时,可能很难跟踪。
最近一次清理发现 Shimeles 的机器上累积了数千个工作树。两人讨论了跟踪累积资源的必要性:支持并行智能体的灵活性,也可能带来运维负担。
Shimeles 预计,随着工具内置更好的默认行为,他的一些流程会消失;反映个人工作方式的指令则可能继续有用。新模型发布时,他会先不带常用指令文件试用,再把工作流加回来。
Yang 提醒,模型实验室给出的建议可能假设使用者拥有比普通用户更多的计算资源。Shimeles 同意,成本和资源限制会影响实际选择,并说他重视能够在本地运行的开放模型作为替代方案。
同频道的其他文章
 46:40EN → 简体中文
 Peter Yang· 2026年11月8日播客 · 2 人对谈Ashley Alexander:我如何用 AI 照顾患癌的父母嘉宾 Ashley Alexander · 主持 Peter Yang一位照护者用 AI 准备就诊、整理病历和提出更好的问题,治疗仍由医生主导。
 17:50EN → 简体中文Peter Yang· 2026年11月4日播客Peter Yang 用 AI 帮助照顾母亲的五个步骤Yang 用共享照护摘要和整理好的病历协调就诊,同时为家人留出时间。
 15:03EN → 简体中文Peter Yang· 2026年11月3日播客Peter Yang 如何用 AI 电话助手协商网费AI 打电话谈到了更低价格和更快网速,但 Yang 仍需亲自批准套餐变更。
 33:09EN → 简体中文Peter Yang· 2026年11月1日播客 · 2 人对谈Jaclyn Konzelmann:AI 能做的更多,更要选择值得做的事嘉宾 Jaclyn Konzelmann · 主持 Peter YangGoogle Labs 将简短的策略文档与原型、用户共创及结束实验后的经验结合起来。
 13:05EN → 简体中文Peter Yang· 2026年10月28日播客Peter Yang 测试 Genie 4:场景逼真,游戏性仍不成熟五个现场演示展示了响应提示词和声音的场景,也暴露出动作不稳定、游戏机制有限的问题。
 1:06EN → 简体中文Peter Yang· 2026年10月26日播客Peter Yang 谈为个人企业设置工资发放在一次付费合作中,Yang 介绍了自己遇到的手续,以及与企业账户整合的工资发放产品。