30 秒看懂
Peter Yang 用旅行网站、游戏、视频流程、移动应用原型、建议和代码仓库审查比较两套模型工具。他选择 GPT 作为日常主力,在一个游戏示例中略偏爱 Claude,同时承认应用界面、共享技能和已有上下文会影响结果。
- 1旅行网站结果接近两者都生成了交互式行程页面,视觉选择不同,也有部分内容被裁切。
- 2主观游戏偏好Yang 在一个例子中略偏爱 Claude 生成的射击游戏。
- 3发布测试提前停止两套系统都开始操作浏览器,但现场演示没有完成整个流程。
- 4共享上下文影响原型两款移动原型使用了相同的规划技能和设计系统。
- 5个人日常主力Yang 因自己的工作流和使用体验而偏爱 GPT,同时承认两者各有所长。
要点建议
- Yang 认为旅行网站和本地数据移动原型的结果大致接近。
- 他在一个主观游戏示例中偏爱 Claude,在浏览器工作流中偏爱 GPT/Codex。
- 现场发布演示在完成所有平台步骤前已停止。
- 共享技能、设计素材和应用界面都会影响结果。
- 价格和使用限额会变化,六个示例不能确立普遍赢家。
按章节阅读整理后的全文
旅行与游戏示例
Yang 比较两个生成网站和复古射击游戏。
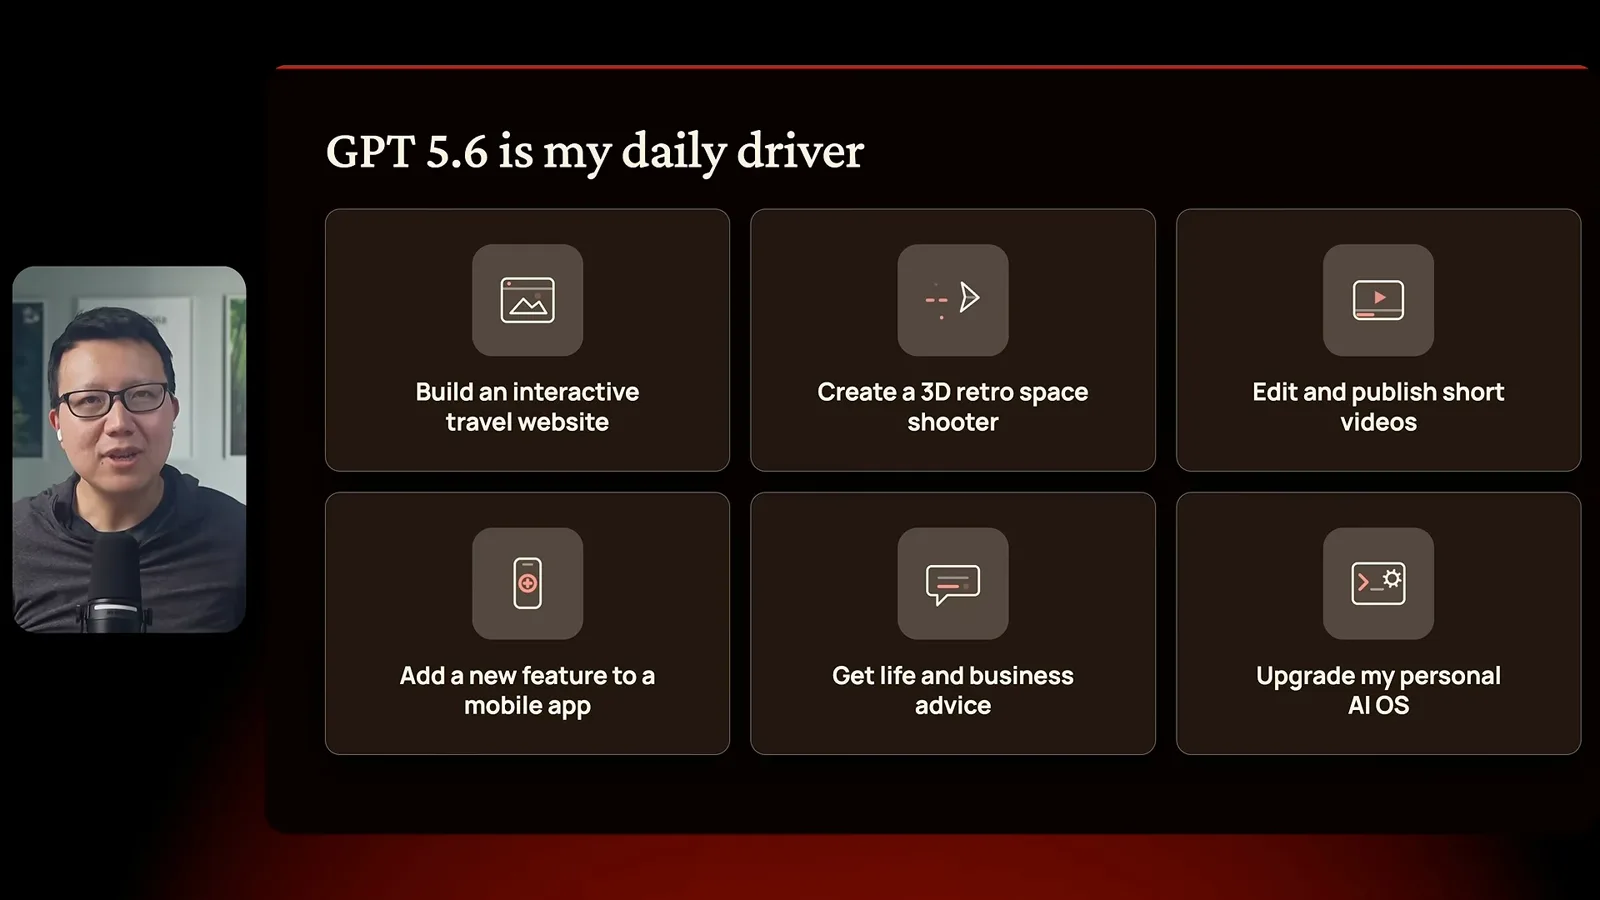
Peter Yang 用六个示例比较 GPT-5.6 和 Claude Fable 5:旅行网站、复古游戏、视频发布、移动应用功能、个人建议和代码仓库审查。他的结论来自少量任务中的个人观察,并非受控基准测试。
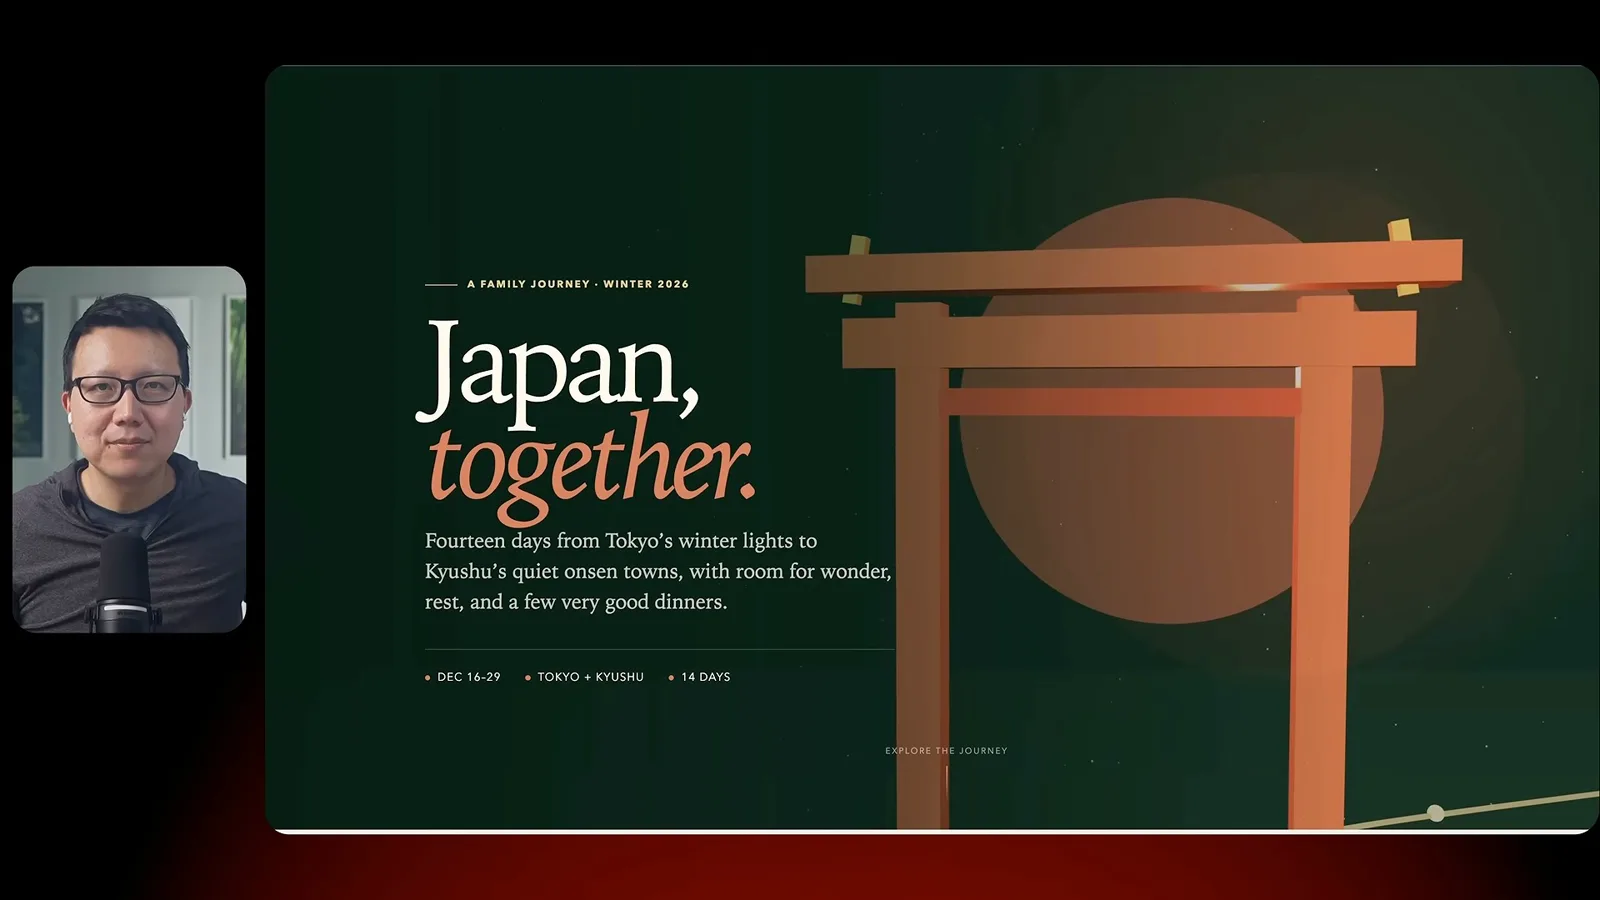
两个模型都把日本行程变成交互式旅行目录。Yang 喜欢 GPT 版本的三维鸟居和相关图片,也喜欢 Claude 版本的雪景与多张图片,同时注意到内容被裁切。他认为结果总体接近。
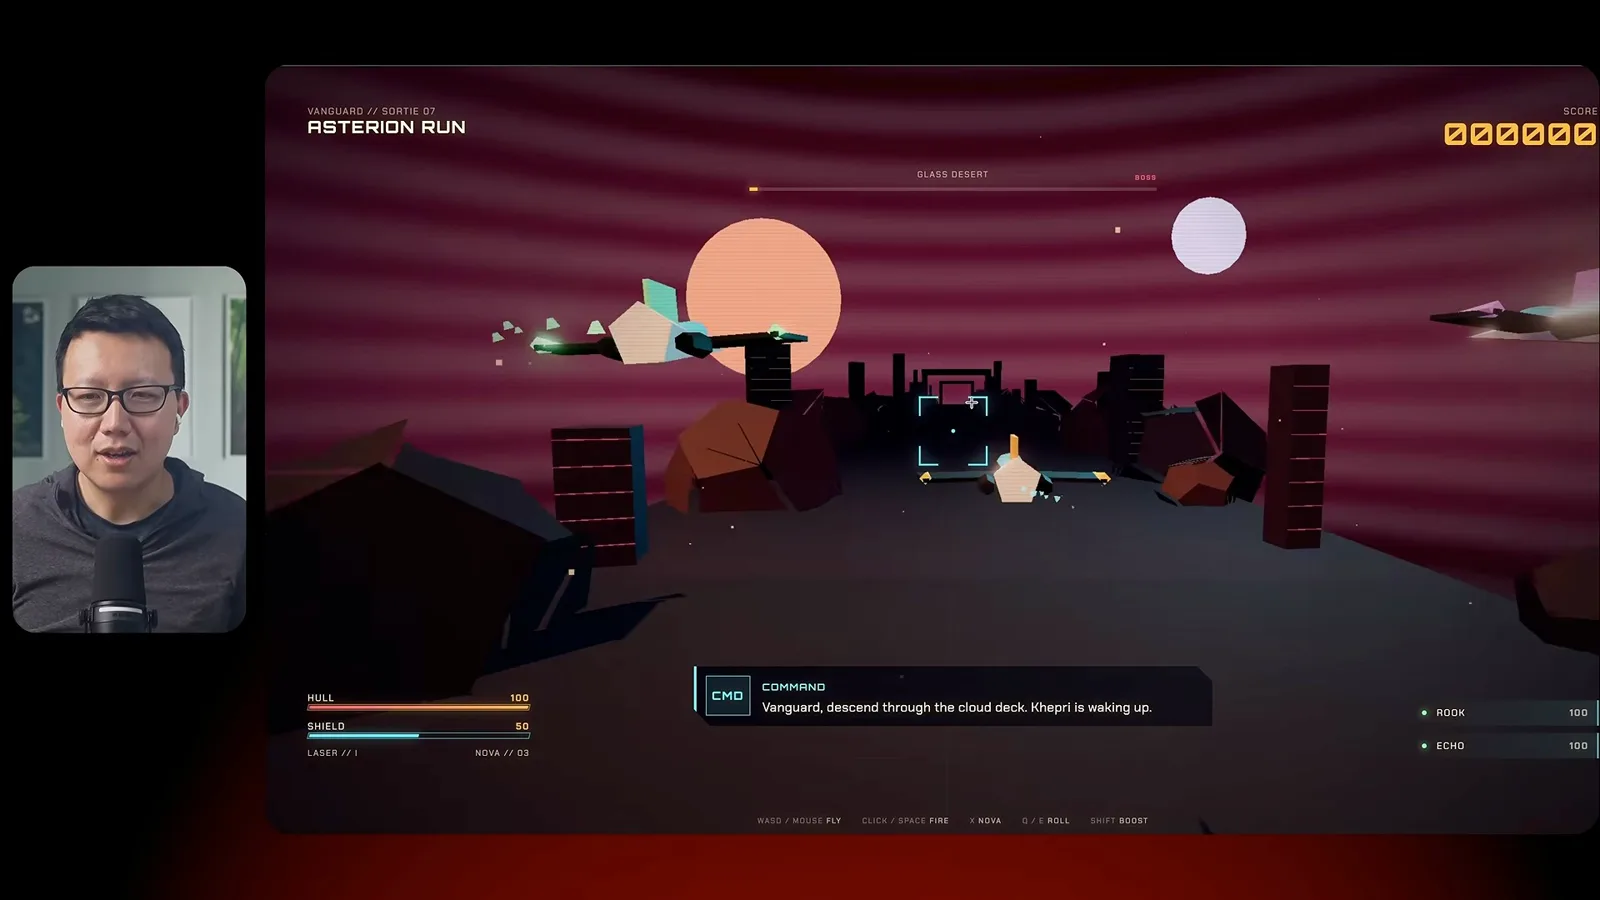
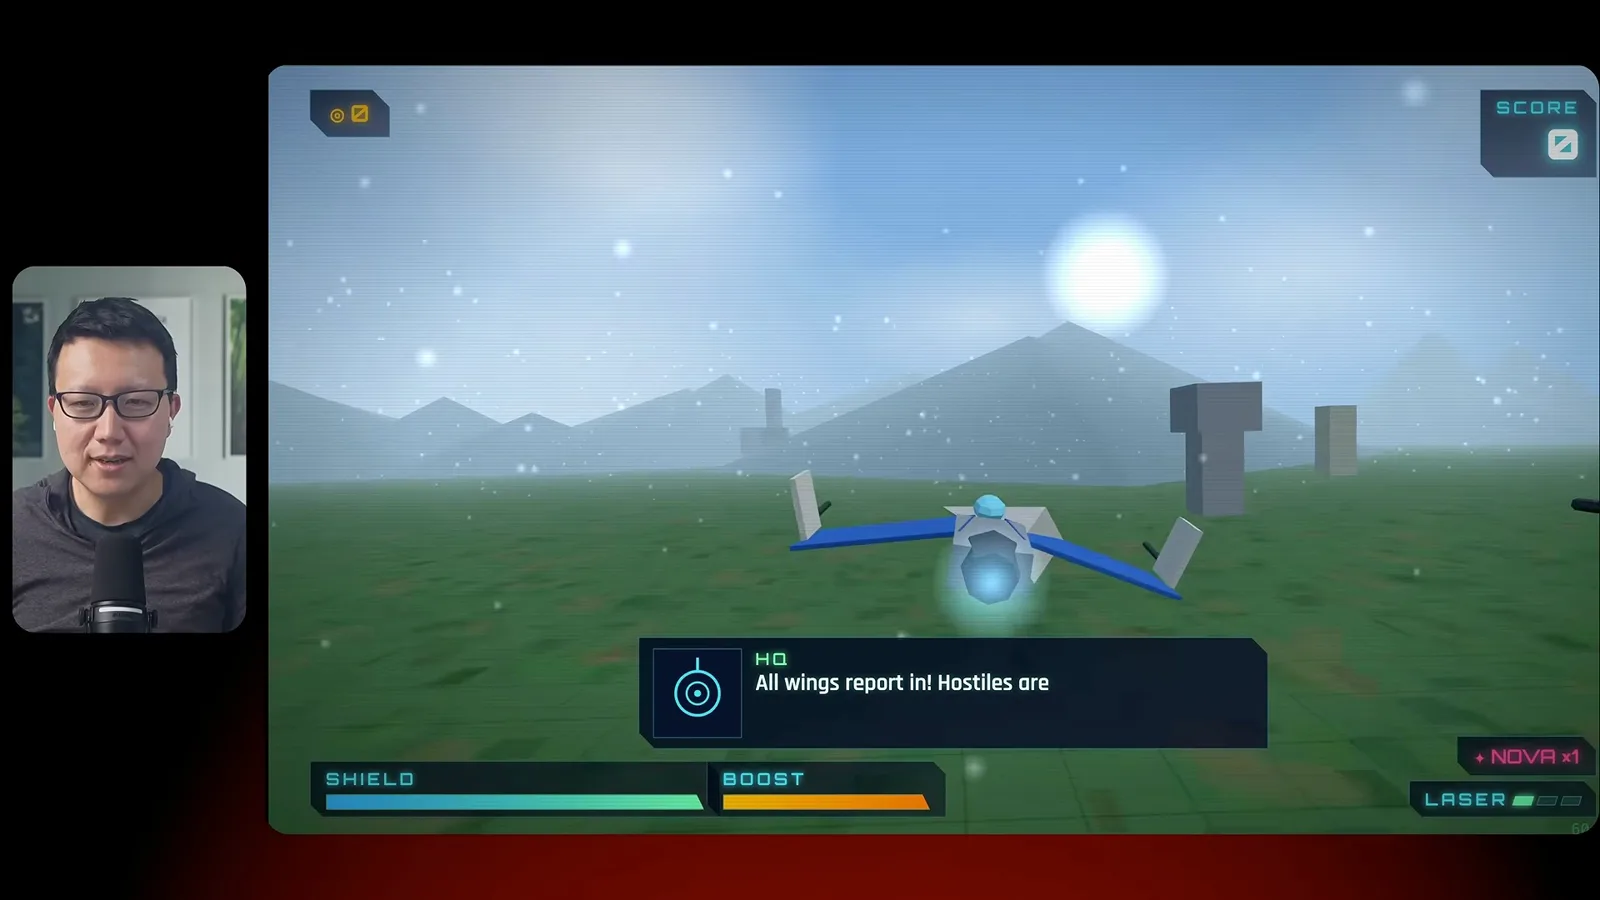
两者根据类似要求制作了可以游玩的复古太空射击游戏。Yang 主观上略偏爱 Claude 的版本,因为他注意到僚机表现和翻滚功能。这是单次生成示例,而非对游戏开发能力的普遍排名。
视频与移动应用工作流
他演示浏览器发布和本地数据原型。
短视频制作方面,Yang 使用技能选择转录片段并渲染视频,再要求两套工具操作发布流程。他在完整跨平台流程结束前停止了两边的现场演示。他根据自己以往的使用体验偏爱 GPT/Codex 浏览器体验,同时指出比较混合了模型和应用差异。
在健身应用示例中,两个模型都为营养标签页创建计划和本地数据原型。Yang 认为它们很相似,判定为平手。两者使用相同的规划技能、设计指南和组件库;这些因素会影响结果,因此比较的不只是模型。
建议与代码仓库审查
模型基于 Yang 自己的上下文提供建议。
个人和商业建议方面,两者都读取了他的规划材料。Yang 喜欢一个回答的组织方式,也欣赏另一个回答提出的见解,但认为结果接近。基于个人上下文生成的建议可以帮助判断和继续探索,不能取代核实基础信息。
代码仓库审查要求两套系统提出改进建议并合并重叠技能。Yang 偏好编号列表,以便选择并批准具体更改。他认为两边都有有用建议,没有宣布赢家。
个人结论
Yang 讨论偏好和会随时间变化的成本权衡。
Yang 根据自己对周边工具、速度和使用限额的体验,选择 GPT-5.6 作为日常主力,同时认为 Claude 适合规划和设计。他对价格和订阅的比较反映录制时的情况,可能发生变化;视频没有确立永久或普遍适用的赢家。
同频道的其他文章
 46:40EN → 简体中文
 Peter Yang· 2026年11月8日播客 · 2 人对谈Ashley Alexander:我如何用 AI 照顾患癌的父母嘉宾 Ashley Alexander · 主持 Peter Yang一位照护者用 AI 准备就诊、整理病历和提出更好的问题,治疗仍由医生主导。
 17:50EN → 简体中文Peter Yang· 2026年11月4日播客Peter Yang 用 AI 帮助照顾母亲的五个步骤Yang 用共享照护摘要和整理好的病历协调就诊,同时为家人留出时间。
 15:03EN → 简体中文Peter Yang· 2026年11月3日播客Peter Yang 如何用 AI 电话助手协商网费AI 打电话谈到了更低价格和更快网速,但 Yang 仍需亲自批准套餐变更。
 33:09EN → 简体中文Peter Yang· 2026年11月1日播客 · 2 人对谈Jaclyn Konzelmann:AI 能做的更多,更要选择值得做的事嘉宾 Jaclyn Konzelmann · 主持 Peter YangGoogle Labs 将简短的策略文档与原型、用户共创及结束实验后的经验结合起来。
 13:05EN → 简体中文Peter Yang· 2026年10月28日播客Peter Yang 测试 Genie 4:场景逼真,游戏性仍不成熟五个现场演示展示了响应提示词和声音的场景,也暴露出动作不稳定、游戏机制有限的问题。
 1:06EN → 简体中文Peter Yang· 2026年10月26日播客Peter Yang 谈为个人企业设置工资发放在一次付费合作中,Yang 介绍了自己遇到的手续,以及与企业账户整合的工资发放产品。