30 秒看懂
Mixedbread 的 Aamir Shakir 认为,智能体能否获取相关证据可能是主要瓶颈。他介绍了解析、分块和单向量检索中的信息损失,并在金融文档上演示多模态、后期交互搜索产品。 他报告称,一家对冲基金客户在更换搜索后端后,55 个问题的基准测试中回答准确率从 36% 升至 98%,同时 token 支出下降。这些是供应商报告的单个客户案例结果。
- 1盲目搜索的成本Shakir 说,大量质量不高的关键词匹配可能迫使智能体花费 token 阅读不相关文档。
- 2多阶段检索流程他认为解析、OCR、分块和嵌入等步骤都可能丢失信息或增加集成工作。
- 3后期交互该模型使用多个嵌入表示更细粒度的查询和文档信息。
- 4将答案追溯到证据演示使用页面布局和边界框,帮助引用检索到的材料。
- 5一个客户基准供应商报告称,更换搜索后端后,55 个客户问题的回答准确率从 36% 升至 98%。
要点建议
- 检索失败可能让智能体阅读更多文档、消耗更多 token,并错过所需证据。
- 解析、OCR 和分块可能丢失表格、图像等复杂文档的结构。
- 后期交互使用多个表示来描述查询和文档,而不是只用一个向量。
- 视觉检索和版面信息可以帮助将答案关联到具体来源。
- Mixedbread 报告一位客户的 55 问基准准确率从 36% 升至 98%;其他结果可能不同。
按章节阅读整理后的全文
证据获取问题
Shakir 介绍 Mixedbread,并说明为什么搜索大型混合资料库可能成本高昂。
Aamir Shakir 介绍了 Mixedbread,这家公司为智能体构建检索模型和搜索产品。他认为,智能体的困难往往不只是推理,还包括从组织数据中找到相关证据。
他以股票分析师为例:一个关于 Intel 内存选择的问题,可能需要搜索多个供应商提供的报告、访谈、播客和研究资料。大型资料库可能产生大量关键词匹配,却无法说明哪段内容最有用。
Shakir 说,如果智能体阅读太多候选文档,就可能在查找过程中消耗大量 token。PDF 还带来额外困难,因为文本、表格、扫描页面和图像不一定能可靠地作为纯文本搜索。
检索流程在哪里丢失信息
他批评了解析、OCR、分块和单向量表示,尤其是在处理复杂文档时。
他描述了常见的检索流程:解析或转写、OCR、分块、嵌入、向量搜索和重排序。在他看来,每次转换都可能丢失信息,尤其是在表格结构或图表未能保留时。
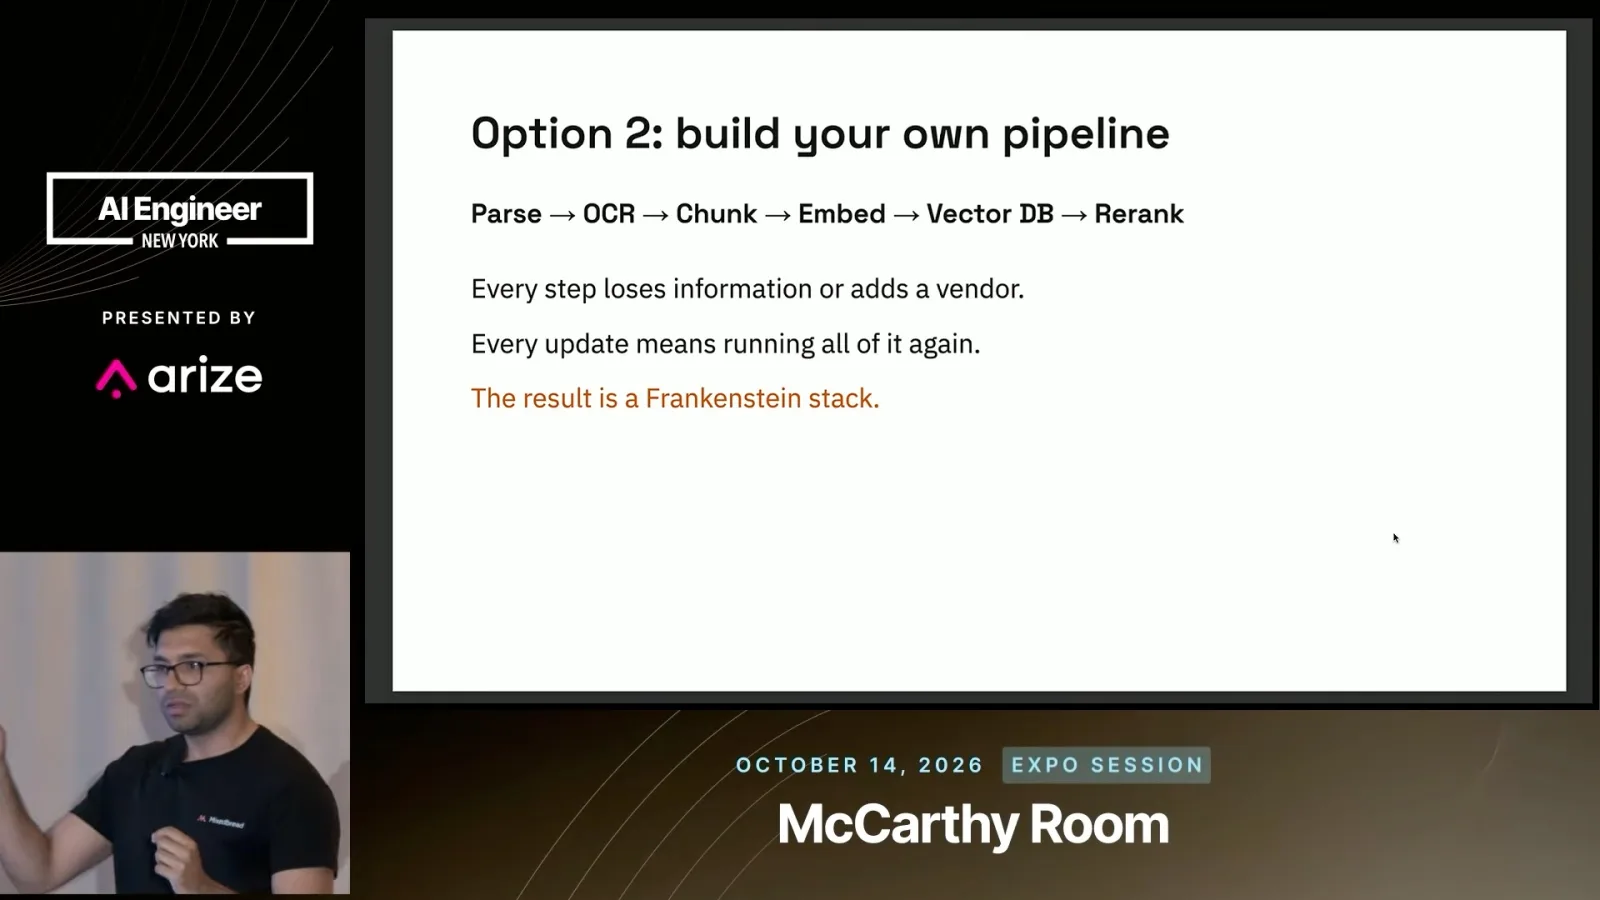
这套流程还可能要求团队评估和整合多家供应商。Shakir 将其称为“弗兰肯斯坦技术栈”,并认为协调这些组件可能需要数月。这是他作为检索供应商的判断,并非所有 RAG 系统的普遍结果。
他用单个向量表示一个文档块的例子说明限制。复杂财报包含许多事实;不同年份的报告在嵌入空间中可能很相似,而查询可能需要某个特定时期的精确数字。
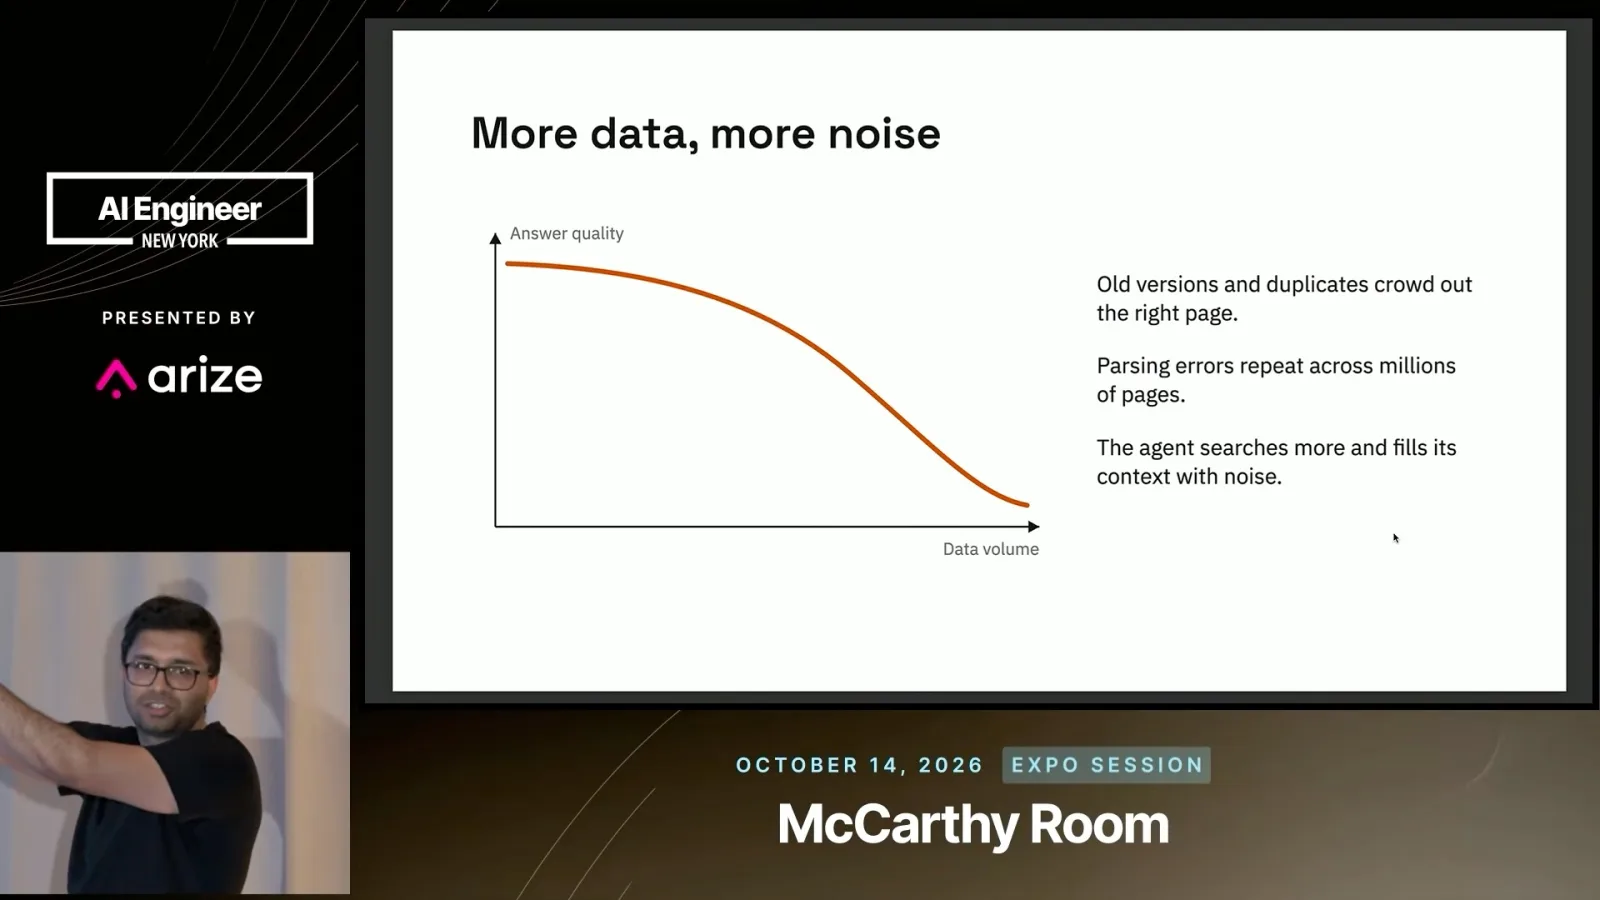
他说,随着资料库扩大,近似重复内容和提取错误可能让证据更难查找。智能体可能通过增加查询或启动更多工作者来补偿,从而扩大上下文并增加成本。
多模态检索与后期交互
他介绍公司的检索方法,并演示搜索金融报告。
Mixedbread 的观点是,相关数据的获取与模型智能是两个不同的瓶颈。Shakir 说,公司构建产品处理文本和其他模态的检索,同时允许客户为下游任务选择模型。
他简要回顾了从 BM25 等关键词搜索到嵌入模型的发展,并展示 Mixedbread 新检索模型的预览。他将这种提升描述为跨越式变化;图表是供应商提供的对比。
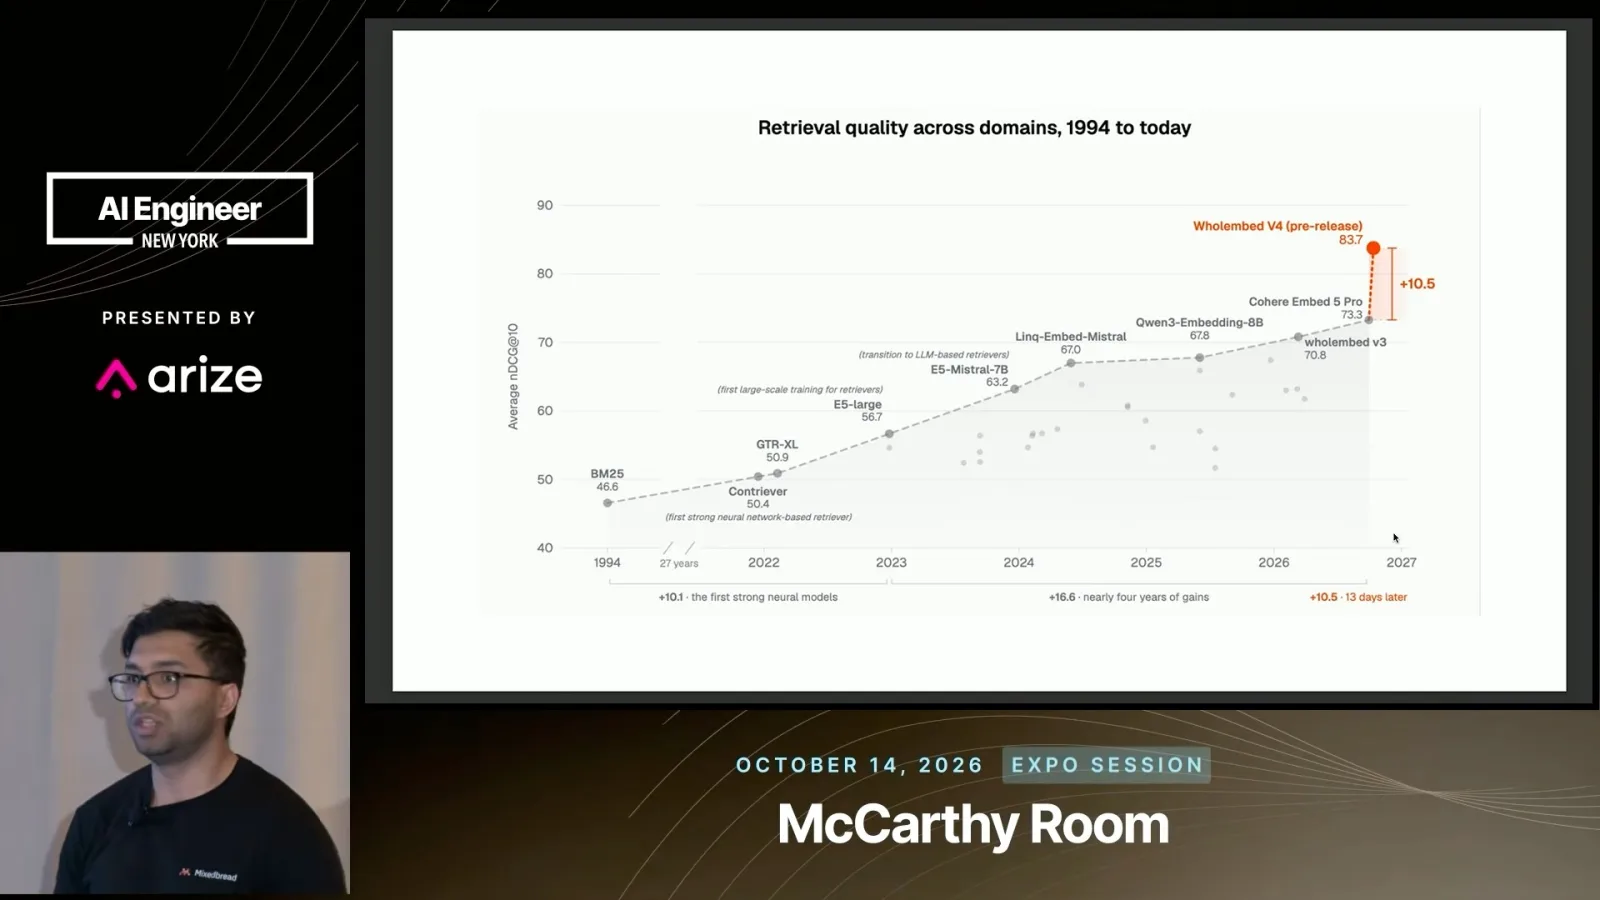
该模型使用后期交互:它用多个嵌入而不是单个向量表示文档和查询。Shakir 说,这可以保留更细粒度的信息,同时让这些表示包含页面上下文。
在演示中,他上传了 Intel 财报材料。他认为,页面的视觉表示可能保留纯 OCR 容易遗漏的图形关系;与此同时,OCR 和版面信息仍可供下游模型使用。
关于 Intel Foundry 营业利润率的查询返回了一些候选页面。Shakir 展示了版面和边界框如何支持引用,让用户或智能体能够把答案追溯到证据。现场演示遇到了网络响应缓慢的问题。
对于更复杂的定性问题,他介绍了一种会把请求拆解为多次搜索的智能体搜索模型。他声称,该模型在公司自己的比较中比大型通用模型更快、更便宜;演讲中没有提供独立方法细节。
一个客户结果
Shakir 报告对冲基金的基准结果并讨论 token 成本。这些数字由供应商提供。
Shakir 展示了一家对冲基金客户的案例。幻灯片显示,基准包含基于客户自有文档的 55 个问题,变更的是搜索后端。他报告说,采用 Mixedbread 后,回答准确率从 36% 升至 98%。
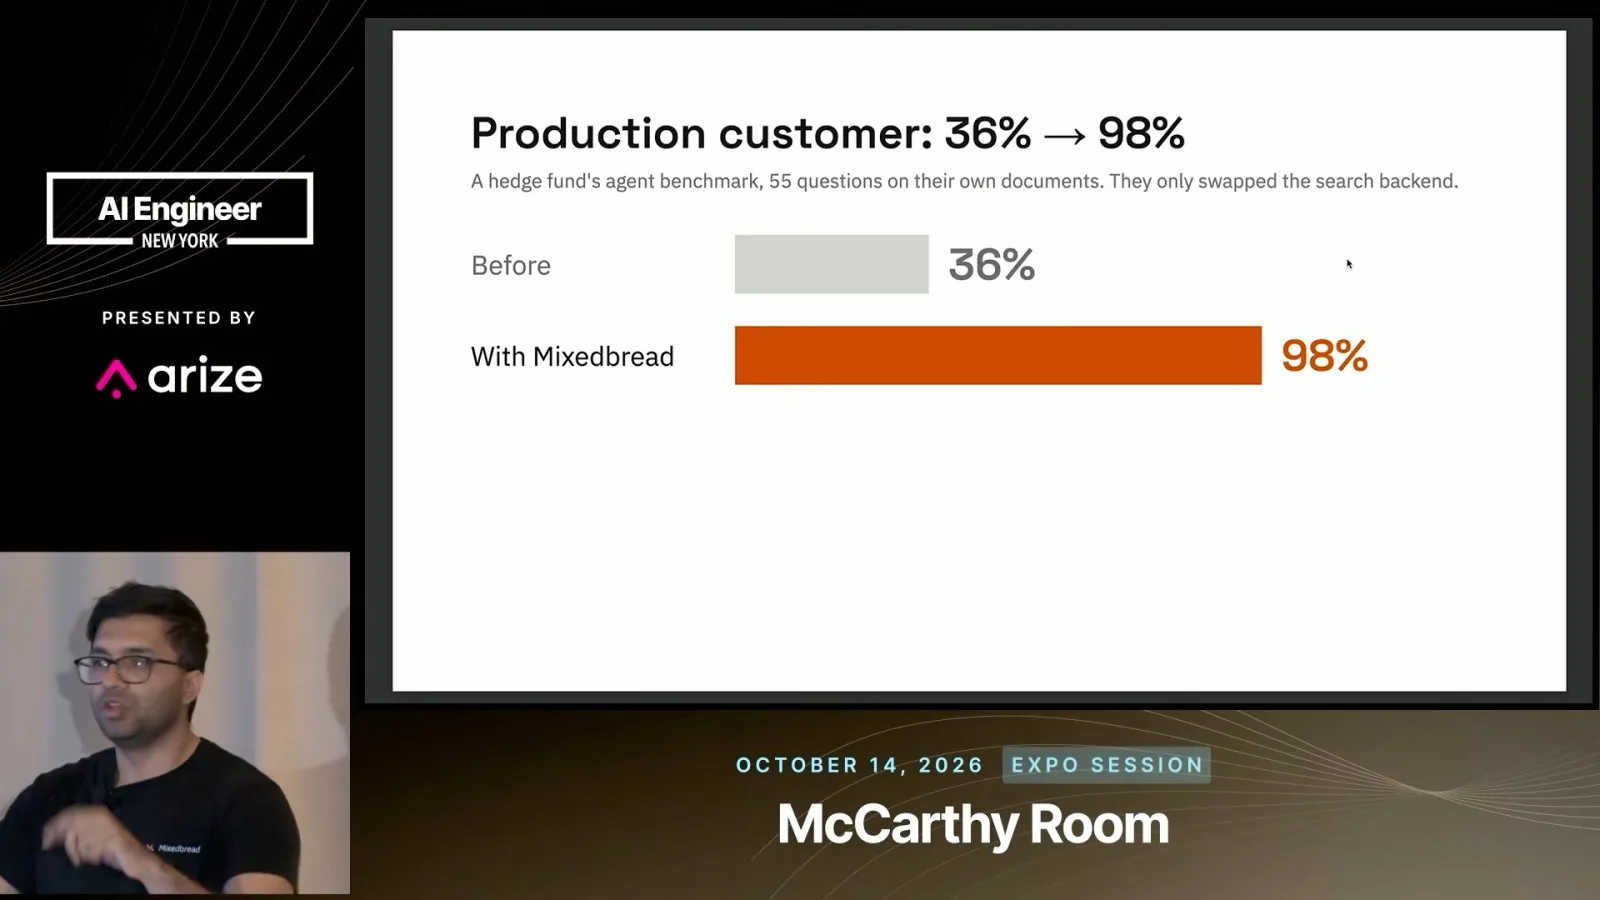
他还说,由于智能体获得了更好的上下文,客户使用的 token 更少,语言模型支出减少约三倍。这些是供应商报告的单客户结果,并不能保证其他资料库获得相同效果。
Shakir 总结说,检索质量会同时影响回答质量和成本,并邀请团队用自己的资料库测试产品。他的核心建议是评估系统能否找到完成任务所需的证据。
同频道的其他文章
 19:12EN → 简体中文
 AI Engineer· 2026年11月4日AI 智能体为什么需要可靠流程才能在公司内推广Mitchell Troyanovsky · BasisBasis 联合创始人 Mitchell Troyanovsky 介绍行为规范、轨迹分叉和生产智能体模拟。
 18:01EN → 简体中文AI Engineer· 2026年11月4日NatWest 如何在上线前测试面向客户的 AI 智能体Jonathan Osborne · NatWest GroupJonathan Osborne 介绍受监管银行的路由控制、人工验证、LLM 裁判问题和影子部署。
 19:48EN → 简体中文AI Engineer· 2026年11月4日为什么 Datasite 选择购买文档解析工具,而不是自己开发Adit Abraham, Raj Bakhru · ReductoRaj Bakhru 与 Reducto CEO Adit Abraham 讨论为交易数据室构建 AI 时的工程取舍。
 19:19EN → 简体中文AI Engineer· 2026年11月4日审批 AI 应用,而不是模型:一家银行如何建立评估关卡Doneyli De Jesus · Langfuse by ClickHouseDoneyli De Jesus 介绍一家银行如何用自己的数据测试 AI 智能体、加入计算器,并由领域专家设定上线门槛。
 16:51EN → 简体中文AI Engineer· 2026年11月3日Cristóbal Valenzuela 谈交互式视频模型与 Runway ContinuumCristóbal Valenzuela · RunwayRunway 联合创始人回顾从早期生成影片到交互式视觉界面研究原型的下一帧预测发展。
 19:42EN → 简体中文AI Engineer· 2026年11月3日AI 智能体的成本从何而来:缓存命中、输入 Token 与调用轮次George Cameron · Artificial AnalysisArtificial Analysis 联合创始人 George Cameron 拆解智能体基准测试,并介绍按成本与能力选择模型的方法。