30 秒看懂
NatWest 首席 AI 工程师 Jonathan Osborne 介绍了银行计划升级 Cora 助手时所做的评估和上线准备。他认为,在服务数百万客户的规模下,构建智能体比证明它安全更容易。 人工审查发现,普通场景与话题切换场景的表现差距很大;另一个已上线项目中的模型裁判则过于宽松,与人工评分相关性很低。Osborne 介绍了分层路由、持续评估和影子部署,并指出演讲时 Cora 的新能力尚未上线。
- 1缩小路由范围上下文过滤、确定性规则、分类和策略检查共同决定对话应进入哪个后端。
- 2不要只看平均值人工审查中,正常路径通过率为 97%,话题切换只有 43%。
- 3宽松的裁判可能已经失效投诉智能体的裁判评分集中在高位,与人工评分的相关性很低。
- 4评估是基础设施轨迹、定期评分和回归关卡让评估成为生产运营的一部分。
- 5先观察,再回答影子部署让系统接触真实输入,现有服务仍负责回复客户。
要点建议
- 路由漏斗利用规则和访问控制,减少进入模型处理环节的流量。
- 应分别评估安全性、任务完成情况和客户体验,而不是依赖单一准确率。
- 83% 的整体通过率掩盖了正常路径与话题切换之间 54 个百分点的差距。
- 如果裁判几乎给所有案例打高分,它与人工审查的相关性可能很低。
- 影子模式和功能开关把上线与回滚拆成更小、更可控的决策。
按章节阅读整理后的全文
面向客户的智能体风险
Osborne 介绍 Cora,以及银行规模下错误带来的更大后果,并比较脚本对话和生成式对话。
我是 NatWest Group 的首席 AI 工程师 Jonathan Osborne。在受监管的银行环境中,将智能体从原型推向面向客户的服务,难点更多在于证明它安全,而不是创建智能体本身。
NatWest 拥有约 1,900 万零售客户。数字助手 Cora 每天处理约 10 万次对话,过去大多数回答来自脚本。团队正在把约三分之一的服务流程转向检索支持的生成式回答,以及能够代客户执行操作的智能体。
规模改变了风险性质。错误回答不只是一个待修复的缺陷:它可能影响真实客户及其资金,引发监管审查并损害信任。这里的工作重点是获得上线批准,并学会信任自己的评估结果。
客户询问能否提前偿还抵押贷款时,脚本菜单可能无法解决问题。AI 助手可以利用知识库回答并处理话题切换,但如果对该客户的抵押贷款给出错误答复,就可能产生真实后果。
路由与多维质量
分层漏斗限制模型接触范围并实施策略控制。安全性、任务成功率和体验分别评估。
Osborne 列出四类失败模式:自信地编造答案、提示注入、准确但无帮助的循环,以及同样输入产生不同输出。为边界明确的脚本系统建立的回归断言,无法直接覆盖这些更广泛的情况。
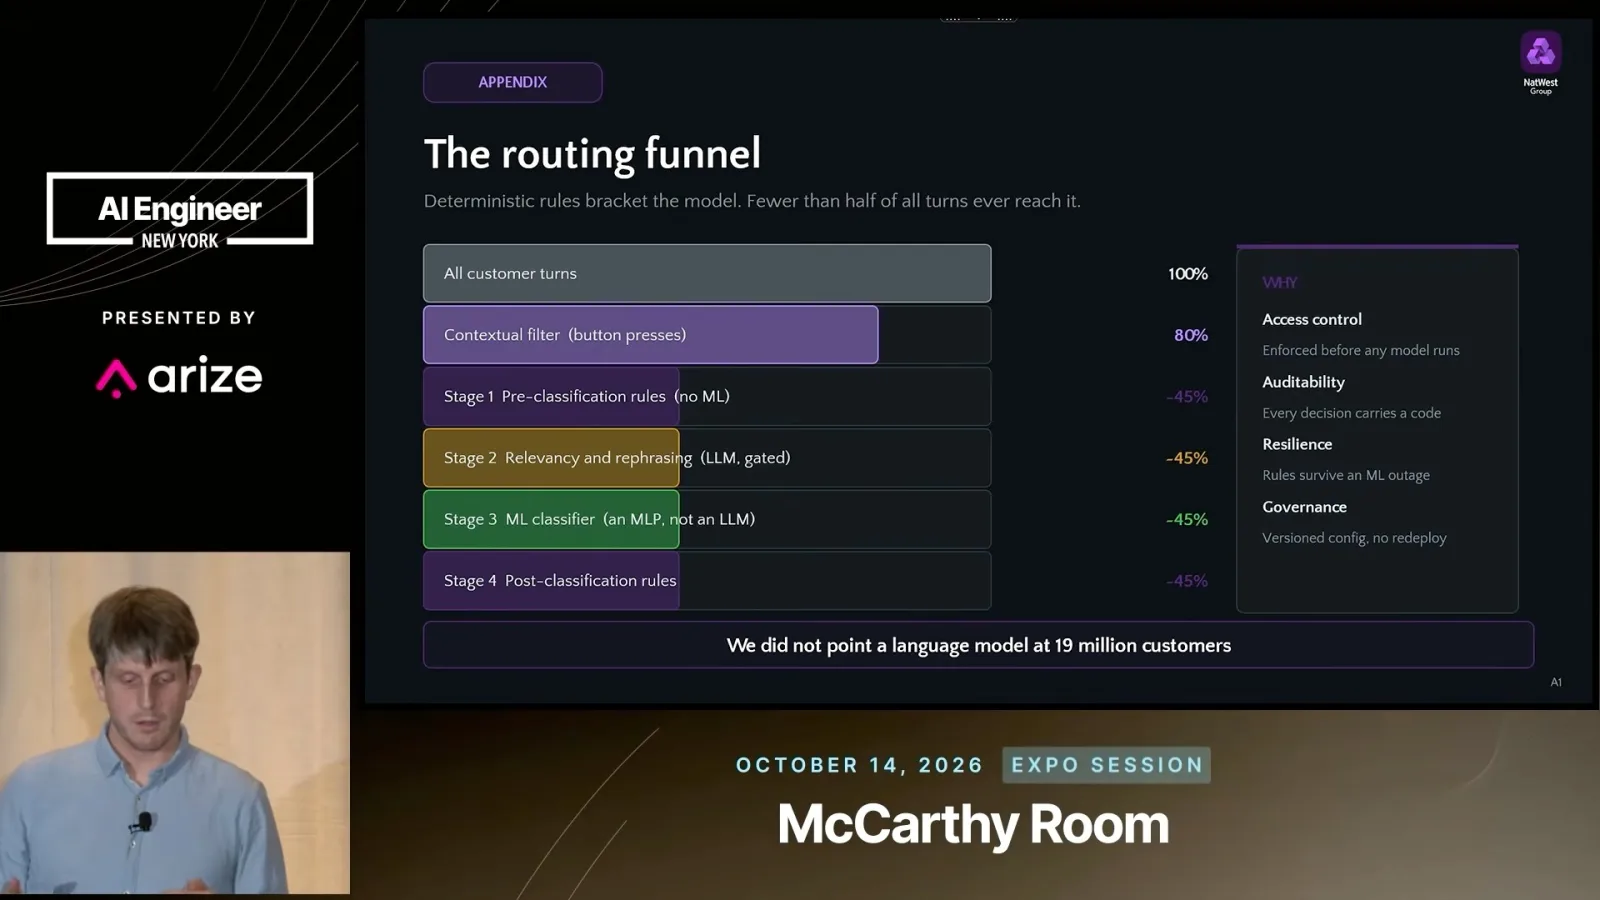
第一道防线是在模型加固前缩小其接触范围。路由漏斗先过滤常见事件,再应用确定性的预分类规则;剩余输入经过相关性与改写步骤、基于嵌入的意图分类器以及策略规则。
这种设计支持访问控制、可审计性、韧性和治理。每个决策都有代码可追溯;模型故障时规则仍可运行;带版本的配置无需完整重新部署即可调整。团队首先判断哪些问题真正需要模型解决。
单一的路由准确率无法说明回答是否有依据、是否解决客户问题,或是否知道何时转交人工。因此 NatWest 把质量看作一个向量:分别评分和监控安全性、任务完成情况与体验。
人工审查与不可靠的裁判
人工评分发现话题切换表现较差,审查者之间也存在分歧。另一个投诉项目暴露了过于宽松的模型裁判。
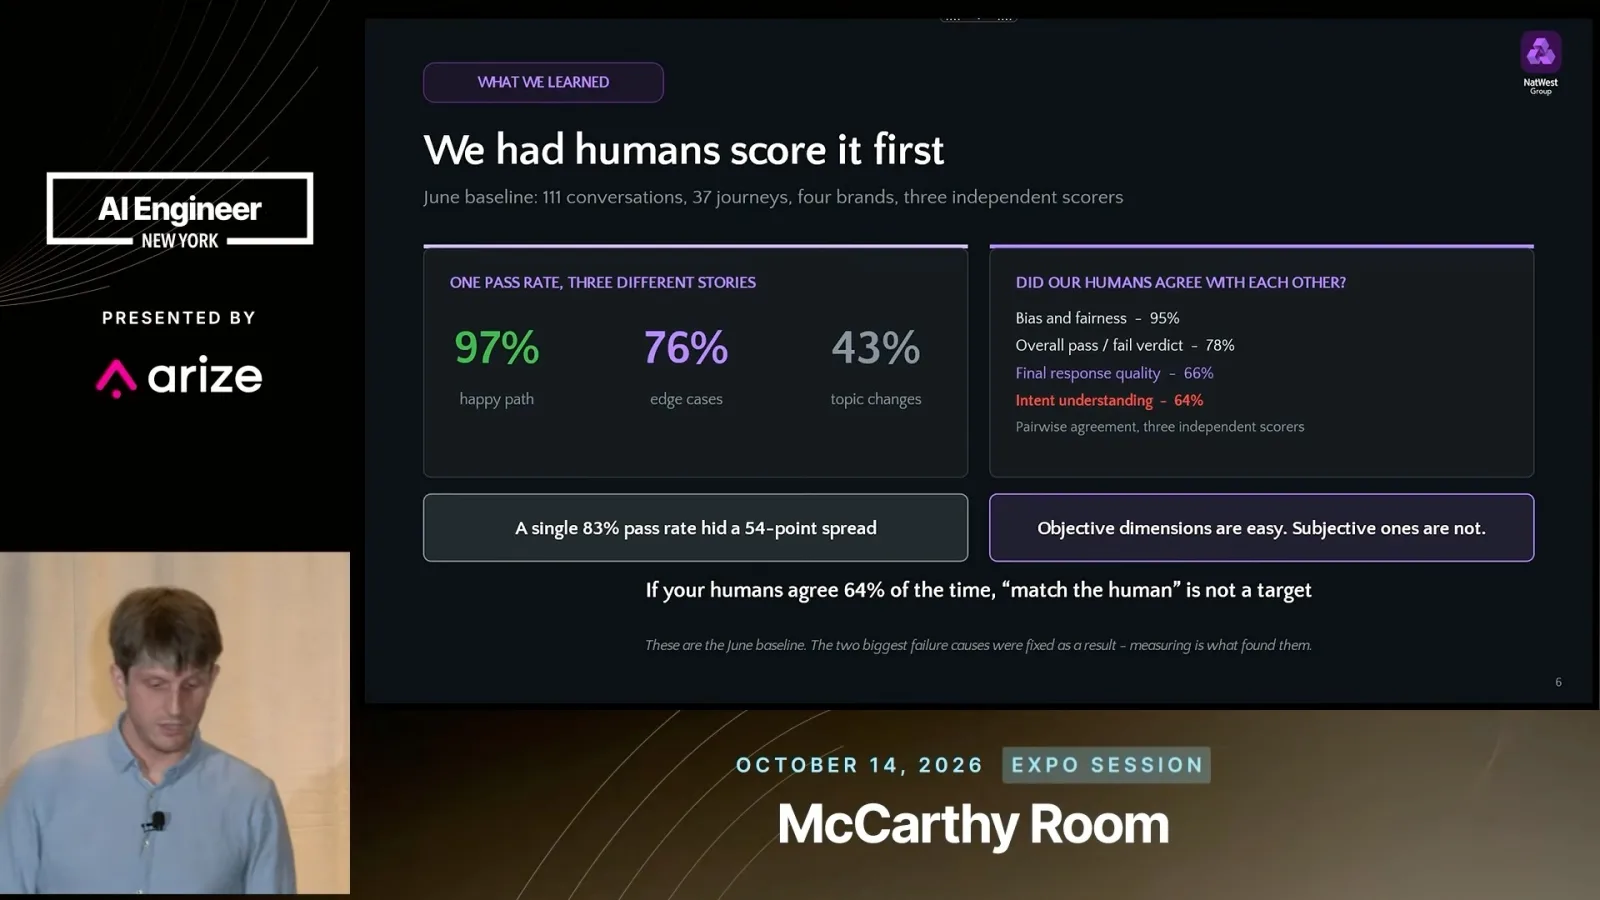
在自动化评估之前,团队先让人工审查 111 段对话,覆盖 37 条支付流程和四个品牌,每段对话由三名独立审查者评分。整体通过率为 83%。
这个汇总数字掩盖了 54 个百分点的差距:正常路径通过率为 97%,边缘情况为 76%,话题切换只有 43%。两个最大的失败原因是工程问题,而不是模型本身的问题;人工验证发现了它们。
审查者之间的一致性也不一样。偏见和公平性方面的一致率为 95%,但对意图理解只有 64%。Osborne 因此提出:当人工审查者自己也不总是一致时,要求自动裁判匹配人工究竟意味着什么?
为了分析 LLM 裁判,他转向另一个已经上线的内部投诉助手。该助手为投诉处理人员撰写摘要;约 1.4 万个案例同时获得了人工和 LLM 裁判评分。
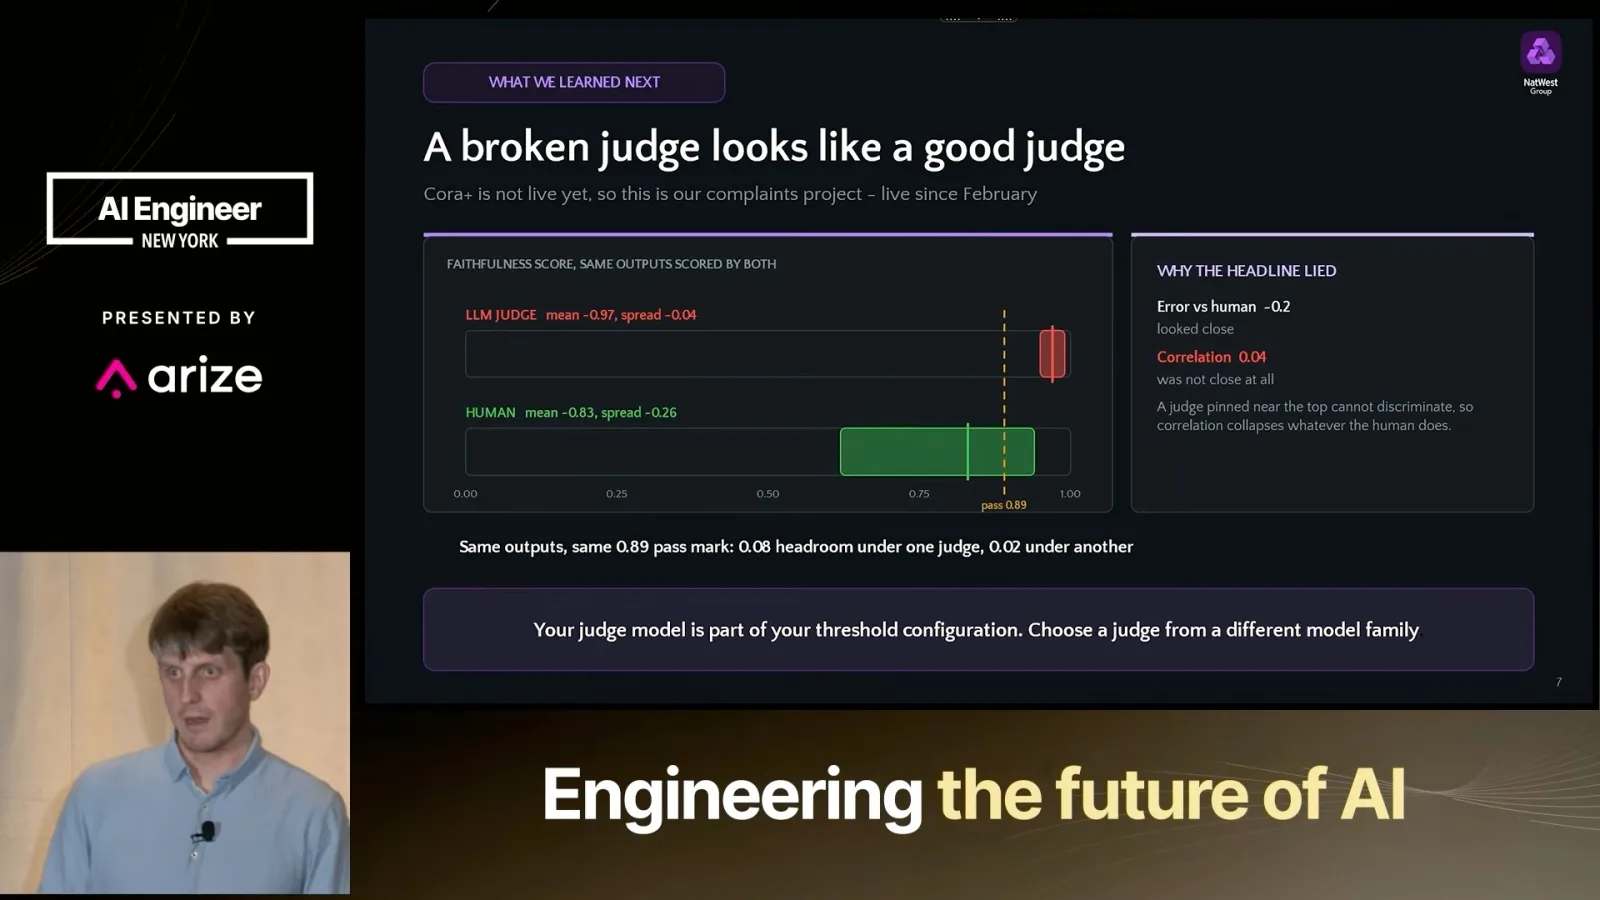
在忠实度指标上,裁判平均分约为 0.97,分布很窄;人工平均分为 0.83,分布宽得多。幻灯片显示两者相关系数只有 0.04:几乎总是打高分的裁判难以可靠地区分好坏案例。
仅更换裁判模型,就改变了分数相对于通过门槛的位置。因此裁判本身也是评估配置的一部分,可能引入破坏性变化。Osborne 说,让裁判和智能体使用不同模型家族,有助于拉近评分。
持续评估与监控
轨迹、采样和定期评分组成评估工作流。生成式回归与分类器漂移需要不同的监控方法。
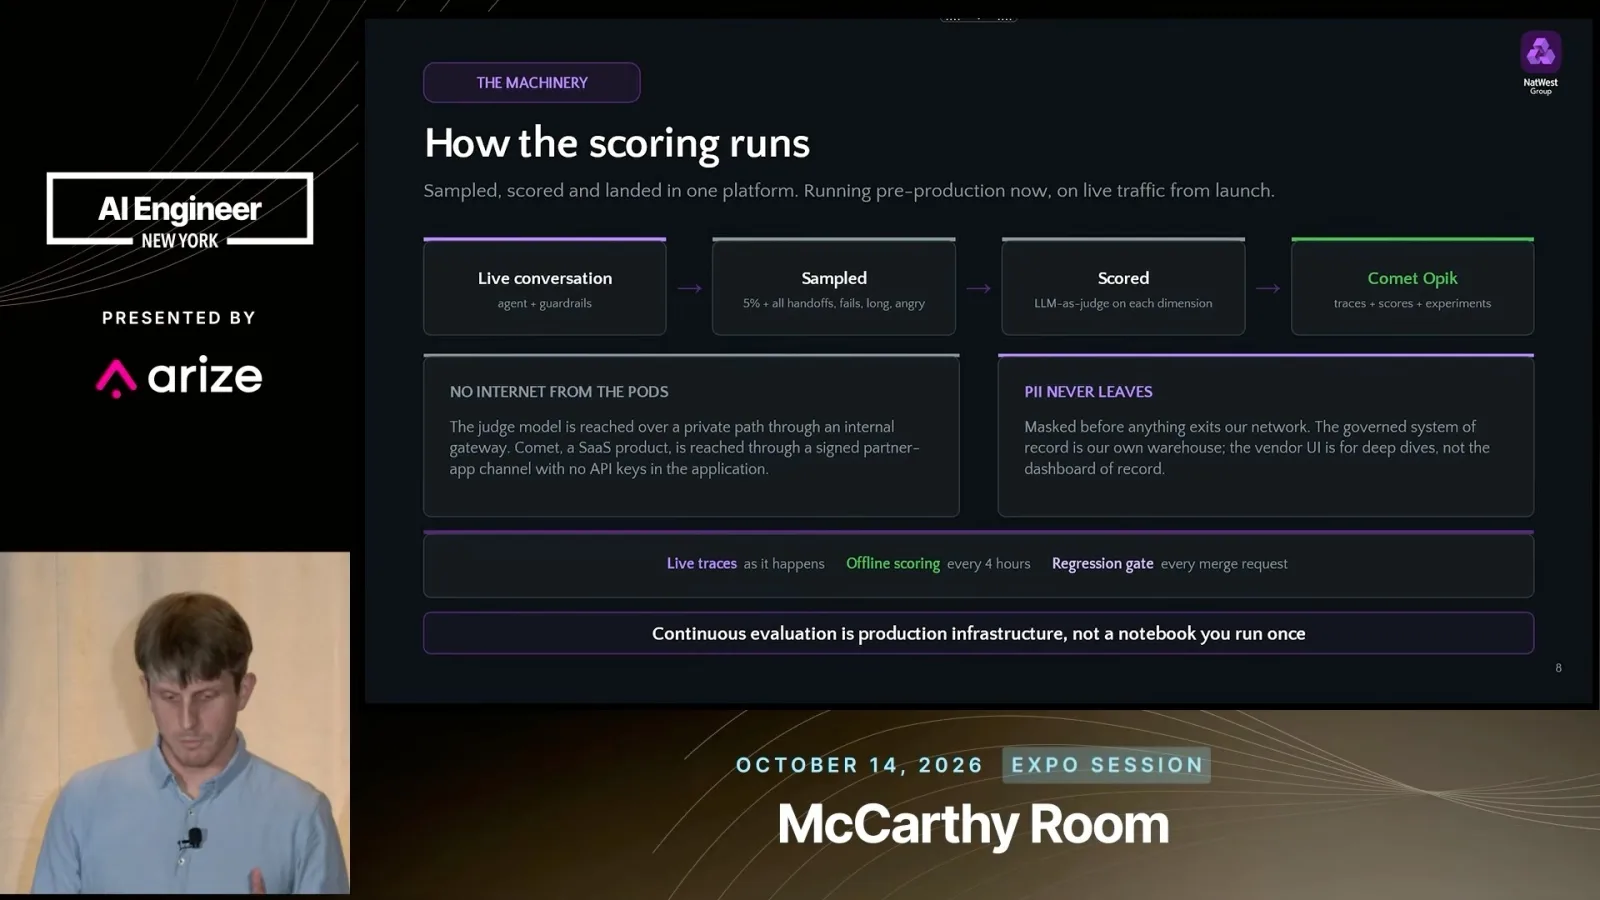
对于 Cora,团队使用开放标准记录对话及护栏轨迹。他们随机抽取 5% 的样本,同时额外选取转人工、失败、长对话和客户愤怒等案例,再让裁判按选定维度评分。
设计必须遵守银行约束:应用不直接访问互联网,通过私有路径连接裁判,并防止个人身份信息离开网络。轨迹持续记录,离线评分每四小时运行一次,结果进入监控系统。
提示词或上下文的变化可能带来很大影响。CI/CD 中的强制回归关卡将变更与已知良好基线比较。Osborne 称持续评估是生产基础设施,而不是上线时运行几次的 notebook。
生成式智能体和传统意图分类器需要不同的监控工具。提示词变化可能引起生成式回归;客户语言变化则可能使分类器随时间漂移。团队观察特征漂移和基于人工标签的 F1 分数,决定何时重新训练。
影子部署与反馈
团队计划通过功能开关和回滚能力分阶段上线。投诉项目中的人工反馈成为有价值的评估数据。
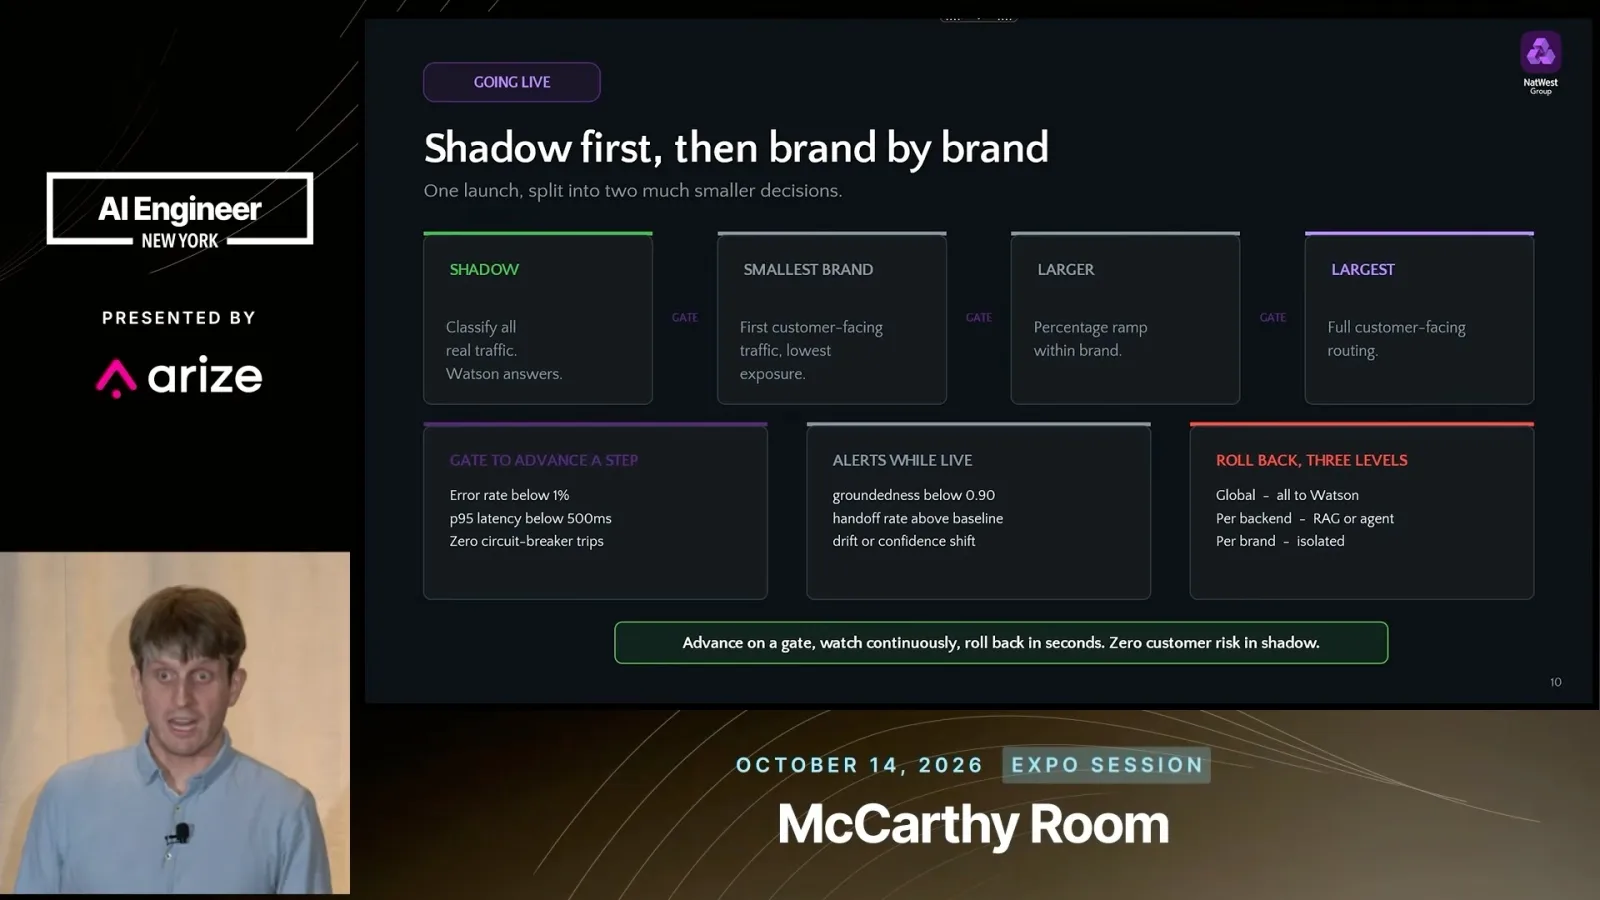
上线从影子模式开始:新系统对真实客户输入进行分类,但仍由现有脚本系统负责回答。这样,团队可以在允许新系统回复客户之前观察生产环境中的输入。
随后银行计划按品牌和流量比例逐步推进,并根据指标决定继续还是停止。有些决策自动执行,有些需要人工批准。功能开关支持全局回滚,也能在几秒内隔离特定后端或品牌。
在投诉项目中,反馈本身就是一道关卡:处理人员想重新运行调查,必须先解释原因。这积累了约 1.4 万条有价值的员工标注,可供项目改进评估。
Osborne 最后的建议是校准裁判时比较分布和相关性,而不是只看平均值。评估系统可以在不同智能体之间复用。演讲时,Cora 的新能力尚未上线,预计次月推出。
同频道的其他文章
 19:12EN → 简体中文
 AI Engineer· 2026年11月4日AI 智能体为什么需要可靠流程才能在公司内推广Mitchell Troyanovsky · BasisBasis 联合创始人 Mitchell Troyanovsky 介绍行为规范、轨迹分叉和生产智能体模拟。
 19:48EN → 简体中文AI Engineer· 2026年11月4日为什么 Datasite 选择购买文档解析工具,而不是自己开发Adit Abraham, Raj Bakhru · ReductoRaj Bakhru 与 Reducto CEO Adit Abraham 讨论为交易数据室构建 AI 时的工程取舍。
 19:19EN → 简体中文AI Engineer· 2026年11月4日审批 AI 应用,而不是模型:一家银行如何建立评估关卡Doneyli De Jesus · Langfuse by ClickHouseDoneyli De Jesus 介绍一家银行如何用自己的数据测试 AI 智能体、加入计算器,并由领域专家设定上线门槛。
 16:51EN → 简体中文AI Engineer· 2026年11月3日Cristóbal Valenzuela 谈交互式视频模型与 Runway ContinuumCristóbal Valenzuela · RunwayRunway 联合创始人回顾从早期生成影片到交互式视觉界面研究原型的下一帧预测发展。
 19:42EN → 简体中文AI Engineer· 2026年11月3日AI 智能体的成本从何而来:缓存命中、输入 Token 与调用轮次George Cameron · Artificial AnalysisArtificial Analysis 联合创始人 George Cameron 拆解智能体基准测试,并介绍按成本与能力选择模型的方法。
 20:35EN → 简体中文AI Engineer· 2026年11月3日面向智能体的图工程:显式流程、记忆与治理Zachary Blumenfeld · Neo4jNeo4j 的 Zachary Blumenfeld 介绍三类图,并演示图结构的贷款审核技能。