30 秒看懂
Langfuse by ClickHouse 的 Doneyli De Jesus 介绍了团队与一家排名前五的银行共同建立的评估框架。黄金数据集、执行轨迹和各项独立质量门槛,为决定 AI 应用能否上线提供依据。 在他的案例中,一个模型的事实依据率为 97%,数值准确率却只有 60%;加入计算器后,据称后者升至约 95%。领域专家负责设定门槛和审查失败案例,智能体发生变更后则重新评估。
- 1用自己的数据评估公开基准无法证明某个银行应用能在内部任务上表现良好。
- 2有依据不等于算得对案例模型的事实依据率为 97%,数值准确率却只有 60%。
- 3加入计算器确定性工具负责算术计算后,据称数值准确率升至约 95%。
- 4每个关卡都重要平均分不能抵消合规等独立必需项目的失败。
- 5让专家参与领域专家审查失败轨迹,并帮助改进黄金数据集。
要点建议
- 公开模型基准无法取代基于组织自身数据和业务场景的评估。
- 应根据独立的质量和合规关卡,审批应用及其配置。
- 案例中加入计算器后,据称智能体的数值准确率从 60% 升至约 95%。
- 结合确定性检查、路径评估和模型裁判,避免依赖单一分数。
- 领域专家设定门槛,并将审查过的失败案例转化为更好的测试用例。
按章节阅读整理后的全文
为什么银行审批应用
De Jesus 解释了为什么公开基准和模型审批不足以满足受监管银行的要求。银行还需要控制部署环境和数据。
我在 Langfuse by ClickHouse 负责 AI 工程解决方案。我们帮助一家排名前五的银行设计安全关卡和评估流程,以便将 AI 应用投入生产。
公开模型基准能衡量有价值的技术能力,但未必能预测模型在银行内部数据和业务场景中的表现。金融机构尤其重视保护自己的数据,以及嵌入工作流程中的专业知识。
例如,一款分析师助手要为投资银行家处理财报电话会记录。仅仅总结文字还不够:应用需要了解机构的背景和专业知识,其输出也必须按银行的要求接受可靠评估。
这家银行的原则是审批应用,而不是审批模型。同一个模型可以支持许多应用,而每个应用的风险和审批标准都不同。
银行还对部署提出要求:系统应在自己的环境中运行,访问受到控制,敏感工作流需要物理隔离。即使外部提供商承诺不保留数据,银行也希望自己掌握控制权。
从黄金数据到上线关卡
代表性数据集和轨迹证据支持可重复评估。独立门槛决定配置是否可以上线。
团队需要证明三件事:应用按预期工作、满足合规要求,并且足够好用,让人愿意采用。系统提示词、模型或工具一旦改变,都应重新判断应用是否仍适合上线。
基础是黄金数据集:包含输入、预期输出和元数据的代表性测试用例。许多银行已经有测试数据,缺少的可能是让评估过程可重复、可实际运行的机制。
每次运行都会生成轨迹,记录应用在数据集评估中做了什么。这些轨迹成为证据,选定维度上的分数则决定某个配置能否通过关卡。
用工具改善数值准确率
模型回答有良好依据,却不擅长算术。加入计算器后,据称准确率有所提高。
一个被测试的模型在事实依据率上达到 97%,说明它的回答基于银行数据;但数值准确率只有 60%。即便引用了正确文档,回答仍可能在计算金融数字时出错。
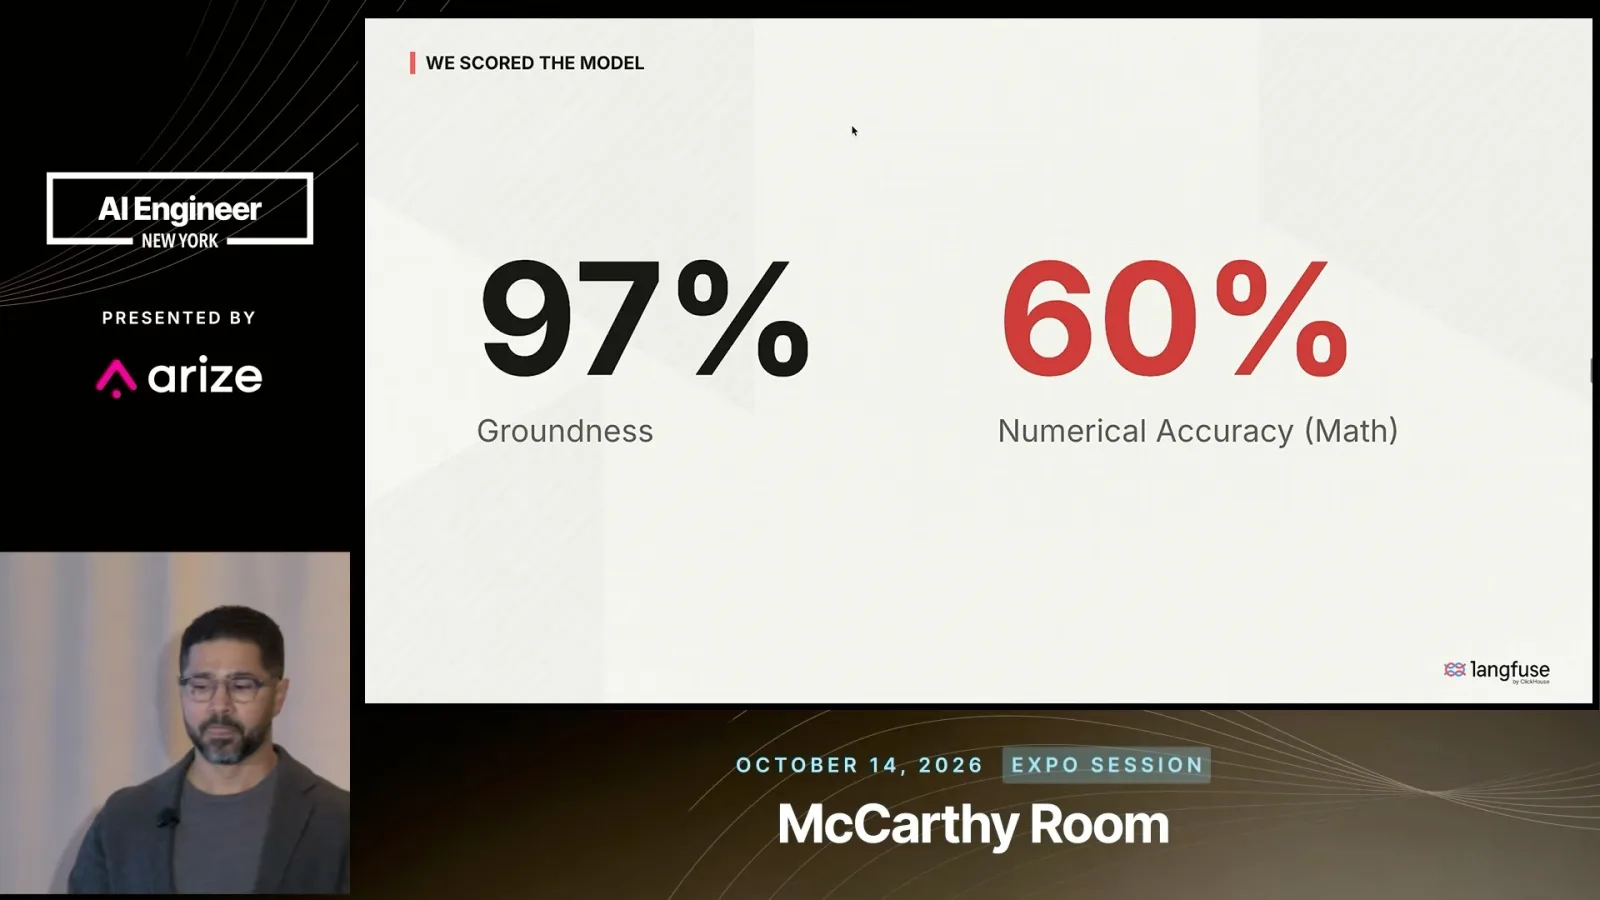
解决办法是改进整个应用,而不是只寻找另一个模型。团队给智能体加入计算工具,让确定性代码处理模型不擅长的算术。
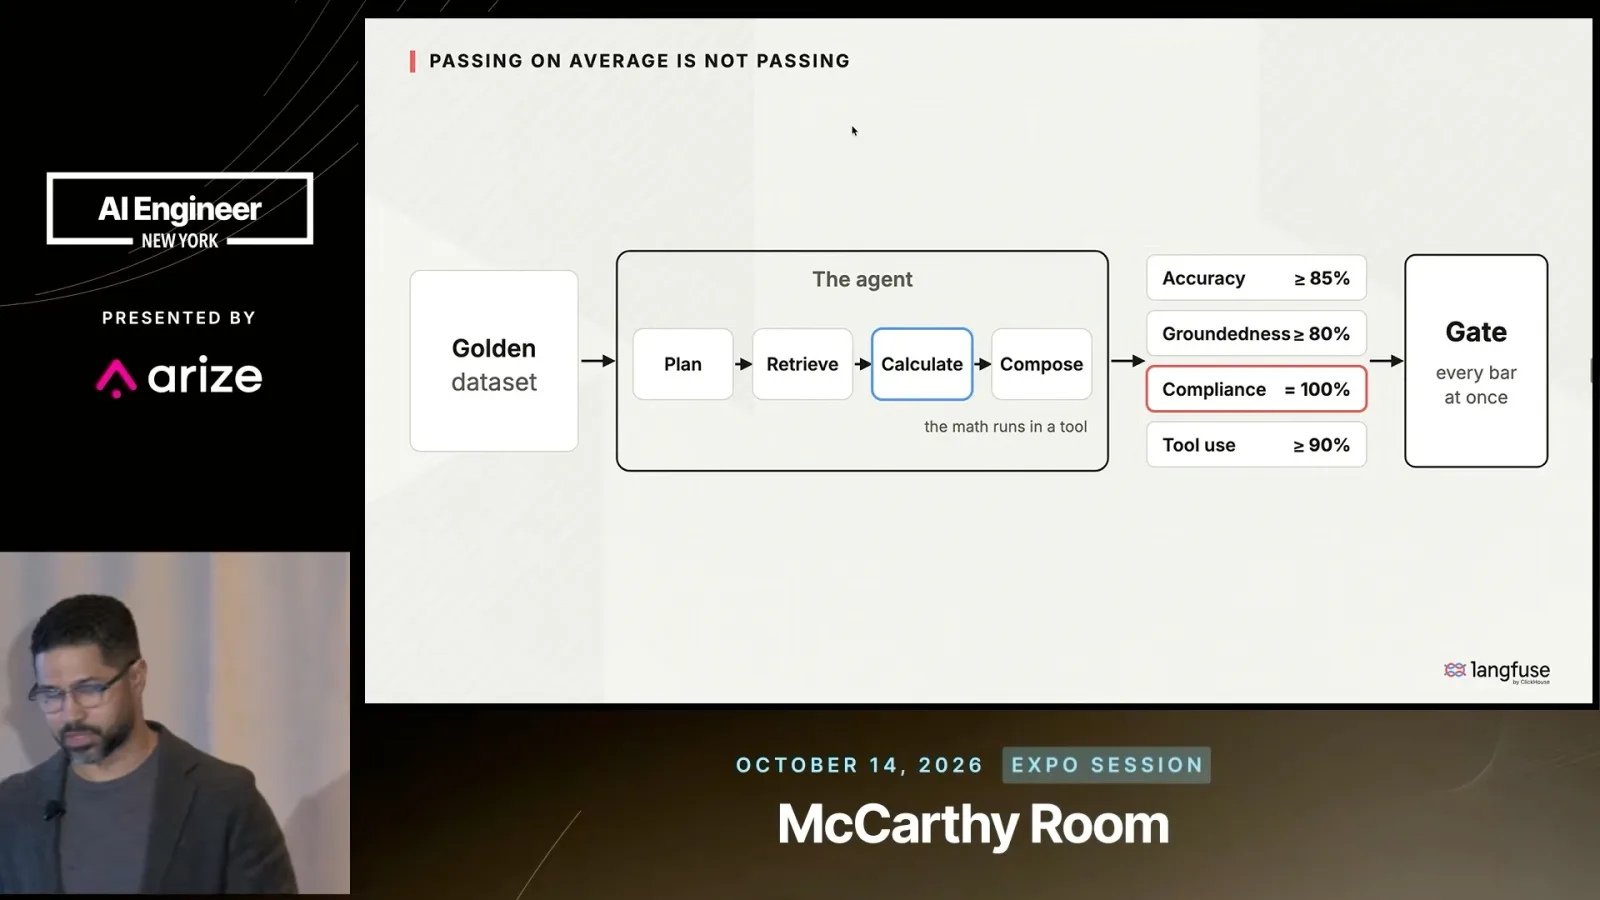
图示工作流从黄金数据集开始,依次经过规划、检索、计算和回答生成。随后,应用需要分别通过准确率、事实依据率、合规和工具使用等门槛。
平均分达标并不够。每个维度可以有不同的最低要求,任何必需关卡不通过都可能阻止应用上线。具体规则取决于银行对该业务场景的要求。
测试用例将输入、预期输出和元数据配对。建立这样的私有基准,能让组织用更接近自身实际工作的任务评估智能体的回答、行为和质量。
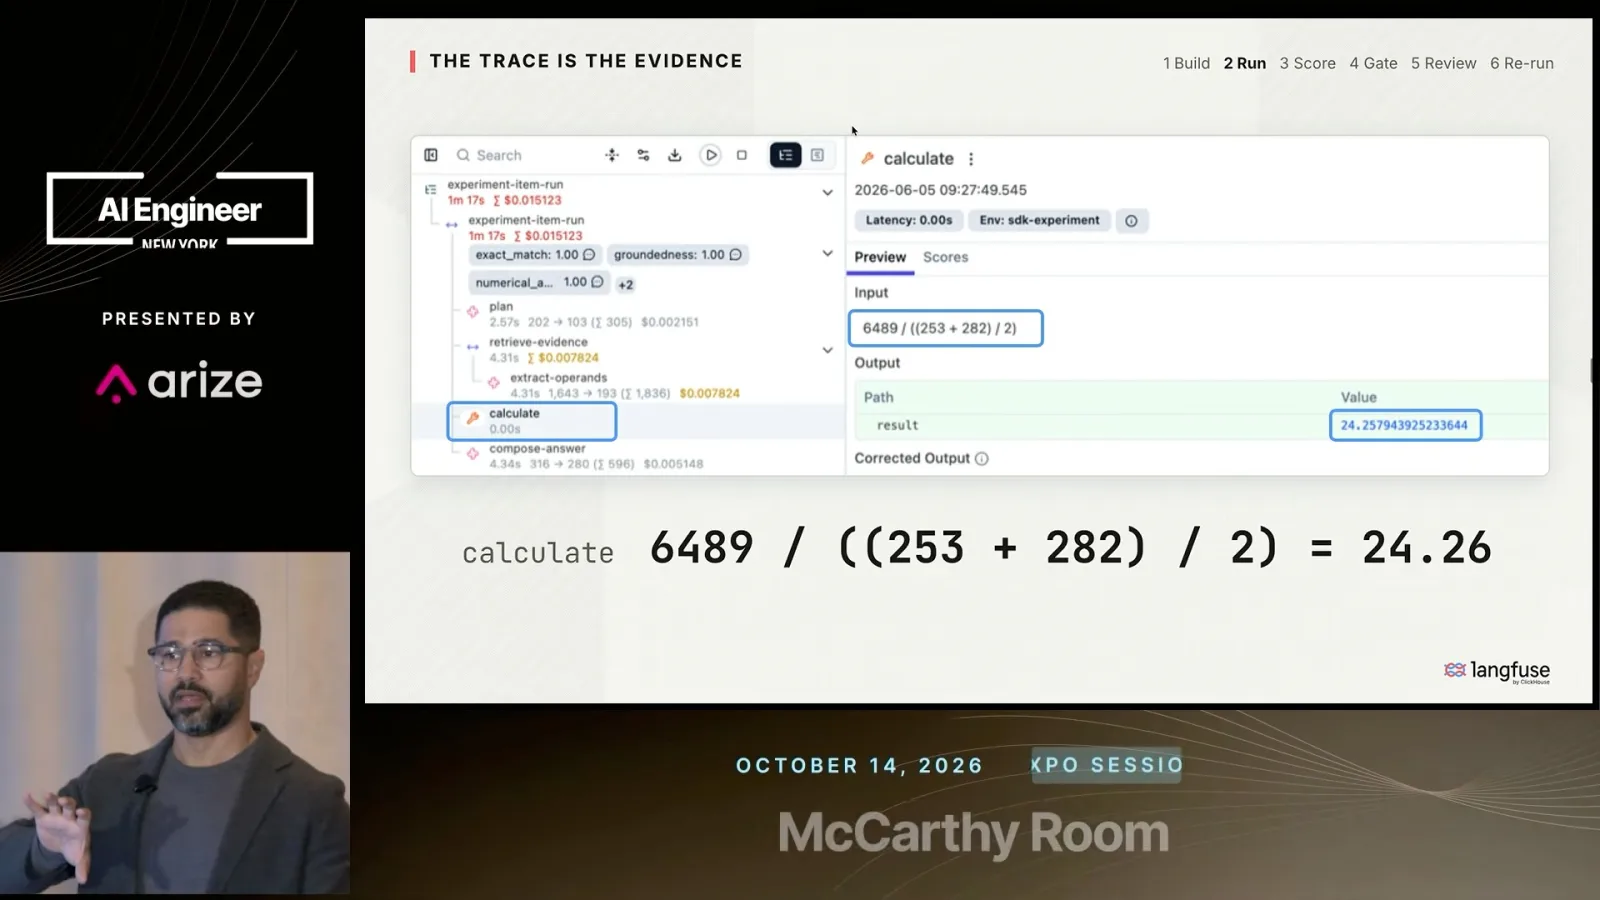
改进后智能体的轨迹显示,计算器接收一个表达式并返回结果。De Jesus 说,在这个案例中,加入工具使数值准确率从 60% 升至约 95%。
评分与证据
确定性检查、路径评估和模型裁判分别衡量智能体的不同方面。轨迹将评估结果与配置变更关联起来。
评分应结合多种方法。确定性检查用代码对相同输入给出相同结果;团队还评估智能体采用的路径,因为看似合理的最终答案可能掩盖遗漏或不恰当的步骤。
大语言模型裁判可以评估回答中较为定性的方面,但 De Jesus 提醒不要只依赖模型裁判。这些评估共同衡量多个维度,帮助应用通过银行设定的 85% 准确率门槛。
证据还可以把结果与配置变更联系起来:提示词、模型和工具都能与每次运行产生的轨迹及分数对应,从而看出哪些改变改善或损害了结果。
领域专家与反馈循环
专家设定门槛并审查失败案例。反馈可以改善测试用例,配置变更则会触发新一轮评估。
领域专家必须参与设定门槛。例如,风险团队可以决定内部或面向客户的风险应用需要达到什么水平;合适的标准取决于具体场景。
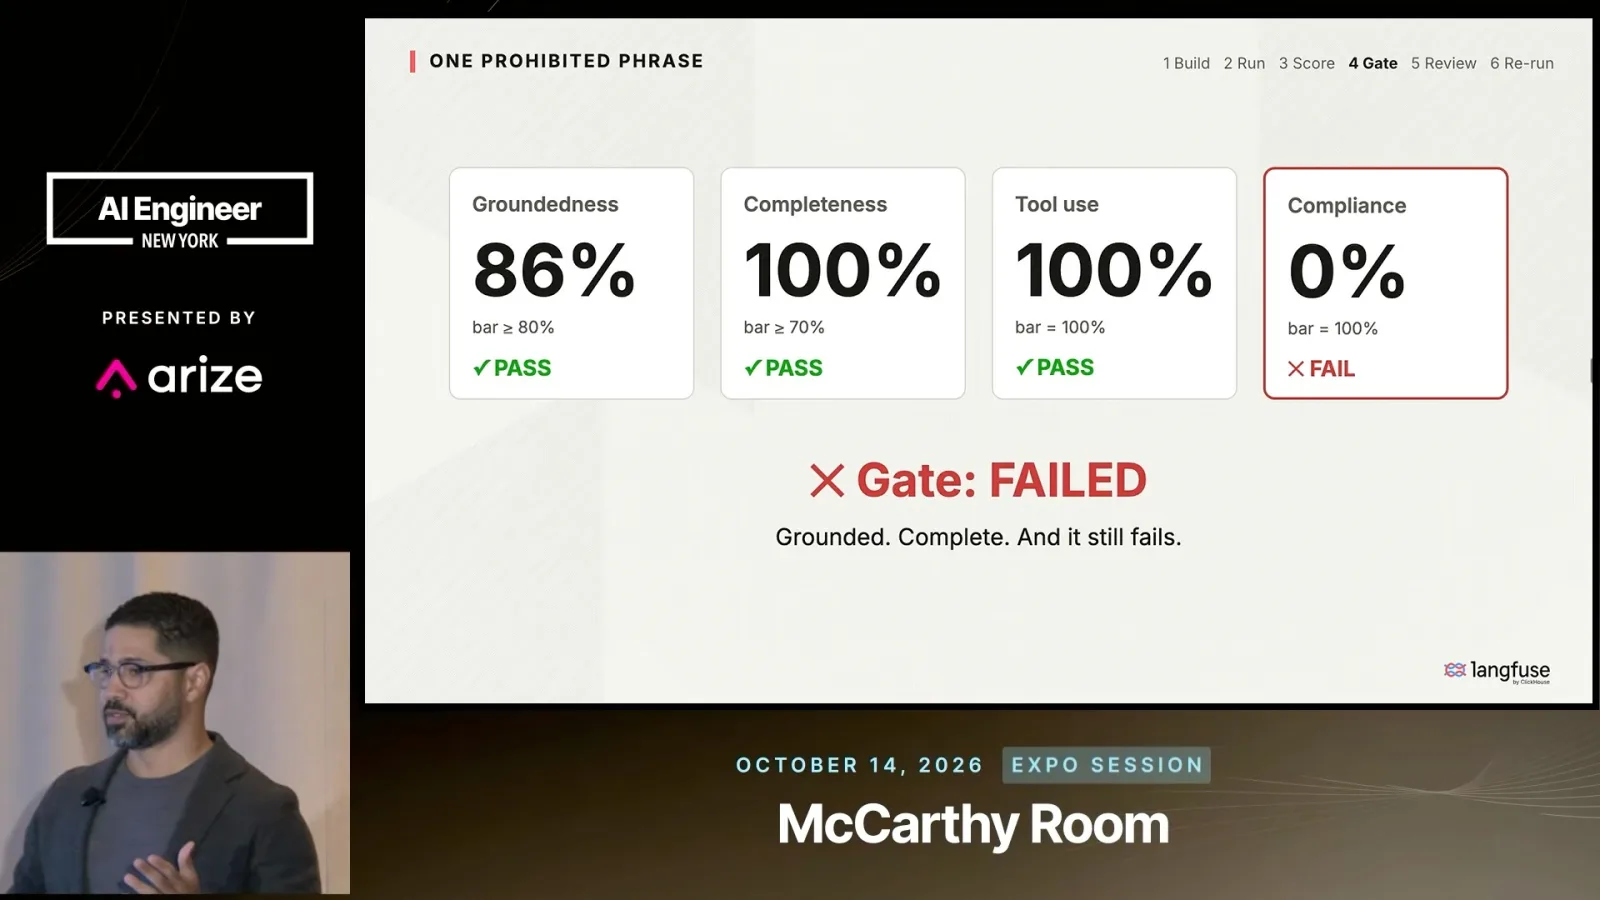
De Jesus 展示了在 150 个和 1,500 个问题的数据集上运行的评估。应用可能在事实依据、完整性和工具使用方面通过,却在合规方面失败。对银行而言,合规失败足以让整个关卡不通过,无论平均分多高。
失败案例可以送入标注队列,交给领域专家。审查者查看轨迹、找出发生了什么,再提供反馈,供团队改进智能体。
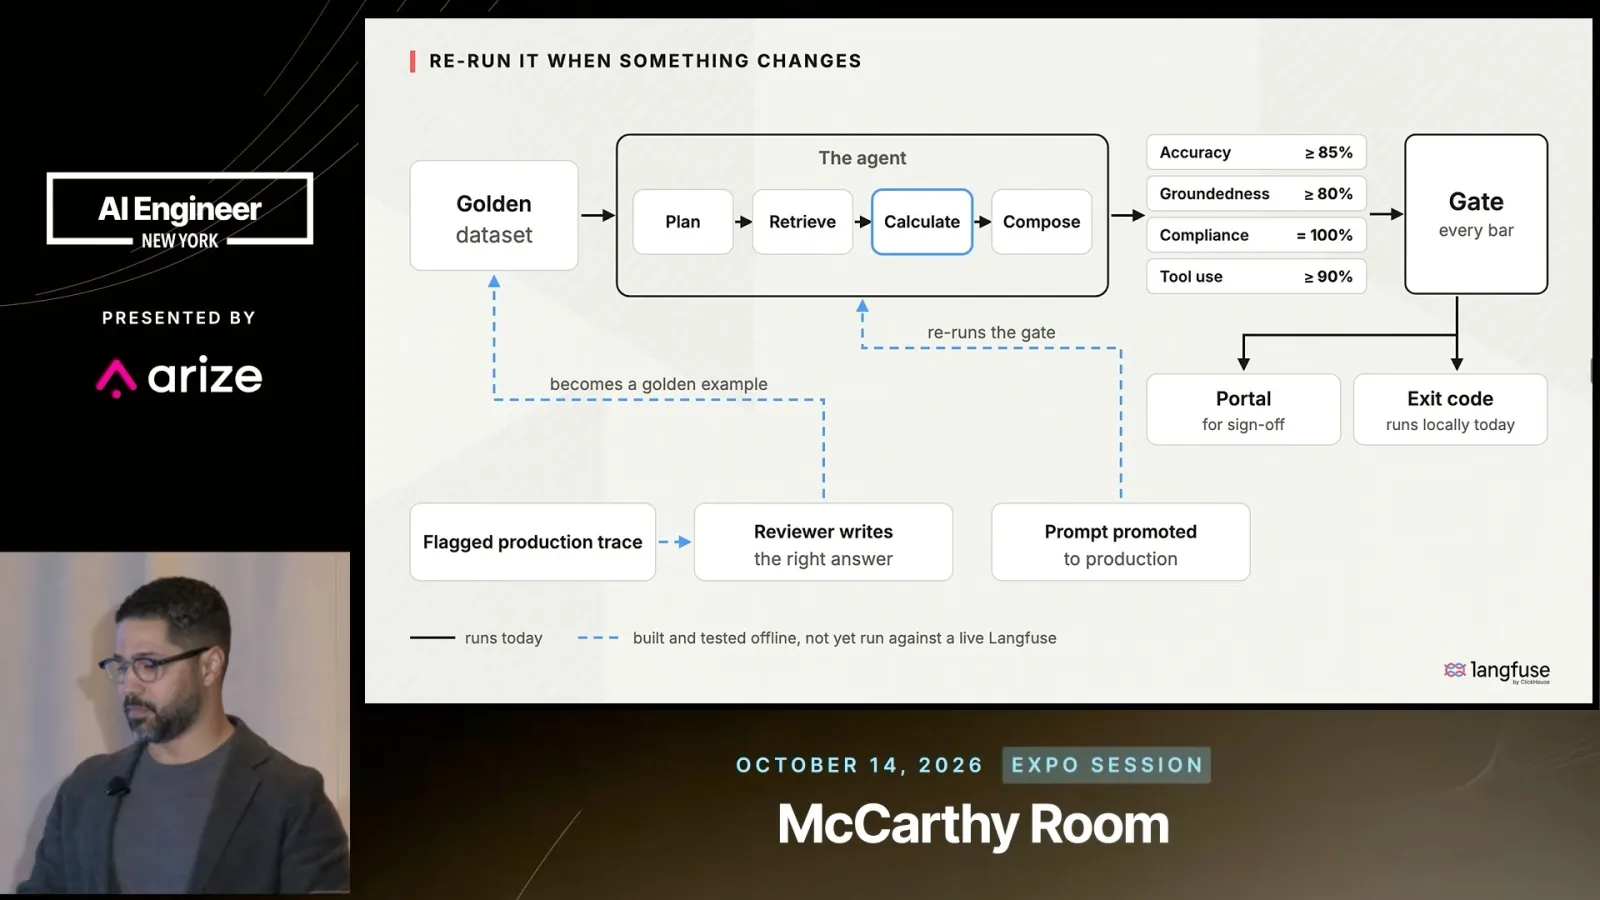
提示词或其他配置发生变化时,流程会重新运行评估。经过审查的样例可以成为黄金数据集的候选内容,让团队从实际失败中不断改进基准。
De Jesus 说,这套流程帮助他们把应用评估从数周缩短到数分钟;某些风险和合规场景的审查原本甚至可能需要数月。他强调,这个行业仍在发展,没有通用模板。
他最后建议:用自己的数据建立基准,审批应用而不是模型,并让领域专家确定相关门槛。有了这些控制措施,团队更容易用同一套应用专属标准评估模型替换。
同频道的其他文章
 19:12EN → 简体中文
 AI Engineer· 2026年11月4日AI 智能体为什么需要可靠流程才能在公司内推广Mitchell Troyanovsky · BasisBasis 联合创始人 Mitchell Troyanovsky 介绍行为规范、轨迹分叉和生产智能体模拟。
 18:01EN → 简体中文AI Engineer· 2026年11月4日NatWest 如何在上线前测试面向客户的 AI 智能体Jonathan Osborne · NatWest GroupJonathan Osborne 介绍受监管银行的路由控制、人工验证、LLM 裁判问题和影子部署。
 19:48EN → 简体中文AI Engineer· 2026年11月4日为什么 Datasite 选择购买文档解析工具,而不是自己开发Adit Abraham, Raj Bakhru · ReductoRaj Bakhru 与 Reducto CEO Adit Abraham 讨论为交易数据室构建 AI 时的工程取舍。
 16:51EN → 简体中文AI Engineer· 2026年11月3日Cristóbal Valenzuela 谈交互式视频模型与 Runway ContinuumCristóbal Valenzuela · RunwayRunway 联合创始人回顾从早期生成影片到交互式视觉界面研究原型的下一帧预测发展。
 19:42EN → 简体中文AI Engineer· 2026年11月3日AI 智能体的成本从何而来:缓存命中、输入 Token 与调用轮次George Cameron · Artificial AnalysisArtificial Analysis 联合创始人 George Cameron 拆解智能体基准测试,并介绍按成本与能力选择模型的方法。
 20:35EN → 简体中文AI Engineer· 2026年11月3日面向智能体的图工程:显式流程、记忆与治理Zachary Blumenfeld · Neo4jNeo4j 的 Zachary Blumenfeld 介绍三类图,并演示图结构的贷款审核技能。