30 秒看懂
Cristóbal Valenzuela 介绍 Runway 在视频生成方面的进展,并认为大规模下一帧预测能够支持交互式世界模型。他展示了生成式界面、面向 agent 的视觉思考和 Continuum 的早期研究,并将未来发布描述为计划。
- 1从早期影片到视频模型Valenzuela 将 2019 年的低分辨率影片与较新的生成视频作比较。
- 2评估一致性他讨论物体恒常性、几何和物理行为等评估问题。
- 3世界界面模型汽车演示响应点击,而没有使用传统方式制作的三维场景。
- 4Continuum一个早期原型探索类似操作系统界面中的实时生成式门户。
- 5视觉思考编程 agent 和人可以在探索问题时共同操作生成的视觉表示。
要点建议
- 除了外观,下一帧预测也可以从一致性、几何和呈现出的物理行为等方面评估。
- Runway 正在探索能够实时响应用户操作的交互式视频模型。
- 在展示的例子中,世界界面模型不依赖传统方式制作的三维场景,也能生成视觉反馈。
- Continuum 是将交互式视觉内容融入日常工作的早期研究概念。
- 生成式可视化仍然是对事物的呈现,其事实准确性需要另行验证。
按章节阅读整理后的全文
从生成影片到世界模型
Valenzuela 回顾 Runway 的早期实验,解释公司对下一帧预测的兴趣。
我在 Runway 工作了将近十年。我想回顾我们在生成视频和像素方面学到了什么,以及我们认为这项工作可能走向哪里。我会开玩笑说我们生活在模拟中,但这个玩笑背后的研究问题是认真的。
我们的第一部 AI 影片《The Orange》制作于 2019 年,图像分辨率为 128×128 像素,随后被放大。现在它看起来像是这个媒介早期的一件作品。当时我们试图弄清,扩大这种方法的规模是否最终能生成更有说服力的视频。
我展示了一段较新的生成视频,其中的人物和地点都不是真实的。进步很显著,但我预计,再过几年,今天的输出本身也可能显得很原始。Runway 将研究视频模型的人员与深植于创意社区的人结合在一起。
电影通过连续展示画面来制造运动的错觉。我们将一个相关想法推进一步:根据此前画面预测下一帧,扩大模型规模,并让这一过程足够快,使它能够支持的不只是精美的创意片段。
我们认为,缩放定律不仅适用于语言,也适用于视频。随着模型规模和算力增长,我们关注连续预测画面时涌现的能力,而不是把每一帧当作孤立图片。
一致性与模拟
他讨论物理行为的评估,以及从视频迈向交互式模拟。
我展示一张包含两个生成式人物的图像,并继续根据它预测后续画面。在我们的测试中,人们很难区分某些生成视频和真实画面。这一观察针对的是我们运行的例子和测试;更广泛的问题是,模型需要学到什么才能保持连贯。
要让场景保持一致,就需要呈现运动、重力、遮挡和物体恒常性等关系。对于复杂画面,模型必须随着序列展开,生成物体、水和周围空间之间看起来合理的互动。
因此,我们的评估不只是看某个人喜不喜欢创意结果。我们还会检查几何、物理行为和模拟环境的一致性。这些测试帮助我们追问模型能够再现什么,而不是假定一张好看的画面就足够。
如果下一帧预测足够快,能够对环境作出响应,它就开始类似一个模拟系统。在我展示的例子中,看起来像游戏的世界由视频生成,而不是由传统方式明确描述的物理引擎产生。
前面的例子并非实时生成:制作需要数秒或数分钟。展望未来几年,我们希望让这些系统具有交互性,使人能够在预测过程中采取行动,并影响接下来发生的事。
机器人与视觉界面
演讲介绍具身系统研究和交互式生成场景的演示。
我们也在 Runway 探索机器人领域。这个想法是研究为视觉世界开发的模型,能否帮助具身系统理解周围环境并在其中移动。这是一个研究方向,并不能证明所有模拟行为都能迁移到实体机器人。
另一个方向是把界面本身当作生成视频。在一个演示中,我点击汽车,打开车灯、旋转车身并打开发动机盖。我称之为世界界面模型:它能响应操作,尽管演示并未建立在 Unity、Unreal 或 Blender 里传统制作的三维场景上。
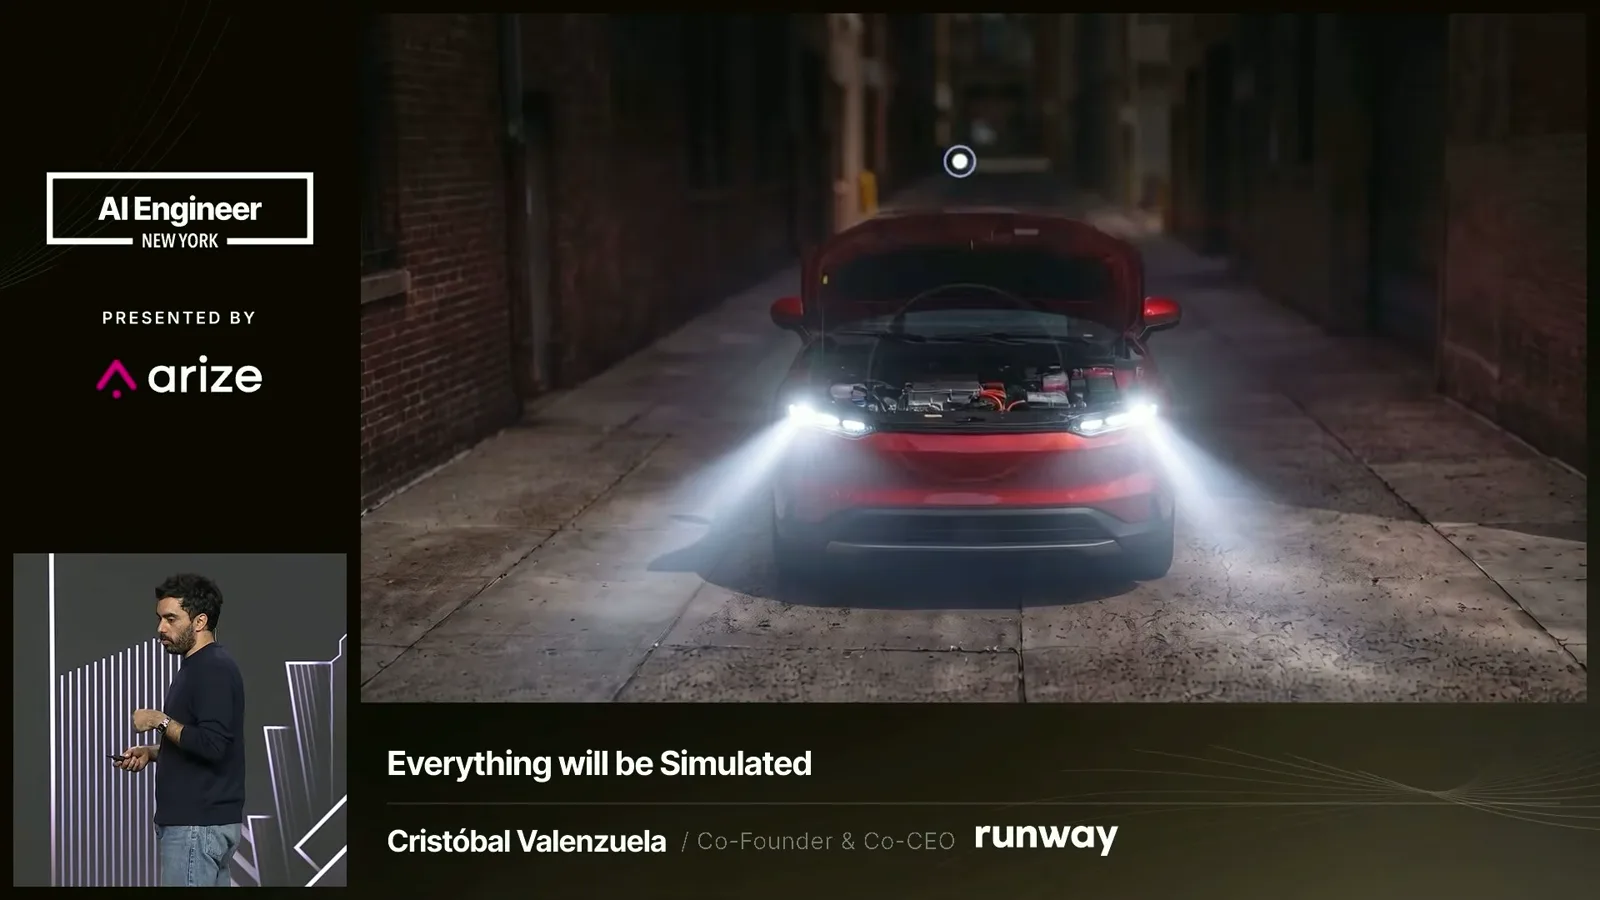
第二个例子是在一张房间图片中移动物体。模型生成交互后的视觉结果,而不必要求有人事先将这个特定环境手工建模为三维场景。我们的假设是,能力足够强的下一帧预测可以支持这类界面。
Continuum 与视觉思考
早期原型探索生成式门户、交互式学习和与编程 agent 的视觉协作。
在 Runway,我们尝试推演未来六个月、十二个月或十八个月可能发生什么。一个早期研究想法是 Continuum:把实时视频或世界模型用在类似操作系统的体验中。这个演示仍在探索阶段,并不是已经完成的操作系统。
第一个例子中,我在真实网页上研究旧金山的雾,选取部分内容,创建一个我们称为“门户”的东西。门户将选中的材料变成可交互的生成视频;此前的门户也可以像视觉记忆一样重新打开。
在光合作用的例子中,我调整应用大小、操作视觉内容时,画面也会变化。它介于可视化、视频和游戏之间;我们仍需要为这类交互找到合适的语言。生成的插图应被理解为一种表示,不能自动视为经过验证的科学证据。
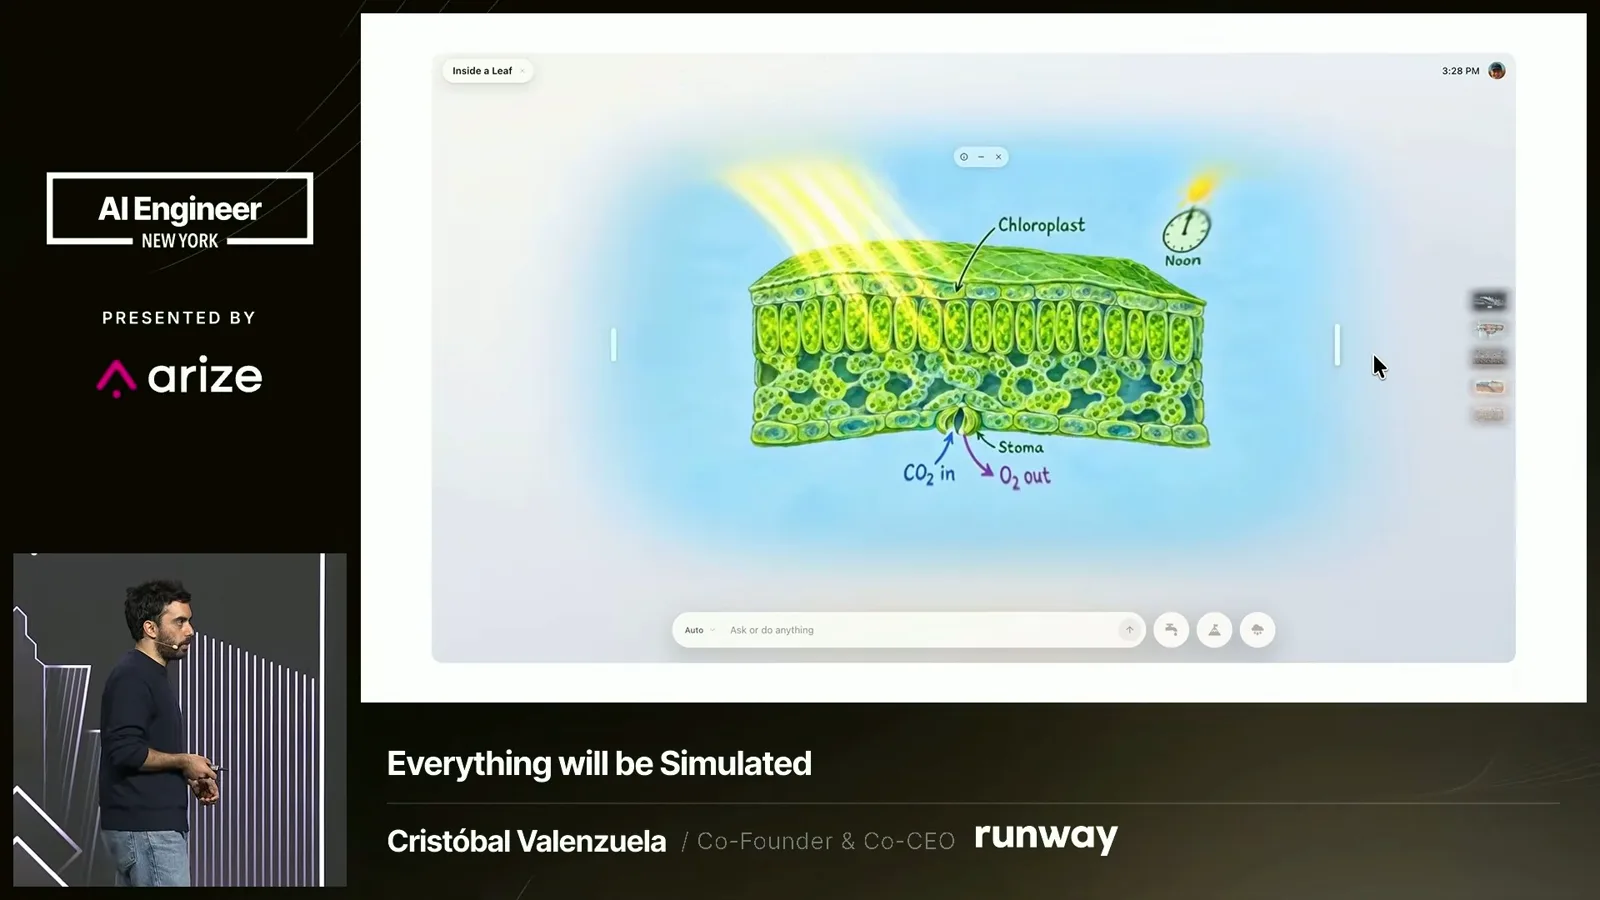
我们还在一项称为“视觉思考”的实验中,把 Continuum 与编程 agent 连接起来。如果 agent 正在设计自行车的三维模型,它可以使用生成的视觉空间探索问题,而不必只通过代码和文本思考。
人也可以查看这个视觉空间,并用它来指导 agent。人和 agent 都能与一个不断变化的表示交互,这种可能性正是我们认为这个想法有吸引力的地方。
最后一个演示将关于火星的搜索变成可响应的体验:Continuum 围绕查询提出一个交互式前哨站界面。我说过希望它依据当前或计划中的机器人信息,但这个演示本身不能证明每个生成细节都准确。
当我说“一切都将被模拟”时,我提出的是一个研究方向,并不是宣称今天的所有系统都已完成。Continuum 和我们的其他模拟工作仍处于早期。我们希望在之后的八到十二个月里发布演示中的大部分内容,但这是计划而不是保证。
同频道的其他文章
 15:51EN → 简体中文
 AI Engineer· 2026年11月2日Adam Nahari:让 AI 试点产生财务影响的六个行动Adam Nahari · Apollo航空公司机组排班案例展示了财务成果为何取决于流程重设计、用户采用和严格衡量。
 20:39EN → 简体中文AI Engineer· 2026年11月2日Sagar Batchu:在智能体操作到达 API 前进行授权Sagar Batchu · Speakeasy一种拟议的治理路径结合智能体身份、权限上限、策略决定和审计记录。
 20:15EN → 简体中文AI Engineer· 2026年11月2日Will Brown:让模型从组织的日常工作中学习Will Brown · Prime IntellectPrime Intellect 的 Will Brown 介绍,如何利用执行轨迹、评估和人工决策,在使用前沿模型的同时支持持续学习。
 18:33EN → 简体中文AI Engineer· 2026年11月2日Zack Proser:建一座工厂,帮助别人讲述自己的故事Zack Proser · WorkOSWorkOS 博客助手与睡前故事应用展示了 AI 工具如何分享经验,同时保留人的责任。
 18:57EN → 简体中文AI Engineer· 2026年11月2日Andrew Norrish:AI 时代的故障响应需要代码上下文Andrew Norrish · SourcegraphSourcegraph 工程师介绍审查压力,以及用于调查、预防和修复故障的边界清晰的工作流。
 15:44EN → 简体中文AI Engineer· 2026年11月1日Yijia Liang:为金融智能体构建兼容 Office 的文档引擎Yijia Liang · Compound AICompound 的方法结合共享智能体收件箱、文档引擎和可追溯到来源的大型资料室访问。