30 秒看懂
OpenAI 在 2024 年春季活动中展示了面向文本、音频和图像的 GPT-4o,以及桌面界面和语音功能。Matthew Berman 回顾了富有表现力的语音、打断对话、实时数学辅导、代码分析和翻译等演示。界面令人印象深刻,但助手有时似乎在看到正确图像前就作出了回应。视频最后,Berman 表达了对能够真正执行任务的助手的期待。
- 1现有模型系列的新界面发布会重点介绍桌面体验和 GPT-4o,其中的 o 代表 omni。Berman 强调这不是 GPT-5 发布会。
- 2更快的语音交互OpenAI 将此前分开的语音转文字、文本模型和文字转语音步骤,与原生处理多种模态的模型作比较,目标是让对话反应更快。
- 3语音作为界面现场演示中,助手帮助一位演示者缓解紧张,随后展示用户可以打断它并改变回应方向。
- 4富有表现力的输出助手以不同的语气和表达方式讲述睡前故事。这展示的是生成语音,而不是系统具有情感的证据。
- 5辅导与代码手机摄像头拍摄的数学题和桌面代码讲解展示了语音与视觉上下文如何辅助学习;摄像头演示中的过早回应也暴露了局限。
- 6翻译与视觉上下文团队演示对话翻译,并让助手描述自拍。摄像头画面混淆表明,模型的描述取决于它实际收到的图像。
- 7演示之后Berman 希望未来的助手不止回答问题,还能采取有用的行动;发布阶段的演示只是起点。
要点建议
- GPT-4o 被介绍为 GPT-4 级别的多模态模型,而非 GPT-5。
- 更一体化的音频处理旨在降低延迟,让打断和富有表现力的语音交互更自然。
- 发布会展示了辅导、代码讲解、翻译和理解摄像头图像。
- 部分摄像头演示出现错误或过早回应,说明精彩演示不能证明系统可靠。
- Berman 认为,执行任务和智能体能力是超越对话的重要下一步。
按章节阅读整理后的全文
GPT-4o 登场
Berman 介绍 OpenAI 的发布会以及新的桌面和多模态体验。
Matthew Berman 回顾 OpenAI 2024 年 5 月的春季活动,认为这朝着更自然的人机交互迈出了重要一步。
活动推出桌面应用和 GPT-4o。名称体现其多模态设计;Berman 指出,这是 GPT-4 级别的产品,而不是 GPT-5。
OpenAI 高管表示,希望通过更易使用的界面让先进 AI 发挥作用。视频中有关可用性和推出时间的说法仅反映发布时期。
原生音频与响应速度
发布会解释早期语音处理流程与 GPT-4o 多模态处理的预期区别。
发布会对比了此前将转写、语言模型和语音生成分开的语音交互流程,以及为处理多种输入和输出而构建的模型。
延迟更低很重要:助手能迅速回应,用户也能打断,对话便更自然。
Berman 强调了日常使用的意义:语音、图像和文本可以成为同一次交互的组成部分,而不是孤立功能。
现场语音演示
演示者测试情绪疏导、打断对话和富有表现力的讲故事。
在现场演示中,演示者请助手帮助其中一人在上台前放松。
他们打断助手并重新引导回答,展示了严格轮流发言的语音界面难以实现的交互方式。
助手根据要求改变表达方式。Berman 对生成声音的对话感和表现力印象深刻。
睡前故事演示要求助手调整戏剧化的语气。这展示的是语音输出,不能证明助手感受到了所表达的情绪。
数学、代码和翻译
助手根据摄像头与桌面上下文回应,并翻译语音。
在数学示例中,摄像头对准一道方程,演示者要求助手帮助推理,而不是直接给出答案。
助手似乎在目标画面出现前就描述了一道方程。这个错误提醒人们,实时视觉理解也会出错。
在桌面演示中,团队分享笔记本中的代码,请助手解释代码并讨论绘图结果。
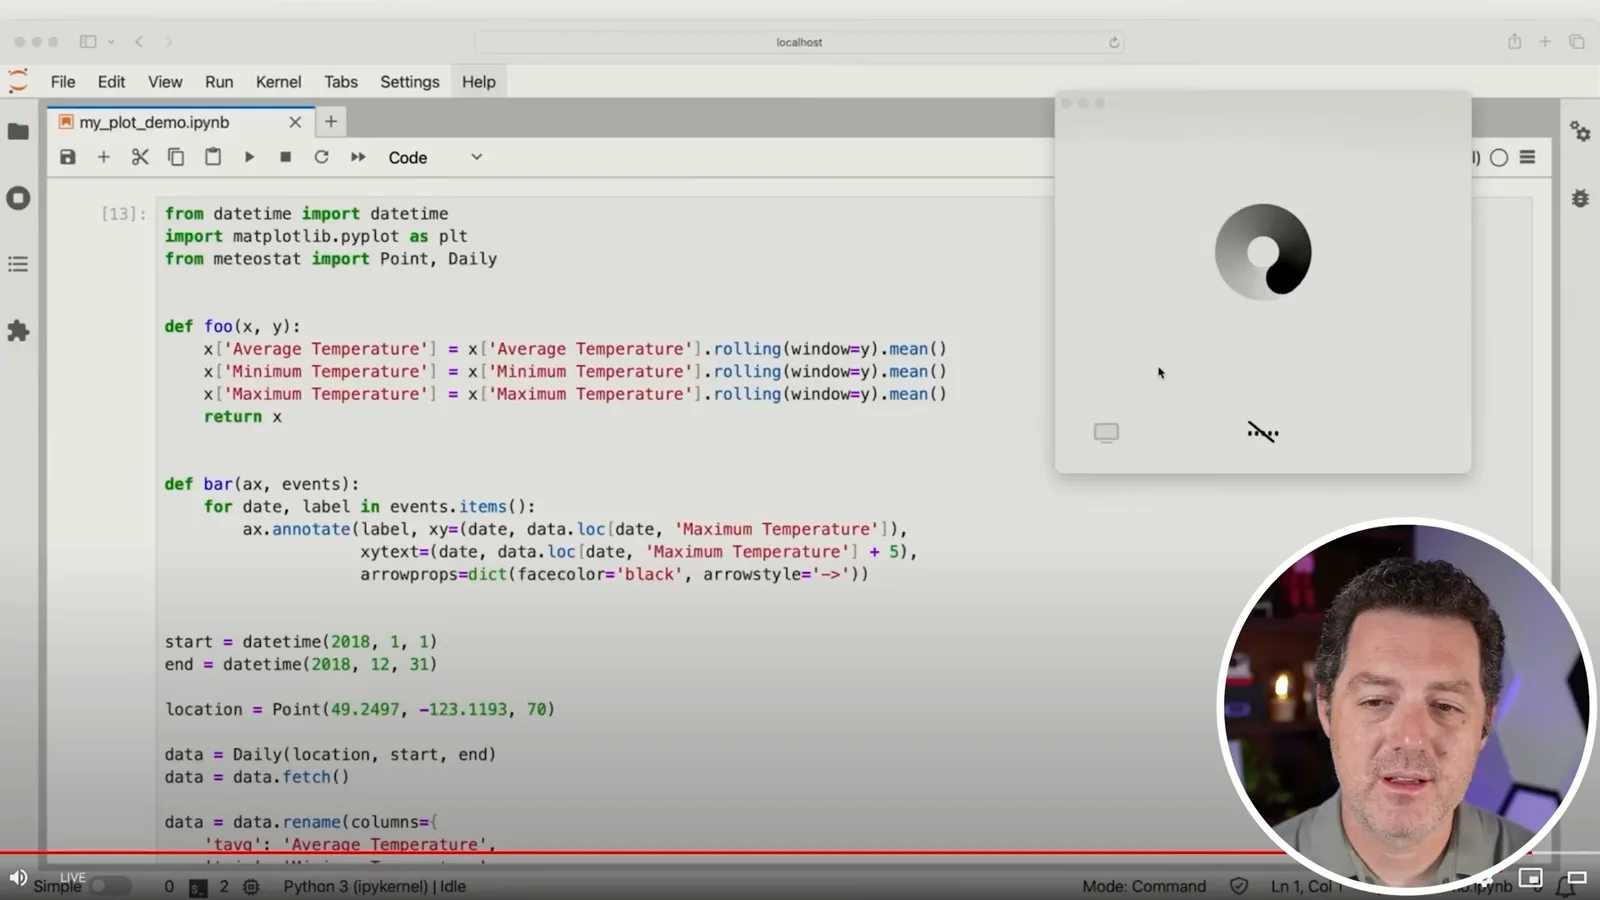
另一项演示让助手在英语和意大利语之间担任口译,展示可能的实时翻译流程。
摄像头的局限与未来
自拍演示暴露了画面混淆,Berman 思考未来的智能体能力。
自拍演示要求助手评论一个人的表情。它先描述了错误的摄像头画面,之后才被纠正;仅凭面部表情无法可靠判断情绪状态。
活动最后,OpenAI 展望未来的 AI 交互。Berman 补充说,他希望助手不仅能对话,还能代表用户完成有用的任务。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 45:08EN → 简体中文
 0:32EN → 简体中文
 12:14EN → 简体中文
 10:36EN → 简体中文