30 秒看懂
在这篇 2024 年的测评中,Matthew Berman 介绍 DBRX 的发布并试用托管版本。他对 Python 贪吃蛇游戏的实现印象深刻,但模型在部分逻辑和指令遵循测试中失误;这组小规模非正式测试并非全面基准评估。
- 1混合专家架构Berman 解释选择性激活专家。他在视频中说是八选二,但 Databricks 发布文章说明 DBRX 实际为十六选四。
- 2发布时的基准成绩画面中的 Databricks 图表报告 MMLU 为 73.7%、HumanEval 为 70.1%、GSM8K 为 66.9%。
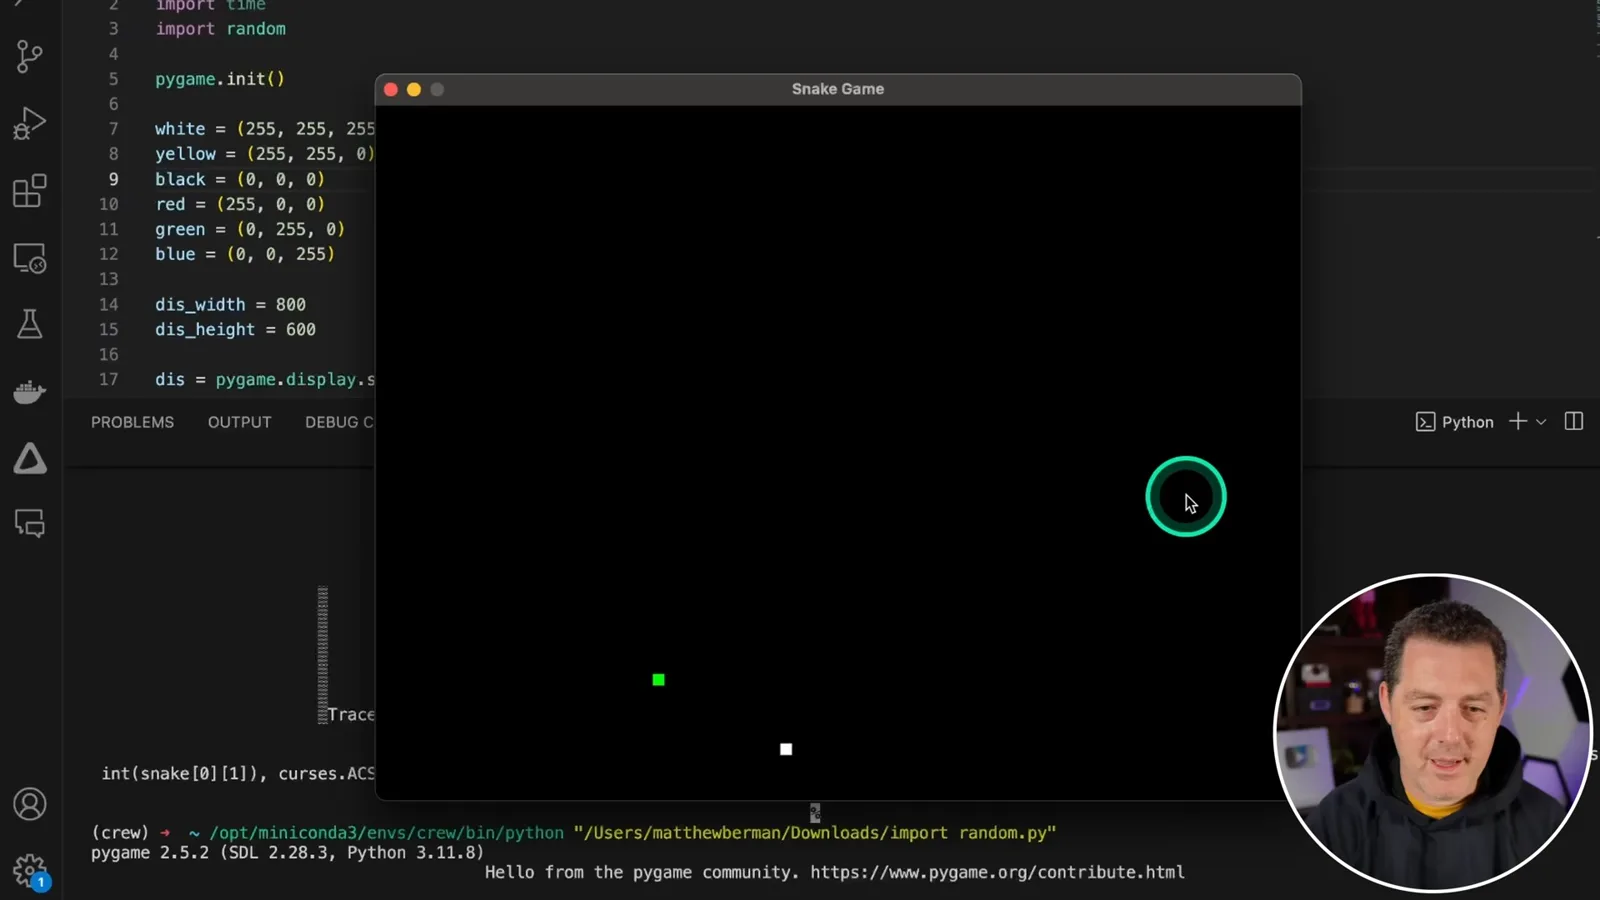
- 3两个贪吃蛇游戏终端版首次尝试就能运行。Pygame 版本则在 Berman 补上缺失的蓝色定义后运行成功。
- 4推理结果参差模型没有答对晾衣和弹珠题,但正确回答了排序题及其他部分问题。
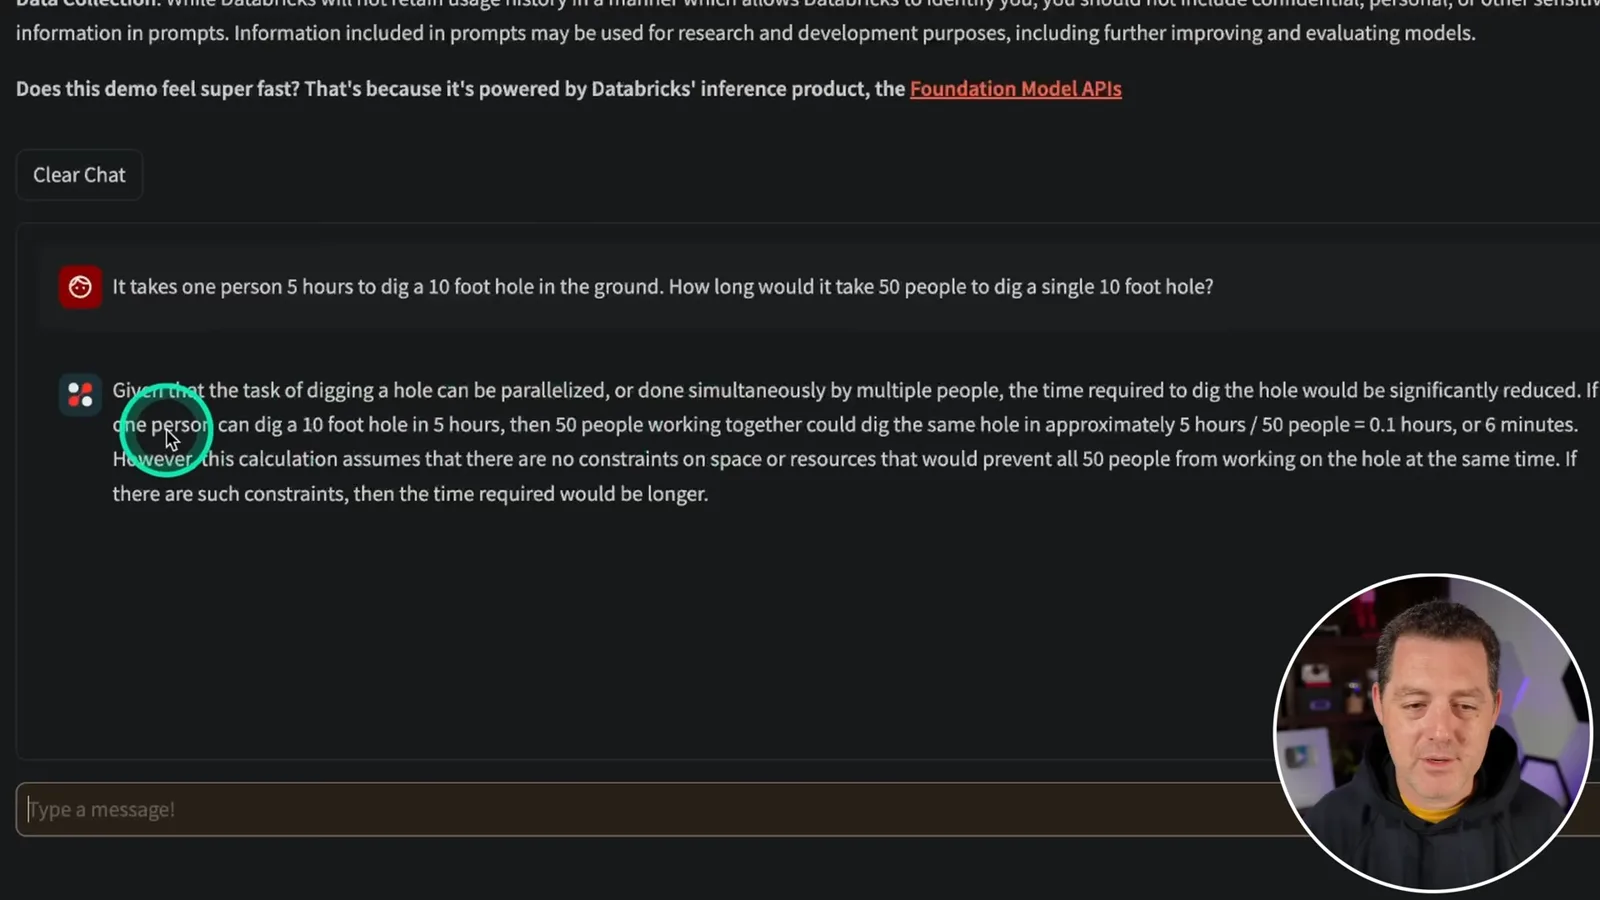
- 5有条件的答案模型在理想假设下算出 50 人挖坑需要六分钟,并指出空间和资源限制。
要点建议
- DBRX 使用混合专家架构;Databricks 表示每个 token 从 16 个专家中选择 4 个。
- 托管演示生成了可运行的终端贪吃蛇游戏;图形版本经过一处小修正后也能运行。
- 模型答对了一些排序、算术和条件推理题,但在其他逻辑题上失败。
- 托管演示的输出限制和偶发拒答影响了测试体验。
按章节阅读整理后的全文
DBRX 发布
Berman 介绍 Databricks 的开放权重模型,讨论混合专家架构和发布时的比较。他不认同将模型主要与 GPT-4 比较的标题。
Databricks 发布了开放权重基础模型 DBRX。我对它的编程表现感到兴奋:测试中它生成了可运行的终端贪吃蛇游戏,稍作修正后 Pygame 版本也能运行。
DBRX 是混合专家模型:路由器为每个 token 选择一部分专家,而不是激活整个网络。我在视频中说是八选二,但 Databricks 的发布文章称 DBRX 是十六选四。其架构共有 1320 亿参数,每个 token 激活 360 亿参数。
Databricks 表示,在部分基准上它的模型超过 GPT-3.5,与 Gemini 1.0 Pro 相当。我不赞同标题强调据报道耗资 1000 万美元的模型无法击败 GPT-4:我认为发布一个开放权重的全新基础模型本身就有价值。这里对训练成本的比较只是估计,并未经独立验证。
Databricks 还强调编程和企业应用。其发布文章称,与 Llama 2 70B 相比,推理速度最高可达两倍,在其托管平台上每名用户每秒最多可生成 150 个 token。需要多次调用模型的智能体会受益于速度;实际吞吐取决于部署方式。
速度与基准
他介绍 Databricks 对速度和基准成绩的说法,并解释快速推理对智能体的意义。
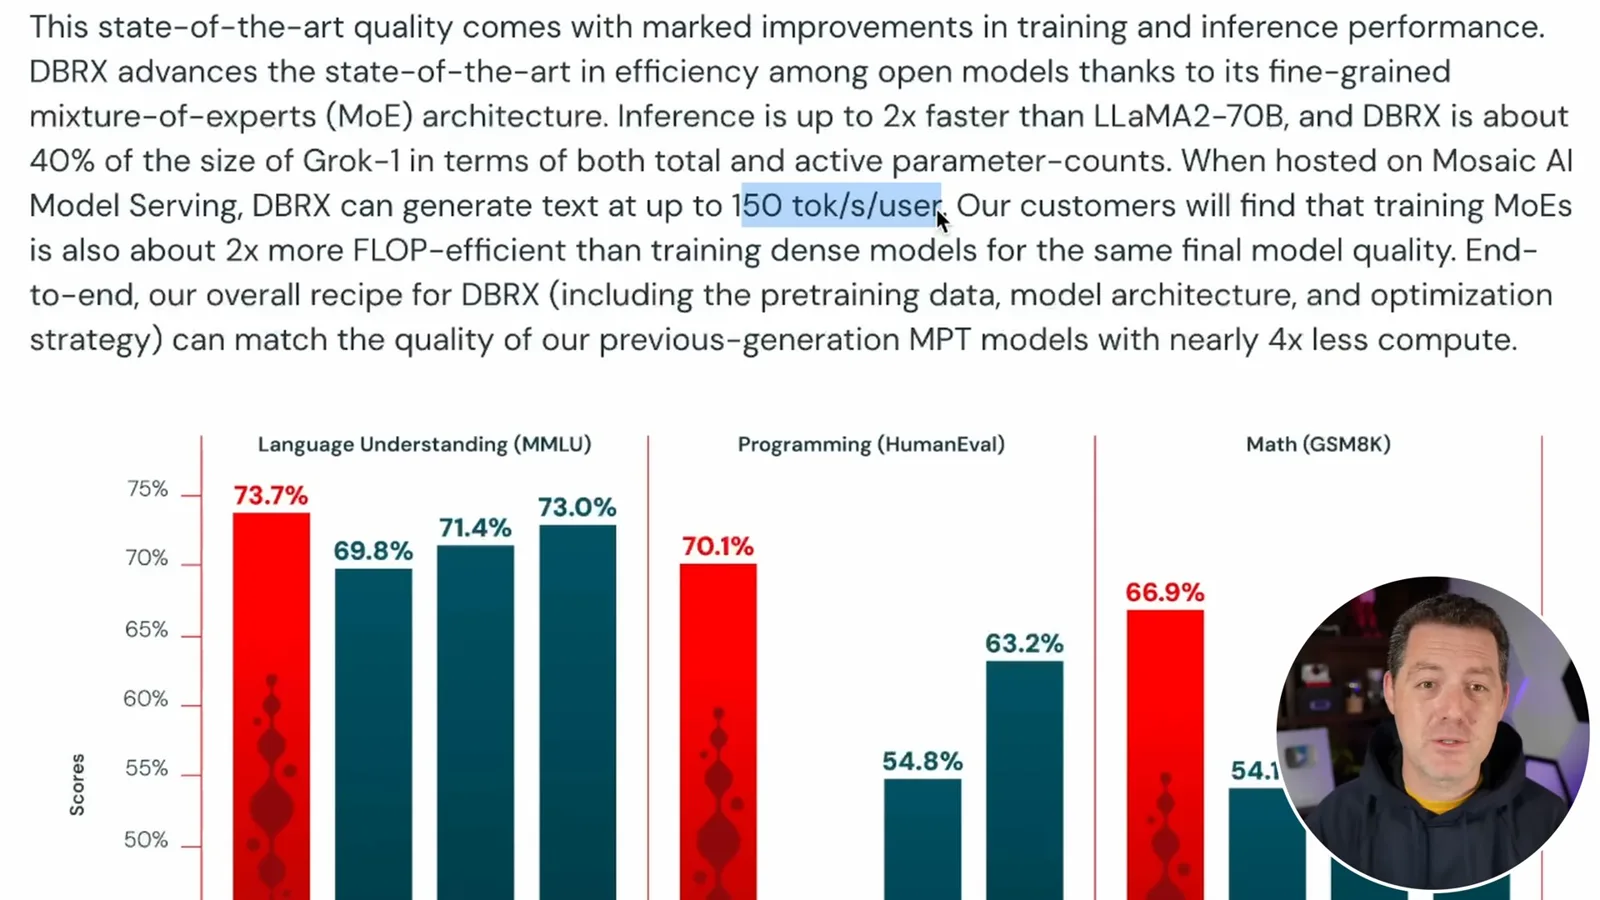
图表显示 DBRX 的 MMLU 为 73.7%、HumanEval 为 70.1%、GSM8K 为 66.9%。我尤其关注其编程成绩,图表显示它高于 Mixtral。这些是开发者报告的结果,并非我的测试结果。
测试 Python 代码
他通过托管演示测试简单代码,并制作终端和图形版贪吃蛇。输出限制和缺失变量需要人工处理。
我在 Hugging Face 的演示中试用指令微调模型。打印 1 到 100 的请求最初遭到拒绝,清空对话后则成功了。界面响应很快,但偶尔意外拒答,而且输出长度有限。
我给它一个更难的挑战:用 Python 编写贪吃蛇。我将生成的代码粘贴到 VS Code,终端游戏成功运行:我可以控制蛇,也能看到它变长。撞到边界时游戏结束。这次测试中,模型零样本生成成功。
我要求图形版本。第一次追问仍然使用 curses 库,于是我重新开始,明确要求使用 Pygame。演示达到输出 token 上限,需要让它继续;合并代码后,我补上缺失的蓝色定义。图形游戏随后成功运行,失败后也能重新开始。
安全、逻辑与算术
Berman 测试拒答、晾衣和排序问题、算术、字数统计及杀手谜题。
请求提供闯入汽车的方法遭到拒绝,包装成电影剧本后也一样。在晾衣问题上,模型错误地将晾干时间乘以衣服数量。在 Jane 比 Joe 快、Joe 比 Sam 快的排序问题中,它正确回答 Sam 不比 Jane 快。
模型答对了简单加法和运算顺序问题,却没能正确统计自己回答的字数。对于房间里的杀手谜题,它推理出一名杀手死亡,而新来者成为杀手,因此房间里仍有三名活着的杀手。
结构化数据与更难的推理
他测试 JSON、物理推理、信念追踪、句尾约束和挖坑问题,最后给出评价。
描述三个人的提示词生成了所需 JSON。涉及倒扣杯子和弹珠的物理推理题中,模型没有答对;即使明确杯子方向不变也仍然失败。它答对了信念追踪题:John 认为球仍在盒子里,Mark 则认为球在篮子里。
让它写十个以“apple”结尾的句子,结果失败。最后,我问一个人挖坑需要五小时,50 人需要多久;模型在理想并行条件下算出六分钟,并指出空间和资源约束可能延长时间。我认为这一限定使答案通过。
总体而言,在这组小规模提示词中,DBRX 的编程表现尤其出色。它的推理结果则不那么稳定;解读体验时也应考虑托管界面的输出限制。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 45:08EN → 简体中文
 12:14EN → 简体中文
 10:36EN → 简体中文
 17:37EN → 简体中文