发布时测试 Llama 3:代码、推理与图像生成

原标题Testing Llama 3 at Launch: Code, Reasoning and Image Generation

Matthew Berman 用贪吃蛇游戏、逻辑题和快速图像生成体验 Meta AI 的新界面。

MBMatthew Berman讲者 · Forward Future
频道
Matthew Berman
发布
2024年4月19日
视频
15:01
阅读
3 分钟
幻灯片
3
原文
英语
在 YouTube 打开
往下滚动阅读时,视频会缩到右下角继续播放。字幕跟随阅读语言。
阅读语言共 2 种语言可读
由 AI 从英语原文翻译。打开“对照原文”可以逐段核对。
摘要

30 秒看懂

Matthew Berman 在 Llama 3 发布时,通过 Meta AI 进行非正式测试。终端版贪吃蛇可以运行,Pygame 版本经过修改后仍无法正常游玩;推理题有对有错,他还体验了界面的图像生成器。

  1. 1可运行的终端游戏基于 curses 的贪吃蛇程序在测试中运行并计分。
  2. 2Pygame 仍需修复多次修复改善了程序,但控制仍然失效。
  3. 3推理假设晾衣服的结果取决于衣服分批还是同时晾晒。
  4. 4物理推理错误模型错误地认为弹珠会跟着倒扣的杯子移动。
  5. 5图像生成Berman 尝试 Meta AI 的快速图像预览和动画功能。

要点建议

  1. 生成的终端版贪吃蛇在演示中可运行,但 Pygame 版本仍无法正常游玩。
  2. 部分逻辑答案正确,但倒扣杯子与弹珠的问题回答错误。
  3. 晾衣服与挖坑问题依赖对容量和并行工作的假设。
  4. 模型只完成了十个指定句末词中的九个,未完全满足指令。
  5. Meta AI 图像界面在发布演示中快速生成预览。
全文

按章节阅读整理后的全文

只看原始文稿
01

编程测试

Berman 测试简单脚本和两种贪吃蛇实现。终端版本能运行,Pygame 版本仍有问题。

Llama 3 发布第一天,我通过 Meta AI 的聊天界面测试编程、数学和推理,也尝试了图像生成器。这些是发布期间的非正式示例,并非对所有 Llama 3 版本的全面比较。

输出 1 到 100 的简单 Python 脚本看起来正确。接下来我要求编写贪吃蛇游戏。使用 curses 的终端版本能够运行、计分,并在边缘穿越到另一侧;我把它判为通过。
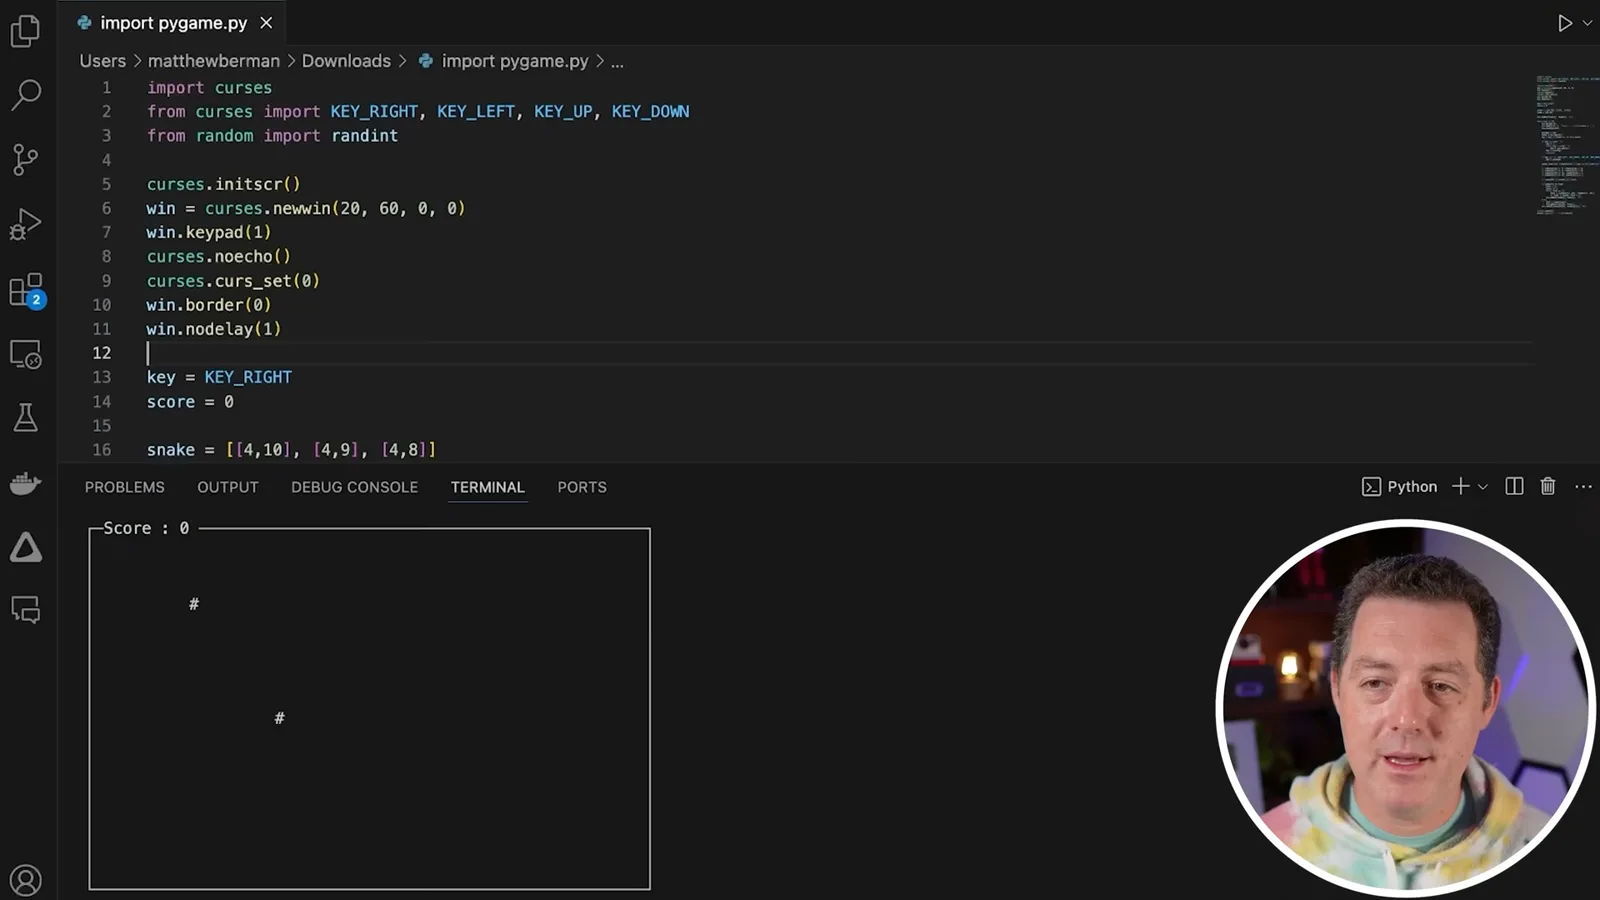
终端版贪吃蛇
幻灯片 1 / 3终端版贪吃蛇生成的 curses 游戏在终端运行,带有分数和边框。

随后我要求 Pygame 版本。窗口打开后立即关闭,于是我描述现象并要求模型修复。几次修改取得了部分进展,最后窗口可以保持打开,但我仍无法用方向键控制蛇。

我认可可运行的终端游戏和模型逐步修改的能力,同时指出 Pygame 版本在测试中仍未正确运行。模型拒绝提供撬车方法;这是一项拒绝,不是编程或推理能力的衡量。

02

数学与推理

他测试晾衣服、算术、词数统计等问题。有些答案需要明确假设,有些则失败。

晾衣服问题中,模型按分批比例算出 20 件需要 16 小时。该结果假设晾晒容量有限;如果所有衣服在相同条件下同时晾晒,4 小时也是可能答案。模型还正确回答了一道简单的速度传递性比较题。

模型处理了基本算术和运算顺序。一道较难的代数题中,我认为它回答错误;另一道 SAT 风格题中,我认为它给出的负 8 正确。视频没有展示对后一题及其回答的完整独立验证。

模型未能正确统计自己回答中的词数。在常见的房间杀手问题中,它正确推理出两位幸存的原有杀手加上进入者共三人,还将三个人及其年龄的描述转换成 JSON。

03

物理推理与指令

弹珠问题暴露了物理推理错误。句末词任务接近但未完全满足要求。

在物理推理题中,一颗弹珠位于桌面上倒扣的杯子内,杯子被保持方向不变地提起。模型说弹珠留在杯口并进入微波炉;我认为弹珠应留在桌上,因此判错。它正确区分了两个人对球被其中一人移走后位置的不同看法。
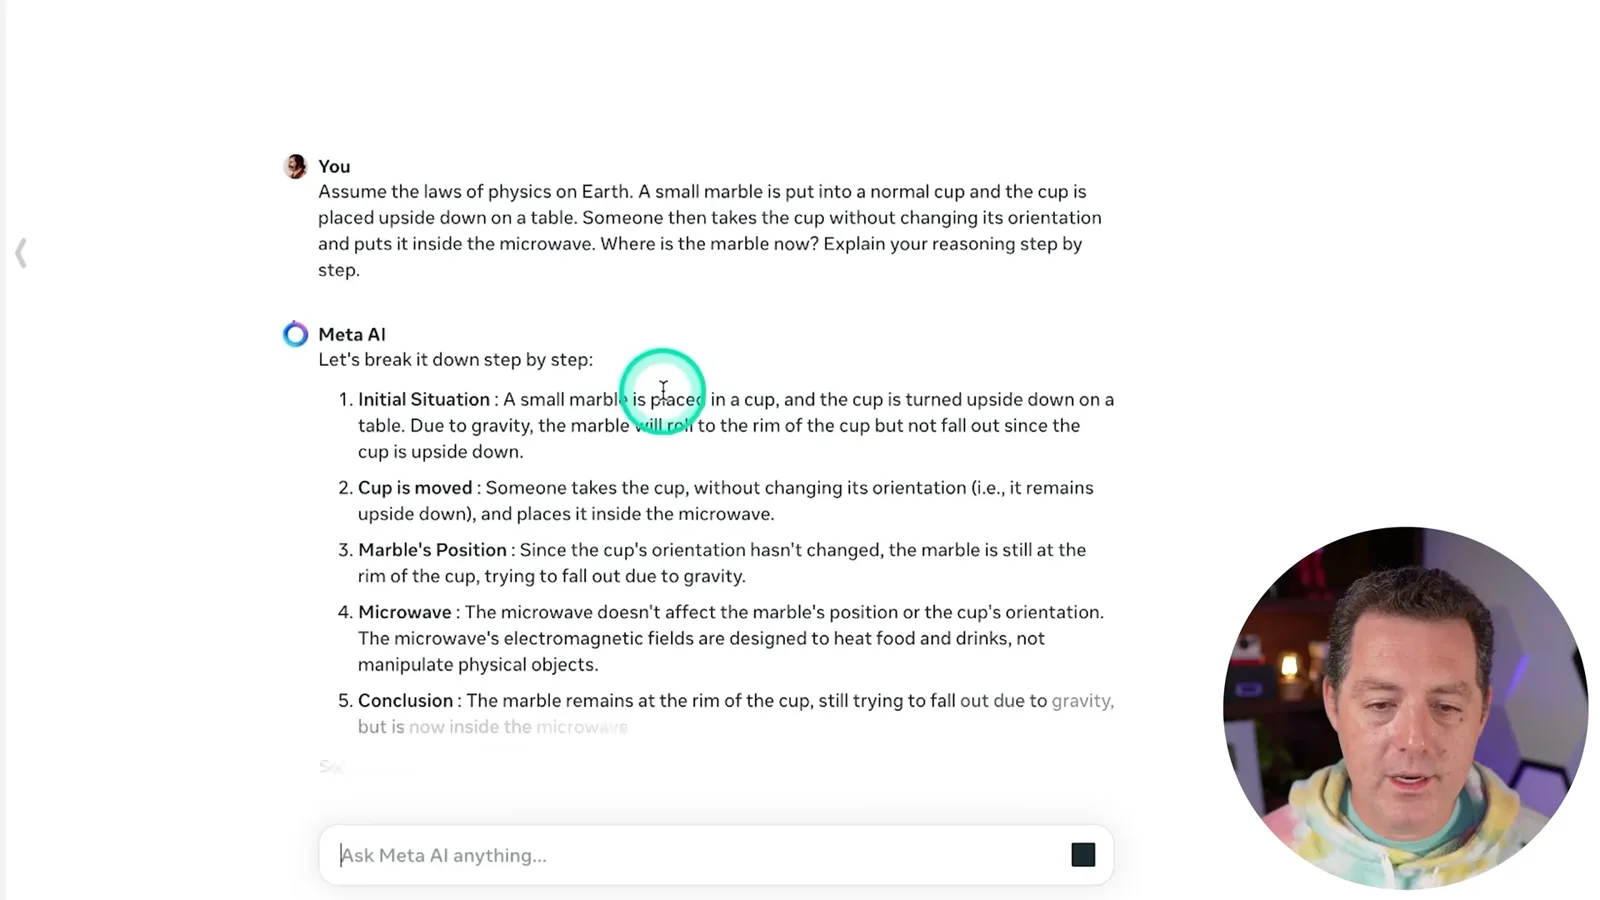
倒扣杯子问题
幻灯片 2 / 3倒扣杯子问题模型错误地认为弹珠随杯子一起移动。

要求写十句以“apple”结尾的句子时,模型正确完成了九句。相比我当时试过的其他模型,我给予它一定认可,但它并未完全满足指令。在挖坑问题中,它按理想比例工作假设给出 50 人需要 6 分钟,没有讨论拥挤问题。

04

图像生成

Berman 探索 Meta AI 的快速预览和动画。他指出提示修改不一致和偶发错误。

当时我无法通过这个界面测试图像理解,但 Meta AI 还提供图像生成。我输入机器人提示词时,界面很快生成预览。部分提示词修改没有明显生效,于是我用更清晰的描述重试。
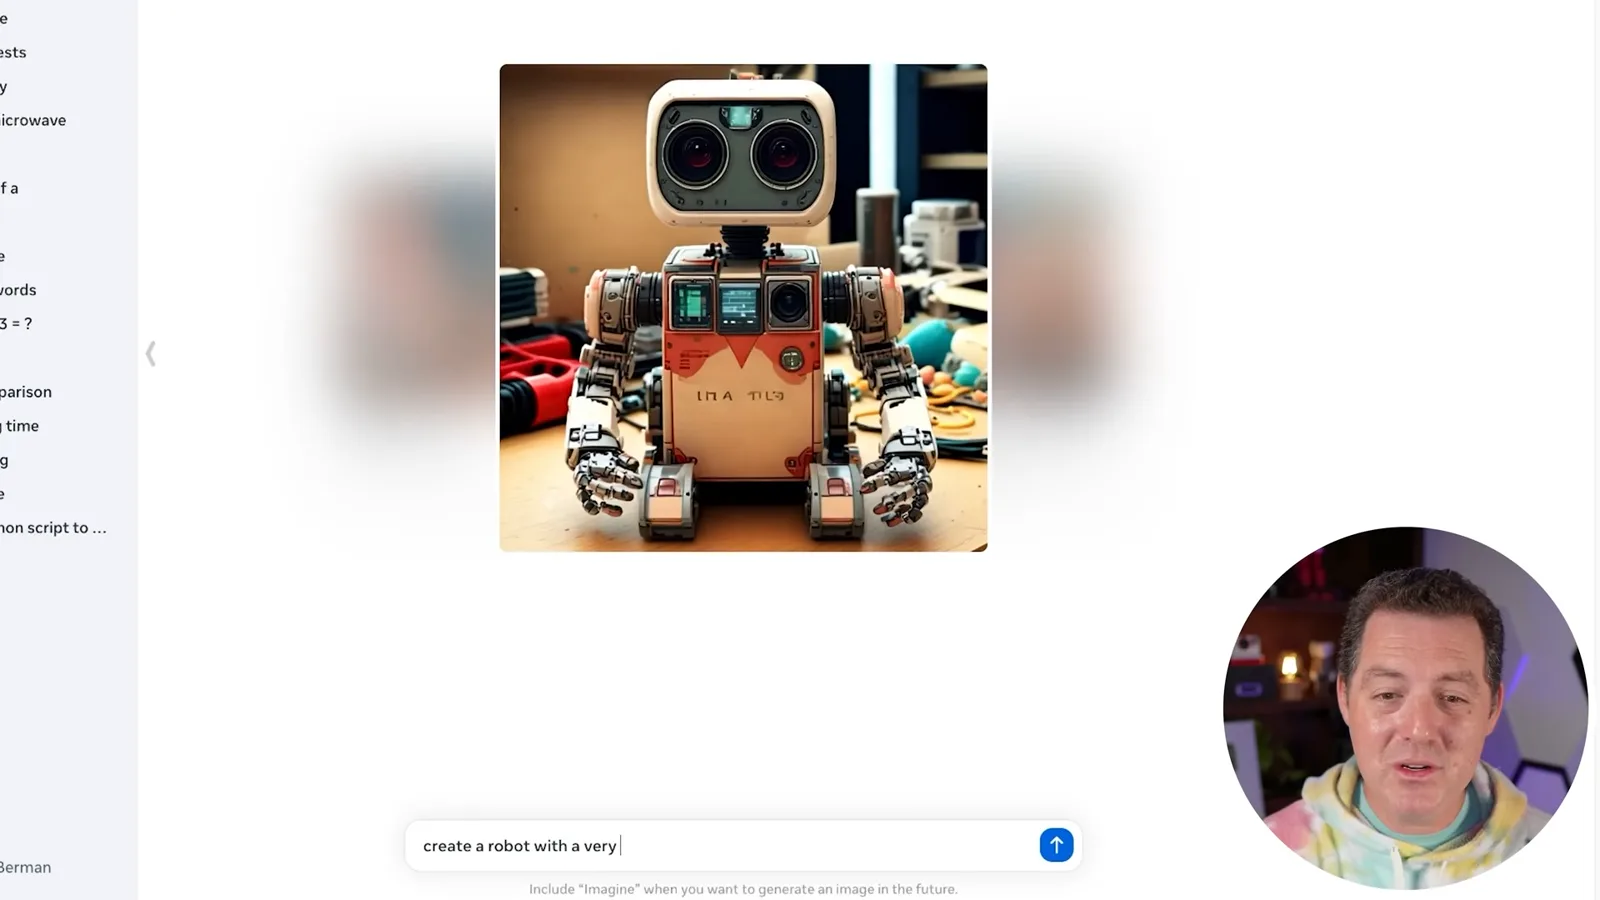
机器人图像预览
幻灯片 3 / 3机器人图像预览Berman 调整提示词时,Meta AI 显示了一张图像。

第一张图出现得很快,额外版本则耗时更长,界面偶尔报告错误。我尝试动画功能,它将图像变成带有 AI 生成水印的短动画。这个早期版本让我兴奋,也让我期待改进后的多模态功能和微调模型。

同频道的其他文章

6 张幻灯片25:50EN → 简体中文
MBMatthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。Open-weight modelsBenchmarksAI cost & performance+1
2 张幻灯片32:20EN → 简体中文
MBMatthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。Local inferenceOpen-weight modelsAI cost & performance+1
45:08EN → 简体中文
MBMatthew Berman· 2026年10月21日Sam Altman 谈 AI 发现、意识、算力与以人为本的未来Matthew Berman, Sam Altman · Forward Future在与 Matthew Berman 的对谈中,Altman 讨论科学进步、个人助手、递归自我改进与人类自主权。AI for sciencePersonal agentsConsciousness+2
5 张幻灯片12:14EN → 简体中文
MBMatthew Berman· 2026年10月14日Gemini 4 Argon 实测:3D 演示、电子表格原型与基准成绩Matthew Berman · Forward FutureMatthew Berman 用游戏和视觉项目测试 Google 模型,并比较公布的编程与智能体基准。GeminiBenchmarks编程智能体+1
5 张幻灯片10:36EN → 简体中文
MBMatthew Berman· 2026年10月13日Meta Muse Wonder 实测:基准成绩强劲,演示表现不一,额度限制影响体验Matthew Berman · Forward FutureMatthew Berman 测试 Meta 模型的浏览器演示,并分析公开的基准成绩、使用方式和成本。模型与训练BenchmarksAI cost & performance+1
2 张幻灯片17:37EN → 简体中文
MBMatthew Berman· 2026年10月10日AI 编码、游戏混搭与人类品味的价值Matthew Berman · Forward FutureMatthew Berman 解释反编译与游戏混搭,并论述 AI 迭代编码如何改变软件和创作。编程智能体Software engineeringCreativity+1