30 秒看懂
Theo Browne 认为,权重可以下载并不意味着大型模型就能方便地在个人硬件上运行。他讨论内存、吞吐量、并行工作、电费和托管替代方案,同时肯定开放权重带来的竞争及设备端隐私优势。
- 1可下载与可运行展示的 GLM-5.2 量化文件约为 395 GB;运行时需求因配置而异。
- 2并发Theo 的工作流使用数量变化的智能体,因此峰值容量和硬件闲置是重要取舍。
- 3电力成本他的电费例子假设 GPU 在旧金山持续运行;实际费用有所不同。
- 4服务商竞争开放权重让多个服务商提供不同的价格、速度和可靠性。
- 5每项任务的成本token 消耗量不同,可能让总任务成本差距远小于 token 单价差距。
要点建议
- 开放权重允许独立托管,但大型模型可能超出个人硬件的实用容量。
- 内存格式、卸载、吞吐量和并发都会影响本地运行性能。
- 硬件和电费取决于设备、使用方式及地点。
- 托管开放权重模型提供了服务商选择,同时改变隐私和控制权的取舍。
- 应比较每项完成任务的成本和质量,而不只是 token 单价。
- Theo 的结论反映了他要求很高的编程智能体工作流,并非否定所有本地用途。
按章节阅读整理后的全文
开放权重与本地硬件
Theo 支持开放权重模型,但质疑人们对在家运行最大模型的期待。他介绍了内存和性能限制。
我想区分两个经常混为一谈的概念。我重视开放权重模型,认为它们对 AI 生态很重要。我不满的是,有人声称最大、最强的模型可以在普通个人硬件上轻松替代托管的前沿模型。
在我看来,GLM-5.2 很出色,但能够下载权重与方便地在家运行是两回事。我展示的量化版本约为 395 GB;完整 BF16 权重则大得多。内存需求取决于格式、运行时、上下文和卸载方式,因此单一数字不是普遍最低要求。
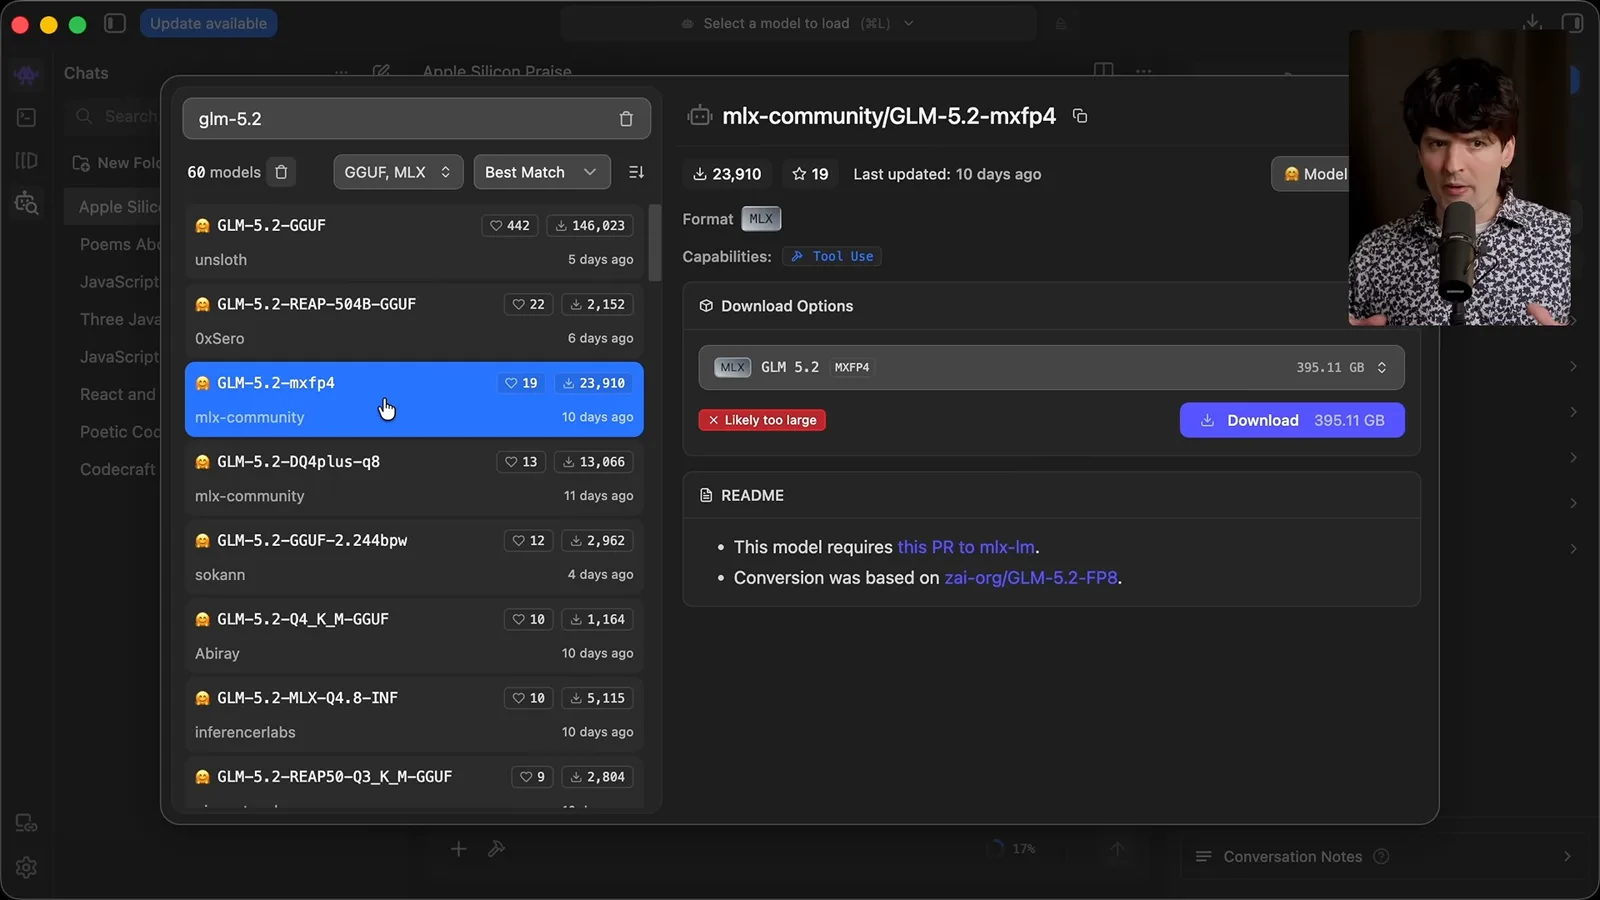
即使较小的量化或剪枝版本也可能很大,并需要在质量与速度之间取舍。我怀疑普通笔记本能否替代我使用的托管编程智能体。这是针对高要求工作流的判断,并不是说较小的本地模型没有用途。
内存与硬件价格
他比较统一内存、独立 GPU 和示例系统。展示的价格是视频录制时的快照。
我关注的是“能运行”与“以可接受速度完成有用工作”之间的差距。我提到 antirez 的 DwarfStar 推理引擎,它以 DeepSeek V4 Flash 为主要目标,并在大内存机器上支持 Pro。展示的 README 还提到,内存较少时可以使用 SSD 流式加载。
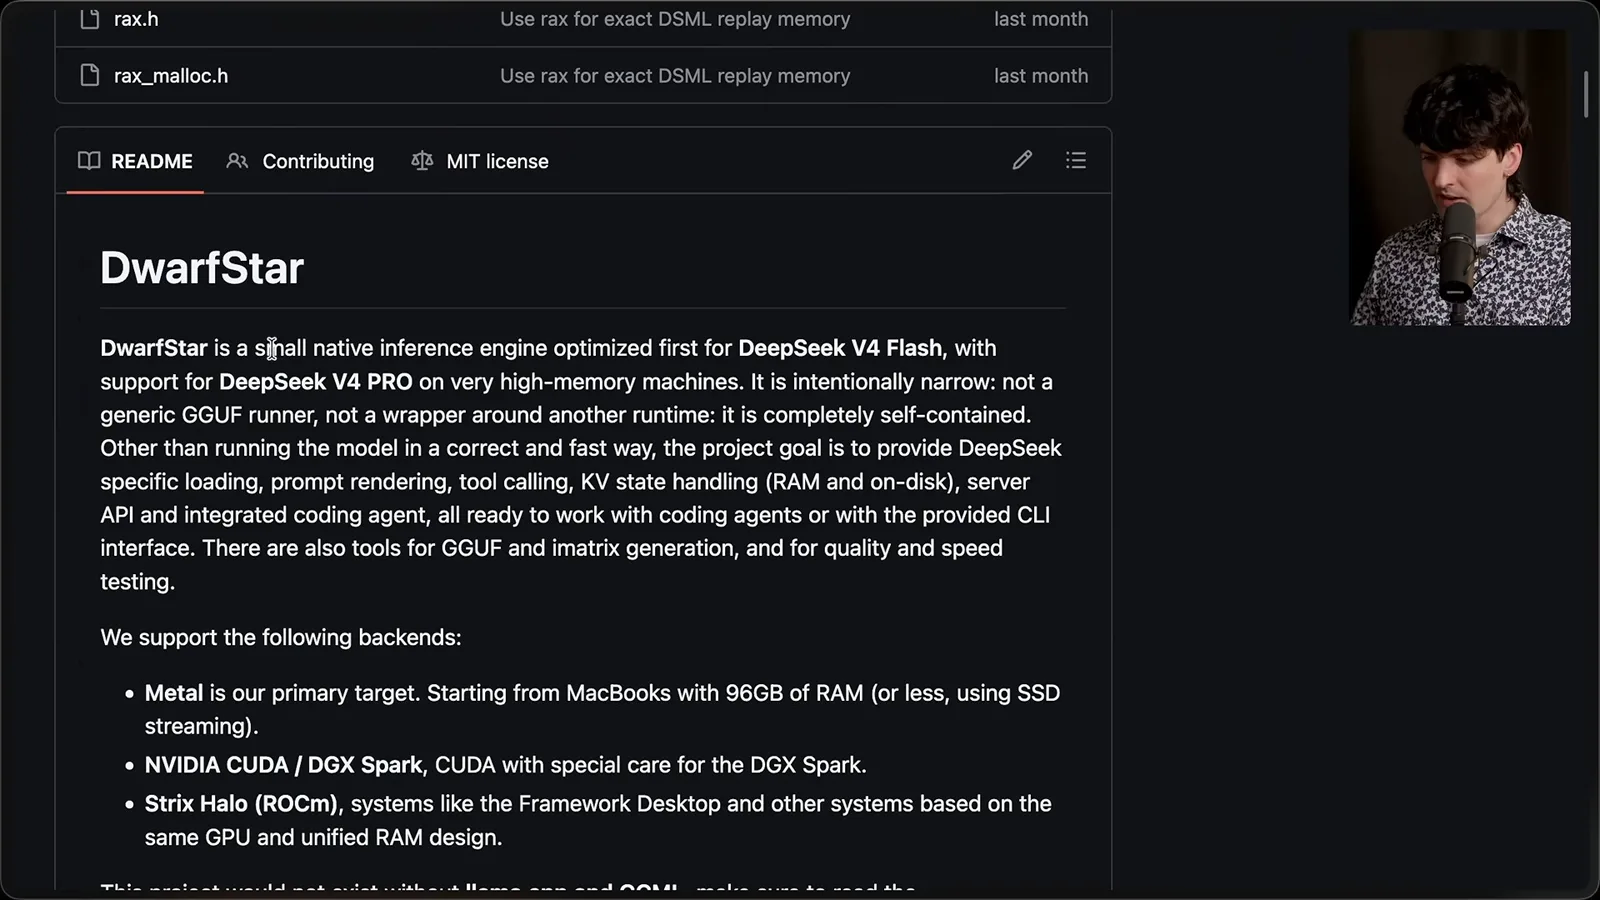
内存架构很重要。独立 GPU 有自己的显存,而 Apple 统一内存机器让 GPU 可以共享系统内存。其他机器也能通过卸载使用系统内存,但 GPU 内放不下更多内容可能显著影响速度。合适的配置取决于模型和运行时。
我比较了大内存 Mac、DGX Spark 和 Strix Halo 系统,作为本地运行较大模型的方式。我的 Spark 对自己的工作不够有用,而大内存配置在我看来很昂贵。这些是我当时的体验和价格,不是所有可能硬件的完整清单。
对于两边都能装下的模型,我看到 RTX 5090 的运行速度比 MacBook 快得多。较大的模型如果能装进 Mac 的共享内存、却放不进 GPU 显存,实际体验可能反过来。容量和计算吞吐量是两个不同的限制。
我展示的硬件价格很高:RTX 5090 的转售价示例约 4,300 美元,更大显存的 RTX Pro 6000 约 1.3 万美元,四 GPU 系统标价 7.5 万美元。这些是视频中的例子,不是当前推荐或报价。使用多个 GPU 也需要合适的分配策略。
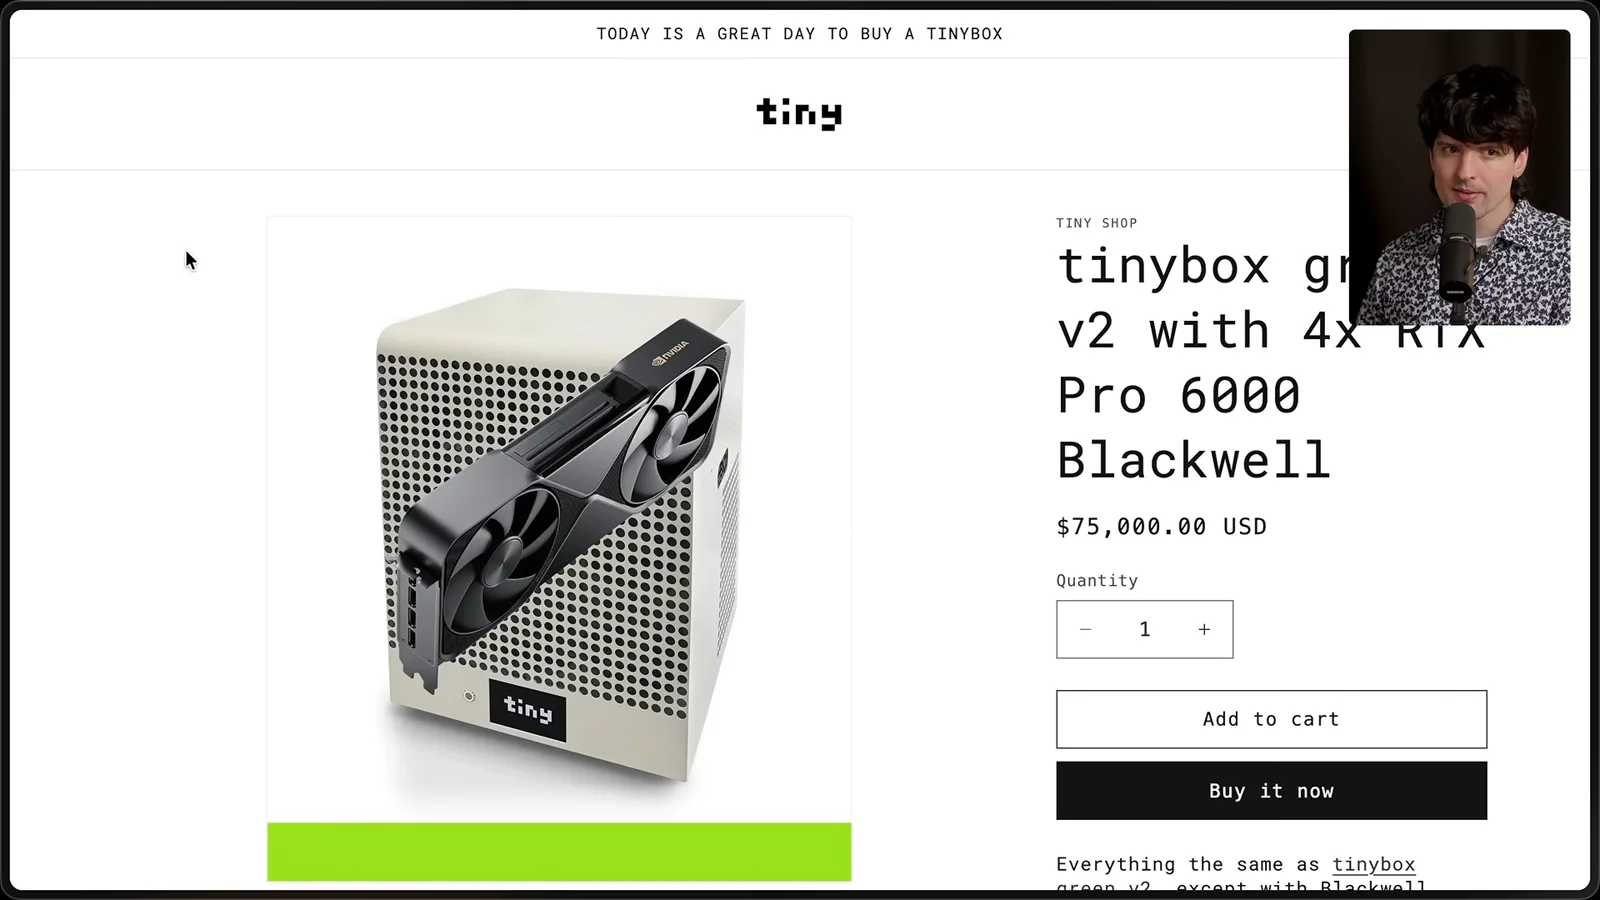
一个较便宜的多 GPU 例子,内存仍远低于我讨论的格式中最大开放权重模型所需的容量。我的核心观点是:开放权重提供了运行模型的可能性,但需要什么硬件、实际性能如何,是另外两个问题。
基准测试与并行智能体
他质疑基准宣传,并考虑并发智能体工作所需的容量。他自己的工作流要求尤其高。
有人引用模型排行榜时,我想知道基准测量什么,以及它是否仍有区分度。我查看了几项编程测试,认为一些宣传分数夸大了实际竞争力。我展示的分数只是当时的快照,也不把单项基准当作完整评估。
现在假设一个适合高端笔记本的小模型能够达到当时前沿模型的水平。接下来我关心的是并发。我的工作流可能从一个智能体变化到几十个,包括探索项目的子智能体,或同时工作的不同模型。
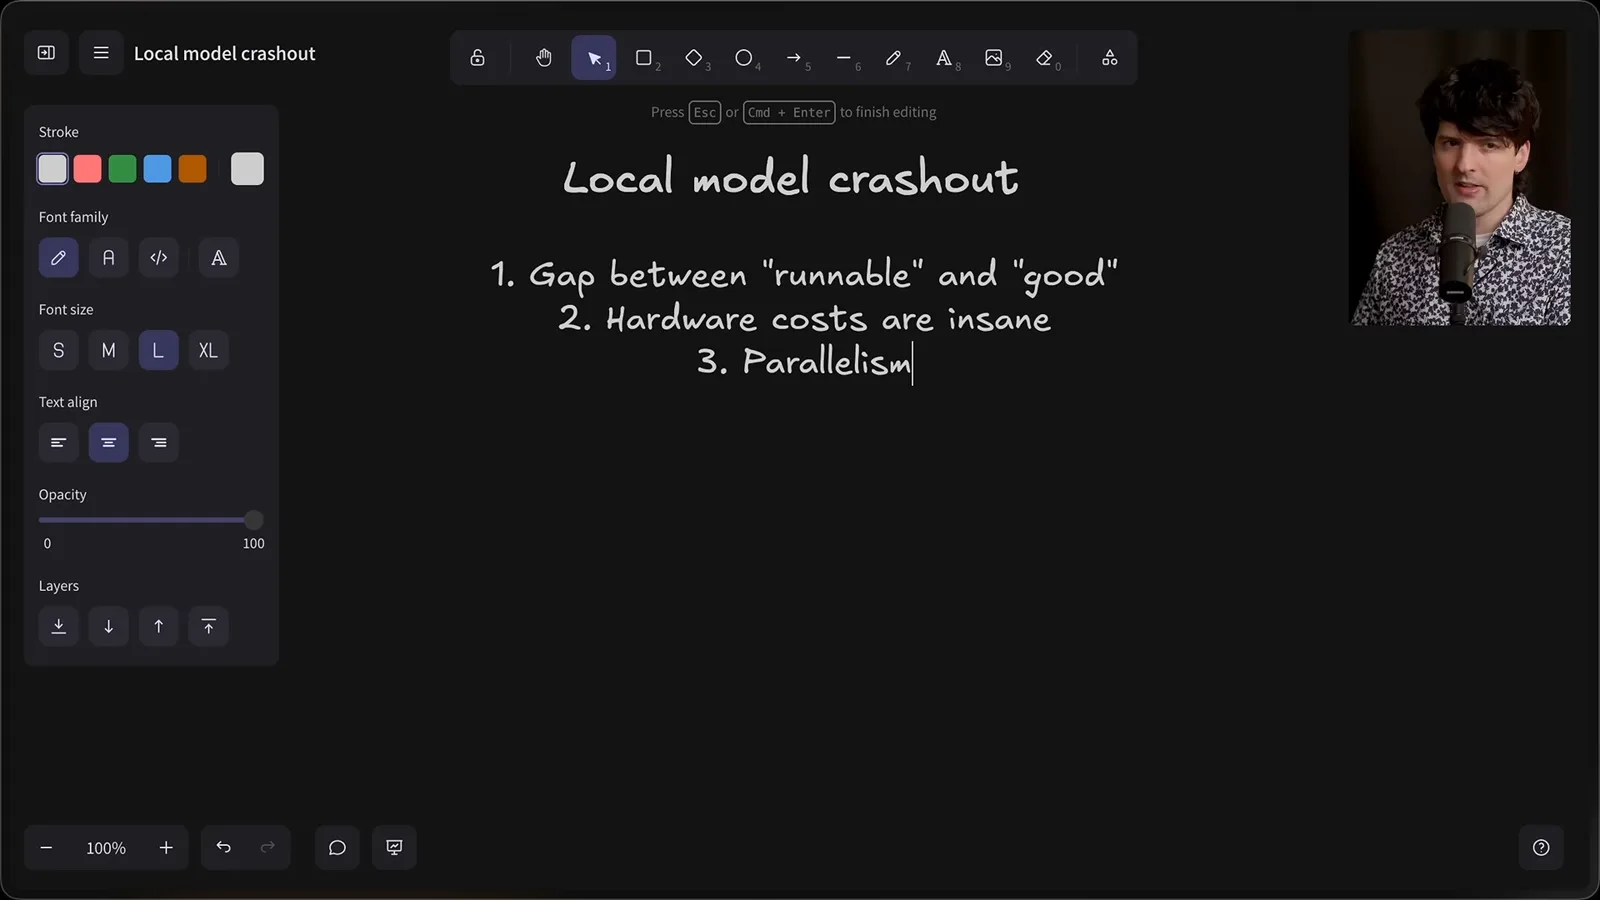
本地硬件的容量有限:为峰值需求采购设备,意味着设备可能闲置;需求超过容量时则要等待或转到其他地方处理。批处理和缓存可以提高利用率,但实际结果取决于工作负载和延迟要求。
对我的工作流来说,能力不只是一项孤立分数:智能体可能需要协调多个阶段、使用工具、查看截图并回应审查反馈。我指出,这里讨论的 GLM-5.2 缺少图像输入,即使它能编写界面代码,也会限制视觉反馈循环。
电力与设备取舍
Theo 讨论电费,并承认设备端任务的隐私价值。他还展示一张范围有限的手机 CPU 图表。
我也预计大型前沿系统仍然很难自行托管,尽管我不知道未公开的专有模型规模。除了硬件,还有电费。一个例子估计在旧金山让 5090 持续运行约需每天 5 美元;实际费用取决于功耗、使用率和电价。
不是每项任务都需要前沿模型。我的观点是,更强的模型拓展了我能委派的工作:它们可以处理更长的流程、反馈和更复杂的协调。这反映的是我的使用方式;其他人可能合理地针对较小、较窄的任务优化。
设备端摘要等功能有价值,因为处理这些任务时数据不必离开设备。我喜欢这一隐私优势,但担心大量本地推理会受到电池和散热限制。具体取舍因设备、模型和工作负载而异。
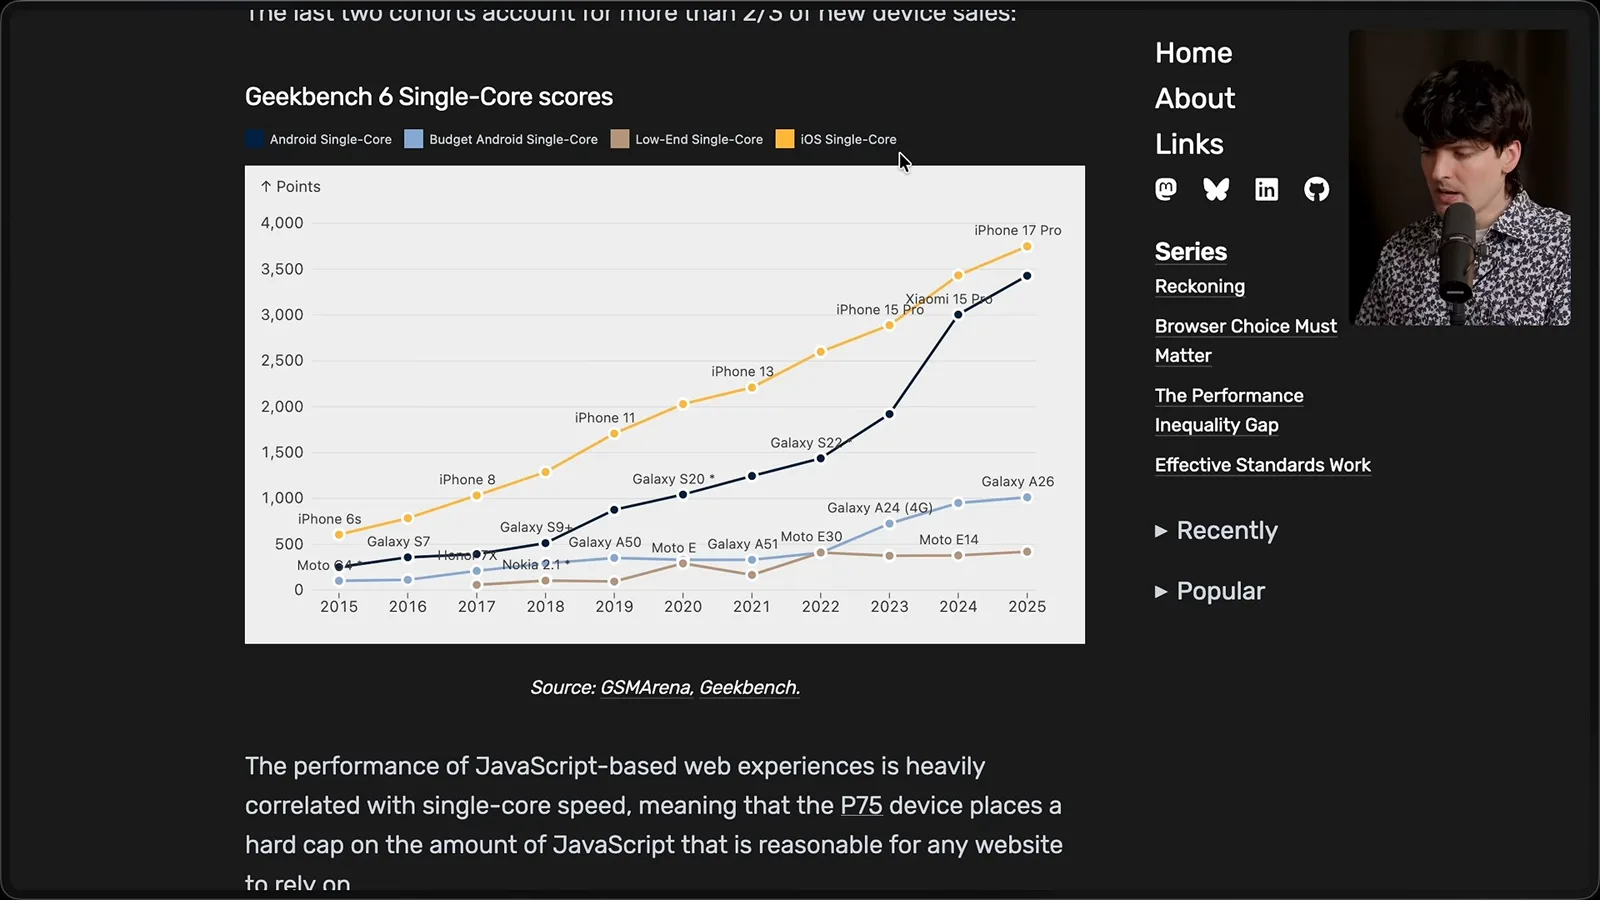
我展示了一张不同档位手机的 Geekbench 6 单核分数图,认为廉价设备的进步没有旗舰手机快。这张图衡量的是 CPU 单核性能,而不是神经网络加速器吞吐量,因此它本身不能证明设备端 AI 性能。
托管开放权重与实际成本
他认为服务商竞争是开放权重的一大优势。他比较 token 单价与基准任务成本,最后区分本地实验和普遍性的主张。
在我看来,开放权重最有力的理由是服务商竞争。不同托管方可以用不同硬件、在不同地点、以不同价格运行同一个模型。即使从不在自己电脑上运行模型的人,也因此有了选择。
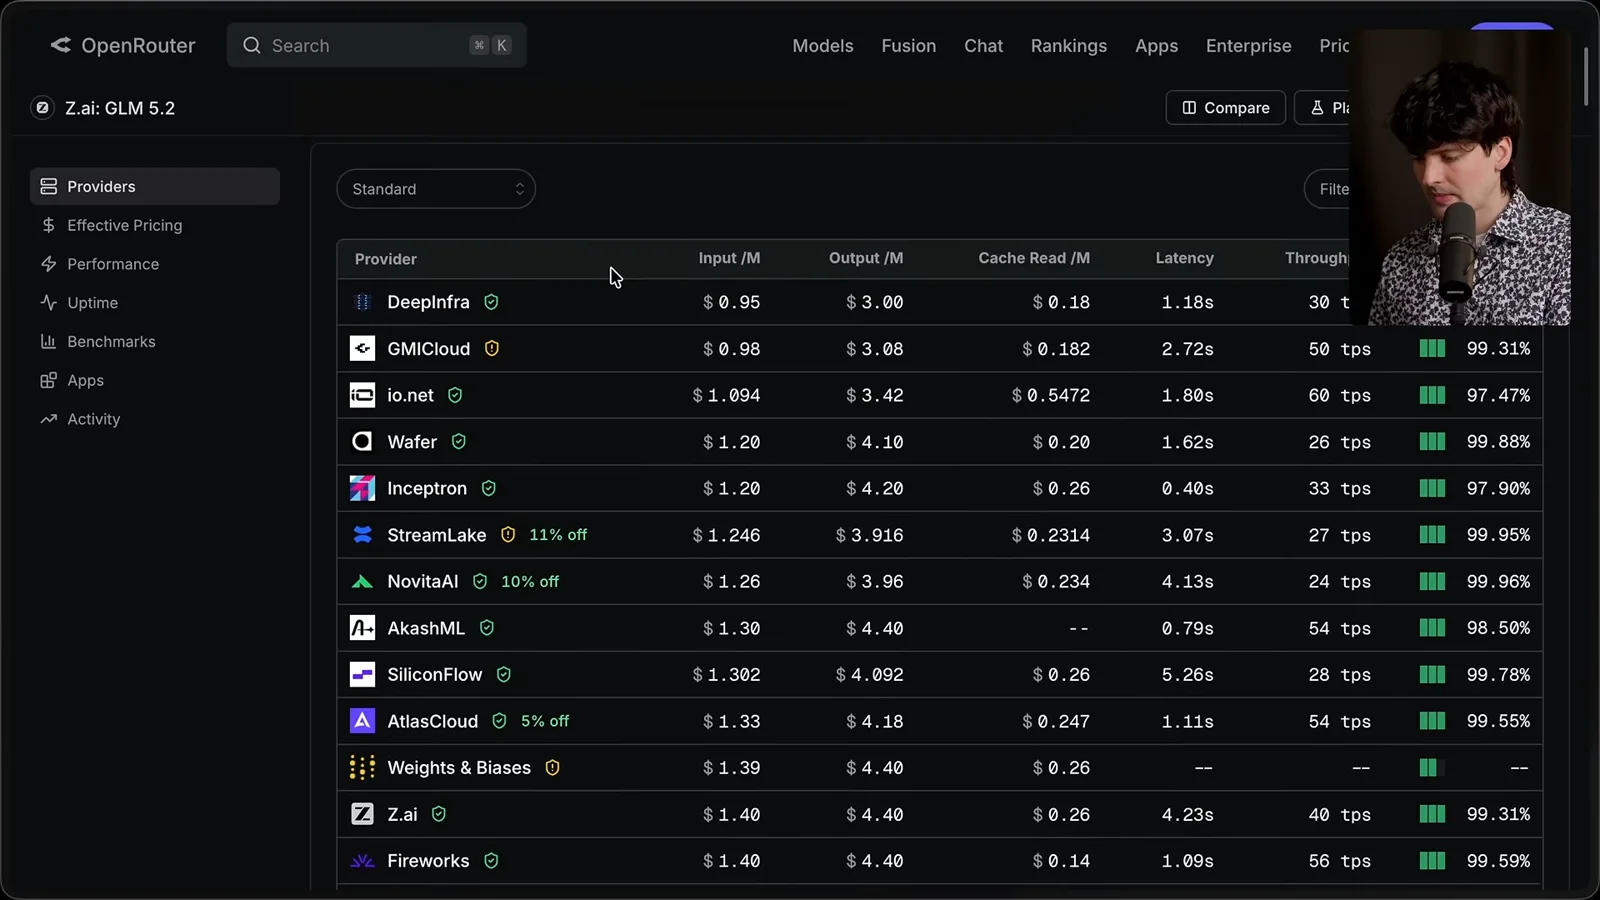
我展示的 GLM-5.2 服务商列表有不同价格、速度和可靠性。更便宜的服务商可能更慢,另一家可能为更高吞吐量收费更多。数字会变化,但关键是用户可以在不同托管取舍之间选择,而不必依赖单一服务。
托管推理把硬件采购、容量管理和电费转移给服务商,并计入价格。它也放弃了本地运行的一项重要优势:工作留在自己的机器上。隐私、控制权、可用性和成本都应针对具体服务商与任务评估。
如果开放权重模型能够可靠地满足某项工作负载,托管版本可能是很有吸引力的选择。但应比较自己任务中的实际结果和失败率,不要假定 token 单价更低就一定更划算。
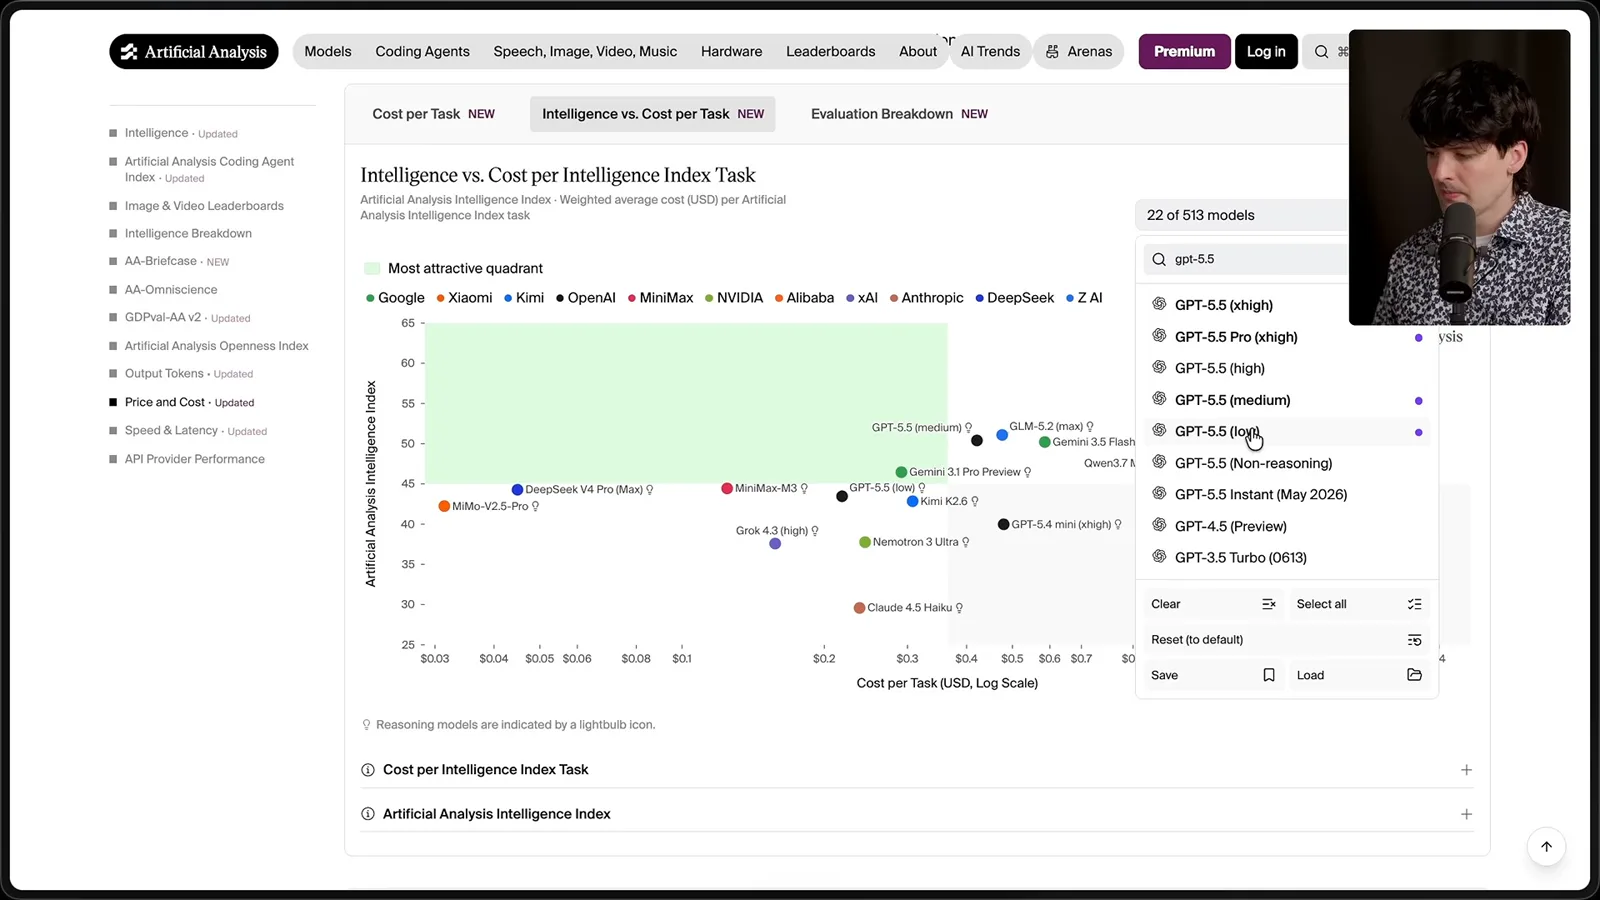
例如,我比较了当时 GLM-5.2 每百万输出 token 约 3 美元和 Opus 4.8 约 25 美元的费率。但在我展示的 DeepSWE 运行中,单项任务的估计成本分别约为 4 美元和 8 美元,因为两个模型消耗的 token 数量不同。设置和工作负载都很重要。
即使服务端每秒生成速度更高,生成更多 token 也可能让任务耗时更长。我用智能水平与成本图比较不同模型和推理档位,包括 GPT-5.5 medium 与 GLM-5.2 max。这对该评测套件有参考价值,但不是所有应用的通用排名。
我认为 GLM-5.2 是优秀的开放权重模型,在部分界面工作上也表现不错。我反对的是把标价或权重可下载当作全部事实。模型质量、总 token 数、延迟、硬件和任务都会影响真实比较。
开放权重的发布可以推动行业前进并创造竞争性市场。我不希望这种进步停止。我只是不同意每个人都能在个人硬件上运行最大的高能力模型,并获得与托管前沿服务相当的性能。
如果搭建 GPU 集群、在本地实验是你的爱好,那很有趣,也值得交流。我的请求是说清楚需要什么硬件、配置实际上能做到什么,而不是暗示同一条路适合所有人。
同频道的其他文章
 38:47EN → 简体中文
 Theo - t3․gg· 2026年10月28日Theo 的长时间 Agent 实验:验证、算力与成本Theo Browne · Ping Labs滑板游戏和两个编译器项目展示了反复检查与弹性算力如何支撑 agent 工作,也揭示了循环可能带来的高昂成本。
 36:07EN → 简体中文Theo - t3․gg· 2026年10月27日Theo 谈 Token 成本、编程智能体与 AI 能力的价格Theo Browne · Ping Labs一则关于 Lauren 的 AI 支出估算广泛传播,引出了对缓存计价、基准测试和编程智能体工作方式的讨论。
 30:37EN → 简体中文Theo - t3․gg· 2026年10月26日Theo 的三个技能:用编程智能体审查和交付代码Theo Browne · Ping Labssol-loop、full-send 和 full-stop 如何定义审查、验证以及不同程度的合并权限。
 0:43EN → 简体中文Theo - t3․gg· 2026年10月23日Theo 区分安全漏洞与实际攻击Theo Browne · Ping Labs一段简短讲解:软件漏洞披露和攻击事件为何属于不同类型的安全新闻。
 29:22EN → 简体中文Theo - t3․gg· 2026年10月22日Theo 谈安全漏洞、被盗 API 密钥与 AITheo Browne · Ping Labs从漏洞披露到补丁部署之间的风险窗口,以及被盗推理密钥为何可能有价值的推测。
 31:13EN → 简体中文Theo - t3․gg· 2026年10月20日Theo:更聪明的模型为何能帮助更多人Theo Browne · Ping Labs从游戏修改到编译器实验,Theo 重新思考谁能从更强大的 AI 中受益。