30 秒看懂
Theo Browne 质疑一项计算:它根据 Lauren 每月 1.5 万亿 token 的用量,估算出每年 1.32 亿美元的账单。他解释为什么没有分类明细就无法从 token 总数推导成本,并明确表示自己的估算也只是推测。他还认为,相近模型能力的价格正在下降,同时承认基准测试和工作流变化使实际比较更复杂。
- 1不同 token,价格不同缓存读取、缓存写入、输入和输出的费率不同。Theo 说自己综合计算后的平均价格为每百万 token 0.41 美元,但 Lauren 的用量组成和实际账单未知。
- 2以更低价格获得相当能力Theo 引用 Artificial Analysis 指数,比较不同时期相近基准门槛的任务成本。他认为,随着人们使用能力更强的模型,总支出仍可能上升。
- 3可控但范围有限的比较他的 SkateBench 测试用滑板动作问题比较 o1 和后来的模型。这展示了一项价格与性能趋势,却不能全面衡量编码工作。
- 4工作流已经改变现代智能体能调查并验证 bug,而不必让人逐次选择和测试每个修改。仅凭 token 成本无法衡量节省的人力。
要点建议
- 没有输入、输出、缓存读取和缓存写入的比例,就无法从 token 总数算出账单。
- 工程师的 token 支出既可能用于代码生产,也可能支持产品开发、研究和营销。
- 基准测试比较显示,达到一定测量能力的成本可能下降,但结果不能自动推广到所有任务。
- 智能体工作流可能花费相近的金额,同时替代更多人力工作。
- 未来价格降幅和私人折扣都是估计,不是已确认的事实。
按章节阅读整理后的全文
广泛传播的支出估算
Theo 介绍 Lauren 的用量,并质疑 1.32 亿美元的标题。公开总量没有披露计费构成。
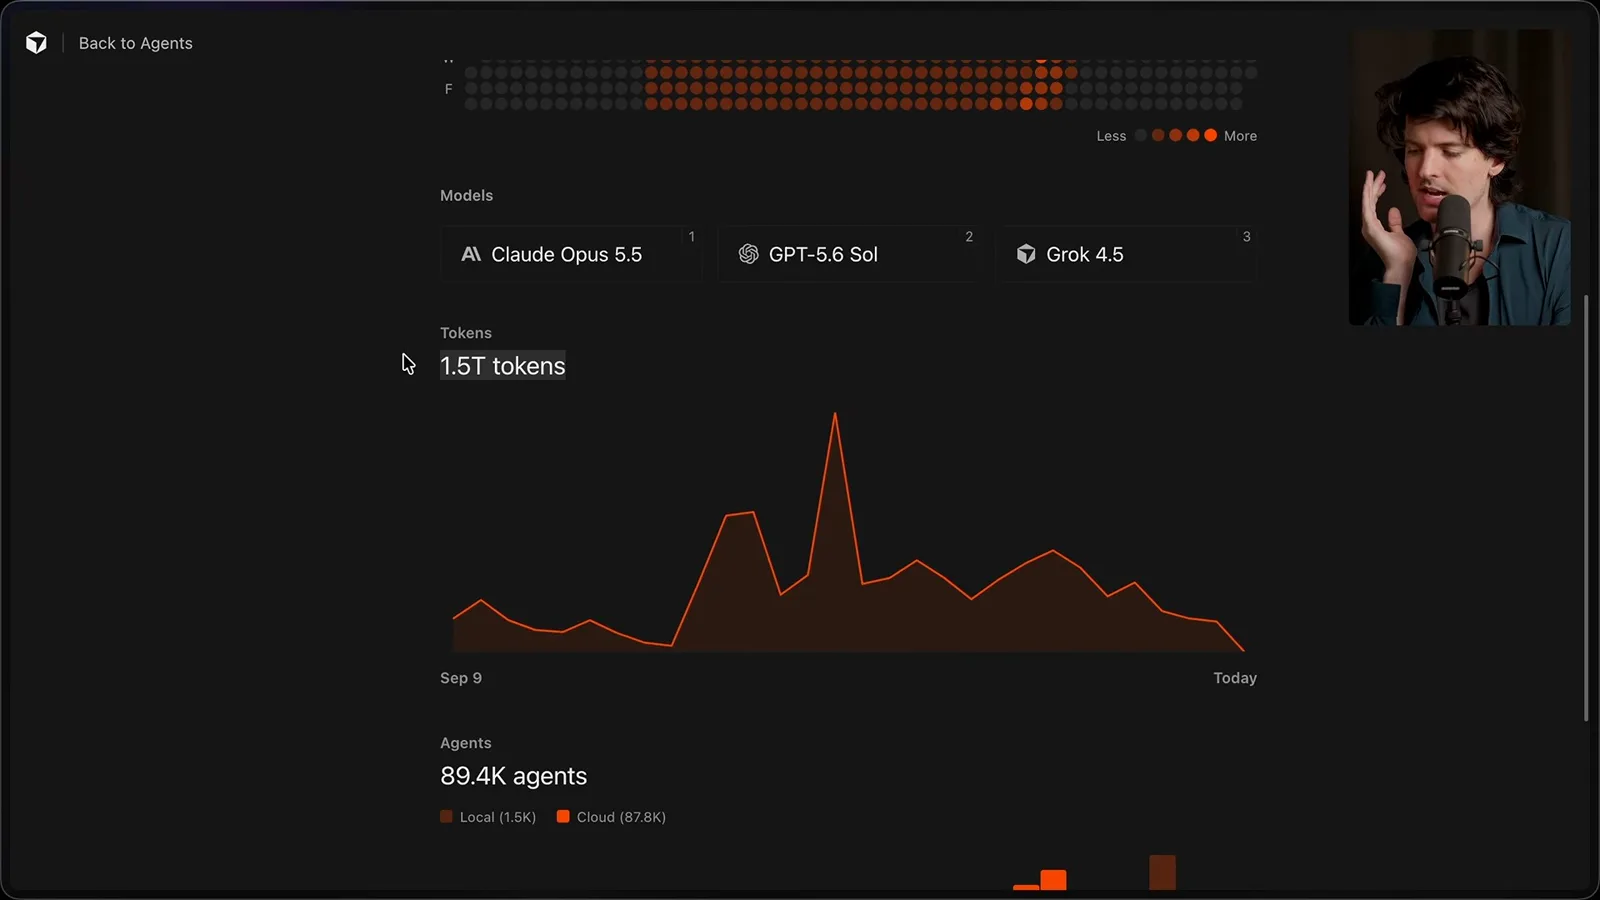
Lauren 以 poteto 之名为人所知,是 pstack 的创建者,也已成为智能体开发领域的知名人物。一则帖子声称,她的 Cursor 主页显示的 1.5 万亿 token 意味着每年花费 1.32 亿美元。这是个惊人的数字,但我认为它依赖的计价假设严重失准。
她的主页显示,过去 30 天使用了 1.5 万亿 token。我自己用量也很大,却还没达到 1000 亿,所以她的用量确实非同寻常。有意思的问题是:这个总量实际花了多少钱,她又用它做了什么?
更广泛的教训是,要审视 AI 领域那些言之凿凿的说法背后的数字。Peter 从真实的用量总数出发,假设每百万 token 平均 8 美元,得出每月约 1100 万美元的结论。我质疑的正是这个假设价格。
Token 计价如何改变计算
他区分缓存、普通输入和输出的价格。他对 Lauren 综合费率的估算只是推测。
总 token 数混合了缓存读取、缓存写入、普通输入和输出。这几类的价格差异很大。如果不知道各类的比例,就不能简单取模型输入和输出价格的平均值,再应用到全部 token 上。
我自己的用量主要来自 Opus 5.5,所有类型合计后平均每百万 token 约 0.41 美元,远低于假设的 8 美元。缓存读取和写入占据了我大部分支出,普通输入和输出不到 8%。我的比例不能证明 Lauren 的价格,但说明计算需要更多信息。
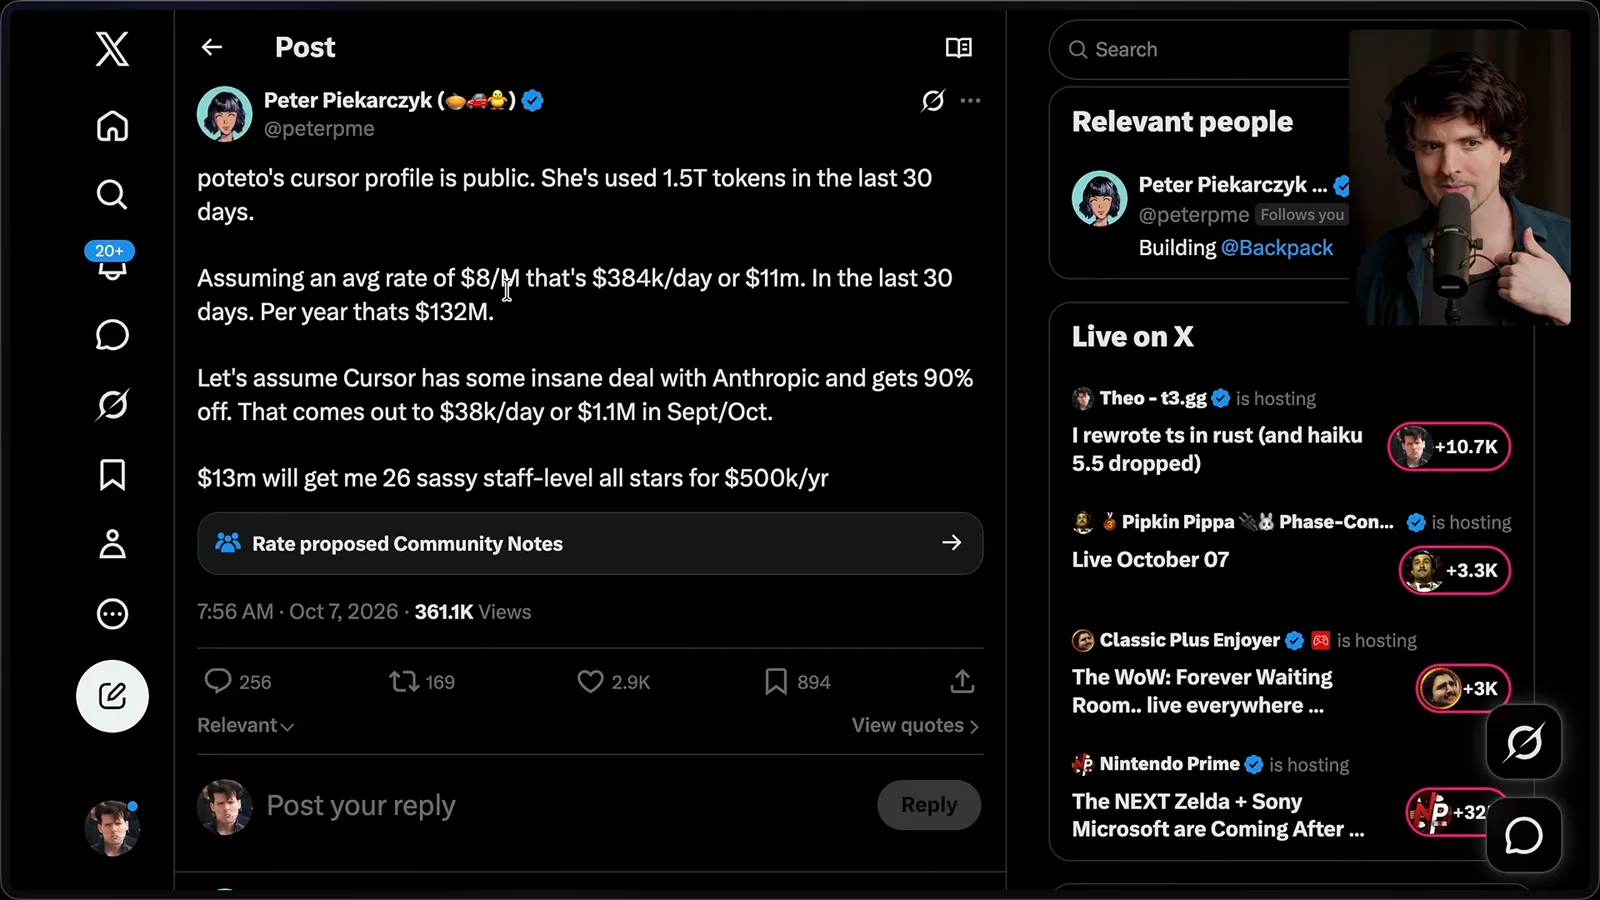
Peter 接着假设有 90% 的折扣,并把算出的年度账单与 26 位资深工程师的成本比较。我认为这种比较忽略了智能体带来的生产力:那些工程师同样需要工具和推理预算。折扣与 token 的组成都是假设,主页并没有证明它们。
我推测,Cursor 的商业协议和 Lauren 使用的模型组合,可能让综合价格降到每百万 token 约 0.20 美元。沿用同样简化的算法,每月约为 2.5 万美元。长时间运行的智能体也可能带来更多缓存命中。这些只是估计,单凭总量无法确定实际账单。
如何评价实验的价值
他讨论工程、研究和营销价值,认为 token 总数无法确定实际账单。
除了成本,也要看创造了什么价值。有些公司花在活动上的钱超过这个数字,获得的关注却不如 Lauren 的几条帖子。她的工作还带来产品反馈和代码变更:我见过 Cursor 的改进和 Grokbot 的相关工作。营销、工程和研究都应该纳入讨论。
根据用量组成,我猜综合价格还可能更低。我无法从公开主页推导出准确金额,自己的估算也不应被当成账单。我的主要异议是,1.32 亿美元的标题采用了不合适的平均价格,却把结果当成已知事实。
一定能力水平的成本
Theo 回顾基于基准测试的价格趋势,并区分能力降价和总用量增加。
争论的另一部分是:在能力水平相当时,推理成本下降得有多快?Artificial Analysis 的图表比较了不同智能水平门槛下的单次任务成本。前沿模型刚推出时可能很贵,后来的模型则能以低得多的价格取得相近分数。
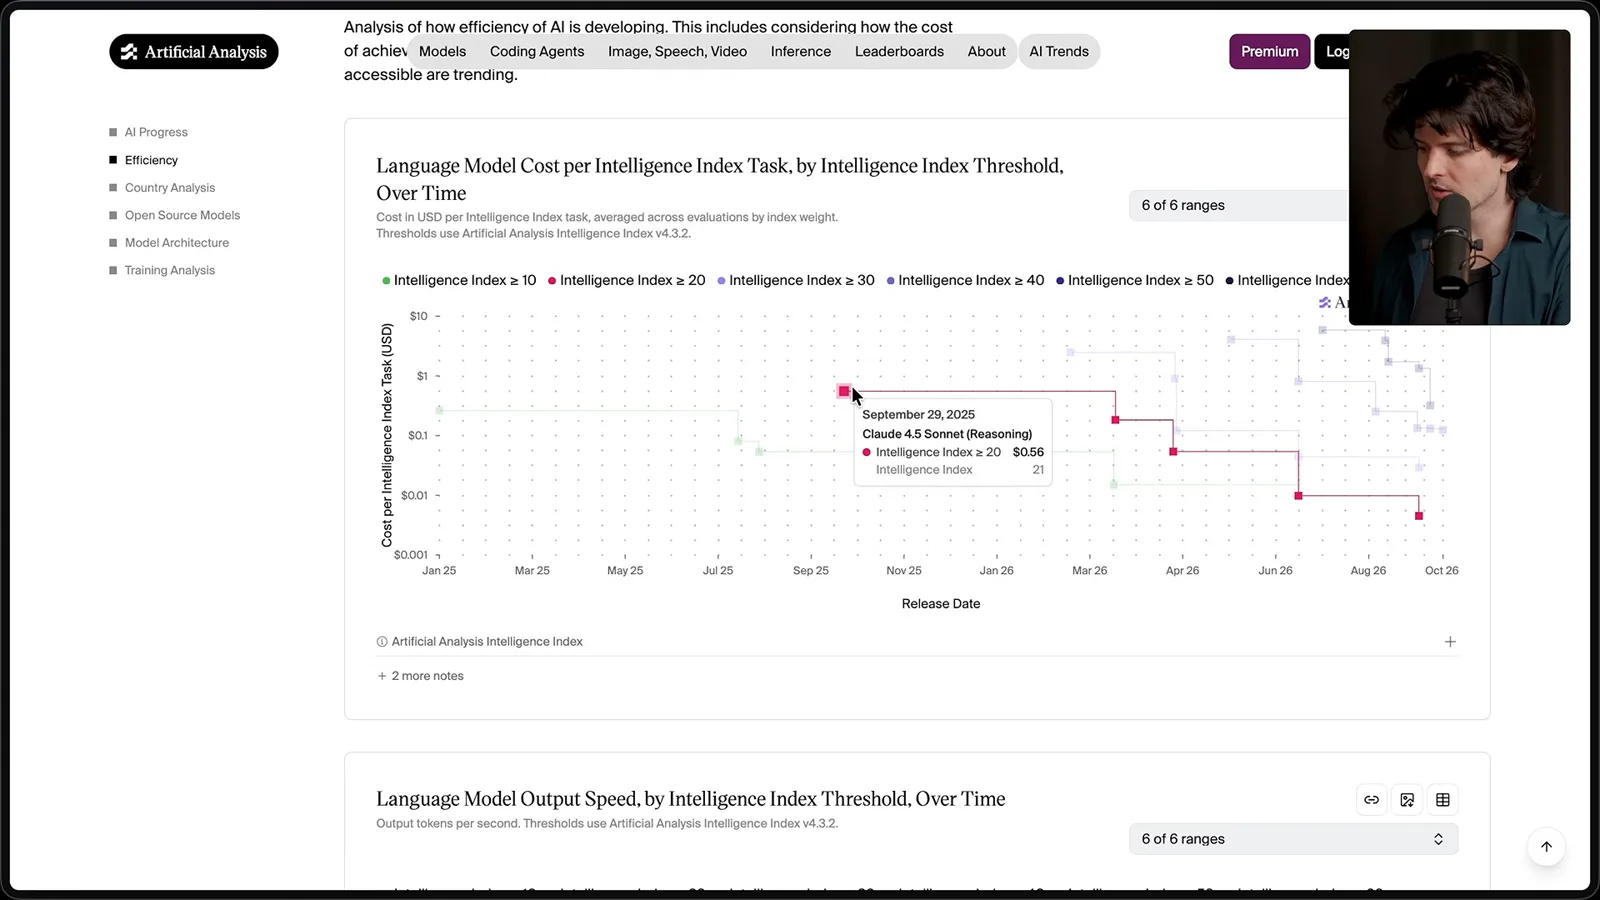
我引用的图表显示,Sonnet 4.5 在 2025 年 9 月达到超过 20 的指数分数时,每次任务约需 0.56 美元;大约一年后,GPT-6 Luna low 达到相近范围时约为 0.0045 美元。下一个门槛的对比是 2.50 美元与约 0.03 美元。这些是基准测试比较,不能保证每种实际工作流都按同样倍数降价。
这与实验室员工是否理解真实 token 预算的争论有关。我把它比作早期计算机时代,以及今天有人不计成本探索智能体工程的极限。实验按当前价格看起来可能奢侈,却能揭示未来负担得起的工作流。
一位批评者认为,基准测试价格下降,并不意味着实际应用中的智能变便宜了。我认为区别在于,人们往往选择更新、更强的模型,并用它做更多事。总支出可能持平甚至上升,同时相近能力的价格却在下降,就像总买最新款手机会掩盖上一代产品的降价。
对于长时间运行的智能体任务,我更喜欢 GLM-5.3 Flash 这样的新小模型,而不是旧一代前沿模型。提升不只是基准分数:根据我的经验,新模型更好用,也更擅长连续完成步骤。淘汰低效的旧模型,并不会抹去更便宜、能力更强的替代品。
模型价格与基准测试的局限
他比较模型费率并回应对基准测试的批评。实际工作流仍是另一个需要考察的问题。
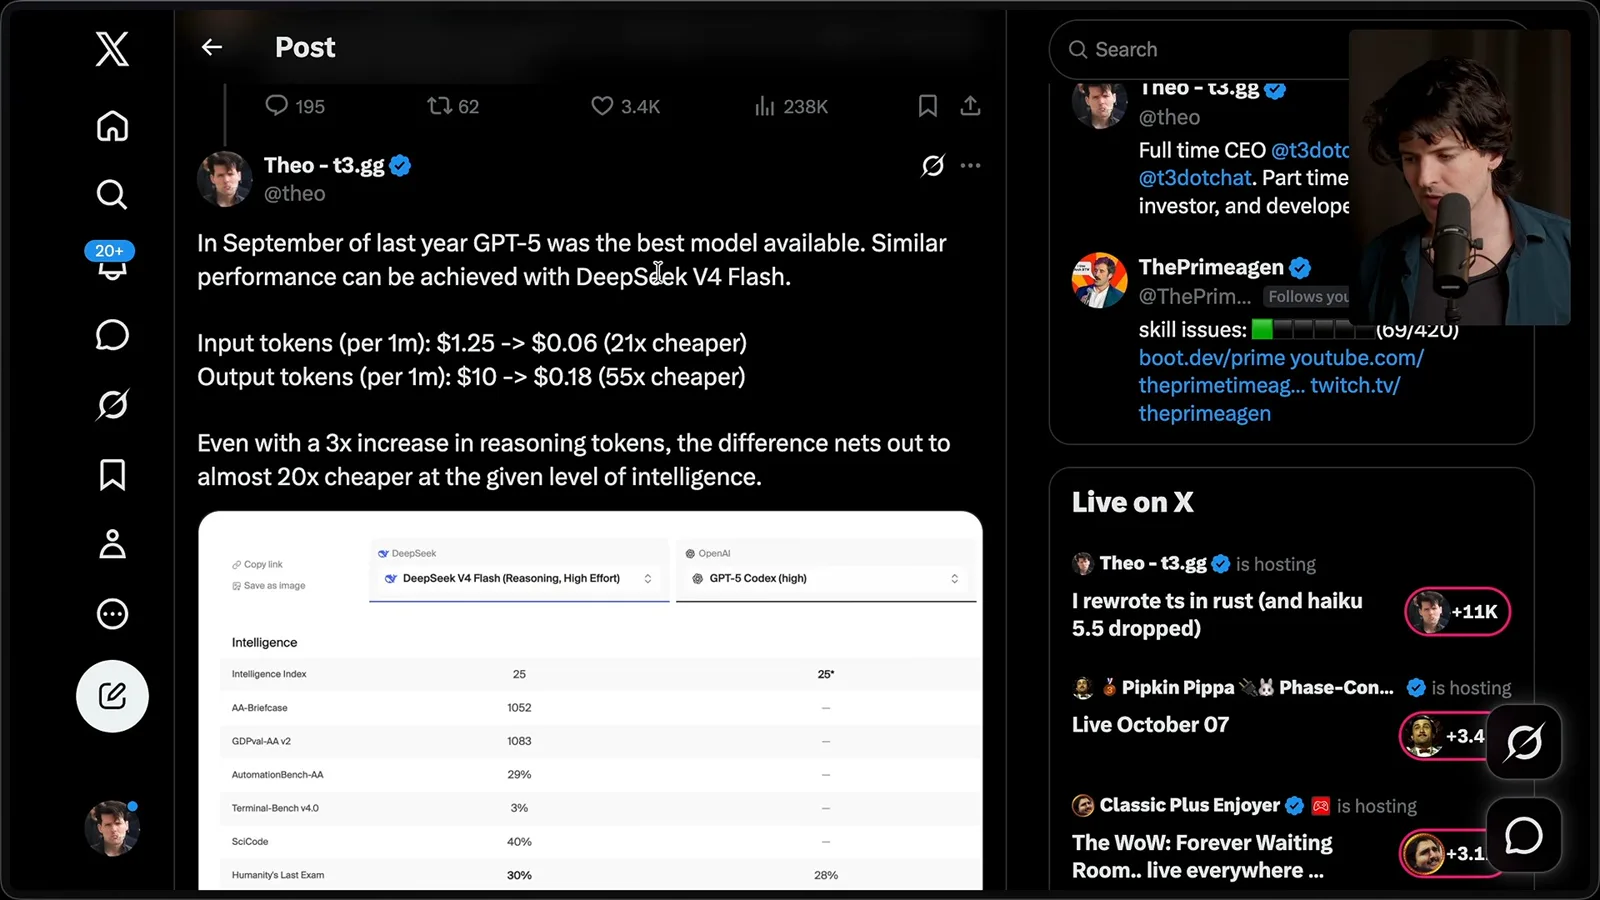
我比较了 GPT-5 和 DeepSeek V4 Flash 的 token 价格:输入价格约低 21 倍,输出约低 55 倍。即使假设推理 token 增加到三倍,我算出的成本仍低近 20 倍。具体结果取决于工作负载和 token 组成。
基准测试有局限,尤其是当前模型已经跑满旧测试,或者测试设计本身不佳时。但廉价模型如今能在旧系统曾经难以应付的测试上取得好成绩,仍是进步的有用证据。我们需要更好、更新的评估,而不是把所有旧比较都一概否定。
反对者指出,一年前花 0.10 美元解决的问题,今天可能仍然花费差不多;困难任务的可靠性也没有按基准测试价格下降的速度同步提高。这是值得研究的区别,但我不认为它证明相当水平的智能没有变便宜。
智能体改变了工作流
旧模型难以使用工具,现代智能体则能完成更多工作。Theo 回顾自己曾经低估运行命令的价值。
我把较旧的 GPT-4o 接入智能体运行环境,发现它很难使用工具并继续完成任务。现代模型能更有效地利用这类环境。只比较最终结果的价格,可能会掩盖智能体现在替用户完成的额外工作。
我自己也曾判断错过。Windsurf 加入运行命令的能力时,我把它当成新手功能:我觉得自己运行命令就行。我没有预见到,让模型在工作过程中使用 shell 和其他工具会有多大价值。
与三年前的模型比较很困难,因为工作流差异太大。当时通常需要自己搭好环境、找到文件,再让模型做具体编辑。现代智能体能接受更宽泛的指令,自己完成更多步骤,因此必须仔细定义所比较的任务。
SkateBench 比较
Theo 用可重复但范围有限的测试比较 o1 和新模型,并讨论任务成本与人力投入为何可能不同。
为了做更可控的比较,我运行了 SkateBench,一项涉及识别滑板动作名称的测试。它无法全面衡量软件工程能力,但提供了可重复的任务。2024 年 12 月发布的 OpenAI o1 在我的测试中得分为 67.7%,每题约花 0.115 美元。
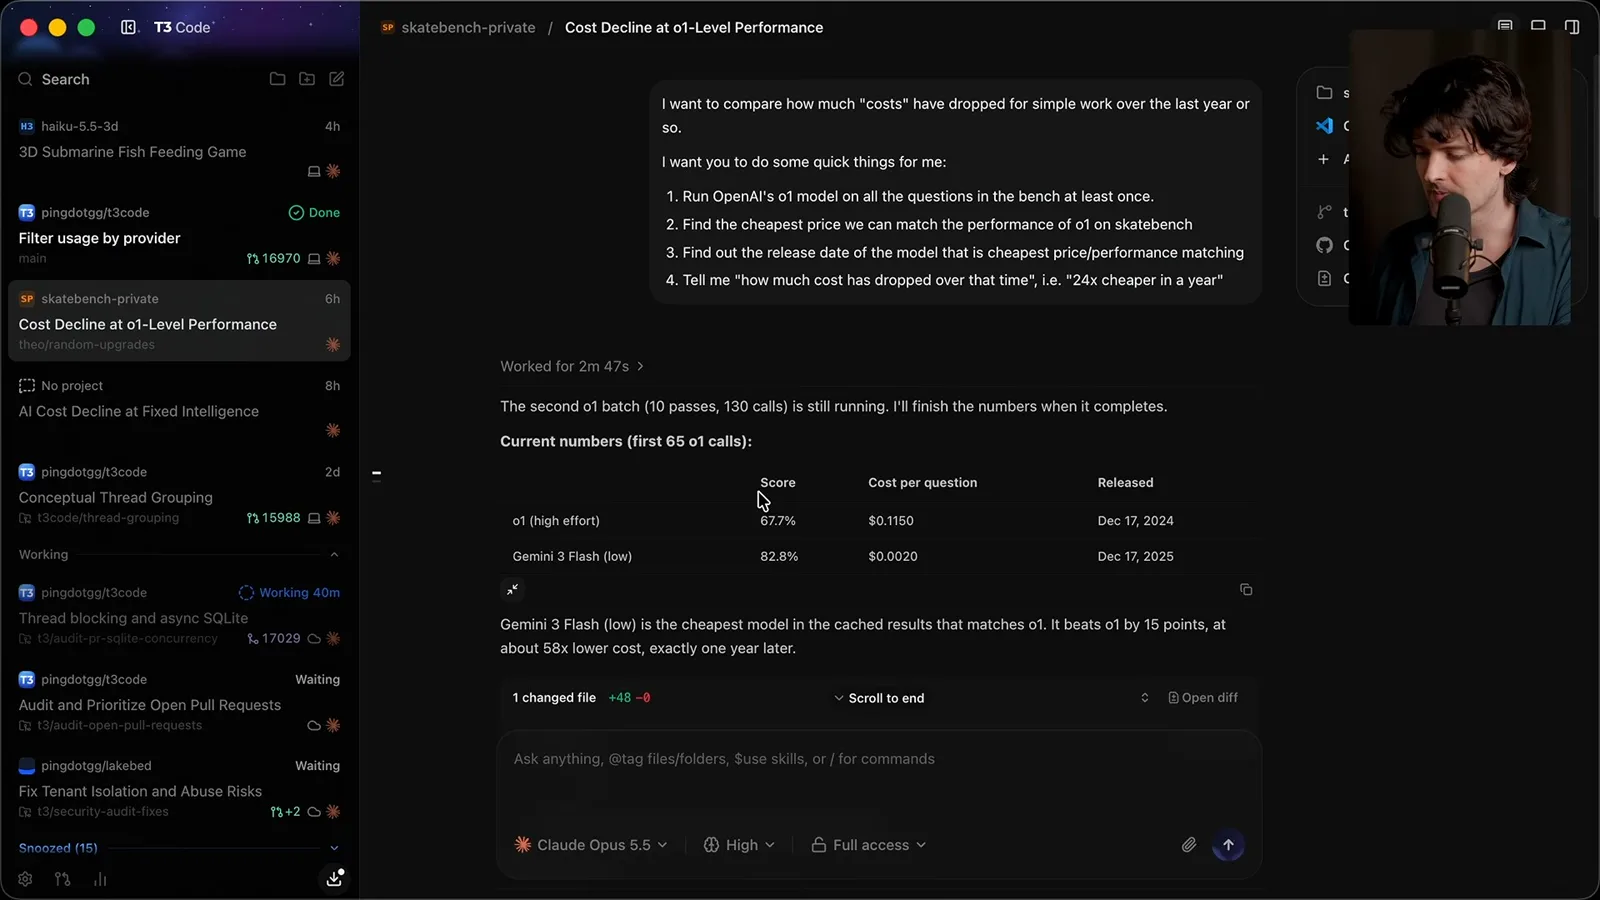
恰好一年后发布的 Gemini 3 Flash,在展示的结果中得分更高,每题约花 0.002 美元,成本约低 58 倍。后来的 GLM Flash 结果为 70.8%,每题约 0.00016 美元;我算出它比 o1 便宜约 680 倍。这些是我的基准测试结果,并非适用于所有任务的成本倍数。
照这个速度发展,我预计在某些工作负载中,运行智能体工具和 shell 的机器最终可能比推理本身更贵。不过,实际应用方面的质疑仍然重要:基准测试中的能力相当,不一定直接对应每个应用的实际结果。
以修复 bug 为例。过去我可能需要复现问题、找到文件、选中代码、让模型修改,再亲自重启应用并检查。现在我可以给智能体一张截图,让它调查、运行应用并验证修复。这个工单的 token 花费可能差不多,但人需要做的工作已经变了。
我选择 SkateBench,是因为很难找到 o1 能足够可靠地完成、适合公平比较的真实编码任务。Gemini 3 Flash 以低得多的成本取得了更好的成绩。我请批评者提供一年前使用 AI 完成的真实任务,以便做成基准测试;这场争论仍未解决。
让我沮丧的是,人们可能因为某些关于 AI 价格的说法符合自己的信念,就乐于接受它。我认为,更便宜的推理也会给模型供应商的利润率带来压力。讨论时应区分有关价格和结果的实际证据,以及对未来的假设。
支出实验的目的
他有条件地预测未来价格,认为 Lauren 的工作属于前沿产品研究。最后,他呼吁读者检查假设并承认错误。
根据我自己的粗略估计,我提出:如果趋势延续,相当水平的能力在未来一年可能大幅降价。这是预测,不是承诺。实际上,用户可能会选择更聪明的模型、解决更困难的任务并委派更多工作,而不是保持原有工作量。
Lauren 的用量也不是要成为每位工程师的常态。我把她看作一位探索前沿的特殊重度用户。评价她的支出时,应该同时考虑工程、研究、产品改进和营销,而不是仅按生产固定数量代码所花的美元来衡量。
Lauren 说,她努力成为重度用户,以便给出有价值的反馈并改进产品。我见过这些工作发生。如果人们要质疑过高的 token 用量,应该考察目的和结果,而不是以为一个庞大的总数就解释了整个实验。
当一个巨大的数字广泛传播时,先检查算术和假设。AI 助手可以帮助审查计算,但关键仍然是相关输入是否已知。在这个例子里,token 总量没有提供确定账单所需的计费类别和商业协议。
还要留意那些猜测他人动机、却回避数字本身的论点。我严厉批评认识的人,是因为我认为这些说法有害于讨论。我也要承认,自己曾经错误预测过模型能力上限、成本下降以及智能体运行命令的价值。
我以前犯过错,证据改变时也愿意公开承认。目标是理解底层信息:究竟测量了什么、假设了什么,以及基准测试或价格比较是否真的回答了所提出的问题。


