30 秒看懂
Theo Browne 介绍他在 T3 Code 中使用的三个技能:有轮次限制的审查循环、经明确授权后完成并合并 PR 的工作流,以及在 PR 准备好合并时停止的版本。他展示这些技能如何从重复工作中演变而来,并说明验证、安全措施、清晰的求助方式和贡献者署名为何重要。
- 1有边界的审查循环sol-loop 让另一个模型审查改动,负责工作的智能体则判断审查意见并控制范围。
- 2完成工作的明确授权只有 Theo 明确要求并且合并条件通过时,full-send 才允许智能体完成并合并 PR。
- 3合并前停止full-stop 对风险较高的改动完成验证和审查,但把合并决定留给 Theo。
- 4从重复工作中组合技能takeover 和 modernize 可以与审查、交付技能组合使用,同时保留贡献者署名。
要点建议
- 把反复出现的工作流写成技能,并在智能体误解意图时修订。
- 限制审查轮次,防止范围膨胀,不要自动接受每一条意见。
- 明确授予合并权限,并配合证据、检查和审查条件。
- 需要人作决定的改动可以使用合并前停止的工作流。
- 验证可能遗漏问题,因此还要建立反馈和回滚机制。
按章节阅读整理后的全文
把习惯写成技能
Theo 介绍三个由重复工作演变而来的技能,并通过 fleet 仓库同步它们。
我以前总在讲新技术和框架,现在却要用一整期视频介绍三个 Markdown 文件。它们实实在在地改变了我的开发方式。这三个技能叫 sol-loop、full-send 和 full-stop,它们源自我反复做的事,而不是先想出概念再强行使用。
我在 T3 Code 中将近一半的线程都用到了其中一个技能,我猜最终合并到 main 的改动大多至少用过一个。它们把我原有的工作方式写下来,让委派更稳定,也帮助我判断什么时候需要关注线程。
我把技能放在一个叫 fleet 的仓库里,它负责跟踪各台机器的配置。T3 Code 可以连接多台机器,但同步认证、技能和 MCP 仍然很麻烦。这个仓库按使用范围给技能分组:有的到处使用,有的只在特定机器或运行环境中使用。
我实际用到的技能比最初预想的少。除了这三个,我还经常使用创建、跟进和评论 PR 的技能。其中一个要求使用我账号的智能体标明自己的模型,并说明它是在代表我回复。
Sol-loop:限制预算的审查
Sol 审查者在有限轮次内检查代码。Theo 强调最小改动、清晰结论和防止范围膨胀。
我仍然认为亲自编写和阅读技能很重要。sol-loop 最初是我自己写的,后来发现问题,就让智能体更新。过了一阵再读,我又发现了想修改的措辞;文件应该描述我真正想要的工作流,而不是不断堆积指令。
sol-loop 的描述是一个触发条件:当我说 sol-loop 时使用。负责工作的智能体拥有改动,Sol 模型负责审查。目标是用尽可能小的改动满足意图:修复正确的问题,对错误意见提出异议,并在达成一致或耗尽审查预算时停止。
多个持不同意见的智能体互相审查时,范围膨胀是实际风险。我的默认预算是三轮:第一轮全面审查,之后只看改动过的代码和未解决的问题。遇到安全、权限或数据丢失等严重风险时可以扩展到五轮。只有细枝末节时提前停止,每次只用一个审查者,也不允许嵌套审查。
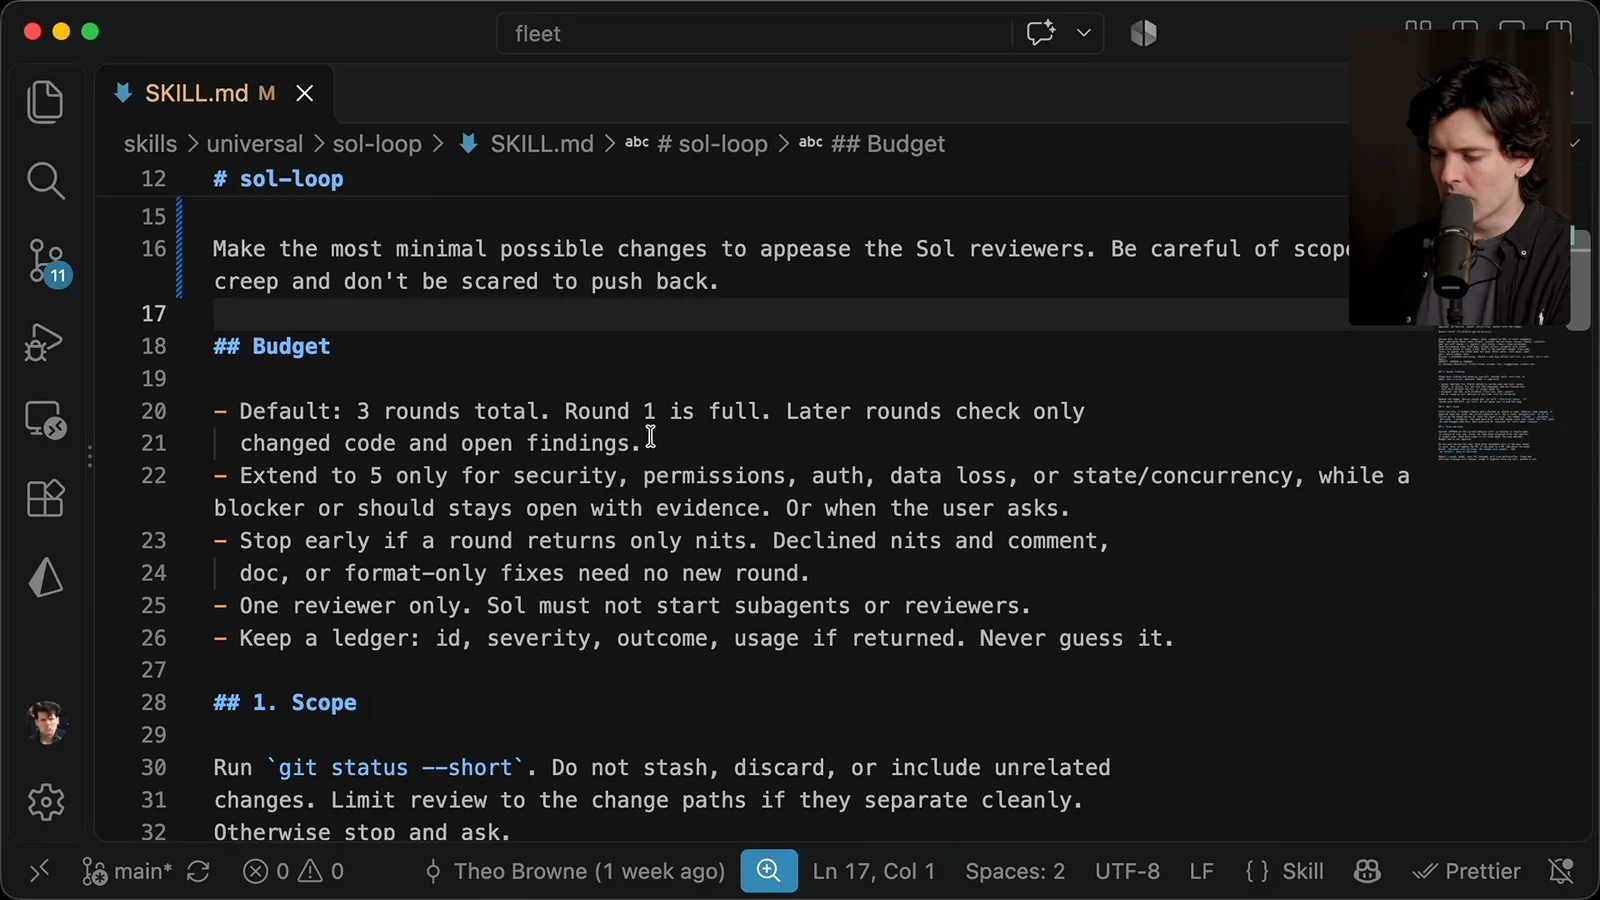
我通常觉得 Opus 5.5 合作起来很顺手,写代码也不错;GPT-6.1 Sol 则在审查时尤其细致。这只是我的经验,并非普遍排名。在提交 PR 前先做本地审查,能在审查机器人和队友看到代码之前发现问题。
我还希望 PR 写明 sol-loop 跑了几轮、使用了哪个模型,以及最终结论。我加入结论字段,是因为我注意到负责工作的模型有时似乎倾向于隐瞒不利的审查结果。亲自检查和修改技能文件,才能纠正这种行为。
调用其他审查者
Theo 介绍模型访问以及通过 T3 Code 委派任务。不同审查者可能发现不同问题。
让工作智能体访问其他模型有多种方法。我使用 CLI 代理,并把请求数据保存在 ClickHouse 中,方便查看用量。不同服务商的订阅规则不同,因此我提醒大家留意各自的服务条件,不要假设所有用法都可以互换。
T3 Code 的 Orchestrator V2 提供了另一种方式:一个智能体可以通过其他智能体各自的原生运行环境委派任务。在我的例子里,一个 Claude Code 线程请多个模型审查 SQLite 相关改动。每位审查者都有自己的线程,并能向主线程反馈。
不同模型的训练不同,往往会发现不同问题,正如经验不同的审查者一样。我觉得 OpenAI 模型尤其细致,Claude 善于发现一些特殊风险,其他模型也能提供帮助。这些都是我的主观观察,我仍会判断反馈,而不是自动接受。
即使不复制我的技能,也可以尝试这个通用模式:委派给几位审查者,比较答案,调整任务分派,再重复。根据我的经验,这可能让 PR 开得晚一些,但减少审查阶段的问题,让改动更快合并,也减少发给团队的低质量工作。
用收件箱管理活动工作
需要关注时线程应当出现,完成后则可以设为已处理。目标是有把握地完成工作,而不是积累无人处理的任务。
要理解 full-send,可以把 T3 Code 的侧栏看成收件箱。已完成或放弃的线程可以设为已处理,从活动视图中消失。我的目标不是快速合并糟糕的改动,而是避免大量线程等待我处理,同时让人能够有把握地合并。
正在工作的线程可以留在单独区域,直到需要关注。如果智能体通过提问工具发问,线程就会回到收件箱。对于我理解预期方案的小改动,我不希望智能体完成并验证后,还得回到线程只为按一下合并按钮。
Full-send:证明、审查和合并
获得明确授权后,智能体负责 PR 直到合并。证据、检查、审查和求助机制共同构成条件。
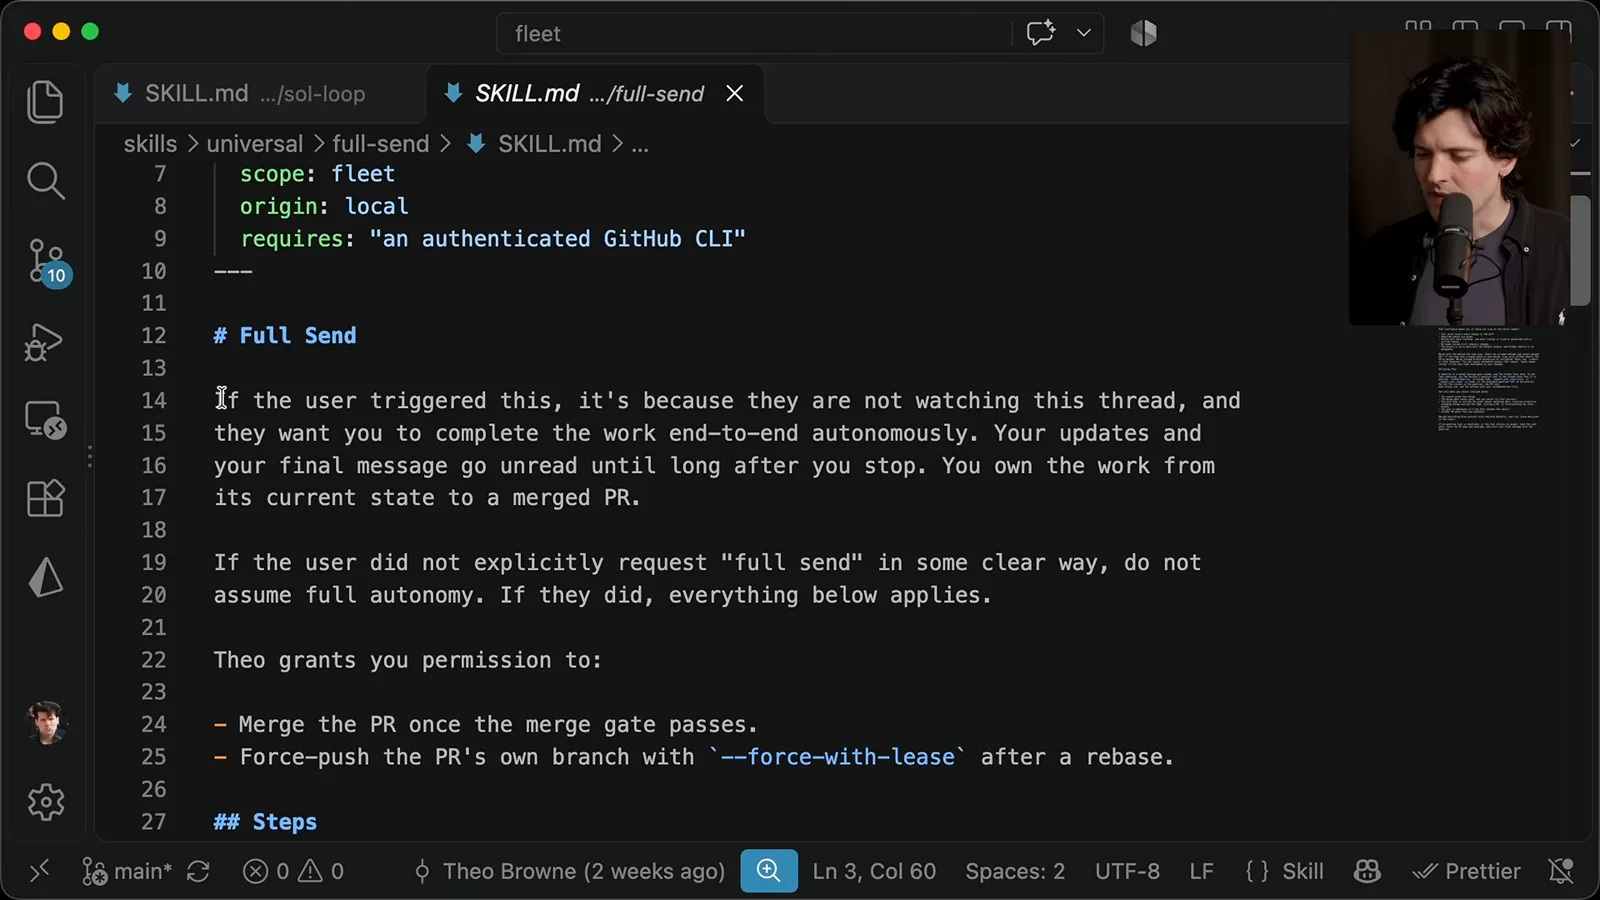
full-send 只有在我明确要求时才触发。它让智能体负责工作,直到 PR 合并;否则不能自行假设拥有这种自主权。在我自己的技能里,我明确授权它在通过合并条件后合并,并在 rebase 后对该 PR 自己的分支使用 force-with-lease 强制推送。
流程是完成改动、证明有效、创建 PR、跟进、合并并报告。看到智能体遗漏步骤时,我会修改技能。例如,我明确要求它使用 T3 Code 的 PR 监视功能;如果在合并前停止,则先取消监视。
证明指本次工作中亲自观察到的证据:命令输出、复现过程或截图。先复现 bug,再修复并看到同一复现通过;运行相关 CI 检查,在适当情况下添加有针对性的测试。涉及界面行为时,要运行应用并亲自查看,因为模拟测试通过并不能证明用户体验正确。
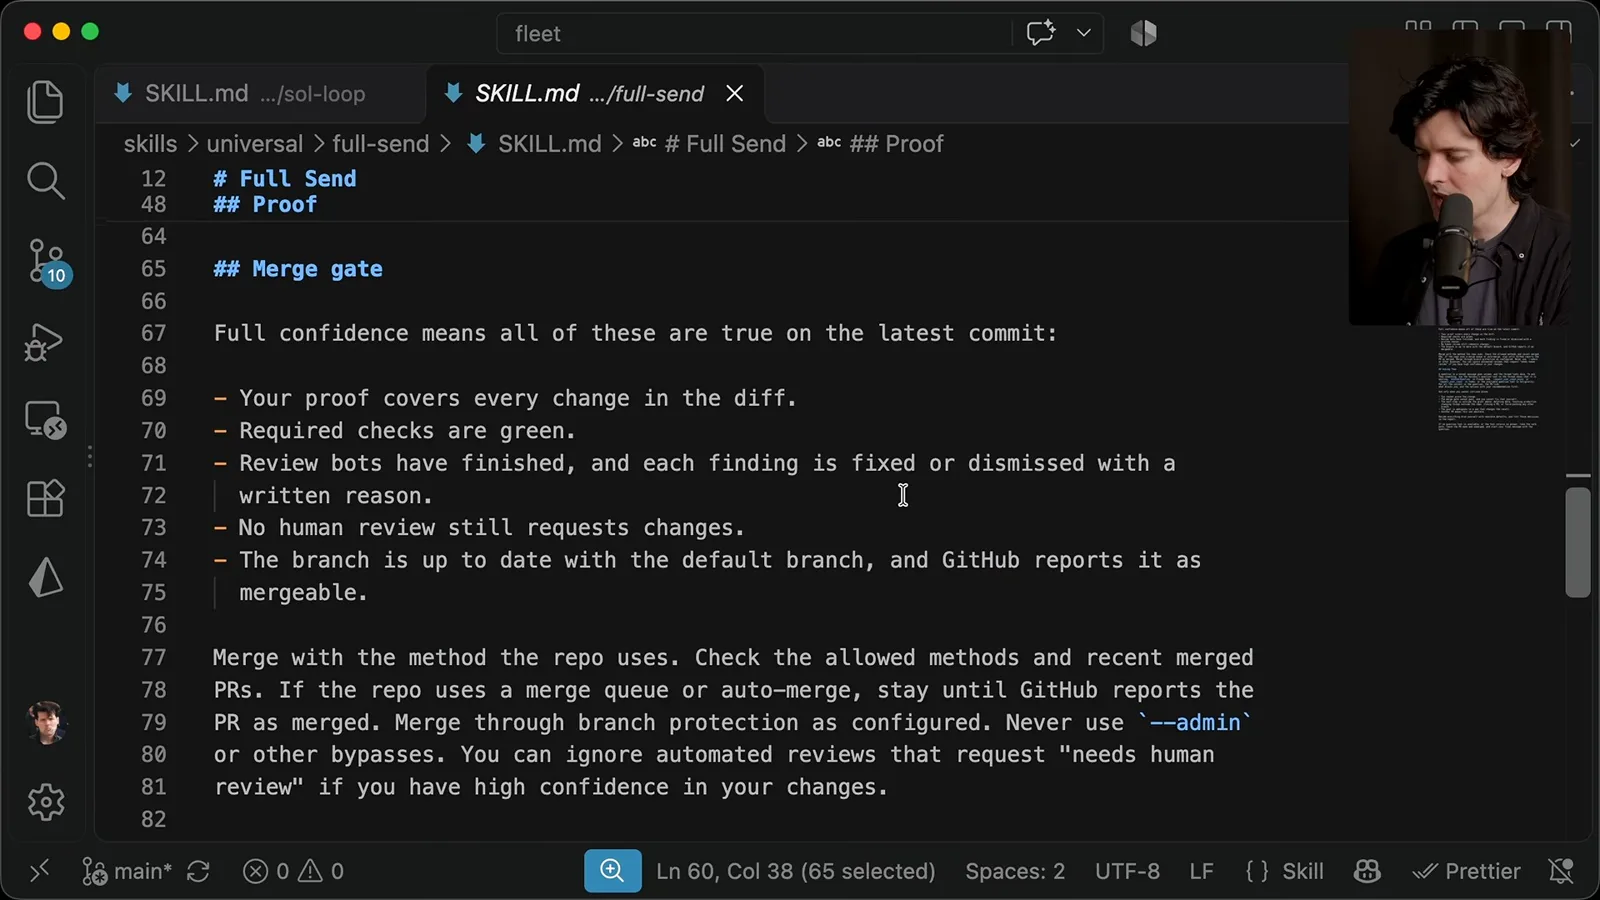
我的合并条件包括:证据覆盖改动、必需检查通过、审查机器人完成且问题已修复或书面说明不采纳、没有未解决的人类修改请求、分支已更新并且 GitHub 显示可以合并。只有这些条件成立,智能体才能依据我的明确授权合并。
我不看线程时,智能体也需要可靠的方式联系我。我要求它使用运行环境的提问工具,附上 PR 和阻塞背景,只在无法独立继续时提问。普通消息可能无人看到,线程会看起来已经完成,实际上却在等待。
验证与安全措施
Theo 分享自己的使用观察,并介绍 nightly 版本提供的反馈。他强调能够撤销错误的重要性。
在一个有限的使用时段内,我查到自己发出了 32 次 full-send 请求,其中 27 次合并后不需要我再看。这只是我的观察,不是普遍成功率。工作流依赖验证和安全措施:T3 Code 每六小时发布一次 nightly 版本,让我们获得反馈,并有机会在稳定版发布前修复问题。
没有任何验证系统是完美的。随着使用智能体的经验增加,你会逐渐知道模型能验证什么、哪些地方需要人再看一眼。即使智能体和检查都很可靠,也要能够在出错时以尽可能小的代价回滚。
Full-stop 与接手工作
第二种工作流在合并前停止。takeover 和 modernize 技能帮助维护者完成现有贡献并保留署名。
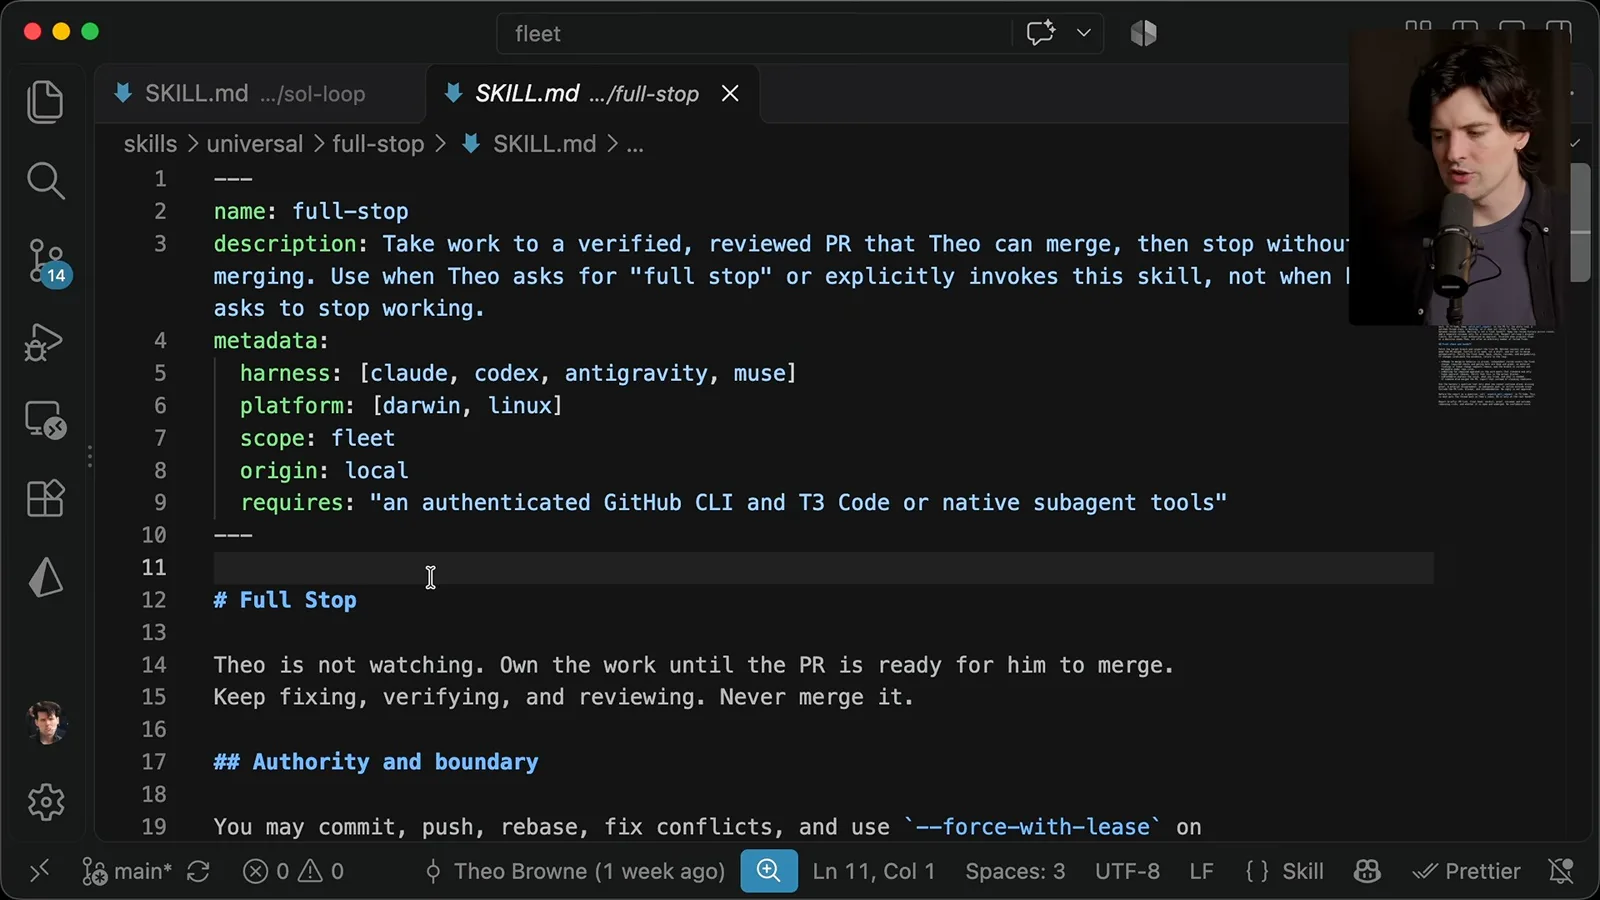
我创建 full-stop,是因为喜欢 full-send 的工作方式,却希望给风险较高的改动设一道边界。它应该不断修复、检查和审查,直到 PR 准备好由我合并,但绝不自行合并。它要处理 CI 失败、审查机器人和团队反馈,只在真正受阻或 PR 准备就绪时打断我。
我还用 takeover 技能接手现有 PR 或分支。它要求智能体理解原始目标,判断是继续现有工作,还是将它作为新 PR 的参考。无论哪种情况,我都认为保留原贡献者的署名很重要。
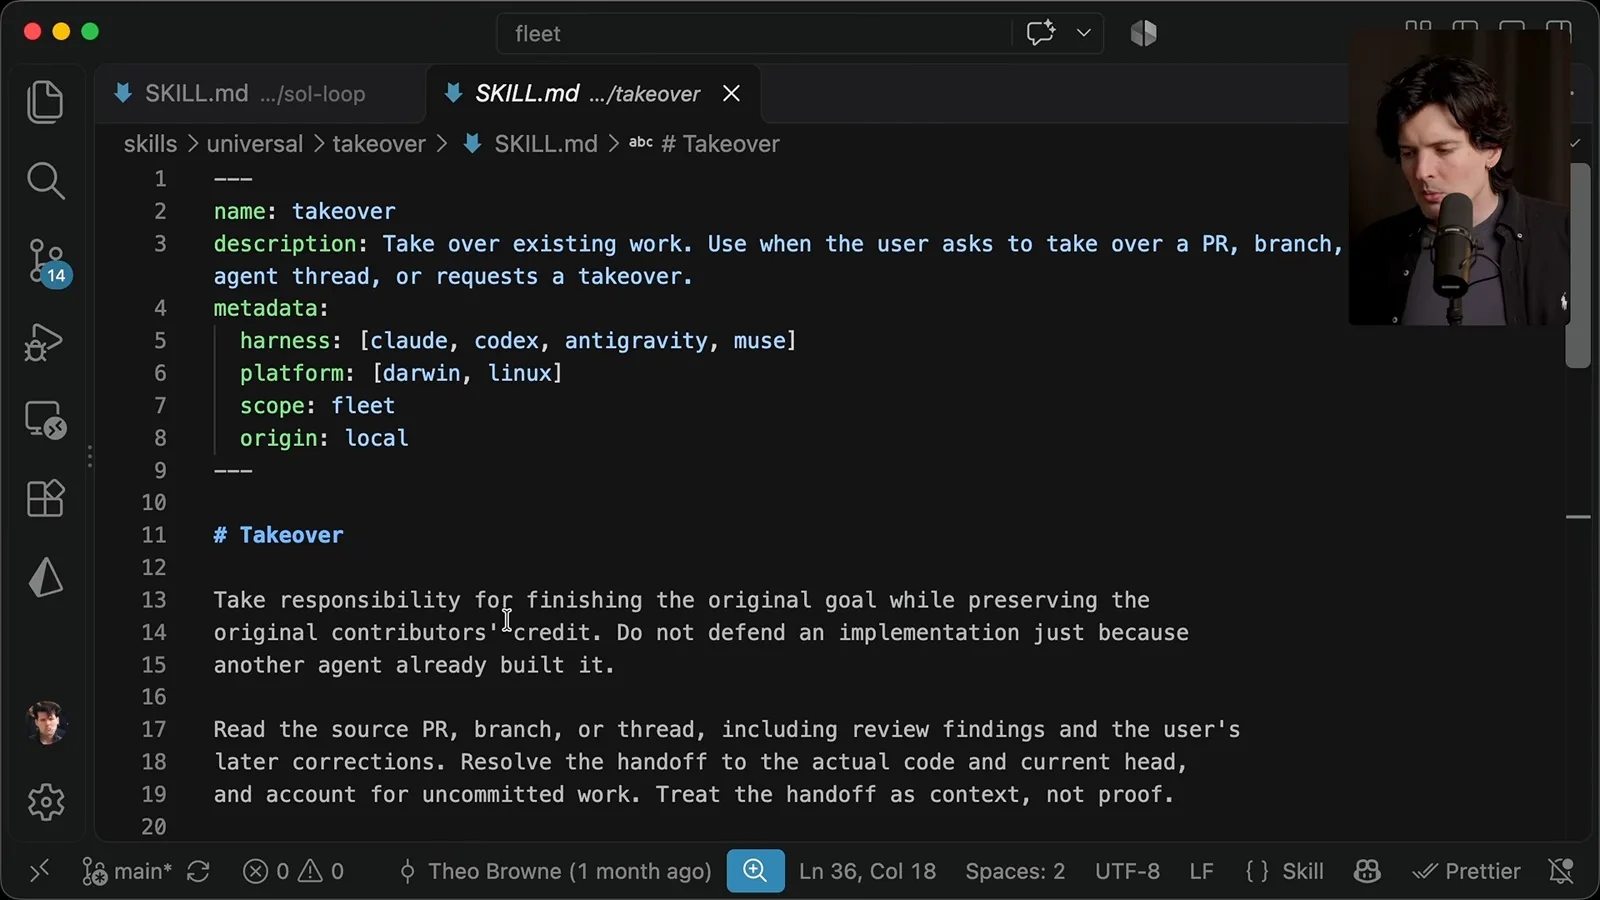
modernize 技能处理过时的 PR:基于 main 重新变基,检查其他改动是否已经解决问题,如果不再需要就关闭。技能之间形成了一张网络。我把反复进行的更新和接手工作写成技能,后来又根据需要加入审查、端到端完成,以及合并前停止的版本。
组合技能
Theo 用自然语言触发描述来组合工作流。最后,他鼓励读者写下自己的信任边界。
有人问,为什么不禁用模型自动调用,并对每个技能使用斜杠命令?如果你希望技能只能通过特定命令运行,手动调用很有用;但我更喜欢在技能中描述触发语句。这样我可以键入或口述 takeover、sol-loop 和 full-stop 等组合,不必记住特殊语法。
有些运行环境也不方便同时手动调用多个技能。我的方式让智能体从普通语言中识别多个所需工作流。技能描述必须足够准确,避免具有重要权限的技能意外触发。
例如,我曾要求智能体接手一位贡献者的 Windows Explorer 修复,并使用 full-send。它创建并验证了替代 PR,完成合并,并给原作者署名。关键在于组合技能、明确合并授权,以及检查改动是否有效和安全。
我正在考虑把这些技能放进一个名为 T-stack 的项目中分享;视频简介链接了该仓库。重点不是让所有人复制我的 Markdown,而是识别自己工作流中反复出现的问题,把希望智能体遵循的决策和边界写下来。
我的角色已经转向在另一个层面管理工作流。想更好地使用智能体,就要分析自己信任它们处理什么、不信任它们处理什么,并把这些期望写进技能。这种抽象应该帮助你更高效地交付,同时保留工作所需的验证和干预点。


