30 秒看懂
Theo Browne 讨论 GPT-5.6 Sol 用量消耗迅速的报告,并分享对自己工作流有帮助的调整。他比较历史基准成本、介绍明确停止点,并提醒不要不加判断地照搬配置建议。价格、限额和产品细节均为 2026 年 7 月的快照。
- 1限额正在变化视频介绍了 2026 年 7 月的一项临时套餐变化,并提醒每周用量仍然重要。
- 2fast 模式的成本Theo 报告了他使用版本中的速度与额度消耗取舍。
- 3推理与基准DeepSWE 展示了不同强度下特定任务的得分与估算成本差异。
- 4观察委派情况Theo 建议观察子代理用量,仅在需要时调整偏好。
- 5定义停止点提示词可以规定何时暂停等待反馈或把工作交回。
- 6关注产品变化视频录制期间的后续更新报告了计费和效率方面的变化。
要点建议
- 一次较长的自主请求可能消耗更多额度,同时替代多次较短的互动。
- fast 模式、推理强度和子代理并发都可能改变总用量。
- 基准的成本与得分曲线针对特定任务,不能决定所有项目的最佳设置。
- 清楚的停止点让人工反馈和工作交接更容易控制。
- 修改上下文或订阅设置前,应查看服务商当前的指导。
按章节阅读整理后的全文
用量突然增加
Theo 介绍用户报告、自己的体验和比较的局限。
GPT-5.6 Sol 能力很强,但发布后不久,许多用户报告说使用额度比 GPT-5.5 更快耗尽。我也遇到了同样的问题。我的建议来自个人实验,而产品和限额在 2026 年 7 月录制时变化很快。
调整设置和提示词后,我在一些工作中看到了更好的结果,同时使用的 token 大幅减少。这不是受控比较,也不能保证每个人都能节省同样的用量。应衡量整个任务,包括审查和修正。
套餐与变化中的限额
他回顾服务商的临时更新,解释为什么仍需监控高消耗运行。
我使用较高档位的订阅,在早期访问用量开始计入额度后很快触及限制。测试时,Ultra 是重要原因。我当时选择暂时不用它,并另行讨论其多代理行为;这是对所测试版本的判断。
视频展示的一则 OpenAI 更新称,在推出效率改进期间,某些套餐的五小时限制暂时取消,每周限制仍然重要。这是 2026 年 7 月的临时情况,并不代表当前套餐或可用性。
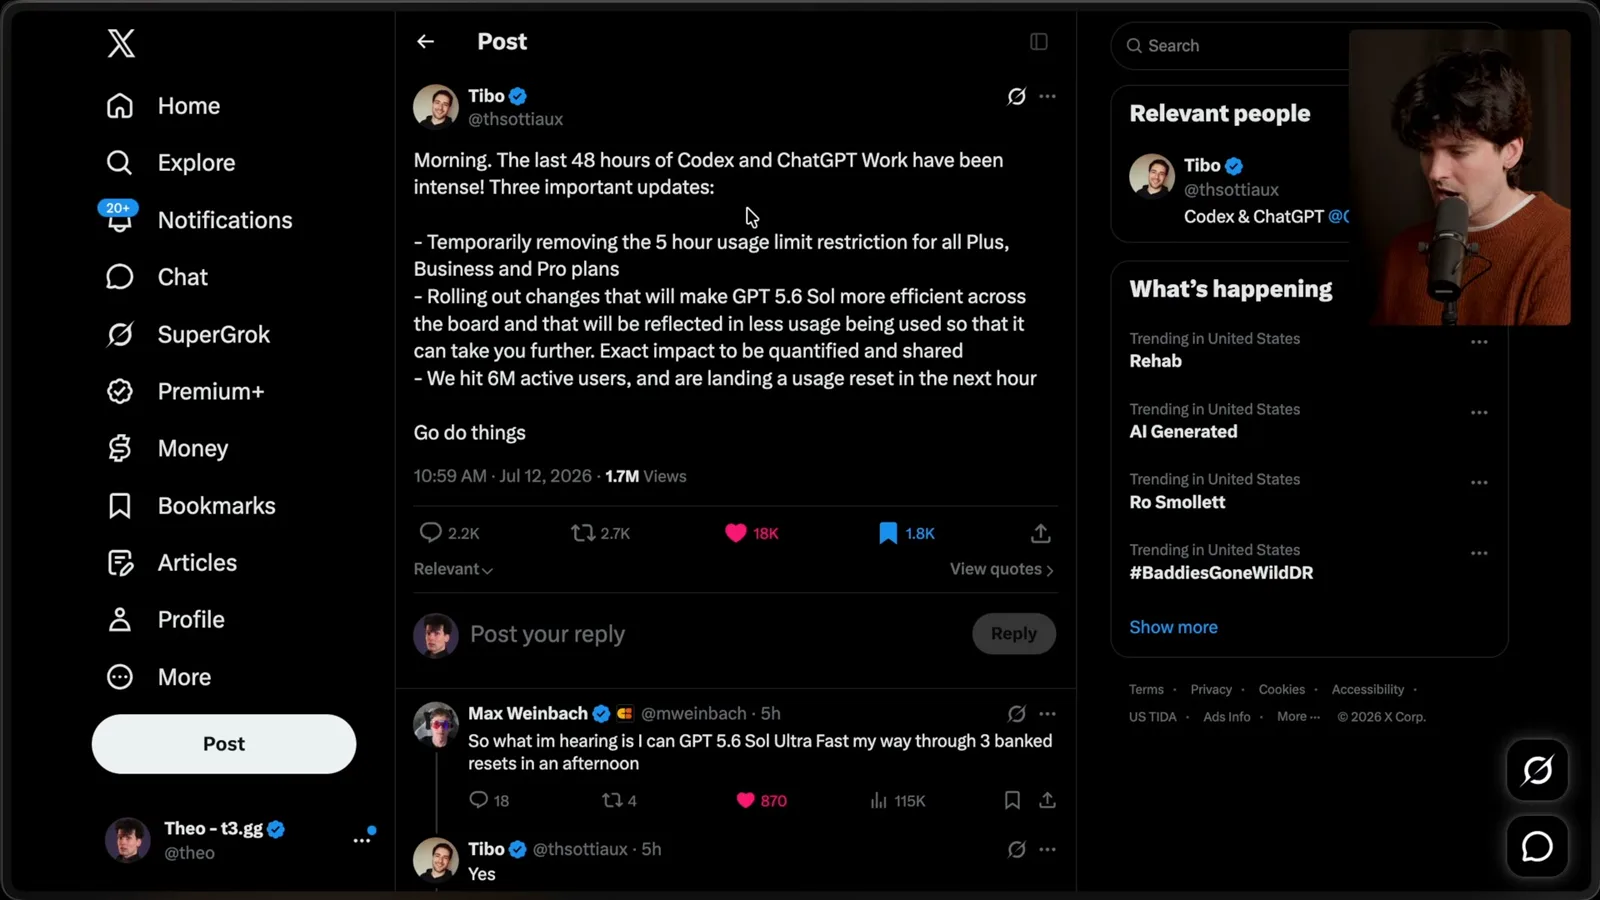
取消短时间窗口限制可以提供灵活性,但也会减少一次自然中断,使高消耗任务可能用掉更多每周额度。应查看实际用量和自己账户的当前规则;一个用户的数字不能说明所有人的额度。
更长的运行、fast 模式与强度
Theo 比较自己的模型体验,并用基准说明成本与质量的取舍。
依我的经验,GPT-5.5 常常停下来请求反馈,也可能在长任务中偏离方向。Sol 倾向于每次请求持续工作更久。这很有用,但也意味着逐条比较消息用量容易误导:一次较长的请求可能替代多次较短的互动。
我观察到,在较高强度下,Sol 的单次请求可能比此前请求消耗更多额度。模型持续执行的时间、任务和工具都会影响结果。这些百分比是我对自己账户的观察,不是公开的换算表。
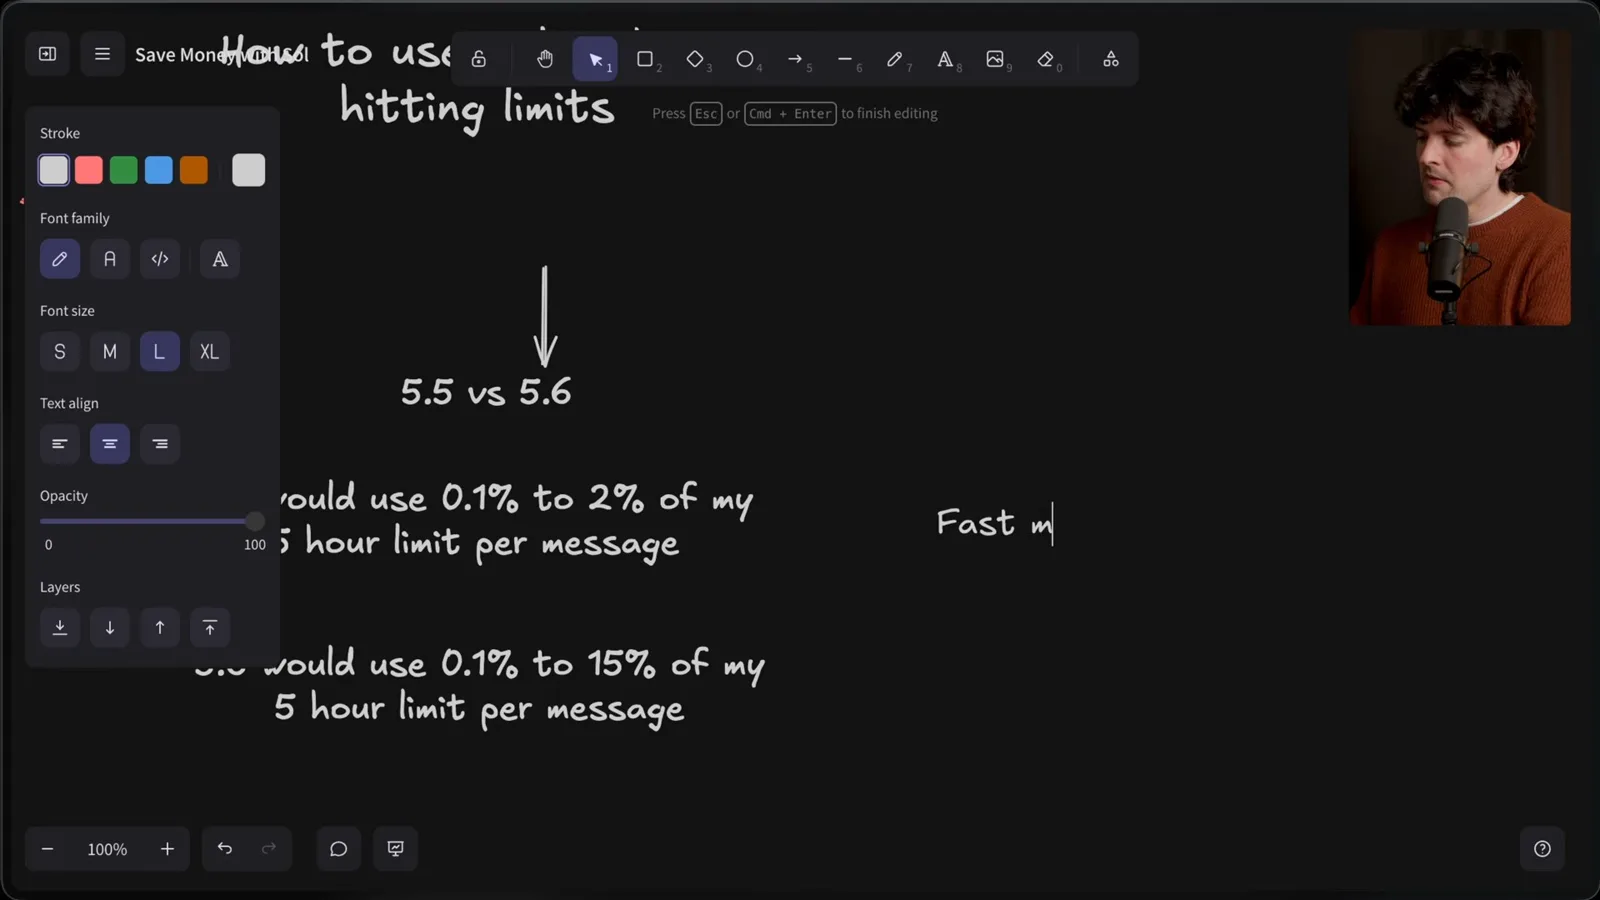
fast 模式还改变了延迟与用量之间的取舍。在我描述的版本中,我估计输出速度约快 1.5 倍,额度消耗速度约快 2.5 倍。对于耗时主要来自测试和工具的长任务,这种提速对我可能没有那么有价值。
使用 5.5 时,我常常盯着代理,因为它会停止并需要新的提示词;速度因此显得重要。使用 Sol 时,我可以启动工作后做别的事。关掉 fast 模式后,我个人感到额度压力减轻,主观上却没有明显变慢。
长期运行的代理也需要合适的停止点。我发现并非总需要持续目标机制来让 Sol 继续工作。长时间自主运行是否合适,取决于任务以及你需要的审查或批准节点。
当时我主要使用 high 推理强度,也认为 low 和 medium 有用,而 extra-high 或 max 应留给额外成本有理由的情况。这是我的偏好,不是普遍默认值;应使用有代表性的任务自行测试。
在我展示的 DeepSWE 图表中,Sol 在 low、medium 和 high 下分别约得 45%、61% 和 69%。图中每任务估算成本从约 1 美元升至 1.86 美元和 3.47 美元。这是特定基准的 API 成本估算,不是每位订阅用户的实际费用。
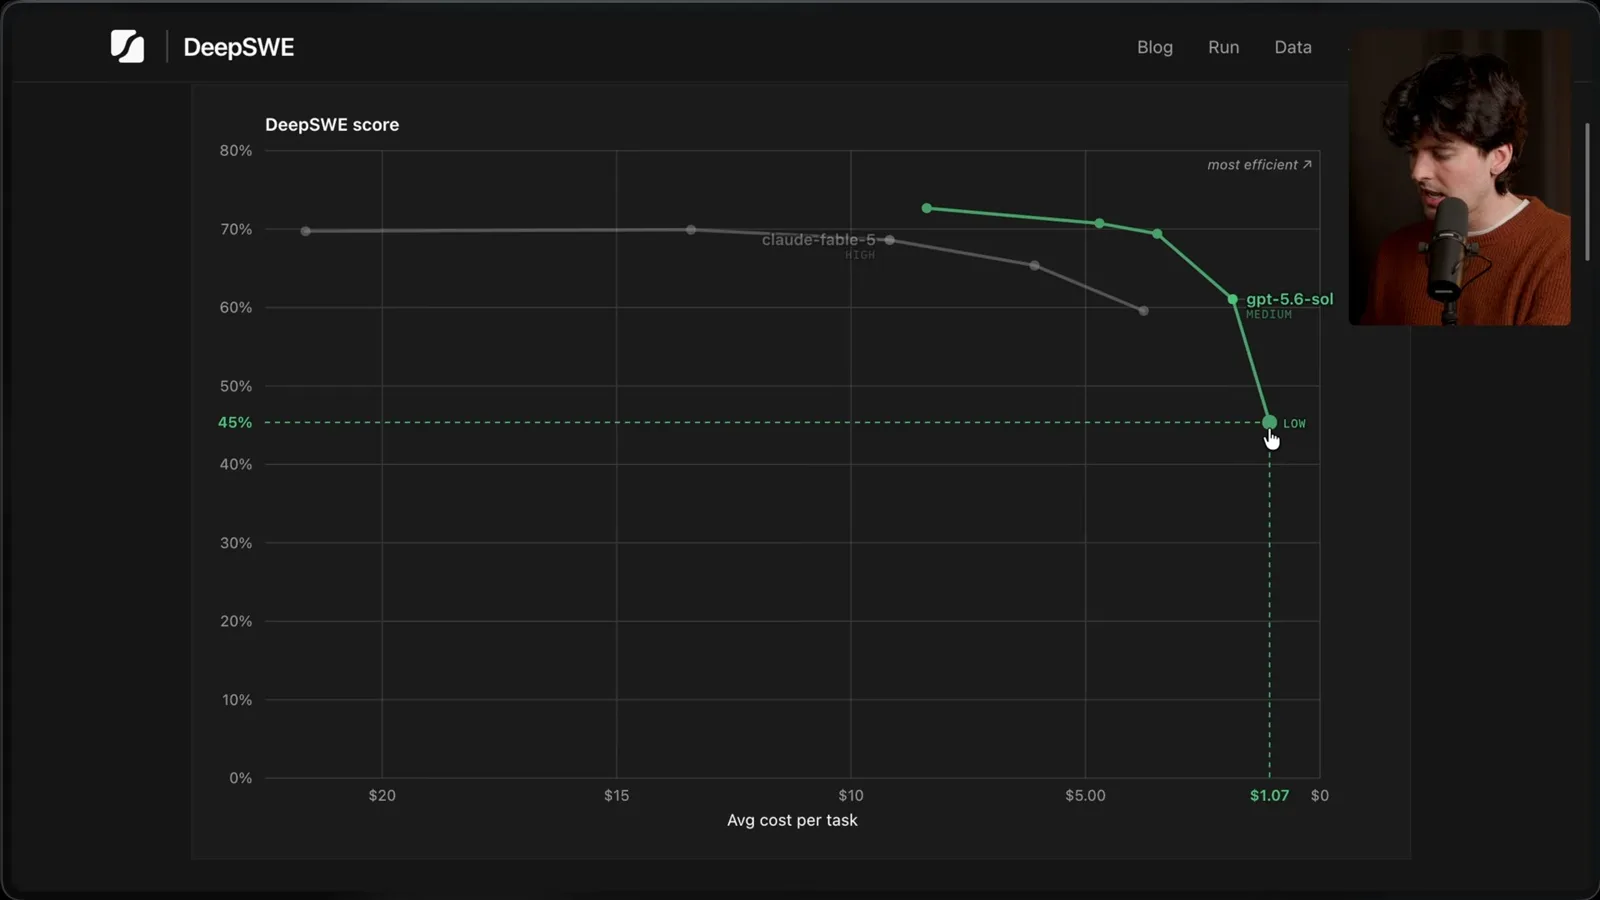
同一图表显示,extra-high 约为 71%、4.70 美元,max 约为 73%、8.39 美元。对我的工作而言,我更喜欢 high,因为后续提升成本更高。但换一个基准或失败代价很高的任务,结论可能不同。
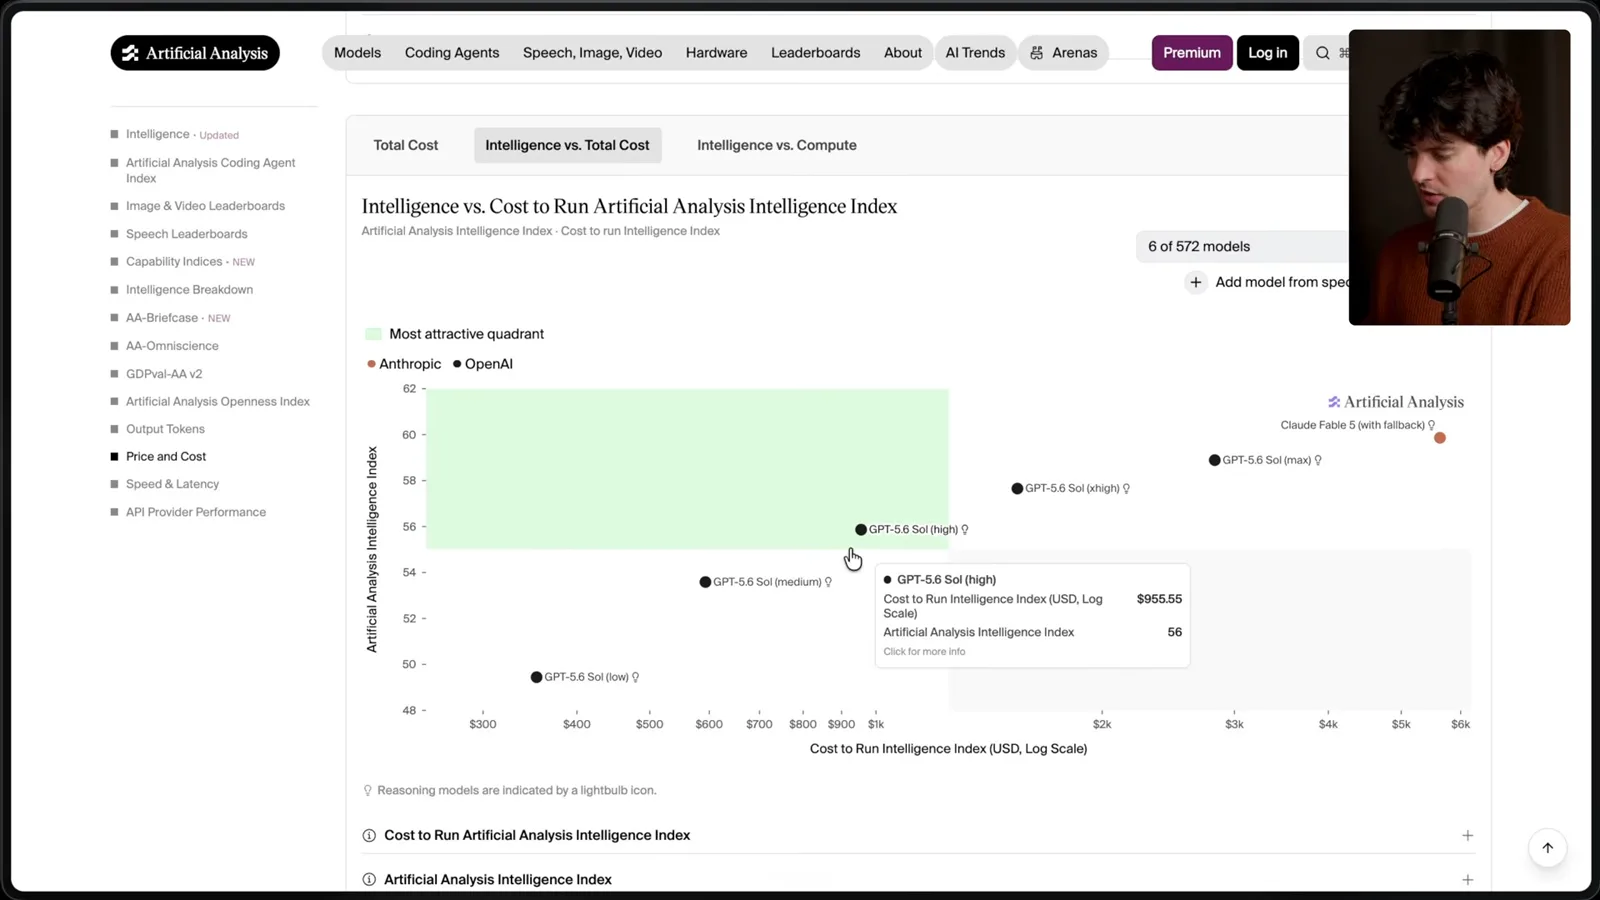
CursorBench 展示了不同的得分和成本差距,Artificial Analysis 也提供了另一种比较。这些测量不能决定某个具体代码库需要什么;除了成本,还应看质量、尝试次数和审查工作量。
子代理与模型选择
他讨论委派、配置和模型选择。
我对所测试的 Codex 子代理实现持谨慎态度。Sol 有时会在我不会选择委派的地方启动子代理,增加工作和用量。子代理也可能很有用,所以我建议先观察实际行为,再决定是否修改配置。
如果不必要的委派仍然是问题,我介绍了一种个人指令:只在明确要求时使用子代理。这只是表达偏好的一种方式,不是每个项目都必须采用的规则。配置方式和服务商能力也可能变化。
我还讨论了模型选择,并说在许多任务上,我个人更喜欢低或中强度的 Sol,而不是 Terra。视频后面还有一份分析通过成本与表现图比较 Terra、Luna 和 Sol。我的偏好和图表都不能证明哪个模型最适合你的工作负载。
停止点与实验
提示词边界、上下文设置以及录制时的后续产品更新构成了最后的建议。
我觉得最有用的提示词改动是明确代理何时停止。例如,让它先写计划并暂停等待反馈;或者让它完成更长的实现与审查任务,同时指定清楚的交接点。停止点可以早也可以晚,应符合需要的监督程度。
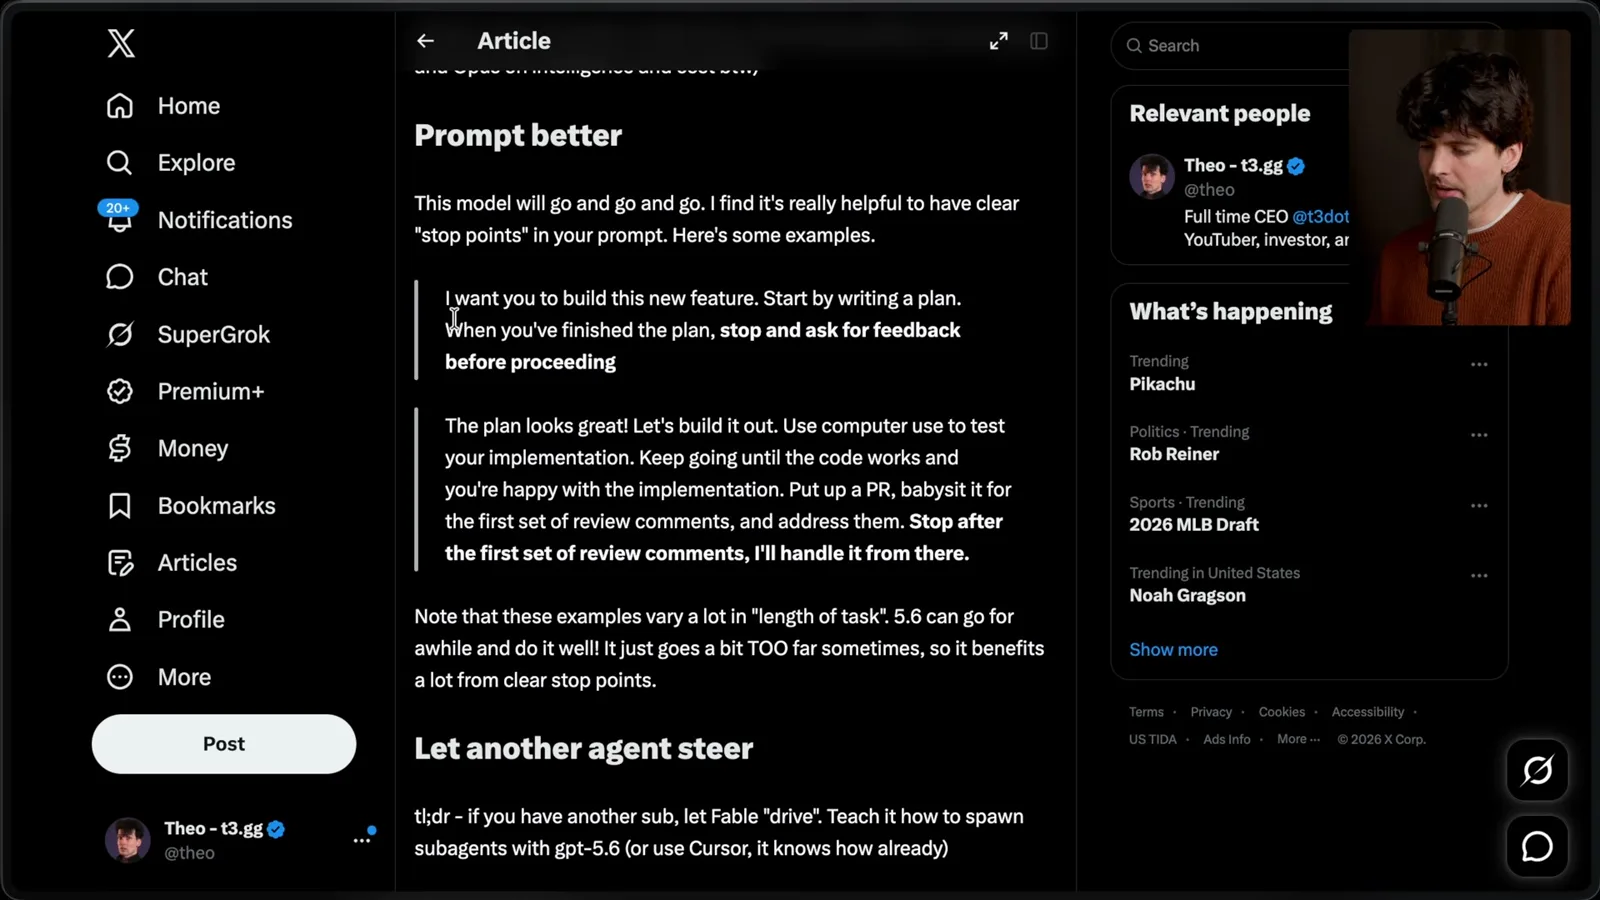
清楚的边界既能给模型工作空间,也不必让它自行猜测应该继续多久。我建议试验检查点之间的距离,并在任务变长时检查输出质量是否仍然可接受。
另一种选择是让一个代理指导另一个,前提是工具和访问方式获得授权。我尝试过不同运行框架,但重点不是照搬我的配置,也不是假定订阅支持所有集成;应查看服务商的当前条款。
应根据自己的工作方式定制提示词和项目指令。尝试不同强度,在行为出乎意料时检查运行记录,再做小幅调整。我的文件和偏好可以作为参考,并不是一套不加修改就适合所有人的方案。
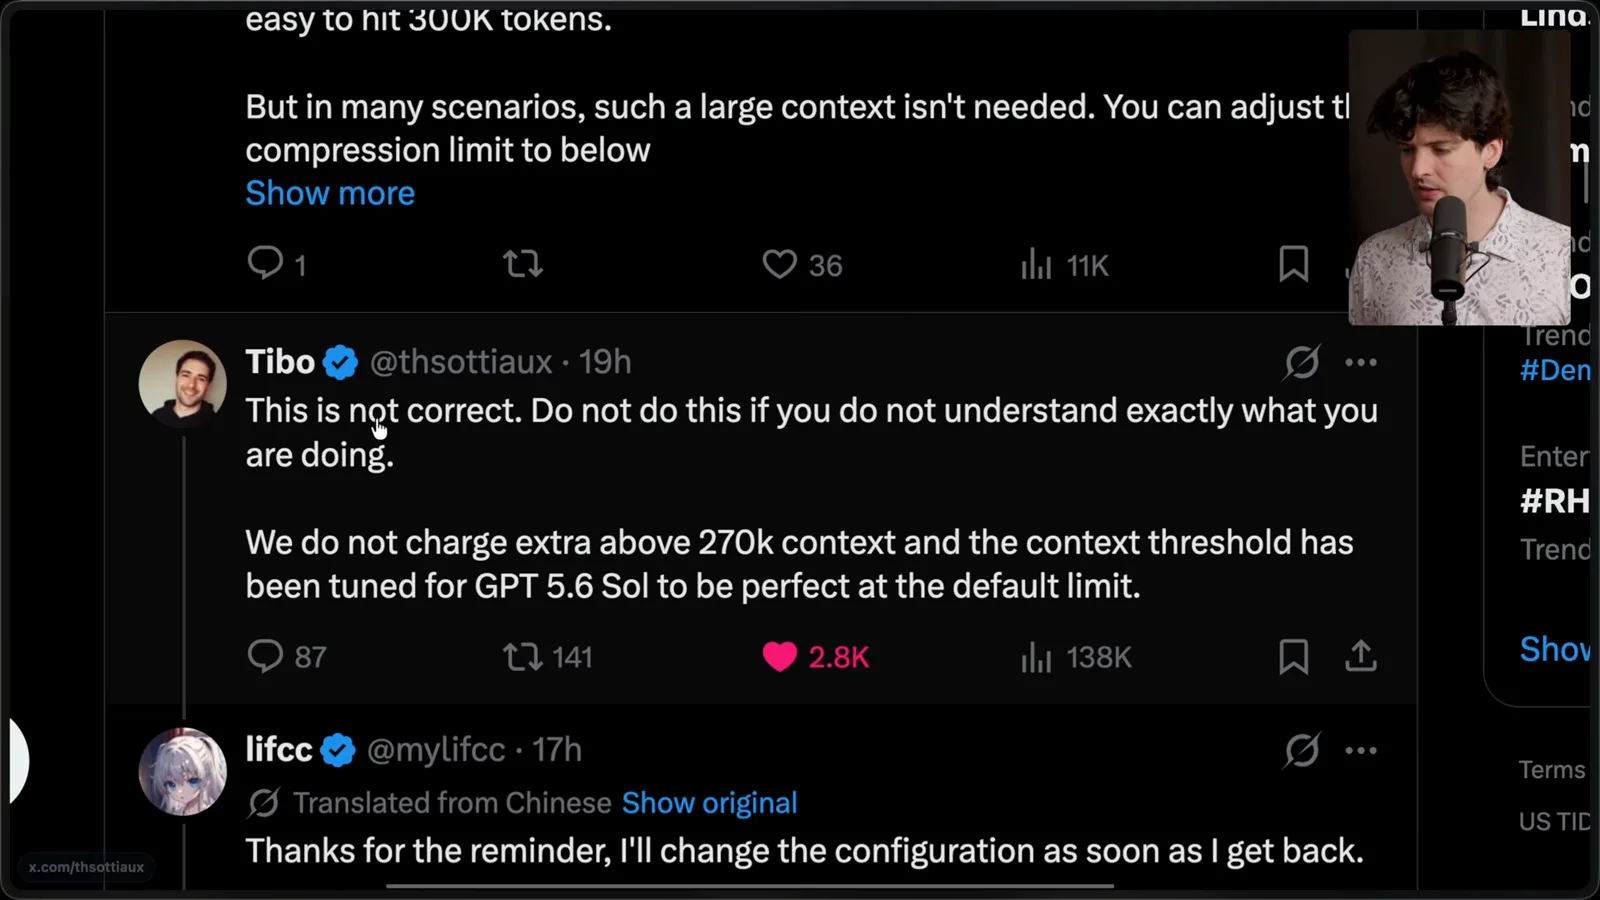
我提醒大家,不要仅凭网上建议就盲目修改上下文窗口或自动压缩设置。在讨论的版本中,一位 OpenAI 代表表示默认值经过调校,并反驳了超过某个上下文阈值会额外收费的说法。这是历史信息;应查看所用工具的当前文档。
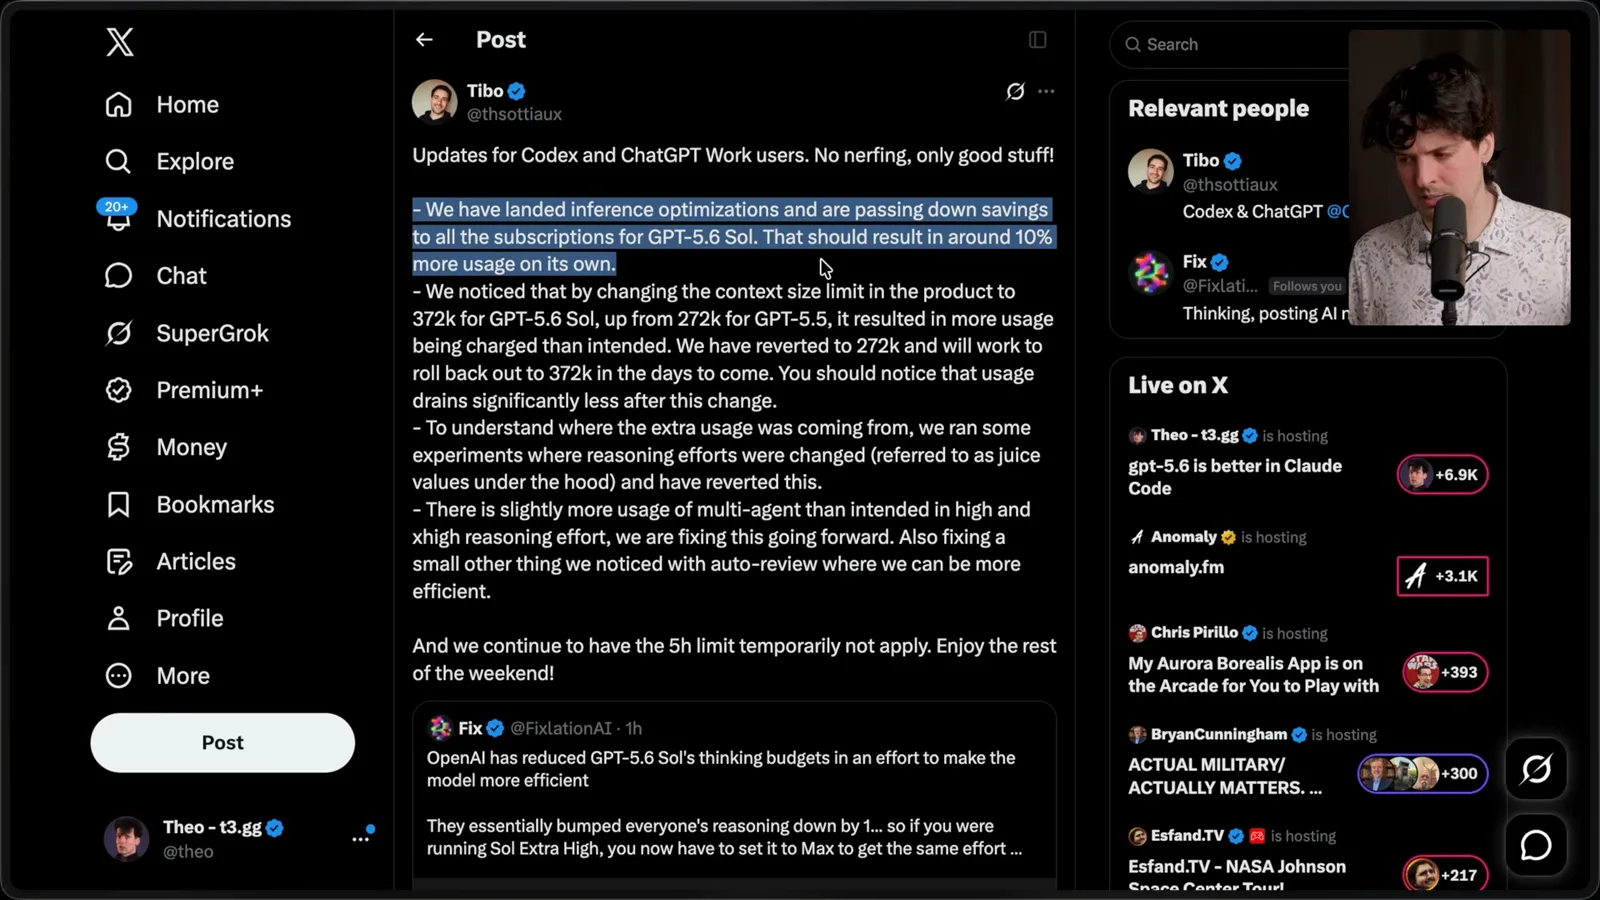
录制期间,另一则更新报告了推理优化,以及改变上下文大小后出现的用量计费问题。服务商称已暂时回退限制,并正在处理超出预期的多代理使用。情况不断变化,更说明应重新核对假设,而不是把视频当作永久配置指南。
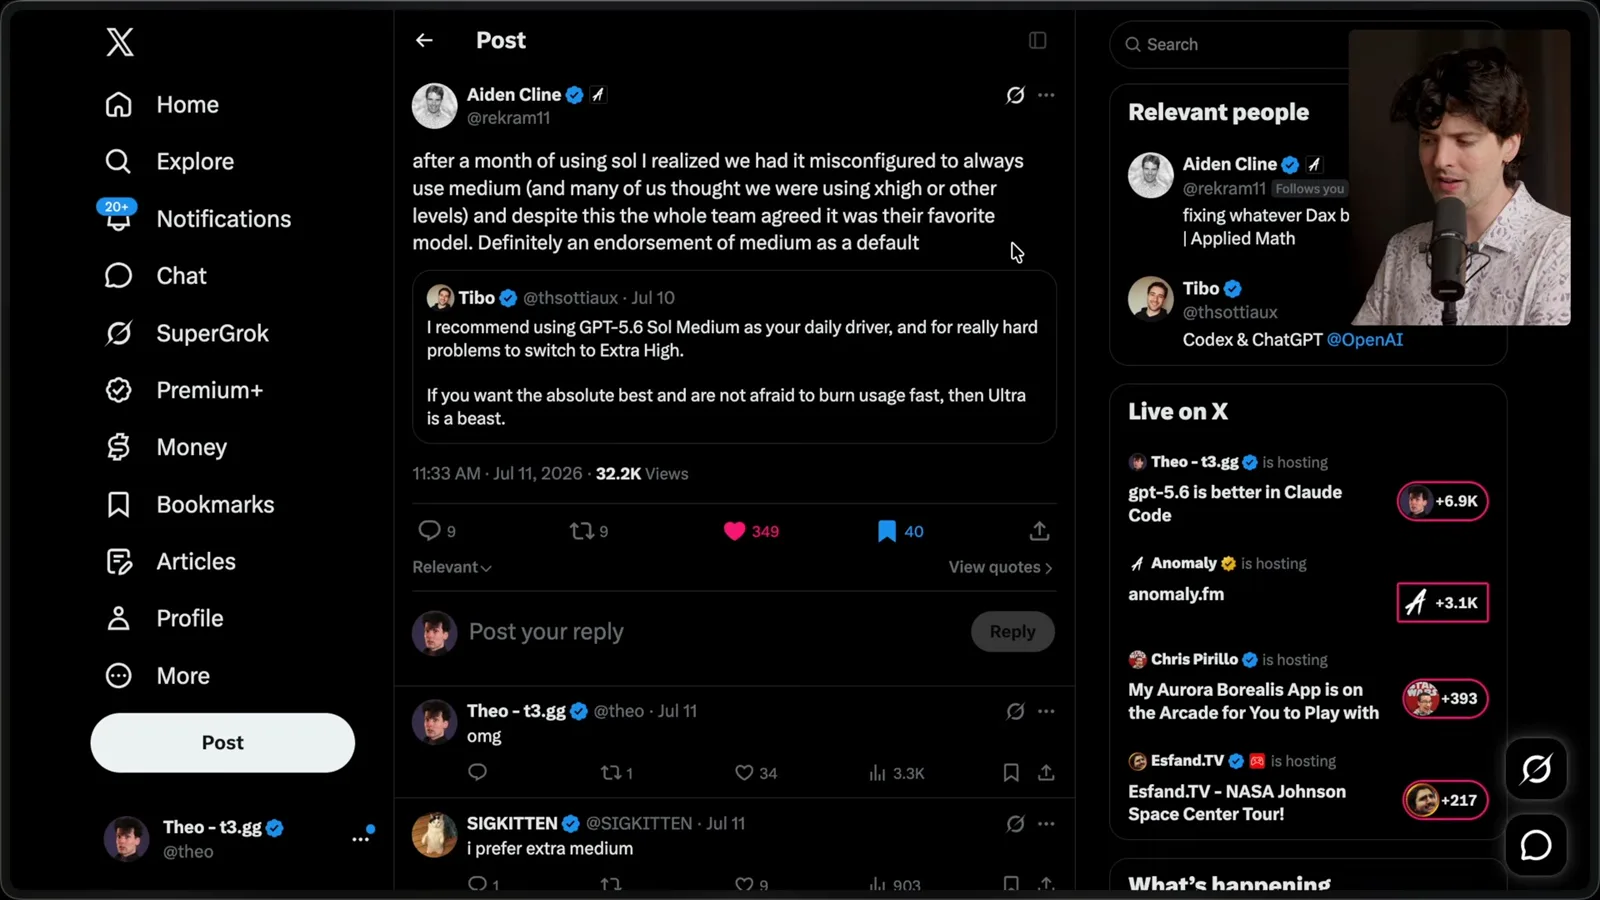
最后,OpenCode 团队报告说,配置错误让他们实际一直使用 medium,虽然他们以为用了更高强度;即便如此,他们仍然喜欢这个模型。我把它看作自己试用 medium 和 high 的一个经验性理由,而不是普遍最优值的证明。
同频道的其他文章
 38:47EN → 简体中文
 Theo - t3․gg· 2026年10月28日Theo 的长时间 Agent 实验:验证、算力与成本Theo Browne · Ping Labs滑板游戏和两个编译器项目展示了反复检查与弹性算力如何支撑 agent 工作,也揭示了循环可能带来的高昂成本。
 36:07EN → 简体中文Theo - t3․gg· 2026年10月27日Theo 谈 Token 成本、编程智能体与 AI 能力的价格Theo Browne · Ping Labs一则关于 Lauren 的 AI 支出估算广泛传播,引出了对缓存计价、基准测试和编程智能体工作方式的讨论。
 30:37EN → 简体中文Theo - t3․gg· 2026年10月26日Theo 的三个技能:用编程智能体审查和交付代码Theo Browne · Ping Labssol-loop、full-send 和 full-stop 如何定义审查、验证以及不同程度的合并权限。
 0:43EN → 简体中文Theo - t3․gg· 2026年10月23日Theo 区分安全漏洞与实际攻击Theo Browne · Ping Labs一段简短讲解:软件漏洞披露和攻击事件为何属于不同类型的安全新闻。
 29:22EN → 简体中文Theo - t3․gg· 2026年10月22日Theo 谈安全漏洞、被盗 API 密钥与 AITheo Browne · Ping Labs从漏洞披露到补丁部署之间的风险窗口,以及被盗推理密钥为何可能有价值的推测。
 31:13EN → 简体中文Theo - t3․gg· 2026年10月20日Theo:更聪明的模型为何能帮助更多人Theo Browne · Ping Labs从游戏修改到编译器实验,Theo 重新思考谁能从更强大的 AI 中受益。