30 秒看懂
语言模型可以为更可能出现的后文分配较短编码,从而帮助压缩文本。Grant Sanderson 展示了算术编码如何利用这些预测,反复缩小数轴上的一个区域,再发送其中的二进制数,让拥有相同模型的接收方还原文本。由此得到的码长与语言模型训练使用的交叉熵直接相关。但公平的压缩评分还必须计入解码器和模型;如果双方同步更新,模型的适应速度也会影响结果。
- 1可预测的段落可能只包含几个比特的意外信息知道美国宪法的开头后,后文可能变得非常容易预测;固定字符编码无法利用这一上下文。
- 2预测器为每条消息分配一个区间根据模型概率反复细分单位区间,就能为每个字符串得到一个区域。接收方使用区域内的数字、消息长度和相同模型,便能还原文本。
- 3同样的 10 比特可以编码更长的可预测单词在图示例子中,“math” 对应的数也落在 “mathematics” 的区域内。这一结果非常幸运,而且没有计入传输长度的成本。
- 4压缩取决于模型概率,而非理想的全知预测编码长度接近预测器给出的概率的 −log₂ 值。模型与实际文本不匹配,会使结果达不到真正的 Shannon 极限。
- 5预训练损失也是压缩成本把实际出现的后续 token 的负对数概率相加,可以得到消息长度;取平均便得到交叉熵。
- 6公平评分要计入解码器和模型不计入模型时,压缩器可以把数据藏在解码程序中。Hutter 奖会计算这部分成本。
- 7压缩器可以一边编码一边学习只要编码器和解码器执行相同的确定性更新,双方的预测器就能适应新数据,无需传输每一次更新。
要点建议
- 当编码器和解码器共享同一个预测器时,算术编码能把下一个 token 的概率转换成无损比特流。
- 越容易预测的后文通常需要越少比特;这里使用的是模型概率,可能与现实不同。
- 在这种构造下,预训练交叉熵对应平均编码成本。
- 比较总体压缩效果时要计入解码器和模型;个别异常短的例子是幸运结果,并不代表新的平均极限。
- 双方执行同步的确定性更新,就能在处理消息时调整预测器。
按章节阅读整理后的全文
为什么可预测性能让文本变短
Shannon 将消息的信息量与其概率联系起来。挑战在于把这一观察变成可运行的编码。
一种算法可以把长段可预测的文本压缩到平均每个字符不到 1 比特。Hutter 奖奖励将 1 GB 维基百科内容无损压缩得最小的方案,评分既计算压缩数据,也计算解码器的大小。我们即将构建的思路是一系列技术的基础,历届获奖方案都用到了它。
可以把压缩看成两个程序:发送方把文本编码成比特,接收方把比特解码成与原文完全相同的副本。要接近压缩极限,我们首先需要理解可压缩程度与消息出现概率的关系。
Claude Shannon 证明,概率为 p 的事件所对应的理想比特数是 −log₂(p)。概率每减半一次,信息量就增加 1 比特。因此,常见消息需要的比特数应当少于罕见消息。
假设我给你美国宪法序言的开头。如果你认出了它,后文可能很容易预测。如果你认为整段后文出现的概率为 50%,它就只包含 1 比特的信息;即使概率为千分之一,也只对应约 10 比特。
如果试图为每个字符分配固定的比特串,这似乎不可能做到。ASCII 编码需要超过 2,500 比特,图中展示的 Huffman 编码约需 1,500 比特。即使用常见的字符片段编码,似乎也很难把整段文字装进寥寥几个比特。
问题在于上下文。单独看起来令人意外的字符,在某个前缀之后可能几乎必然出现。语言模型恰好提供了缺失的部分:给定上下文,它会预测下一个可能 token 的概率分布。
假设发送方和接收方拥有相同的预测模型。我们可以把这个模型接入编码器和解码器:预测与实际文本越吻合,压缩效果就越好。基本思路是用零到一之间一个精心选出的实数来表示消息。
把预测的字母变成嵌套区间
语言模型根据预测划分数轴。最终区间内的一个数就能确定一条消息。
为了方便图示,想象一个每次预测 26 个小写字母之一的模型。把它的初始概率分布画成并排的条带,填满零到一的区间。每个字母占据一段区域,其宽度等于该字母的概率。
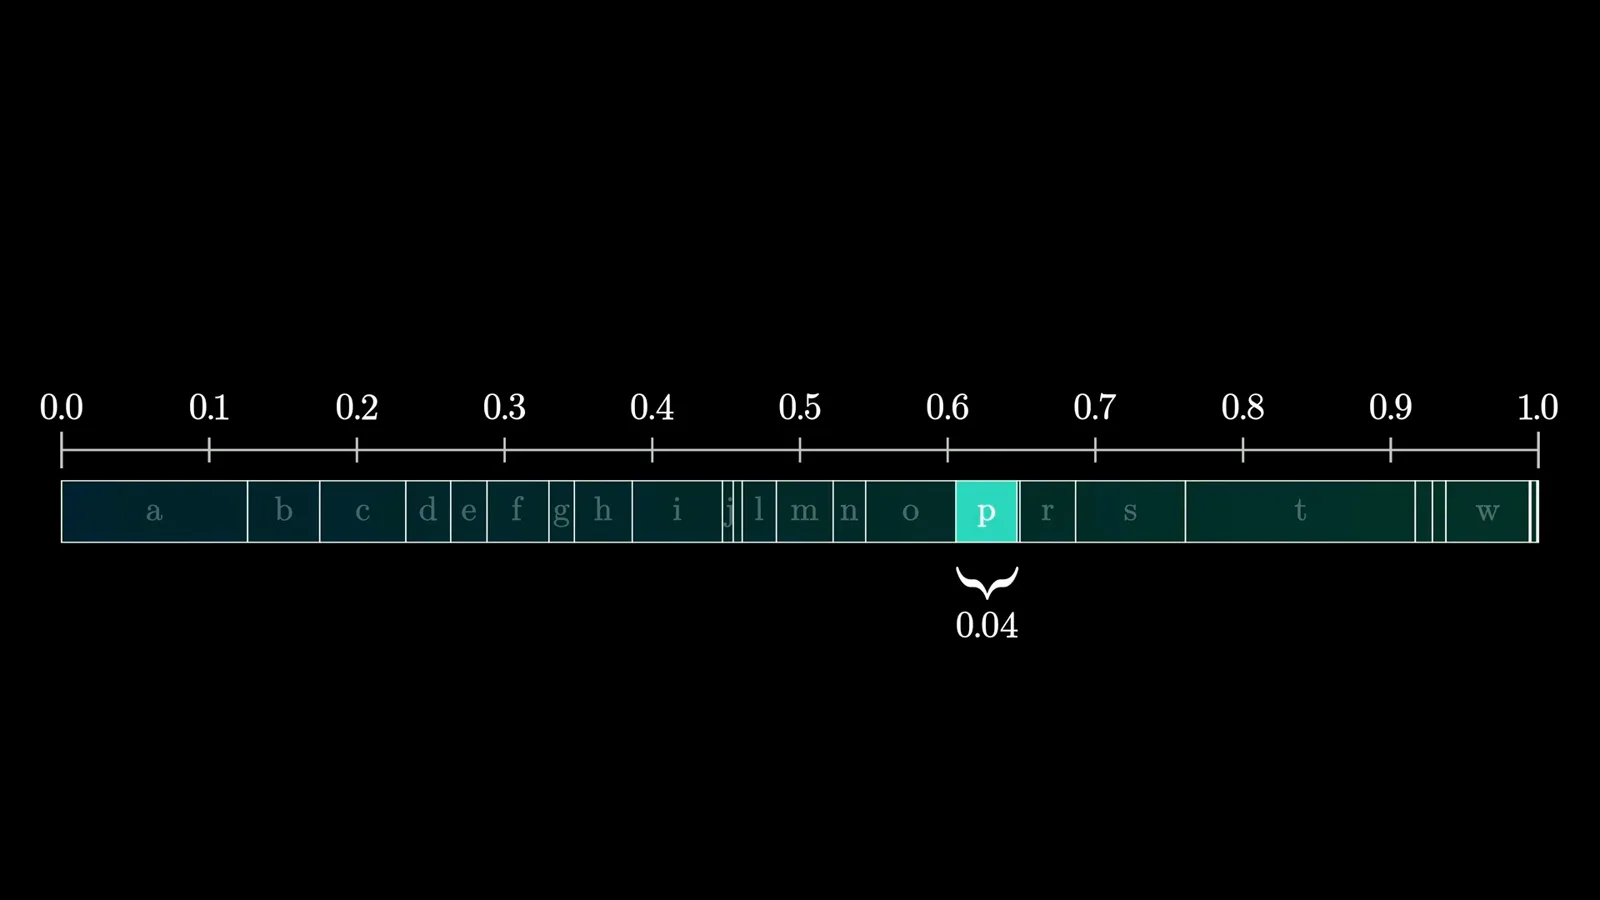
常见的开头字母占据较宽的区间,不太可能出现的字母占据较窄的区间。要编码更长的字符串,就按照模型对下一个字母的预测,继续细分选中的首字母区间,然后在选出的子区间内重复这一过程。
以单词 “math” 为例。选中 m 的区间后,询问模型 m 后面会出现什么。ma 区间的宽度等于 m 的概率乘以 m 后出现 a 的条件概率,这就是通常的概率链式法则。继续细分,就能得到 mat 和 math 的区间。
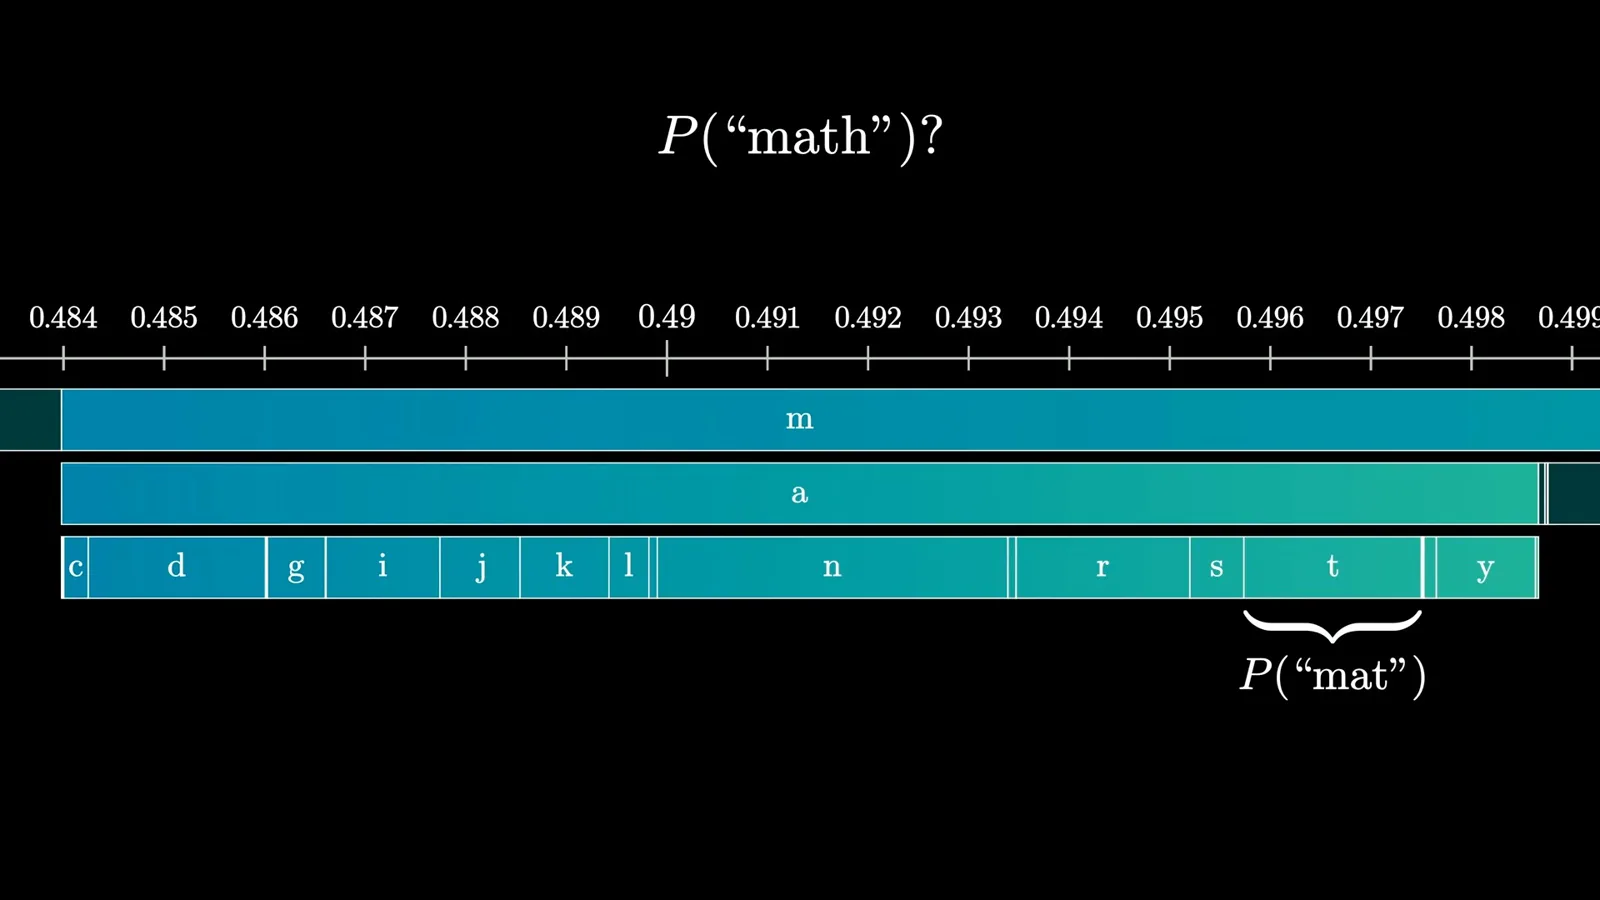
只要接收方知道发送的是四个字符,并拥有相同模型,最终区间内的任何一个数都能确定这个单词。每增加一个字符,就选中一个更小的嵌套区域;原则上,这张图可以继续表示任意长度的字符串。
用相同模型解码数字
接收方重复按照概率细分区间,还原每个字符。二进制精度决定这个数字需要多少比特。
解码则反过来进行。接收方先用模型获得空上下文的分布,看收到的数字落在哪个首字母区间,再把该字母作为上下文进行下一次预测。不断重复,直到达到指定长度;另一种选择是使用特殊的消息结束符。
如果在区间内均匀随机选数并解码,得到的字符串往往看起来像合理文本。概率较高的文本占据数轴上更大的一部分。这也是理解语言模型如何生成文本的一种图示。
为了实际传输一个数,需要用二进制表示。每个比特都把可能的区间再分成两半:第一个选定二分之一,第二个选定四分之一,第三个选定八分之一。有限个比特对应二进制网格上的一个点,它必须落在消息的目标区域内。
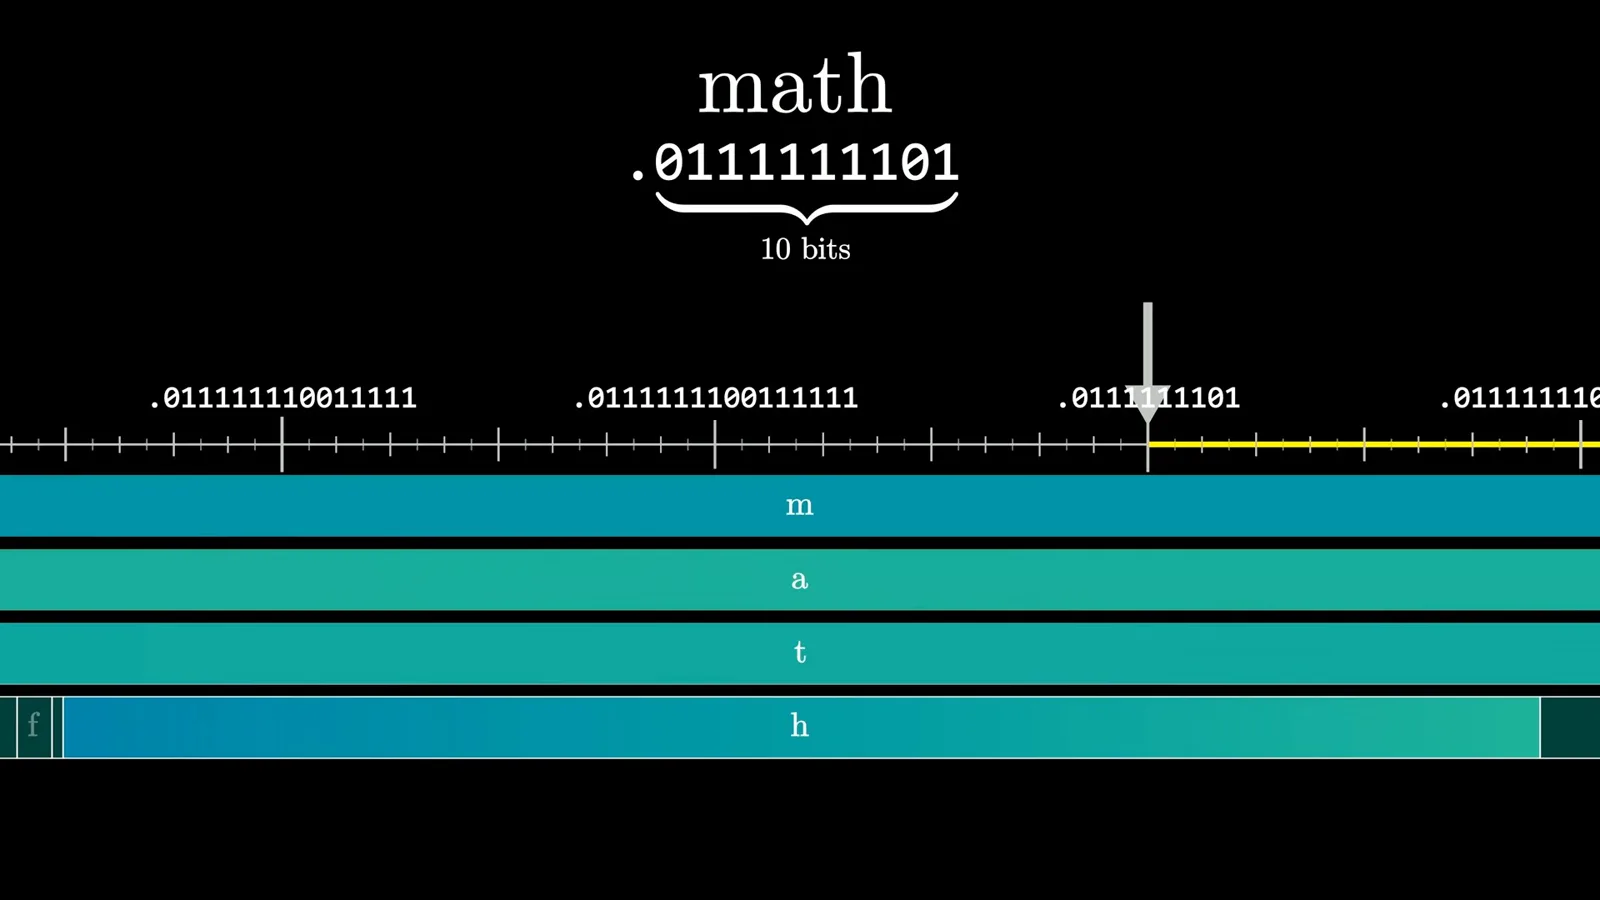
图示例子中,一个 10 比特的数落在 “math” 的区间内,相邻的两个 9 比特数都没有落进去。这相当于每个字符 2.5 比特;但如果后续内容更长且可预测,就可以继续使用同一个数。
为什么幸运的 10 比特单词没有打破 Shannon 极限
目标区间和二进制网格解释了概率与码长之间的关系。消息长度和模型准确性也很重要。
模型高度预期 “math” 之后的许多字母,因此继续拼出 “mathematics” 时,区间几乎没有缩小。同样的 10 比特恰好能表示全部 11 个字母,平均每个字符约 0.91 比特,但这还没有计入单独传输的消息长度。
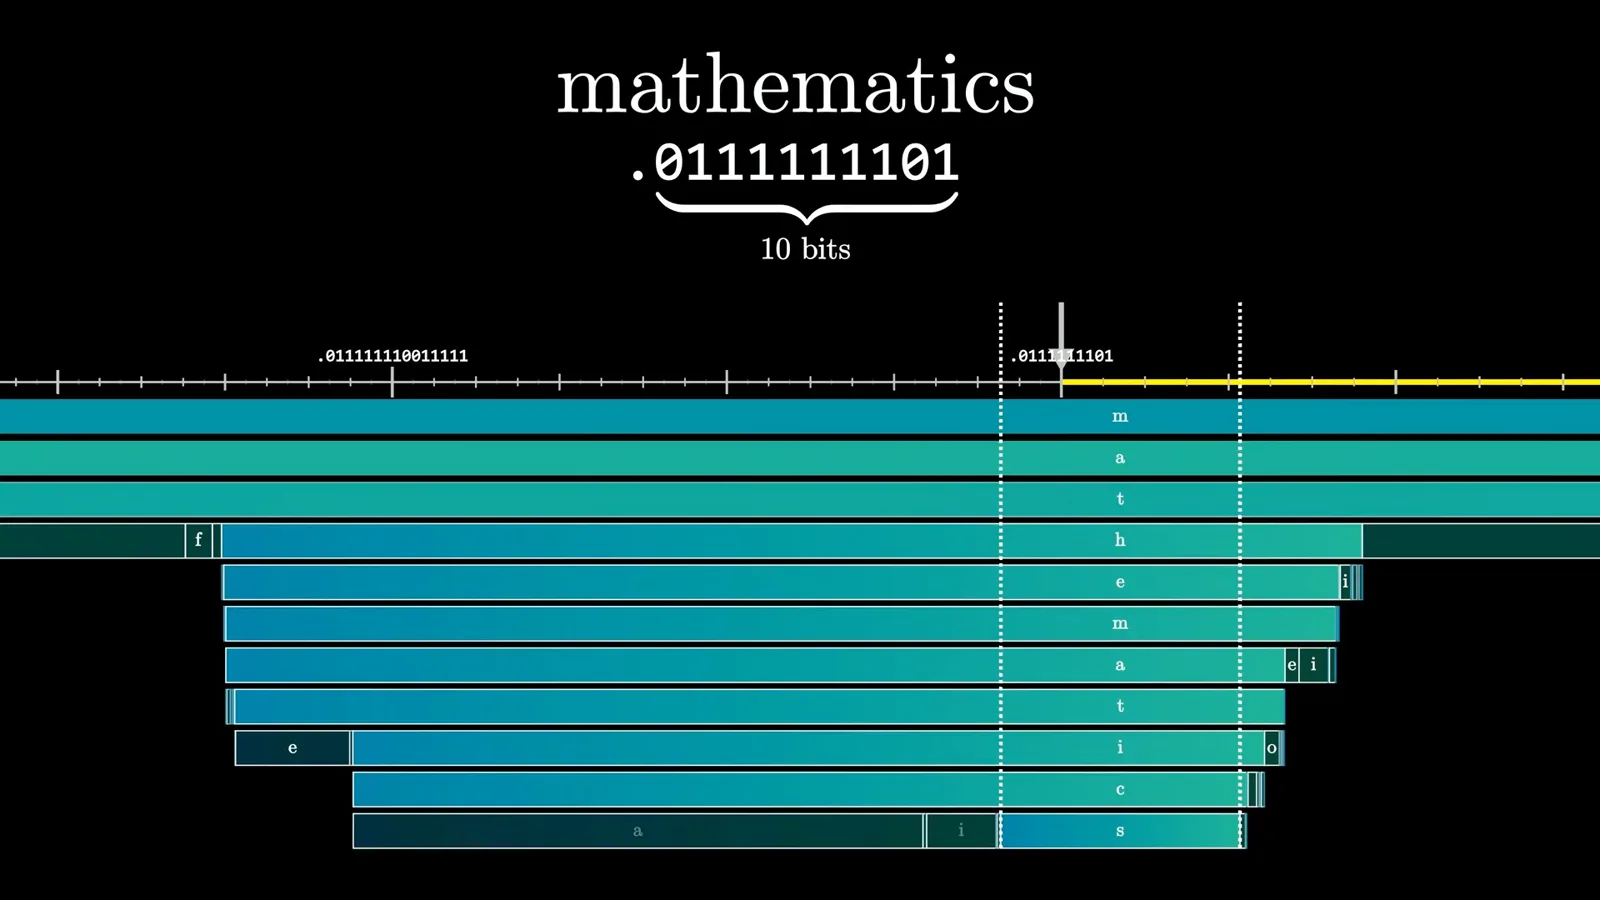
这个结果有运气成分:“mathematics” 区间的宽度约为 2⁻¹⁸,但一个 10 比特的网格点恰好落在其中。一般而言,最多用 k 个比特表示的二进制网格点之间相隔 2⁻ᵏ。
对于宽度为 p 的目标区间,只要选择不小于 −log₂(p) 向上取整的 k,就能保证区间内有一个可表示的点,而不必依赖运气。这就是模型赋予的概率为何大致对应这样的比特数。
编码后的数字并不是全部:接收方还需要消息长度或结束标记。对于长消息,固定大小的长度头相对于数据本身可能很小。个别字符串可以用少于其信息量的比特表示,但 Shannon 极限讨论的是平均值。
还有一个限定条件:这里的 p 来自模型,不一定等于消息的真实分布。只有模型概率与文本的实际统计特征非常接近时,压缩结果才会接近理论极限。
把语言模型训练看作压缩
各 token 的负对数概率可以相加,其平均值就是预训练要最小化的交叉熵。
将模型对整个字符串给出的概率展开,它是每一次后续 token 概率的乘积。取负对数后,乘积就变成求和:每次预测都贡献一项成本;模型给实际出现的 token 的概率越低,成本越高,反之越低。
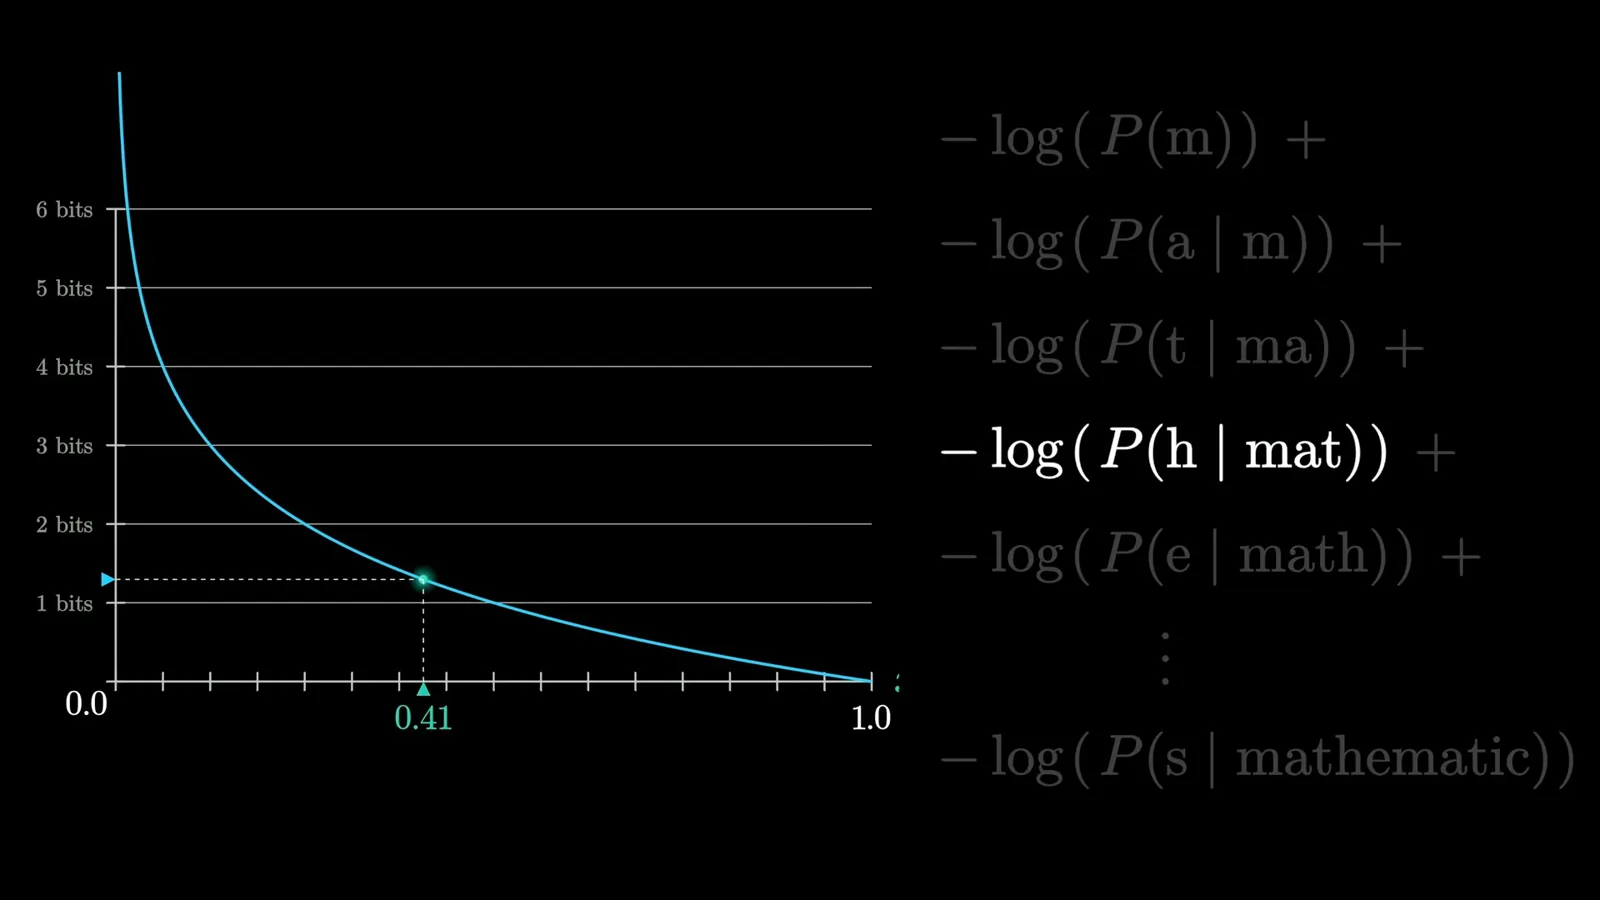
语言模型预训练最小化的就是这一成本的平均值,称为交叉熵。我们可以把同一个目标描述为构建更好的下一个 token 预测器;通过这种编码方式,也可以把它描述为减少压缩训练文本所需的比特数。
比较两个预测器,让算术编码变得实用
更大的预测器把示例段落压缩得更紧。实用的算术编码通过重新缩放区间,避免无限增长的精度要求。
在示例中,一个拥有 370 万参数的小型 NanoGPT 模型用 254 比特编码一句关于欧几里得《几何原本》的话,平均每个字符约 2 比特。一个更大的、拥有 5 亿参数的 Qwen 模型给可预测的结尾赋予高得多的概率,将整个例子压缩到每个字符不到 1 比特。
对于美国宪法序言,Qwen 示例用约 35 比特表示开头,其余部分只增加约 10 比特。开头建立上下文后,几乎所有概率都集中在预期的后文上;拼写和大小写仍带来了一些需要区分的选择。
一个合理的质疑是:如果模型事实上记住了著名段落,它就把信息存在了别处。我们稍后会回到模型本身的成本。另一个实际问题是,简单地不断放大小区间,需要越来越高的数值精度。
这种区间方法的构想至少可以追溯到 Peter Elias 1960 年的工作。Jorma Rissanen 和 Richard Pascoe 在 1976 年各自独立开发出实用的算术编码。实现时反复重新缩放工作区间,就能保留从预测到压缩的思路,同时避免要求无限增长的精度。
算术编码提供了一种近乎理想的方法,能把预测器变成压缩器;Hutter 奖的进步来自更好的预测器。Yarik Duda 的非对称数制提供了另一条路径:它使用不断增长的整数及其他技巧,实现快速编码。
压缩能否说明智能
预测、紧凑模型和快速适应都与压缩有关。这一拟议定义仍比人们通常所说的智能更狭窄。
“压缩就是智能”这一标题应当被看作一个拟议的数学定义,而不是对人们所说智能的一切含义作出的定论。一个有用的定义可以舍去人类概念中的细微差别,同时统一看似互不相关的现象。
首先,预测与压缩紧密相连。算术编码把预测器变成压缩器。反过来,我们可以比较一段文字在加入某个候选续文前后的压缩长度;如果增加了 δ 比特,就意味着该续文的概率大约为 2⁻ᵟ。
这种双向关系表明,压缩可能成为预测能力的一种替代指标。Sanderson 将其与神经科学中的预测加工理论联系起来:这一理论认为,大脑形成预测,并向上传递预测与感官输入之间的差异。
单靠预测仍遗漏了我理解中的另一部分:用少量原则解释许多结果。如果两个模型的预测能力相同,较小的模型意味着它可能采用了更紧凑的表示,而不是存储同样庞大的细节。
两个预测能力相同的模型会把同一数据流压缩到相近大小,但公平比较必须计入解码器及其模型。否则,可以把维基百科的副本藏在解码器中,让传输的数据小到任意程度。Hutter 奖同时计算这两部分。
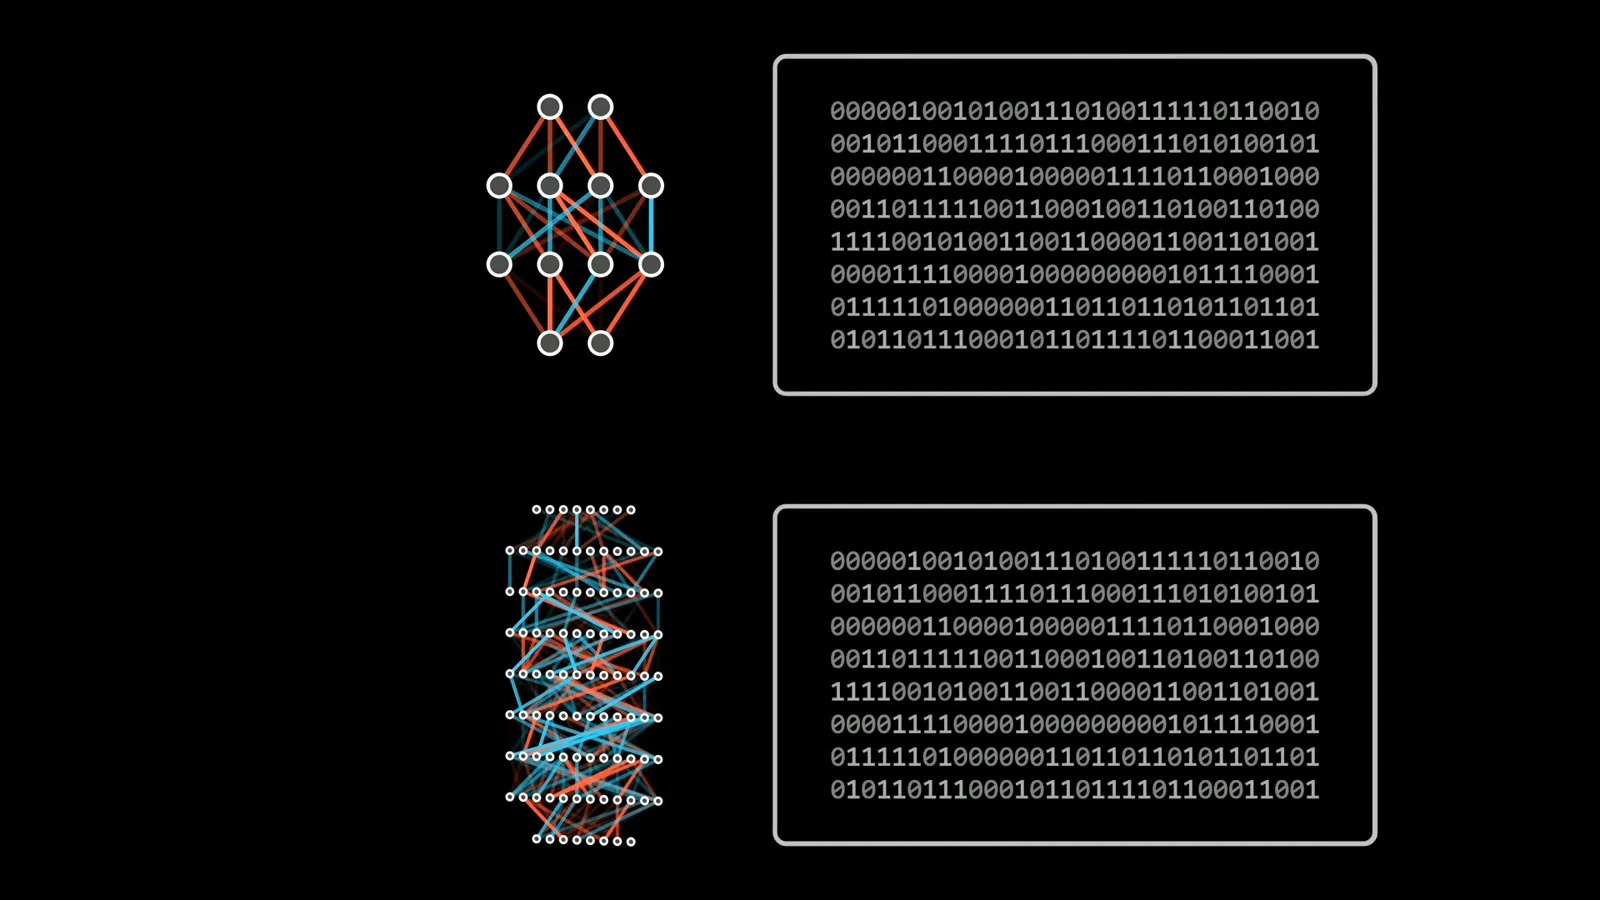
这回应了大模型似乎记住宪法的疑问:如果接收方需要模型参数才能解码,这些参数就是成本的一部分。预测能力相同时,较小的模型能实现更好的总体压缩。
第三个方面是系统学习得有多快。固定模型的最终压缩分数并不能直接说明训练花了多久。但一个在维基百科上训练的模型,可以在压缩另一类材料——例如莎士比亚作品——时进行调整。
编码器可以在看到每个 token 时更新模型;解码器在重建 token 的过程中执行完全相同的确定性更新。双方的预测因此保持同步,能快速适应新材料的模型就可能改善最终压缩效果。
双方甚至可以从以相同方式可重复生成的随机模型开始,省去传输初始训练参数。在这种自适应设置下,分数不仅取决于静态预测能力,也取决于模型从所处理数据中学习的速度。
回顾整个三部曲:Shannon 对英语可压缩程度的估计需要人类预测;现代 AI 训练使用了为研究压缩而发展的数学工具;优秀的实用压缩器结合了预测、紧凑模型,有时还包括快速适应。压缩并不等同于人们所说智能的全部含义,但它涵盖的内容比我最初预想的更多。
同频道的其他文章
 40:44EN → 简体中文
 3Blue1Brown· 2026年10月16日Grant Sanderson:现在是投身数学的最好时机Grant Sanderson, Constantin Kogler · 3Blue1Brown学生担心 AI 已经解决了数学。Grant Sanderson 却认为恰恰相反:即使机器证明定理的能力超过人类,数学这套制度依然有价值,而新人正迎来一个难得的机会,可以参与重塑它。
 51:55EN → 简体中文3Blue1Brown· 2026年9月18日AI 解不出的最后一道 IMO 题Grant Sanderson · 3Blue1BrownGrant Sanderson 带你走一遍 2025 年 IMO 第 6 题——前沿模型没做出来的铺砖谜题——以及要证明一种构造最优,需要怎样的视觉耐心。
 0:55EN → 简体中文3Blue1Brown· 2026年7月24日64 块方糖谜题:六组相等距离一个 4×4×4 的方糖块有三种颜色;证明总能找到六对同色方糖,且每对距离相等。
 33:51EN → 简体中文3Blue1Brown· 2026年7月16日交叉熵连接了什么:压缩、语言模型与 KL 散度Grant Sanderson · 3Blue1BrownGrant Sanderson 从码长推导交叉熵,并用它解释下一个 token 训练和模型蒸馏。
 2:25EN → 简体中文3Blue1Brown· 2026年6月12日香农如何测量英语的信息熵一场猜字母游戏帮助克劳德·香农估算英语文本的信息量,也揭示了预测与压缩之间的联系。
 1:02EN → 简体中文3Blue1Brown· 2026年6月10日月球机器人与最优二进制编码谜题四个方向出现的频率不同,每条指令最少需要多少比特?