30 秒看懂
Theo Browne 讨论 Codex 订阅用量计算方式的变化,并比较自己使用 Codex 和 Claude 的工作流。他认为,更便宜的模型即使让按 API 费率估算的额度价值降低,仍可能支持大量工作;Astra Ultrafast 则可能很快消耗额度。 他对利润率和定价动机的解释属于假设。用量与基准数字只适用于他的测试,不应视为有保证的订阅限额。
- 1成本有不同含义订阅价格、API 等价价值和供应商的实际边际成本是不同的量。
- 2一次观察到的用量Theo 的报告估算,账户显示 100% 之前的 API 用量价值为 573.86 美元;模型组合不同且请求仍获允许,限制了结论范围。
- 3每项完成任务的成本一项 63 个任务的基准比较在特定测试配置下显示,分数相近的模型价格差距很大。
- 4Ultrafast 可能很快消耗额度视频展示了高得多的 Astra Ultrafast 价格,以及根据小样本推算的 500 美元订阅额度。
- 5根据工作流选择Theo 在自己的编程工作中更偏好 Claude,并使用 Codex 和 Sol 进行审查及处理其他任务。
要点建议
- 按 API 费率计算的 token 价值是估算,不是现金额度,也不是供应商的实际成本。
- 订阅能支持多少有用任务,取决于模型选择、token 组合和成功率。
- Theo 的混合模型测试在按 API 价格估算的已计价用量为 573.86 美元时显示达到 100%,但没有捕获到硬性拒绝。
- 他的 Ultrafast 每周完整额度估值来自小样本推算,并非完整一周耗尽额度的实测。
- Theo 倾向于用 Opus 完成大部分编程工作,并用 Sol 作为经济的审查搭档。
按章节阅读整理后的全文
订阅发生了什么变化
Theo 把之前的 API 等价估算与最近一次用量测试进行比较,并解释为什么智能体让订阅用量更加密集。
几周前,我估算 200 美元的 Codex 订阅每月最多能提供按 API 价格计约 1.2 万美元的推理用量;在我的比较中,Claude 订阅约为 8,000 美元。这些数字是按 API 费率估算的 token 用量价值,并非订阅者收到的现金,也不是有保证的额度。
这些订阅推出时,重度用户发送的提示词少得多,工具感觉几乎不限量。随着智能体能力提高、运行时间变长,用户消耗的推理量也增加了。我认为各家公司大幅补贴订阅,以便在模型变贵时保持吸引力。
OpenAI 宣布改变 200 美元订阅的用量计算方式。在我最近的一次测试中,账户显示每周额度用尽前,按 API 价格计的用量约为 574 美元;如果每周如此,大约相当于每月 2,500 美元。这只是一次混合模型使用的观察,并不是固定的美元额度。
API 价值与供应商成本
Theo 区分 API 费率和订阅价格,并推测利润率与竞争关系。这些假设不是经过审计的公司数据。
首先要理解,订阅价格与按 API 费率计算的用量价值是不同的量。我的仪表盘显示,多台机器在七天内产生的用量按 API 价格计近 2 万美元。这是根据公开费率计算的估值,不是我实际支付的账单,也不是供应商运行模型的自身成本。
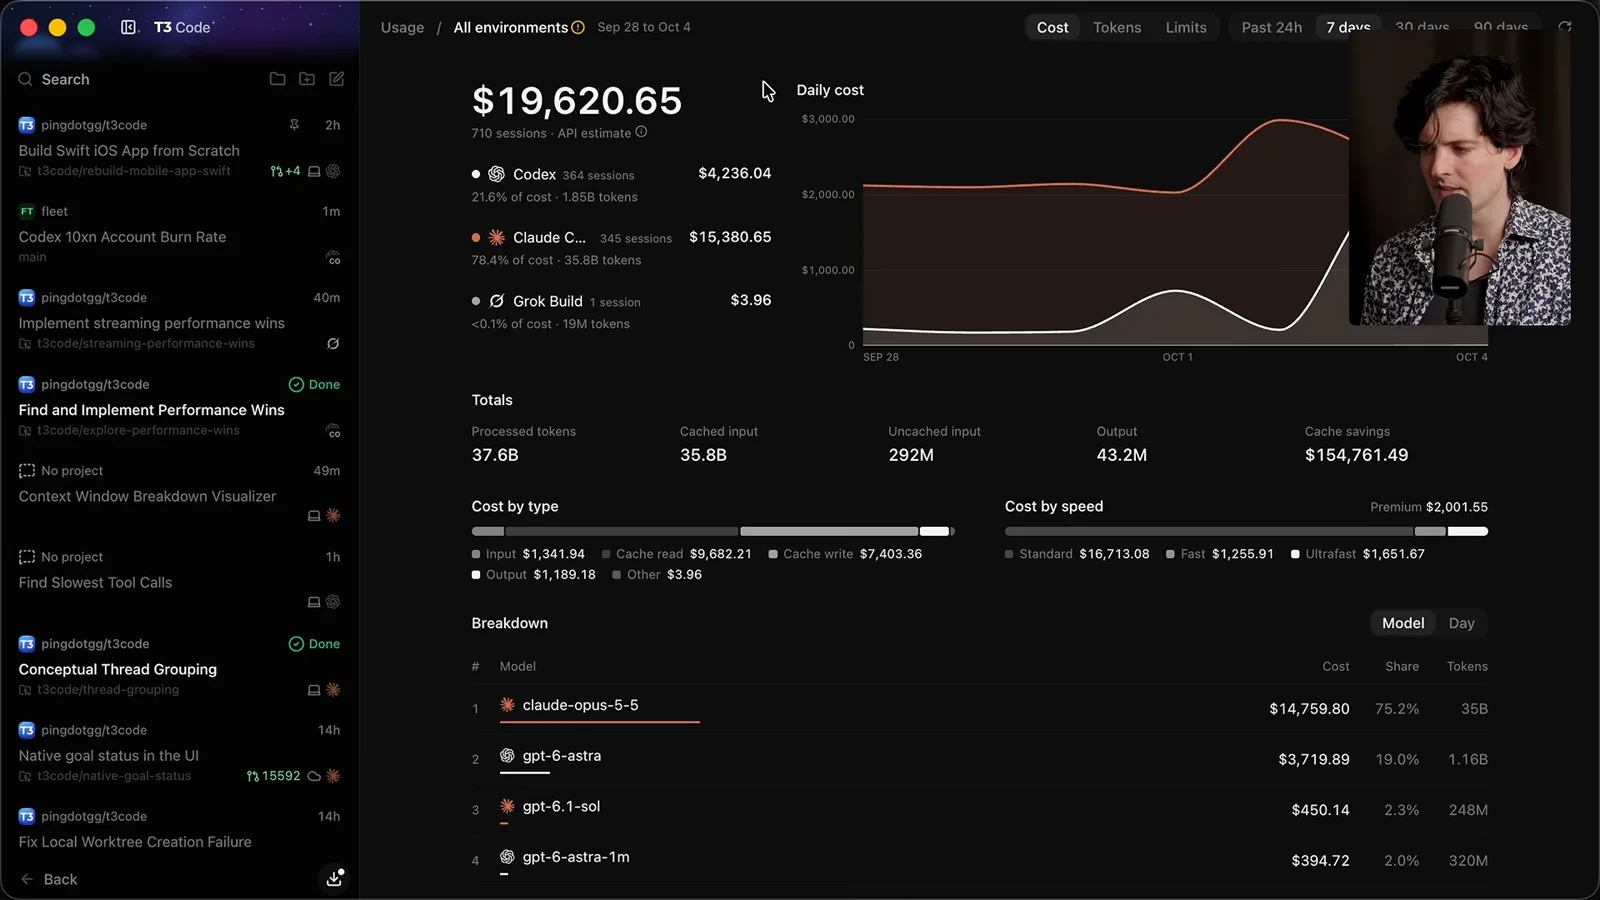
我认为 API 价格过去远高于硬件和能源的边际成本,但我讨论的具体利润率数字只是设想。它们没有计入训练、人员和基础设施等重大成本,而我也没有这些公司的内部单位经济数据。应把它们当作示意,而不是经过审计的利润报表。
这些产品的订阅使用方式也不同。我介绍了通过 Claude Code 及其 agent SDK 使用 Claude,包括 T3 Code 的集成,并与我对 Codex 允许用途的理解进行对比。规则和权益可能变化,因此这些说法只是我当时的理解,不能代替当前条款。
我还提到 Claude 总额度内对 Fable 的单独限制,而我说 Astra 可以使用 Codex 的每周额度。这些订阅细节影响比较,但从个人用量得出的估算不应当作官方或永久的额度公式。
为了说明我对竞争的看法,我把先前提出的 Mythos 每百万输出 token 125 美元价格与后来的 Fable 50 美元价格进行对比。我假设两者的边际成本都是 6.25 美元,以说明利润率如何从 95% 降到 87.5%。成本和公司定价意图都是推测;算术本身无法证明这两点。
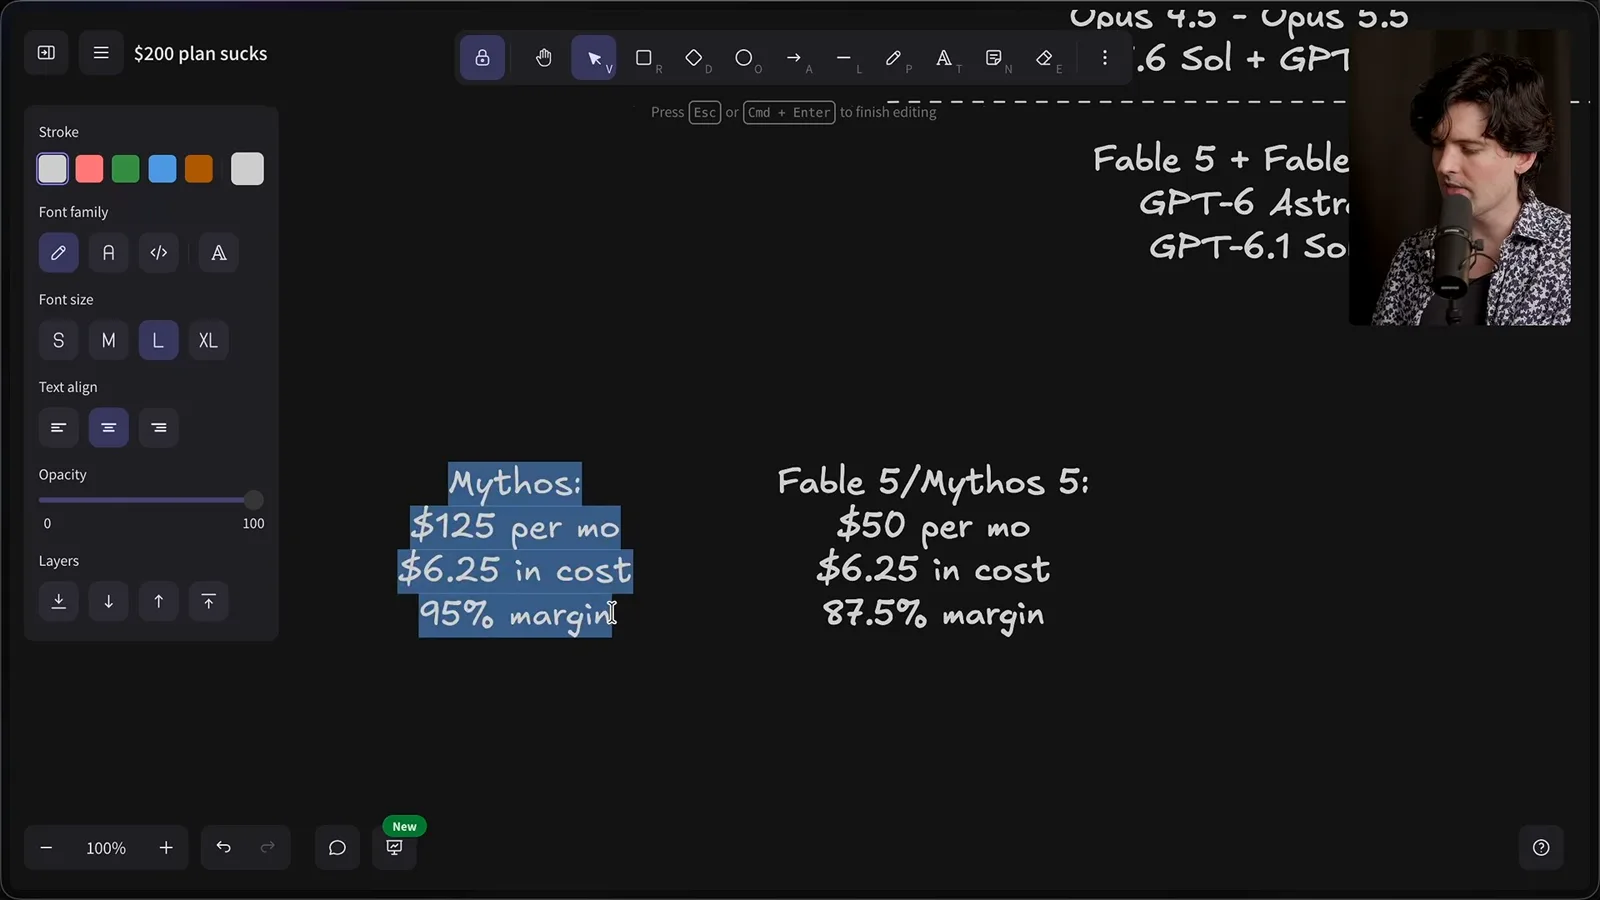
我的观点是,竞争压力可以降低 API 价格,缩小订阅价值与 API 定价之间看起来的差距。我推测 Anthropic 的 Fable 定价影响了 OpenAI 的 Astra 定价,但相似价格本身不能证明竞争对手导致了这一决定。
我对 GPT-6.1 Sol 也做了类似的假设性比较:OpenAI 也许曾考虑过更接近 Opus 的价格,但我讨论的发布价格是每百万输入 token 2 美元、输出 10 美元,缓存读取 0.10 美元。先前预期价格和由此推算的利润率都是我的猜测,不是公司披露的数据。
缓存读取折扣可能显著改变智能体工作的经济性,因为缓存 token 可能占用量的很大一部分。用户能节省多少取决于新输入、缓存读取和输出的实际组合;不了解工作负载,单比标价是不够的。
用量测量与任务效率
他的混合模型日志显示 Astra 和 Sol 的 API 等价价值不同。基准比较说明了任务成本的重要性。
我推测 OpenAI 调整订阅用量计算,部分是为了缩小订阅补贴与更便宜的 API 定价之间的差距,而不是单独限制 Sol。我无法验证其内部动机。我也认为,对于仍大量依赖 Astra 的用户来说,公告的时机并不好。
下面是我自己的数字:这次测试显示,已计价用量按 API 价格约为 573.86 美元,另外还有未定价的审查活动。约 29 小时的运行中,显示用量达到 100%。报告同时指出,显示 100% 时请求仍被允许,所以这里测到的是显示额度耗尽,而不是实际捕获到的硬性拒绝。
Astra 产生了 1,815 次响应、约 76.6 万个输出 token,按 API 价格估值 534.21 美元。Sol 产生了 1,490 次响应、约 62.9 万个输出 token,估值 38.27 美元。两者的输入与缓存组合差别很大,我也提到可能存在配置问题,因此这不是同一任务的受控比较。
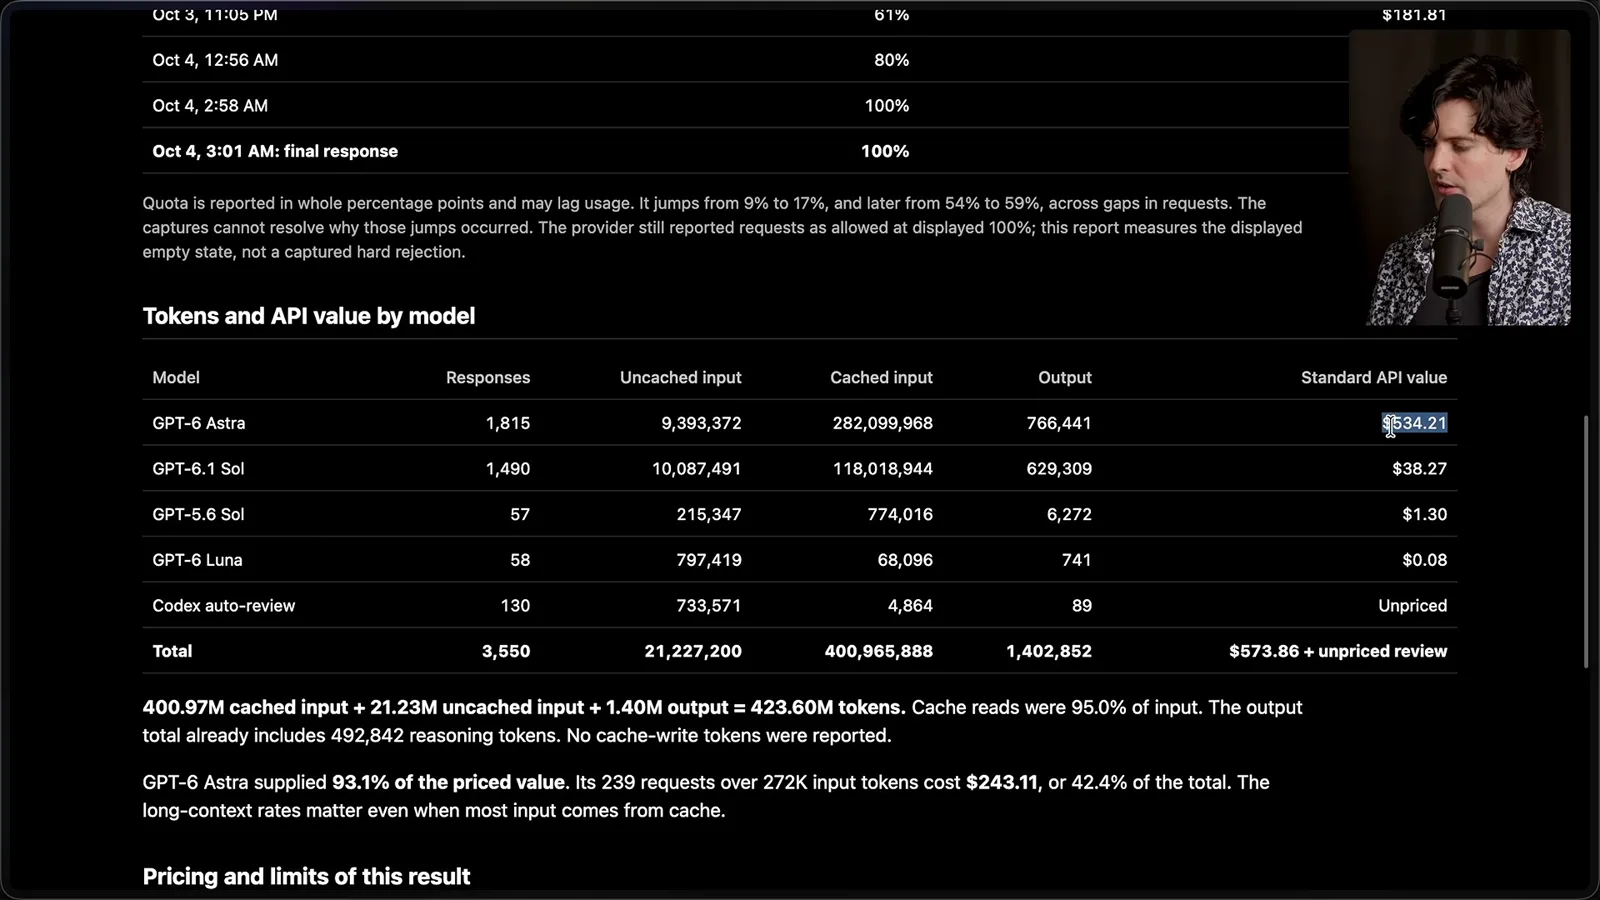
我的理解是,即使按 API 费率计算的美元价值降低,更便宜的 Sol 也能让订阅在许多工作负载中撑得更久。我认为普通用量可能感觉接近不限量,但这只是我的看法,实际限制取决于工作负载和账户条件。
对于交付严肃的代码,我个人更喜欢 Claude 订阅的价值,也大量使用 Opus。同时,我认为按 API 价格看 Sol 的性价比非常高。两者可以同时成立:订阅看起来的折扣与完成有用工作的成本是两种不同的比较。
我构建了一个可视化工具,将基准分数与任务成本对照。在我使用模型原生编程环境运行的 Terminal-Bench 4.0 测试中,Sol 的 xhigh 设置在 63 个任务上得分 58.7%,每项任务成本 0.96 美元;我把它与分数相近、每项任务成本 13.11 美元的 Opus 结果进行比较。单一基准和一种运行配置不能决定哪个模型适合所有工作。
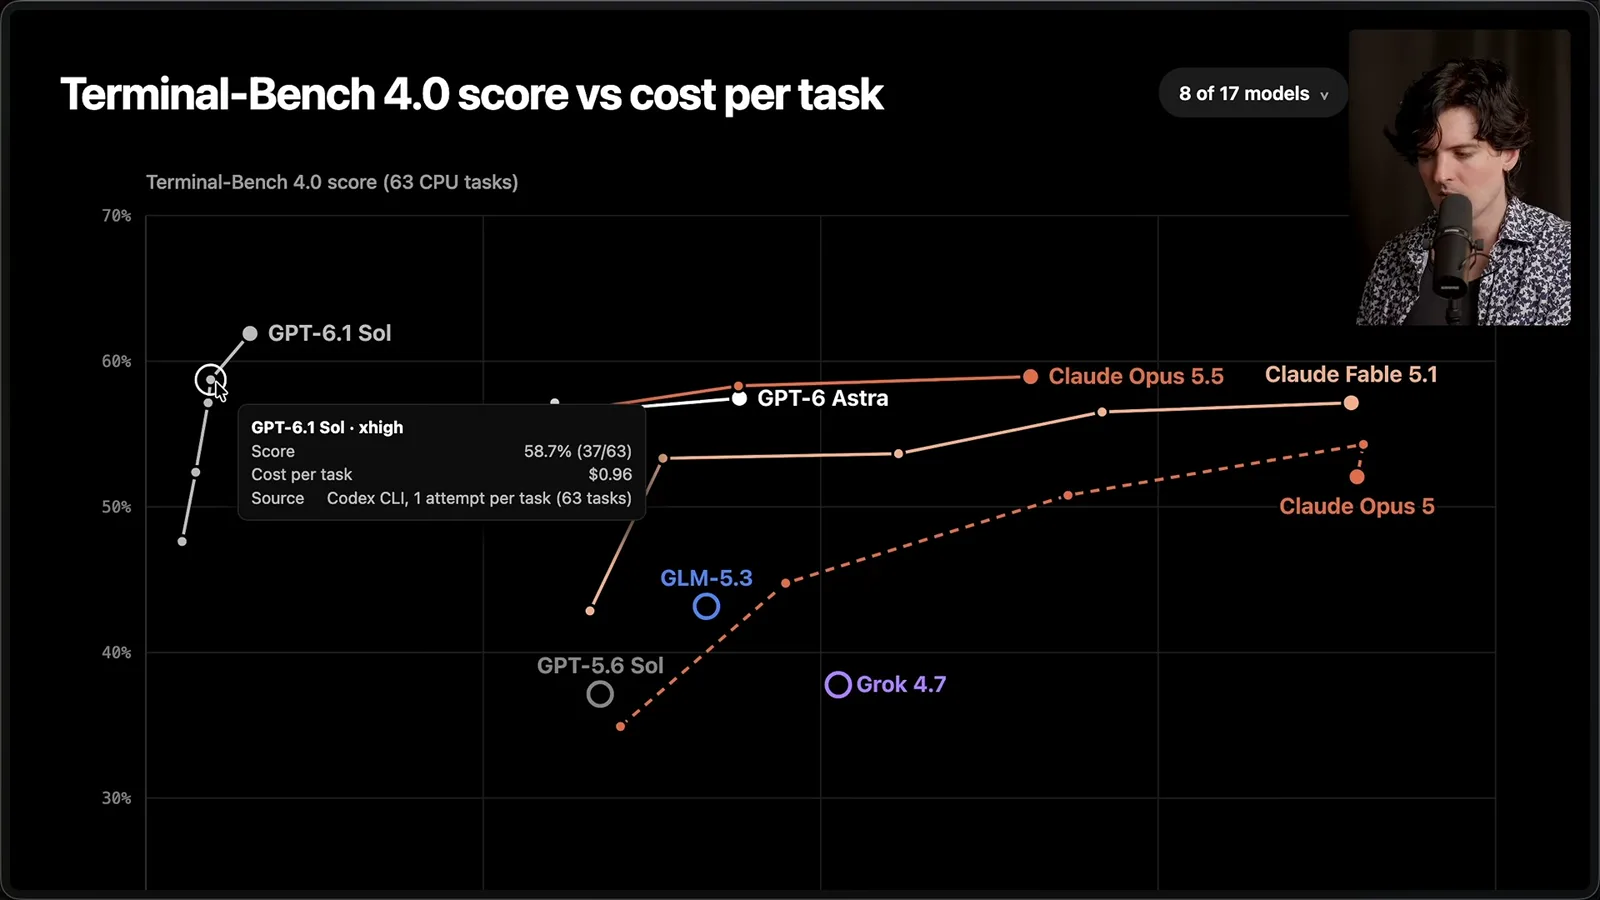
这个例子说明,模型更便宜且效率更高时,按美元估值较低的额度仍可能完成更多基准任务。准确比例取决于成功率和所做任务。我仍不认为 Sol 在我做的每件事上都自动是更好的模型。
500 美元订阅与 Ultrafast
Theo 批评高价档位的推出时机和呈现方式。他查看了更高的加速模式价格,以及基于小规模测试的额度推算。
我对 500 美元订阅的批评集中在时机和呈现方式上。在用户感受到 200 美元订阅价值下降的同时推出贵得多的档位,会让人觉得被迫升级。即使更高档位有其用途,我认为同时推出两项变化也损害了信任。
Ultrafast 又增加了一个问题。画面中的 Astra Ultrafast API 价格表显示,短上下文每百万输入 token 为 60 美元、输出为 300 美元;长上下文价格更高。我报告两次 PR 审查按 API 费率约值 600 美元。这是我自己用量的 API 等价核算,并不是说每两次审查都会花这么多。
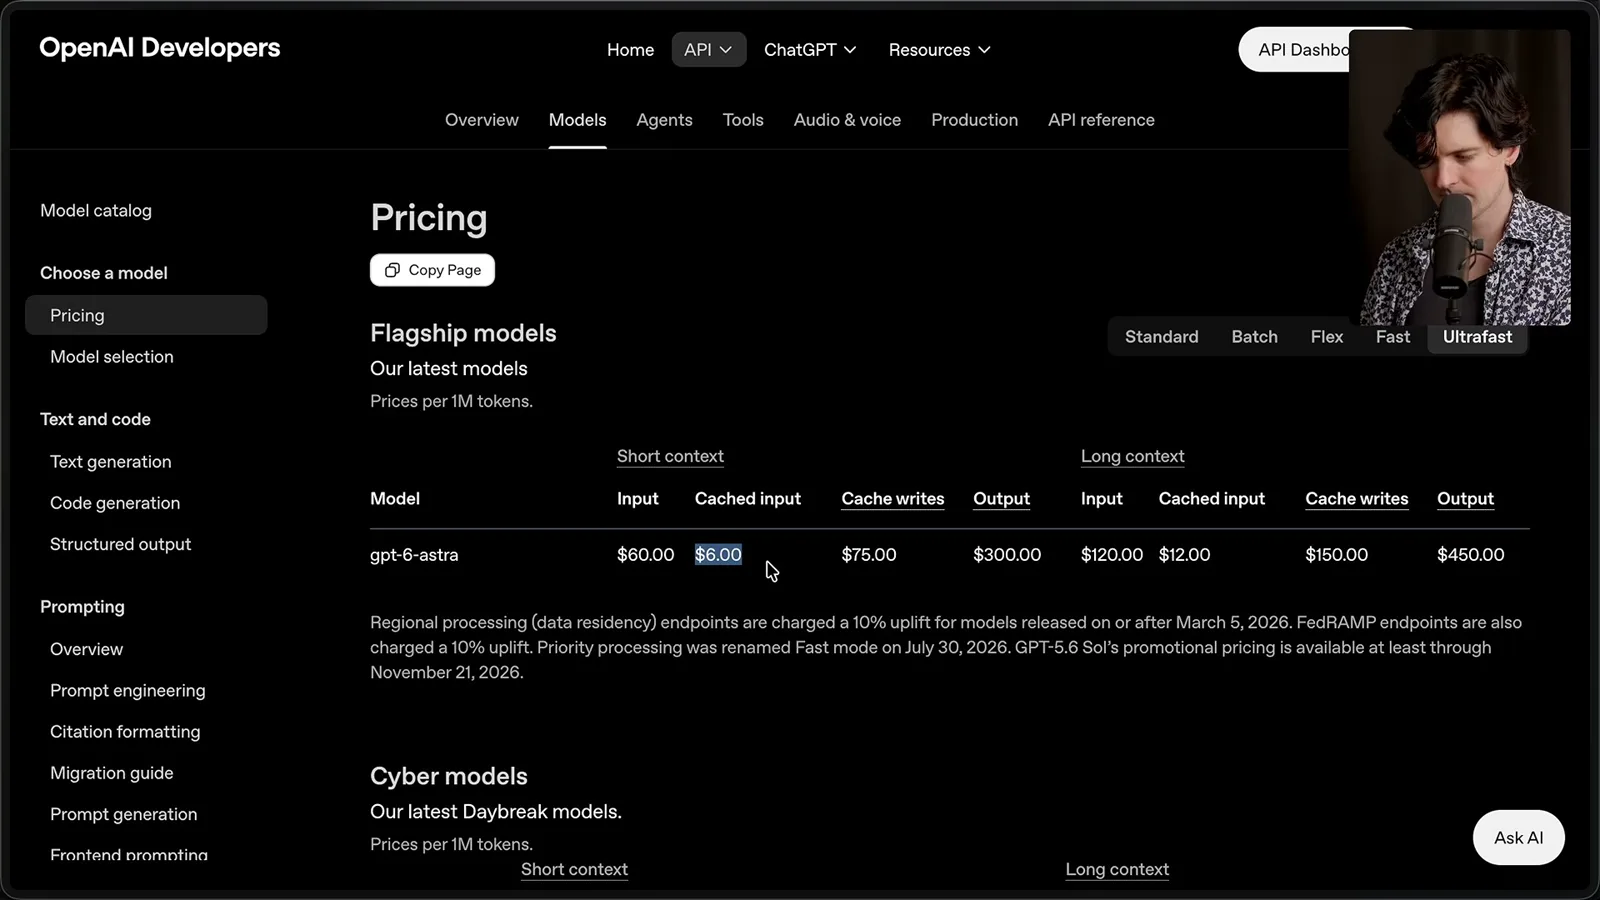
我一开始推测这种速度背后的专用基础设施,随后在视频中得知 Astra Ultrafast 使用 Nvidia,而不是我原先假设的 Cerebras 方案,于是纠正了自己。有关基础设施和利润率的解释仍是推测,而非经过核实的成本披露。
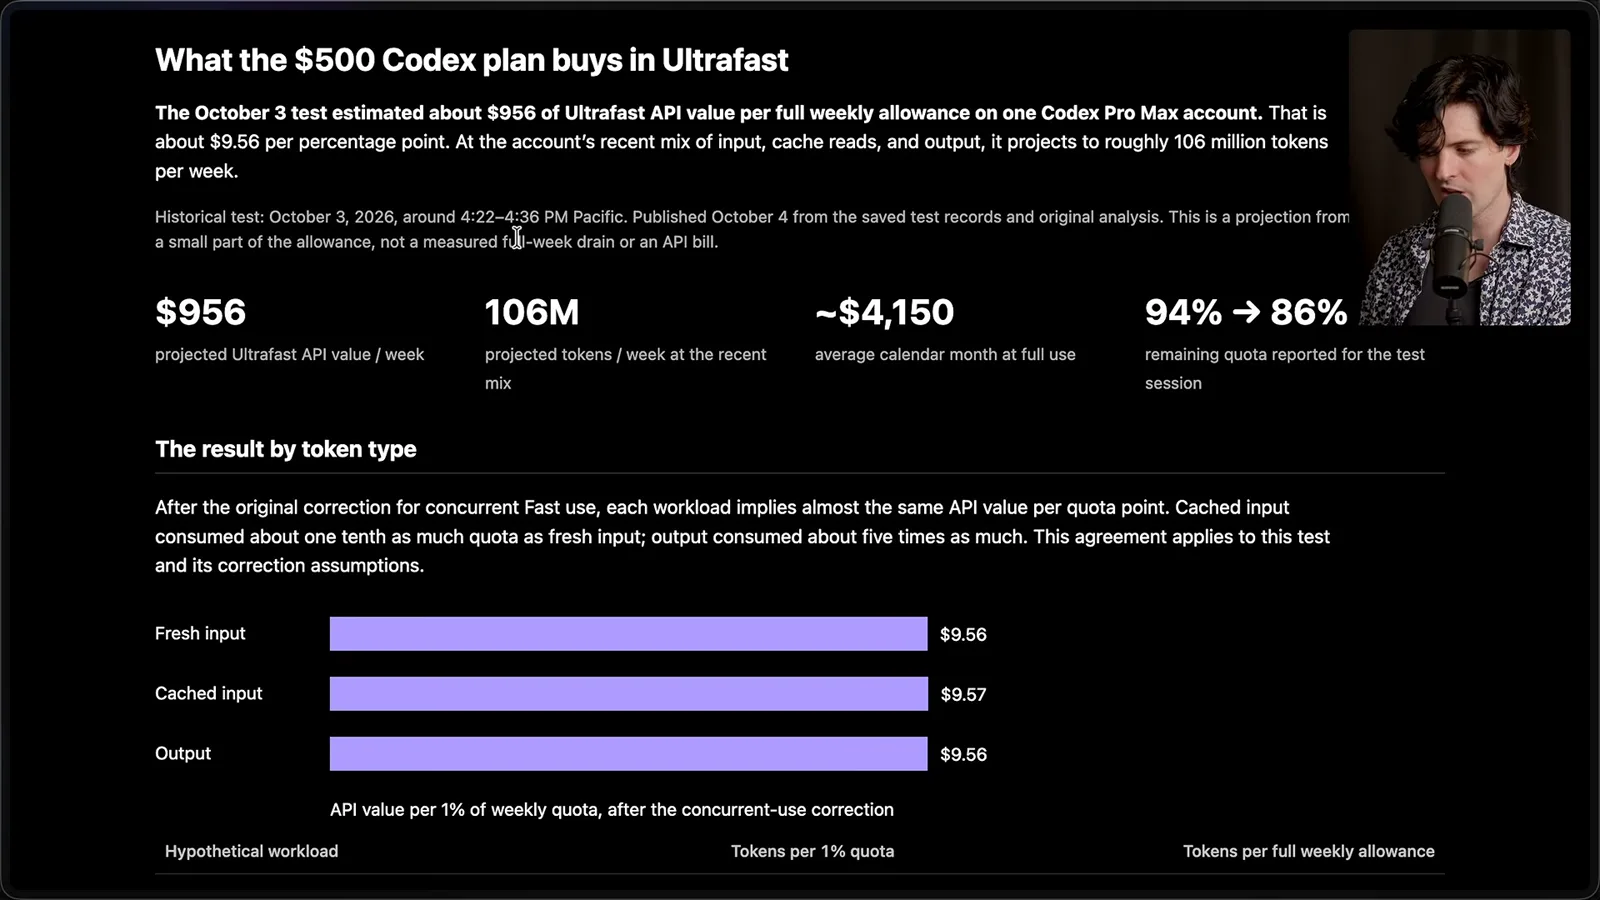
我对 500 美元订阅的估算是,每周完整额度大约相当于 956 美元的 Ultrafast API 用量价值;这个数字根据小样本和假定的 token 组合推算。我估计,在我的工作负载中,这可能对应约 2.1 小时的生成时间。截图明确指出这是推算,不是完整一周耗尽额度的实测,也不是 API 账单。
我的不满来自这些变化同时发生:限额调整、新的高价档位和非常昂贵的加速模式,在用户清楚理解取舍之前就一起到来。主要为了 Ultrafast 而升级的人,可能会对额度消耗速度感到意外。使用的模型组合与订阅价格同样重要。
对我自己的使用而言,把 500 美元订阅每月推算约 4,000 美元的 Ultrafast API 用量价值,与之前 200 美元订阅约 1.2 万美元的估算相比,感觉像是倒退。但这些数字对应不同模式、工作负载和估算方式,并非相同工作的受控比较。
根据工作选择订阅
Theo 讨论自己组合使用 Claude 和 Codex 的方式。他认为价值取决于模型与工作,而不仅是表面折扣。
如果你购买 200 美元订阅主要是为了使用昂贵的 Astra,我认为这次减少影响很大,而我自己的编程工作更偏好 Claude。如果可以使用 Sol,账户仍可能提供可观价值。我两者都用:Claude 经常负责编写,Codex 则审查其工作,或处理邮件与计算机操作任务。
我预测竞争会继续降低 API 价格,让订阅补贴看起来不再那么夸张。我希望随着时间推移,同一订阅能让模型完成更多工作,但这只是预测,不是承诺。现在,应根据它帮助你完成工作的质量、速度和数量来判断订阅价值。
同频道的其他文章
 36:07EN → 简体中文
 Theo - t3․gg· 2026年10月27日Theo 谈 Token 成本、编程智能体与 AI 能力的价格Theo Browne · Ping Labs一则关于 Lauren 的 AI 支出估算广泛传播,引出了对缓存计价、基准测试和编程智能体工作方式的讨论。
 30:37EN → 简体中文Theo - t3․gg· 2026年10月26日Theo 的三个技能:用编程智能体审查和交付代码Theo Browne · Ping Labssol-loop、full-send 和 full-stop 如何定义审查、验证以及不同程度的合并权限。
 0:43EN → 简体中文Theo - t3․gg· 2026年10月23日Theo 区分安全漏洞与实际攻击Theo Browne · Ping Labs一段简短讲解:软件漏洞披露和攻击事件为何属于不同类型的安全新闻。
 29:22EN → 简体中文Theo - t3․gg· 2026年10月22日Theo 谈安全漏洞、被盗 API 密钥与 AITheo Browne · Ping Labs从漏洞披露到补丁部署之间的风险窗口,以及被盗推理密钥为何可能有价值的推测。
 31:13EN → 简体中文Theo - t3․gg· 2026年10月20日Theo:更聪明的模型为何能帮助更多人Theo Browne · Ping Labs从游戏修改到编译器实验,Theo 重新思考谁能从更强大的 AI 中受益。
 31:47EN → 简体中文Theo - t3․gg· 2026年10月18日Theo:向智能体请求结果,再构建它需要的工具Theo Browne · Ping Labs从工具耗时报告、排障手册到数据连接,看提示如何改变产品工程。