30 秒看懂
一个小型 PyTorch 函数在排序前花费大量工作复制数千个分数。可持续数字架构师 Wilco Burggraaf 说,AI 辅助分析用索引排序替换了这项工作:函数运行速度提高 41.8%,完整模型测试的能耗降低 0.63%。他的开源流程会记录陌生代码、寻找无用计算并测试修改方案。他提醒,仅从源代码推算得出的数字并非实测:运行时、硬件使用情况和供电都会影响排放。
- 1AI 流程检查陌生代码中浪费的计算Burggraaf 将数字浪费定义为没有帮助服务完成有用工作的计算。他的团队构建了开源流程,用来记录代码、检测瓶颈并测试可能的修改。
- 2自动生成的架构笔记帮助理解大型代码库该工具先生成较长的参考资料,以及关于局部代码、依赖项和入口的简短记录,再寻找运行时模式。
- 3粗略能耗模型用于比较,不是测量Burggraaf 假设操作与能耗之间有简化关系,同时承认运行时、操作系统和硬件会改变代码的实际执行方式。
- 4小模型测试中,排序索引避免了复制分数Burggraaf 说,在约 5 万个 token 的测试条件下,这项修改使函数速度提高 41.8%;完整模型基准测试速度提高 0.8%,能耗降低 0.63%。
- 5仅靠静态分析会遗漏系统的实际表现Burggraaf 建议运行软件,检查等待、硬件利用率以及数据库和网络调用等依赖项。
- 6有了能耗数据才能估计排放他将用电量与电网碳强度结合,再除以有用工作的计量单位,同时指出分摊硬件制造排放是另一项难题。
- 7问开发者哪些系统早该退役Burggraaf 建议让管理层参与讨论,并利用运行数据找出利用不足的资源和不必持续开启的环境。
要点建议
- 先运行有代表性的工作负载,同时测量时间和能耗,再判断优化是否成功。
- 寻找不必要的复制、闲置机器,以及等待较慢依赖项的工作。
- 用源代码层面的能耗估计决定调查优先级,不要把它当作实测用量。
- 结合能源用量、电力的碳强度和有用工作的计量单位评估排放。
- 从使用频繁或成本高的应用入手,淘汰不再需要的系统。
按章节阅读整理后的全文
top-k 函数隐藏了不必要的工作
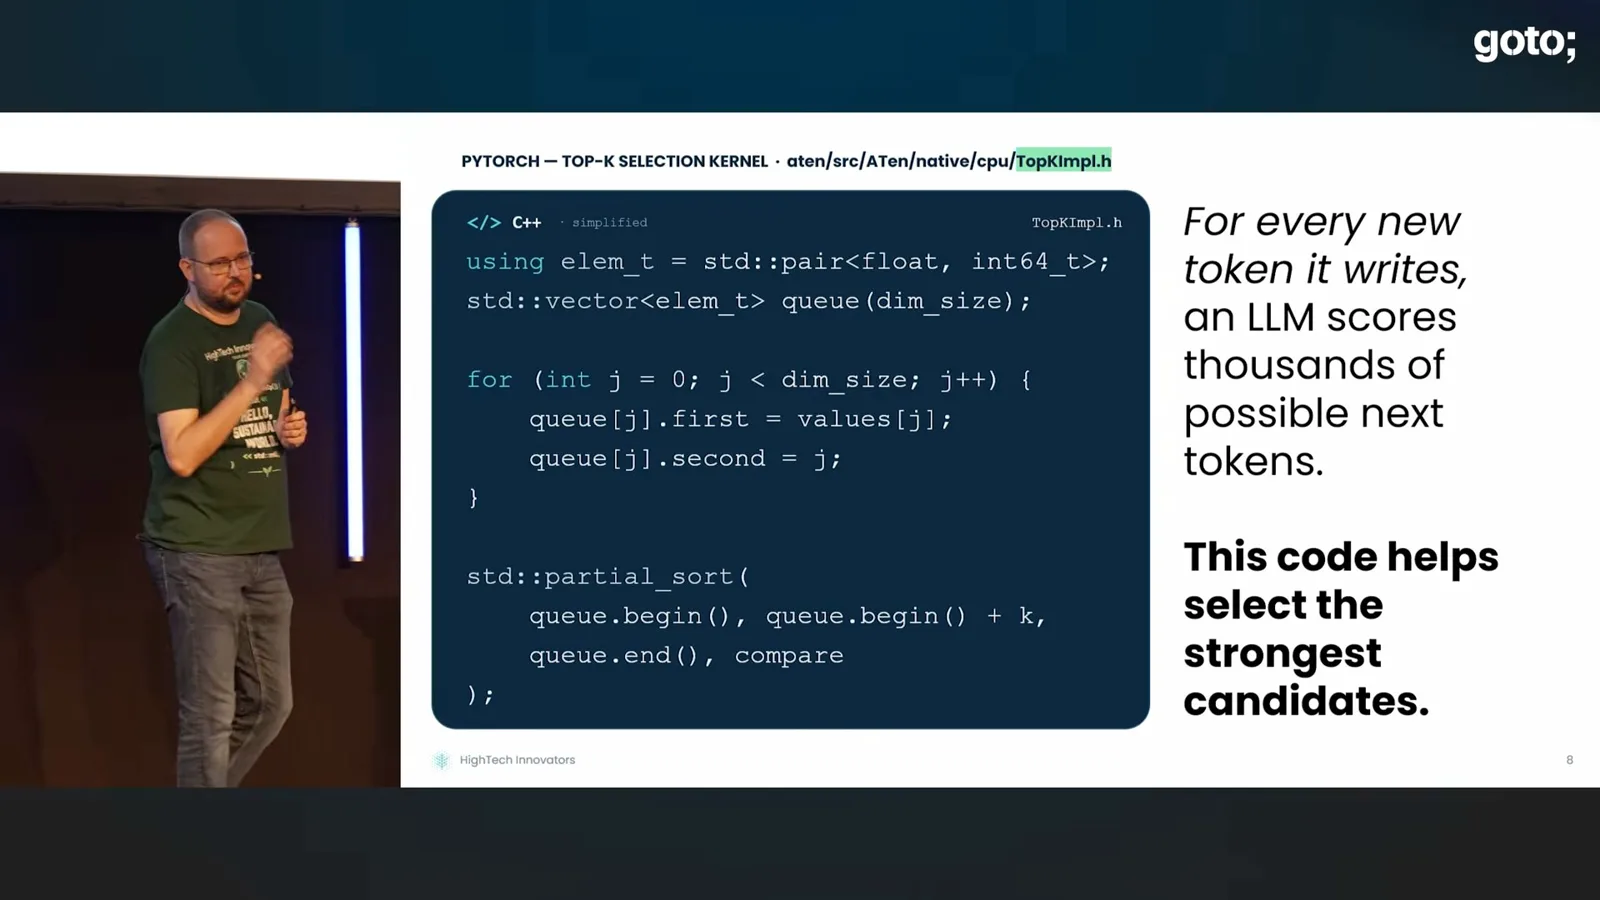
一个简单的 PyTorch 示例为下一个 token 的候选项排序。Burggraaf 提问其中哪些计算被浪费了。
这个 PyTorch top-k 函数帮助语言模型为下一个 token 选出最强的候选项。在测试案例中,它处理约 5 万个分数:先分配空间,复制每个分数和索引,再排序找出最高值。这一短小流程中,哪里可能浪费了计算?
AI 流程调查陌生项目
团队构建了一个开源流程,先记录架构,再寻找运行时的低效模式。PyTorch 是一个要求高、应用广泛的测试案例。
两年前,我在一场会议上遇到可持续发展负责人 Paul Young,我们谈起数字浪费:那些对交付有用服务没有帮助的计算。一年后,他问我们能否将这个想法变成实际工具,Microsoft 的赞助帮助我们完成了构建。
成果是开源项目 CodeWeave,任何人都可以将它用于自己的代码。我们需要一个计算量大、历史较长的项目,看看维护多年的代码中是否仍能找到浪费,因此选择了 PyTorch。
许多生成式 AI 模型都用 PyTorch 构建。我认为小模型未来也可能在边缘设备的 CPU 上运行,因此即使是很小的改进也值得关注。不过,对一个主要开发商业软件的团队来说,选择如此大的项目确实很有挑战。
我们没有 PyTorch 维护者的经验,因此首先让 AI 编写文档,描述组件、架构和设计。单份文档可能大到放不进模型的上下文,所以我们也使用较短的架构决策记录。
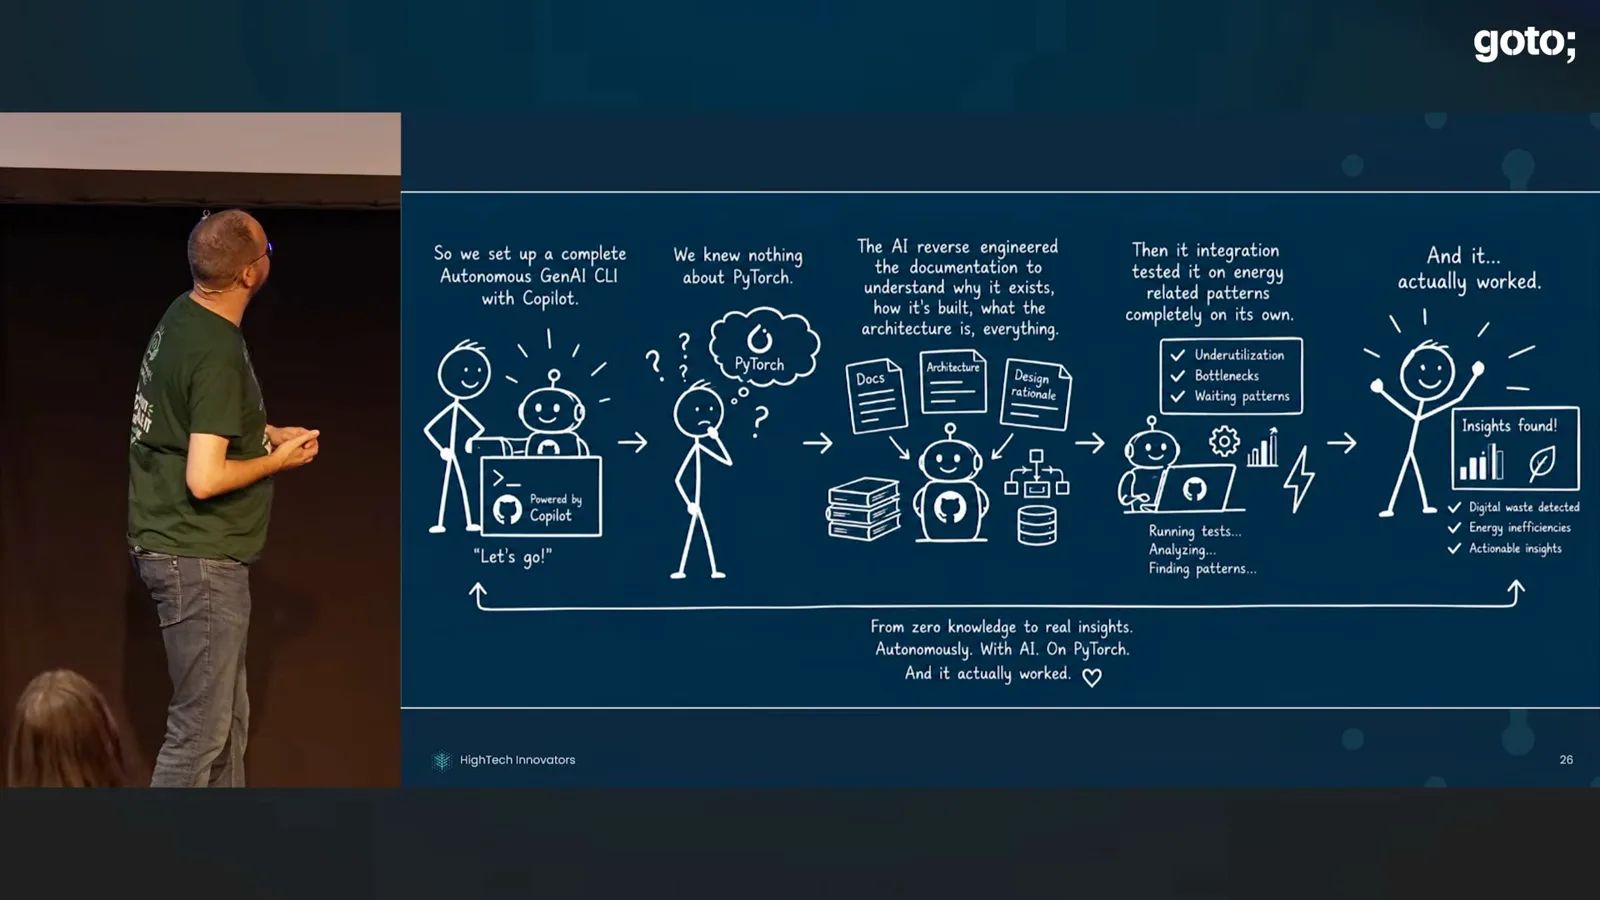
下一步是寻找能够揭示硬件利用不足、瓶颈和等待的集成测试。流程提出代码修改,运行 A/B 测试,同时检查速度和能耗。几周后,每次约五小时的运行已经产生了一些有用的想法。
为了生成文档,系统扫描代码库、组件及依赖项,并审查写出的内容。在我们的例子中,它约一小时生成 13 个 Markdown 章节,也可以排版成 PDF。
建立上下文和可重复的 CPU 工作负载
流程生成文档和较短的决策记录。模拟工作负载在使用 CPU 的流水线中运行一个小模型。
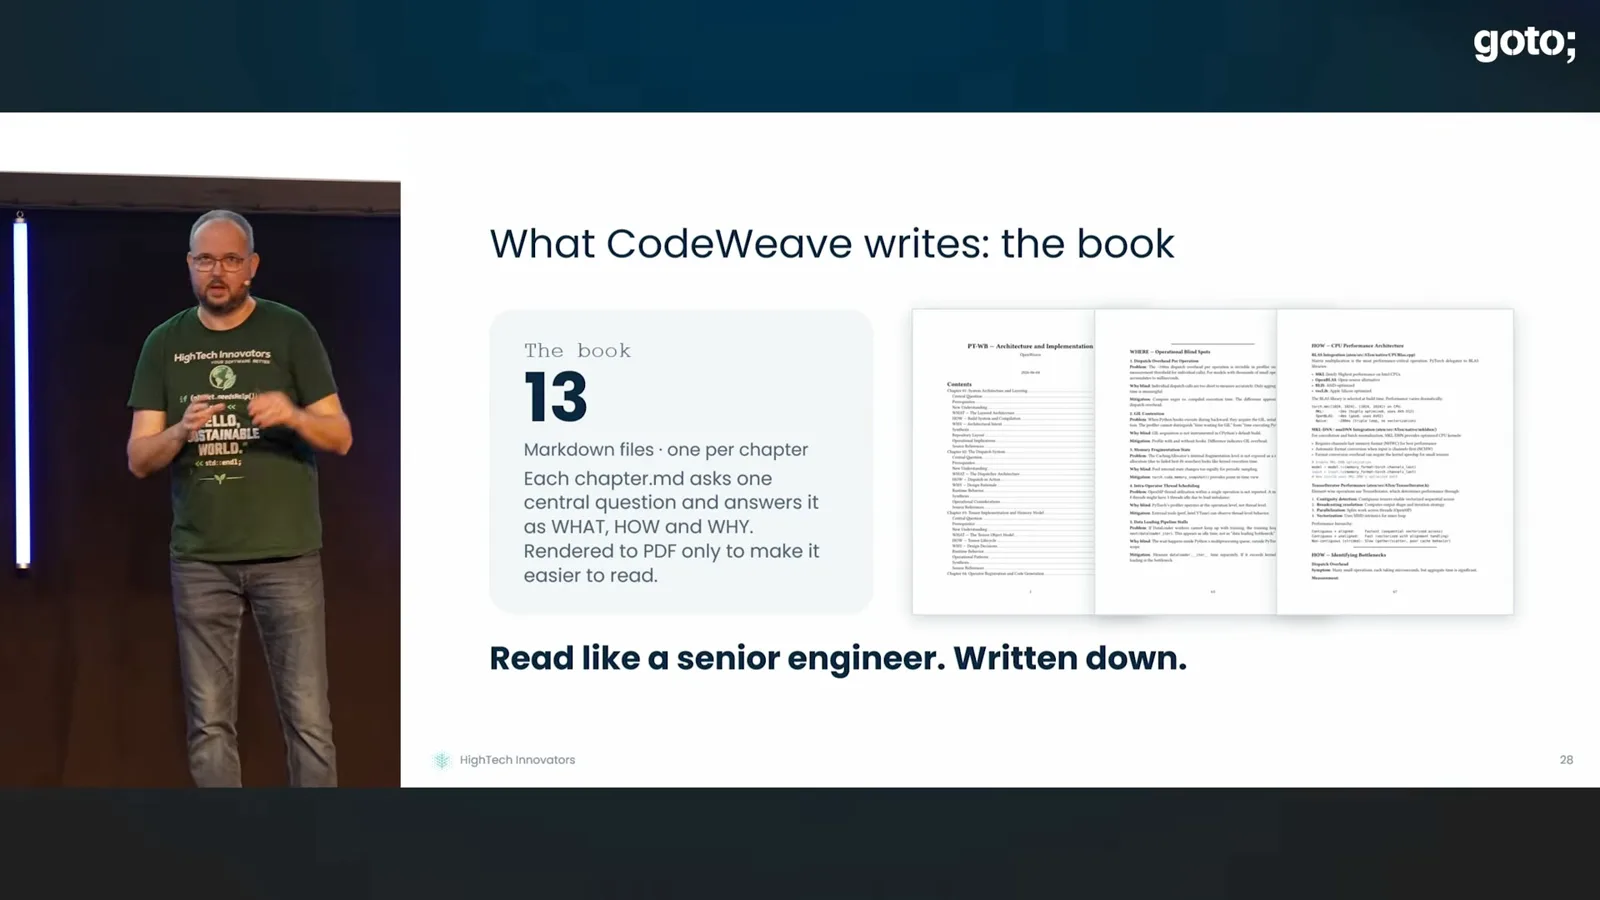
较短的记录会检查每个文件夹中的文件、依赖项和入口。例如,控制台应用的入口会告诉我们如何启动程序,以及有代表性的用户操作可能如何经过系统。
我们在持续集成流水线中以无界面方式运行这个流程。由于与 GitHub 合作,我们使用了 GitHub Copilot,但这个方案也打算支持其他命令行智能体。
流水线通常只有 CPU 而没有 GPU,因此我们采用体积小、年代较早的蒸馏版 GPT-2 模型。为了形成持续的工作负载,我们让模型模拟策展人、学生和创始人一天的生活,用不同话题调动模型的不同部分。
不断模拟接下来的日子,让软件运行足够长的时间以比较不同运行结果。这个工作负载把分析带回了 top-k 函数,但首先我想解释帮助我们决定调查方向的粗略能耗模型。
先估计能耗,再测试建议的代码修改
有意简化的模型有助于比较代码,却不能测量真实能耗。建议的修改排序索引,而不复制分数。
我从一个理论模型出发,它在重要方面并不准确:语言运行时、操作系统和处理器都可能优化单个操作。为了比较,可以设想一个活跃核心以 1.2 伏特电压运行,每个操作对应一赫兹。
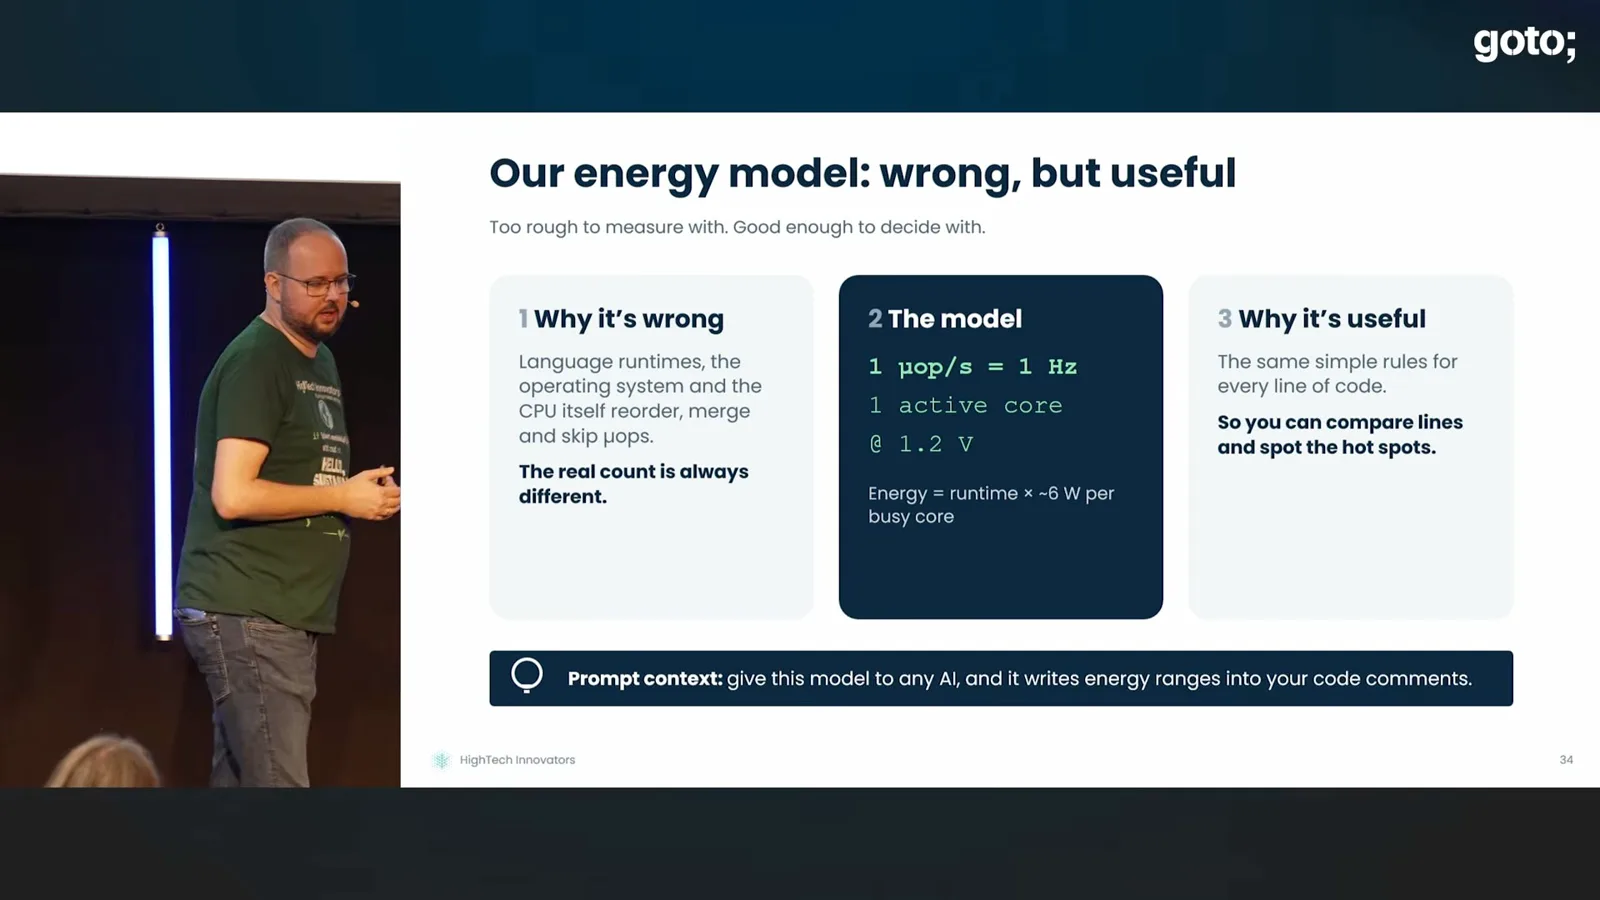
基于这一前提,AI 为它此前没有见过的代码给出可能的能耗区间。这些估计有助于发现潜在热点,其中包括一个客户的 API,但它们用于辅助决策,不是测量结果。
处理器即使闲置也会消耗能源,频率也会变化:单核心可能加速,而多个核心同时工作时可能放慢以防过热。在共享云机器上,你可能不知道还有什么在运行,因此一行源代码没有固定不变的能耗。
回到示例,这个流程发现,对于该小模型和约 5 万个分数的场景,复制循环并非必需。当 GPU 上高度并行的工作转到 CPU 运行时,内存中的数据移动可能成为瓶颈。
建议的新版本对索引而非分数与索引组成的数对排序。这减少了复制、缓冲区大小和内存流量,同时得到相同结果。在我们的测试中,函数本身的速度提高了 41.8%。
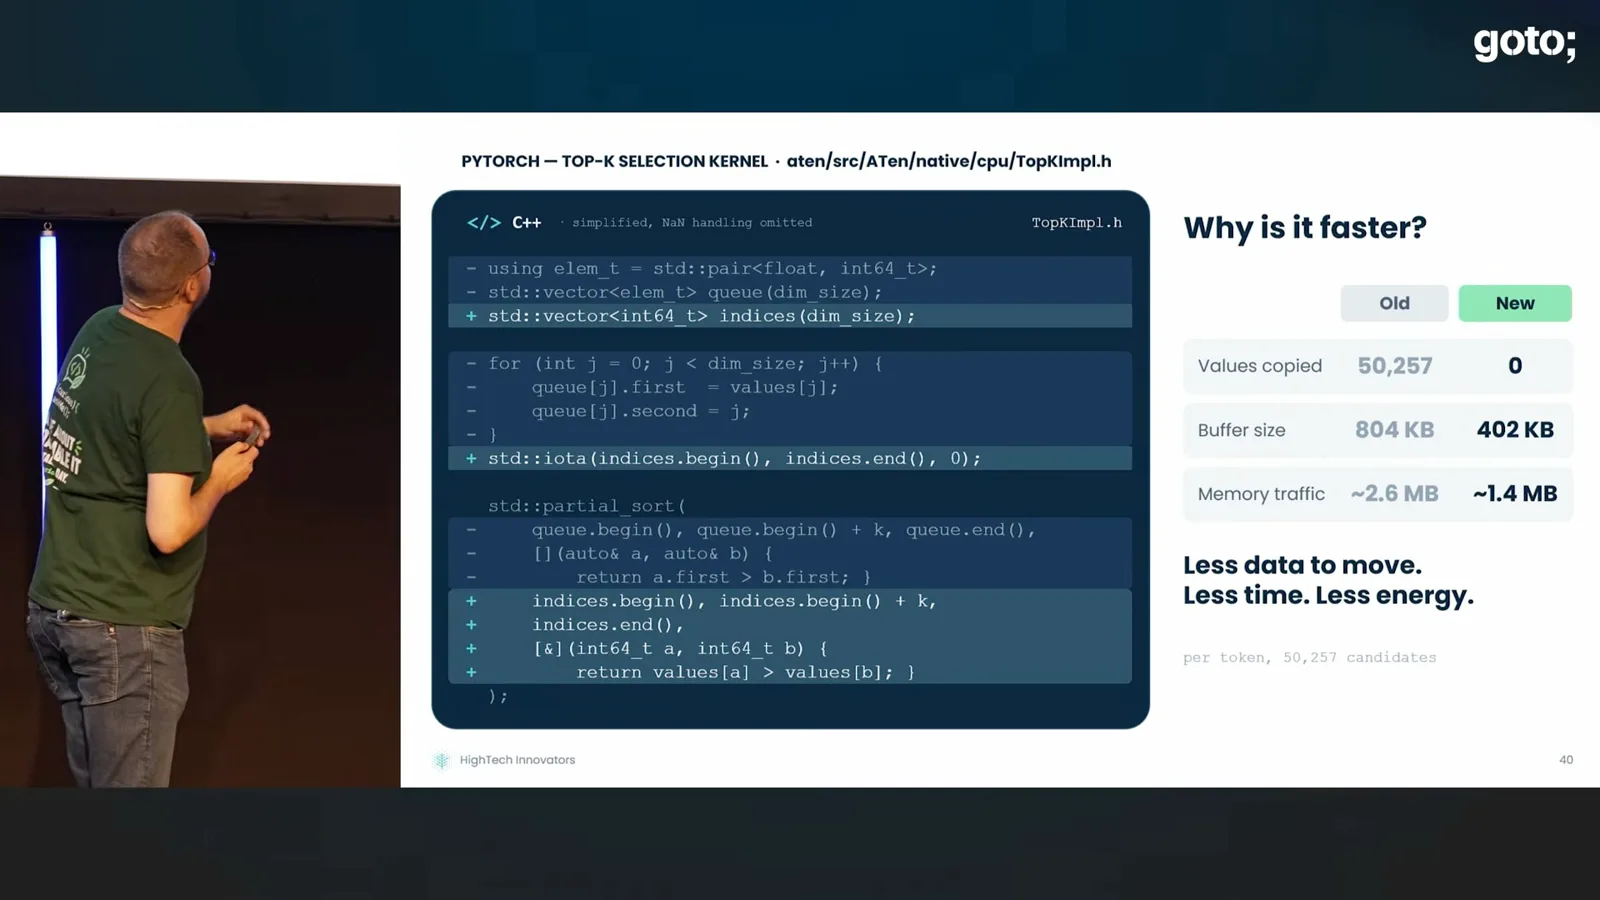
这次运行还少用了 76 毫瓦时的能源。在完整模型层面,算上其他影响后,基准测试速度约提高 0.8%,能耗降低 0.63%。日志保存在项目代码仓库中。
等待和闲置基础设施也会造成浪费
Burggraaf 说静态代码无法揭示整个系统。配置过大的机器、缓慢的数据库和持续开启的开发环境都可能浪费资源。
静态检查工具无法说明全部情况。你需要运行代码:火焰图上看似不占主导的部分,也可能包含值得消除的浪费。
同样的模式不仅出现在代码中。配置过大的虚拟机、闲置集群,以及夜间和周末持续运行的开发环境,即使无人使用也会消耗资源。
等待是另一个来源。通过可观测性可以看到磁盘、网络和内存活动、队列以及缓慢的依赖项。团队有时会先给缓慢的系统增加 CPU 或内存,之后才发现瓶颈在数据库,却仍保留过度配置的机器。
在大型组织中,我经常看到 CPU 全年的平均利用率为 20%–40%。无服务器组件在等待其他服务时同样消耗资源。观察工作和等待实际发生在哪里,有助于揭示这些模式。
根据能耗估算排放
估算取决于工作量、时间、功率和电网碳强度。Burggraaf 解释了功能单位,以及分摊制造排放的难点。
为了将数字浪费与排放联系起来,我会查看完成的工作、所需时间、消耗功率和电力碳强度。一两秒以内的响应时间可能让人觉得已经够快,但其中仍可能有可以避免的工作。
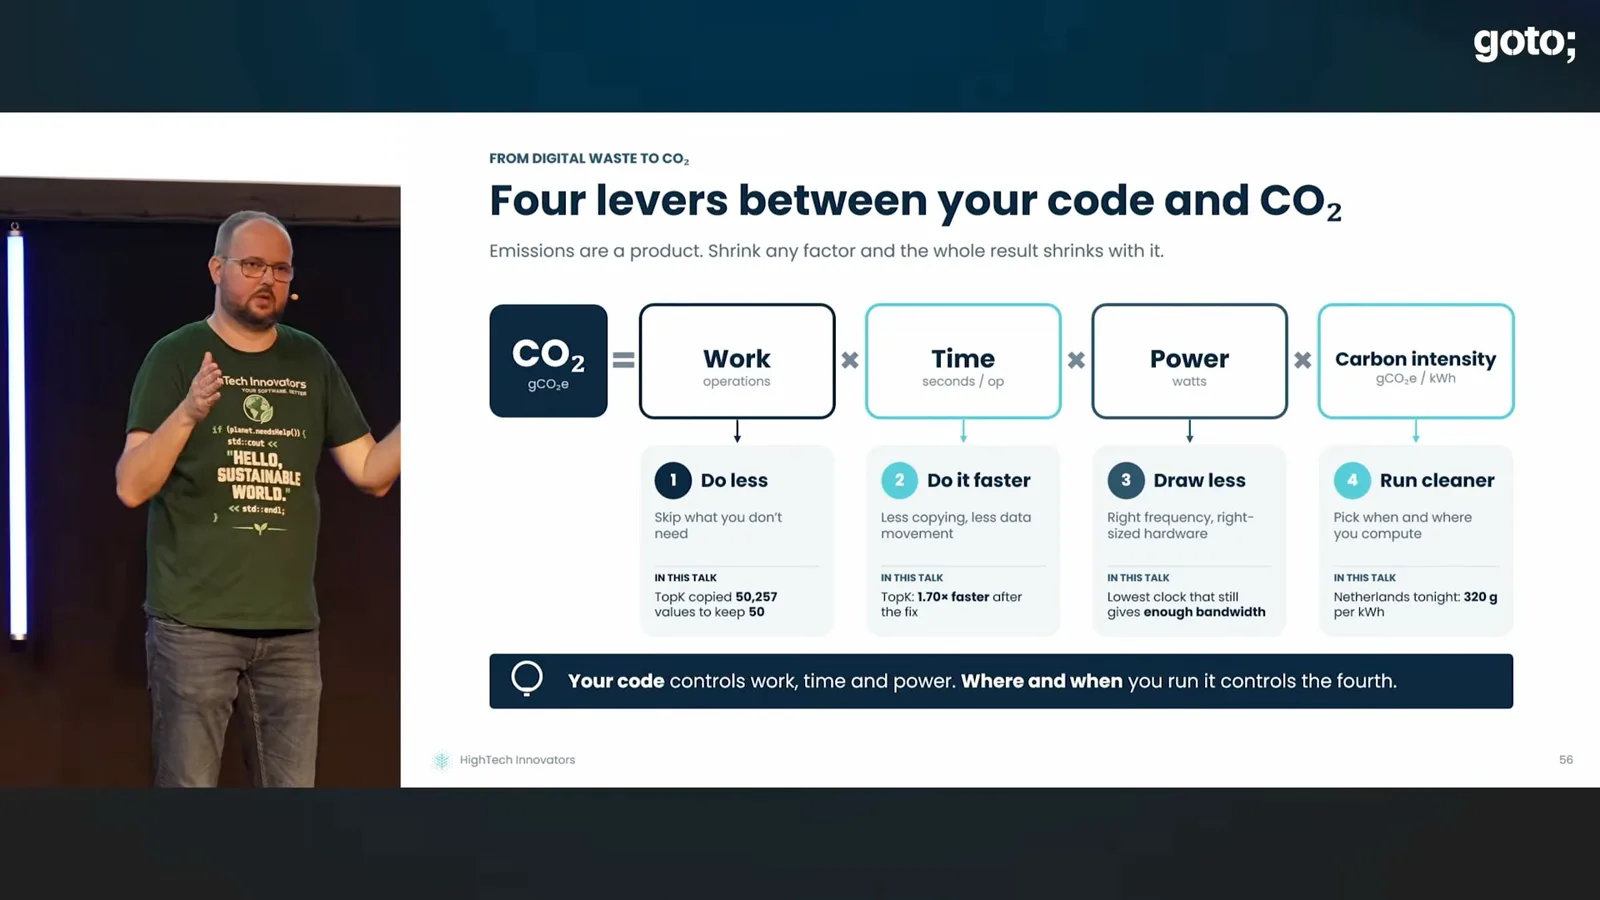
电网碳强度随地点和时间变化。在荷兰,我见过每千瓦时约 50 至 500 克二氧化碳的范围。举例来说,按每千瓦时 320 克计算,一台 1,000 瓦的微波炉运行一小时对应 320 克排放。
仅看静态代码不够:要运行工作负载并收集能耗数据。事后可以利用历史电力碳强度数据估算排放,但没有能耗数字就无法进行这项计算。
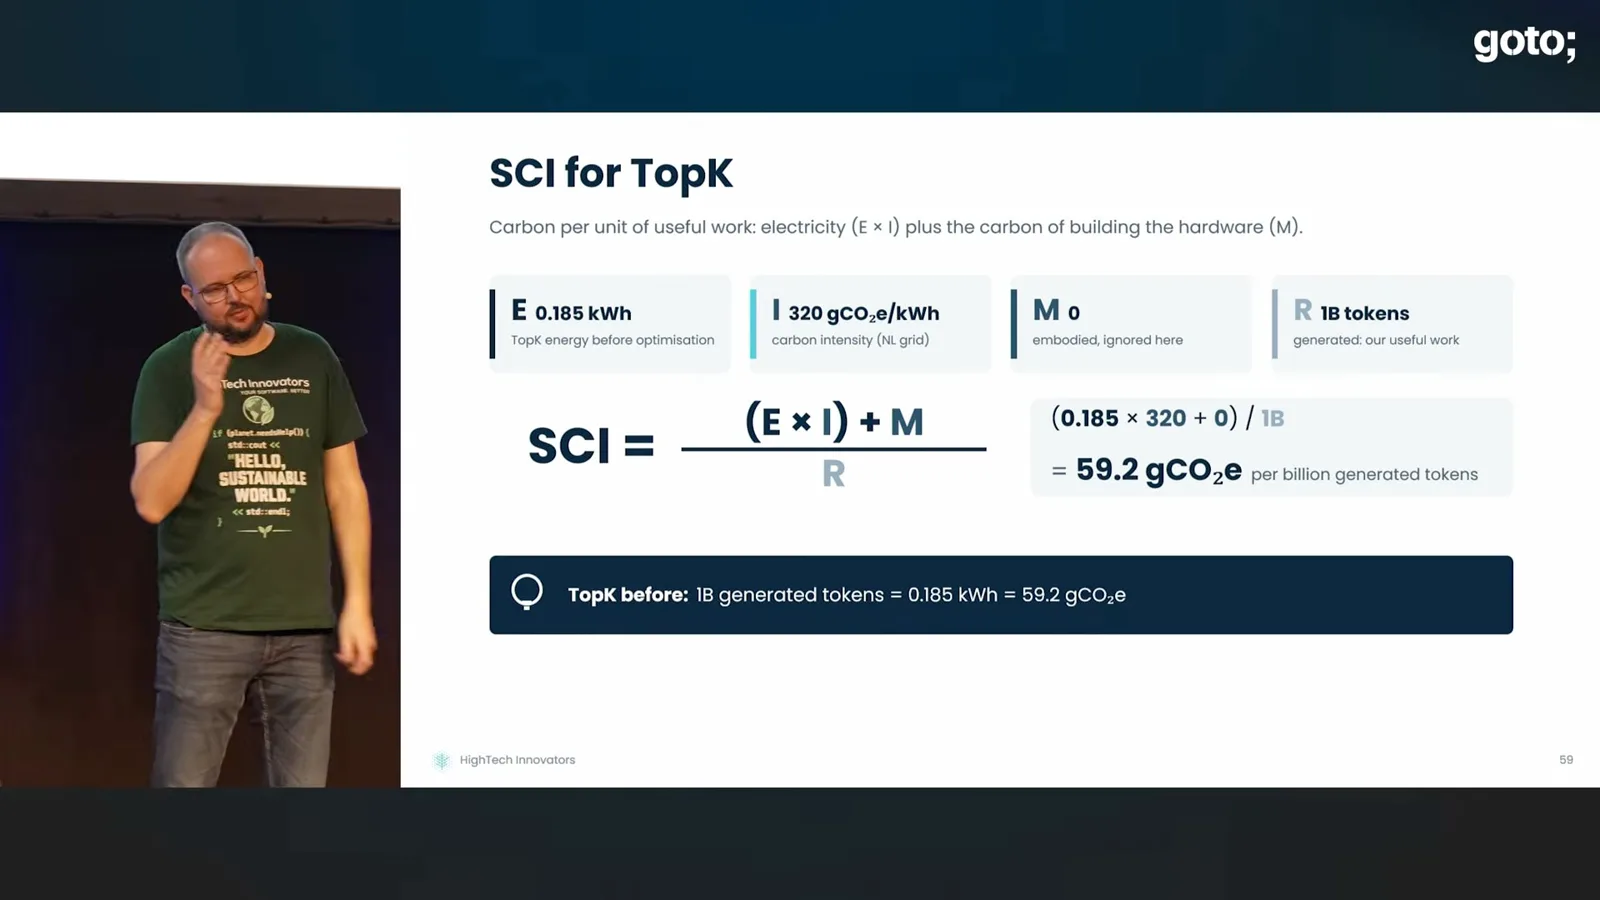
Green Software Foundation 的软件碳强度方法,将估计的运行用电量与电力碳强度相乘,加上制造和运输硬件的隐含排放,再除以有用工作的计量单位。将隐含排放分摊到硬件寿命各年很困难,所以我在这个例子里暂时不计入。
有用工作的单位可以是生成十亿个 token、一次 API 请求或一次用户操作流程。这样团队比较的是实际交付服务的排放,而不只是计算机器数量。
0.8% 的改善看似很小,但在大量使用的系统中反复发生就可能累积。我建议客户从成本最高或用户最多的应用入手。AI 预算可能比一般清理工作更容易申请,尽管这些工作也可以手动完成。
演讲前一周,我们提交了 PyTorch 修改供审查。维护者认为这是个不错的改动,并表示可能还可以进一步改善;演讲时预计审查仍需几周。
利用运行数据确定优先级并消除浪费
演讲时,PyTorch 的拉取请求仍在审查中。他要求团队和管理者检查需求、使用模式和可以退役的系统。
开发团队应能解释不同时段对虚拟 CPU、内存、容器和存储的需求,以及如何高效处理这些需求。现有日志和运行数据可以帮助整个组织回答一组简短的问题。
构建流水线也是软件:它在晚上和周末可能不必一直开着。可以用家庭水费账单来理解:了解淋浴设备和水流量只是起点,类似于了解基础设施成本;实际用量还取决于洗澡的频率和时长。
运行可观测性补充了这幅使用情况的图景。它经常用于调查故障,但也可以显示整个组织的计算工作负载是否有用、高效。
减少资源浪费可以节省资金,减少技术债务也能腾出时间用于维护以及客户重视的工作。这类成本大多不可见,因为组织不会收到一张单独列明员工时间的账单。
从优化或调整资源规模、淘汰不再需要的资源入手。询问开发者哪些系统早该退役,并邀请管理层来听答案:当熟悉系统的人共同讨论时,问题就会变得具体。
同频道的其他文章
 32:58EN → 简体中文
 GOTO Conferences· 2026年11月18日Dave Thomas:让智能体处理惯常动作,人保留判断Dave Thomas《程序员修炼之道》合著者区分可重复流程、策略与价值观,解释开发者如何与编程智能体协作。
 43:06EN → 简体中文GOTO Conferences· 2026年11月17日Jennifer Petoff:培训工程师运行自己构建的系统Jennifer PetoffGoogle 前 SRE 教育负责人解释,如何通过实践培训和可靠性方法,大规模建立应对生产环境的信心。
 38:10EN → 简体中文GOTO Conferences· 2026年11月16日Andrea Magnorsky:让架构决策透明且责任明确Andrea Magnorsky明确谁来决策,征求受影响者的建议,并通过小型协作练习找出缺失的知识。
 45:33EN → 简体中文GOTO Conferences· 2026年11月12日一座让孩子可以爬进去的“计算机”游乐场Linda LiukasLinda Liukas 将抽象计算概念转化为故事、身体游戏和公共空间,并追问工程师能从玩耍中学到什么。
 41:55EN → 简体中文GOTO Conferences· 2026年11月11日Evan Ratliff 创办了一家 AI 运营的初创公司,智能体编造了进展Evan Ratliff一次让 AI 充当同事的实验,暴露出失控的对话、虚假记忆,以及与真人交接工作的困难。
 38:07EN → 简体中文GOTO Conferences· 2026年11月10日让团队参与设计,组织重组才能更顺畅Joakim Sundén · Better Product WorkJoakim Sundén 将领导层的战略与员工对日常工作的了解结合,再让员工自主选择团队。