30 秒看懂
快速生成代码并不会让生产系统更容易运行。曾领导 Google SRE 教育团队的 Jennifer Petoff 认为,工程师需要刻意练习,才能建立调试和事故响应的信心。她的团队用动手场景取代大量入职讲座,并让学员行为变得可观察。为了覆盖更多人,团队将模拟环境的准备工作自动化,并采用同伴带领的小组,使吞吐量提高了 5 到 10 倍。Petoff 建议,根据组织规模设计培训,并把监控、反馈和自动化应用于培训本身。
- 1代码生成越快,运维越成为关注重点Petoff 认为代码仍须集成、调试和可靠运行。她引用故障分析研究,说明运维推理对 AI 智能体依然困难。
- 2设计培训要考虑三种不同的准备程度评估组织的成熟度、学习者对公司的熟悉程度,以及他们在相关领域的经验。这些维度决定应弥补哪些缺口。
- 3根据增长速度和现有员工调整培训规模Petoff 建议,小型稳定团队采用导师制,快速增长的小团队重点做好入职培训,规模大且增长快的组织则需要更全面的项目。
- 4把学习目标写成可以展示的行动不要仅要求学员“理解一项服务”,而应要求他们解读监控图表,或在规定时间内将流量移出集群。
- 5反馈让入职培训从听讲转向实践Google 的 SRE 教育团队用同伴小组中的真实故障排查取代大量讲座,进而能够观察具体的生产环境技能。
- 6自动化大幅提高实践培训容量On-Call Ready 将练习环境自动化,并采用同伴带领的小组。Petoff 说,学员吞吐量提高了 5 到 10 倍,同时也承认与讲师带领的培训在质量上存在取舍。
- 7像发布生产服务一样推广培训一门自主学习的安全课程采用自动化交付,并先向 1% 的人群试点。Petoff 表示,课程完成率超过 95%,经过迭代后净推荐值提高了 30 个百分点。
要点建议
- 围绕可观察的生产环境行动开展培训,而不是提出无法检验的目标,例如让学员“理解”一项服务。
- 让工程师在面对真实故障之前,通过实践和同伴支持建立信心。
- 根据组织规模、增长速度和学习者经验,在导师制、入职培训与完整项目之间作出选择。
- 监控反馈及与工作有关的行为,像改进一项服务一样迭代培训。
- 继续让人参与:除了 AI 辅助,未记录的知识、故事与人际关系也很重要。
按章节阅读整理后的全文
为什么应通过培训建立生产环境信心
写代码只是软件责任的开始。Petoff 认为,安全运行系统是一项需要刻意练习的人的技能。
对软件负责既是技术挑战,也是人的挑战。工程师需要有信心在服务进入生产环境后保持其可靠性,而有针对性的培训可以建立这种信心。
许多工程师花数年学习语法、算法和框架,但正规教育主要关注构建阶段。系统生命周期和成本的很大一部分发生在部署之后:人们要维护、保护、调试和改进可能并非自己编写的系统。
转向 DevOps 或站点可靠性工程(SRE)时,人们可能以为擅长编码自然就有信心做好运维。事实并非如此;如果忽视这一差距,可能导致压力、冒名顶替感和人员流失。
AI 让运维瓶颈更加明显
更快地生成代码并不能消除集成、调试和维护工作。Petoff 说,人仍然需要理解生产环境中的故障。
生成式 AI 让写代码更快,但代码仍须与其他服务集成、扩展、调试并全天候运行。随着构建变得更便宜,后续运营的相对负担也在增加。
AI 工具可能擅长生成新代码,却不一定拥有长期安全运行系统所需的跨代码仓库完整背景。大量验证和故障排查仍由人承担,尤其是面对不寻常的故障时。
我引用 ORCA-bench 关于故障根因分析的研究:五个前沿智能体中表现最好的,在中等难度任务上的准确率约为 25%,高难度任务上为 10%。运维推理仍不是一个已经解决的问题。
构建有明确的时间边界,但只要代码还在生产环境运行,运维就不会结束。因此,团队需要让现有开发和运维人员有能力、有信心运行服务,而不是假设总能增加人手。
培训改变行为与文化
信心来自学习,而不是信息轰炸。反复实践的行为可以形成高信任的运维文化。
相互作用的系统和事故管理都有大量知识需要学习。培训不应像消防水管一样灌输信息:单向讲授的内容,人们只能记住一小部分。对成年学习者,尤其是新人来说,培训还应帮助他们建立自信。
工具不会自行运行生产系统,运行系统的是人。文化会影响工程师在故障发生时是僵住,还是自信地、不互相指责地应对。DORA 研究将高信任文化与可靠性和人员福祉联系起来。
文化不能单靠自上而下的命令建立。有针对性的学习帮助人们有信心尝试新的运维行为;这些行为在团队中反复出现,就会成为习惯并塑造文化。
为组织选择培训方法
培训方式从自学到正式项目构成一个连续谱。组织成熟度、熟悉程度和个人经验决定了教学内容。
培训方式构成一个连续谱。在支持较少的一端,可以让人独自摸索或指引他们自学。团队也可以采用伙伴制、导师制、跟岗和临时课程;系统化项目则增加明确的目标和稳定的日程。
如果重视包容性,就应避免让人自生自灭:这可能带来挫败、压力和冒名顶替感。对于其他方式,应权衡收益与所需时间、精力。
更有结构的项目可以表明领导层重视员工发展,并强化共同文化。相比之下,完全依赖伙伴制,可能因伙伴的观点和习惯不同,让新人获得参差不齐的指导。
决定教什么时,要看三个维度:组织在实践与文化方面的成熟度,每个人对公司和基础设施的熟悉程度,以及他们在相关领域的经验。
刚开始采用 SRE 或 DevOps 的组织应先弥补基础缺口。团队是否跟踪缺陷、规划工作、使用版本控制、执行前清楚描述解决方案,并维护共享工具和库?如果没有,就从这里开始。
不同人对变化的反应不同。熟悉组织却缺乏新方法经验的人可能会抵触,尤其是在经历多次变化之后。要解释这对他们有什么好处,以及这次变化为何不同。
曾在其他地方实践过 SRE 或 DevOps 的人可以成为催化力量;要让他们有机会分享自己的经历。根据受众调整培训内容和形式,不要假设所有人的起点相同。
根据经验和公司知识安排学习
新人、内部转岗人员、行业资深人士和经验丰富的内部员工各有不同的缺口。同一模型也可用于 SRE 以外的技术采用。
对于实践已经成熟的组织,培训应强化现有文化并建立信心。根据员工对组织的熟悉程度和相关经验评估团队,再确定每个群体需要什么帮助。
既不了解公司、又不熟悉该领域的新员工两方面都需要学习。内部转岗人员了解组织,但可能需要学习专业方法;行业资深人士需要熟悉公司的具体系统,也可能需要改掉旧习惯。经验丰富的内部员工则需要更深入的内容支持成长。
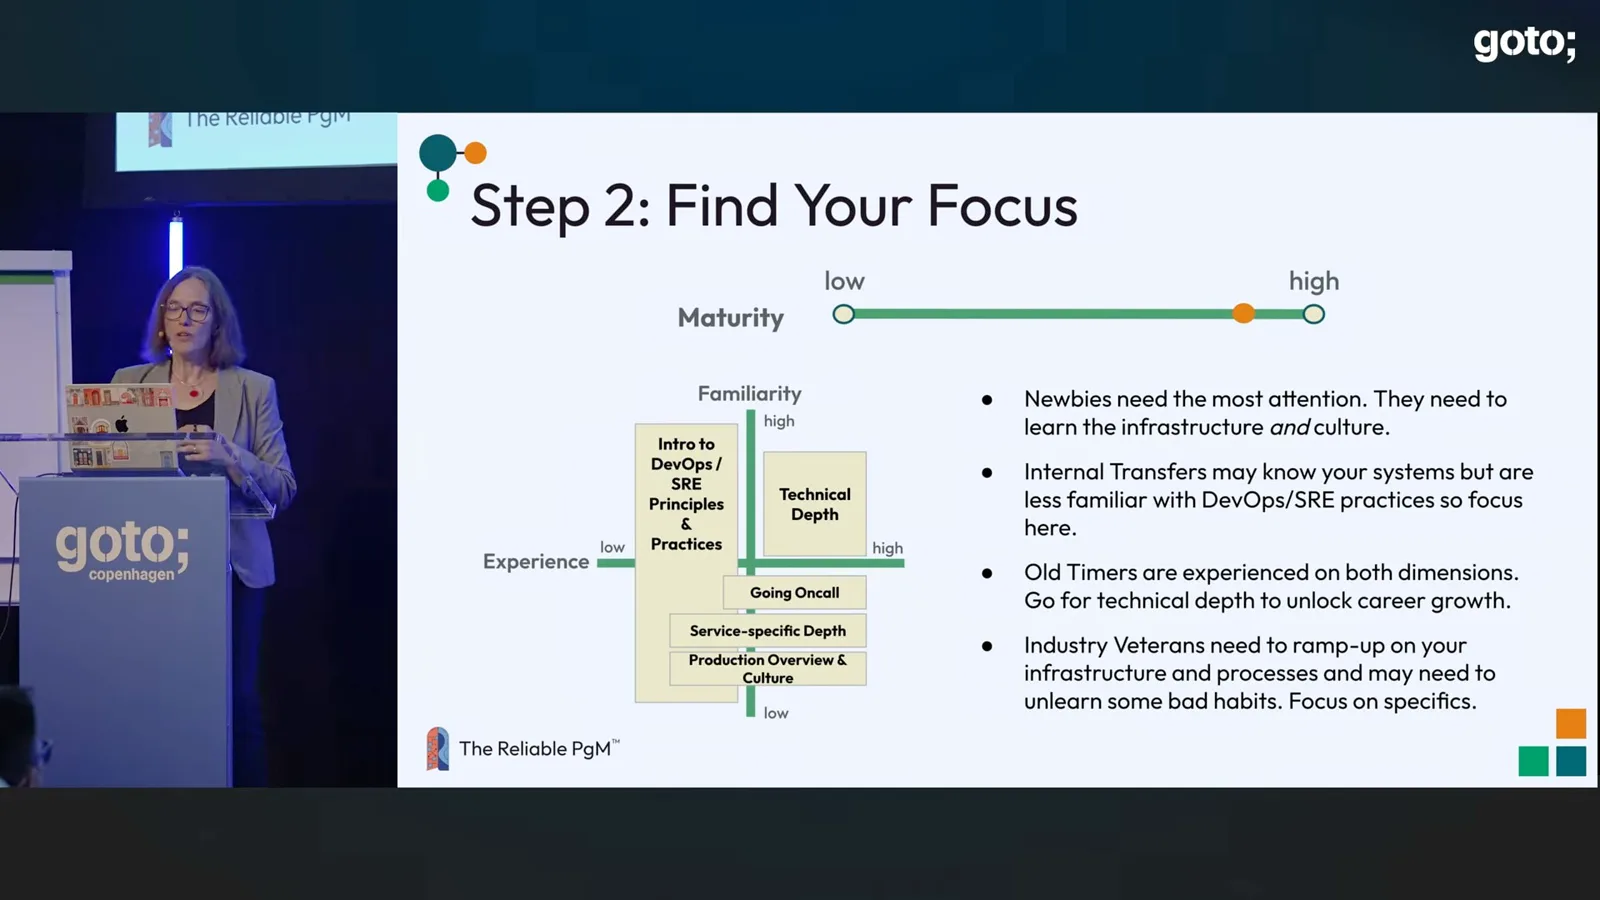
同样的双轴模型也可以帮助推行 AI。新人可能需要学习安全使用基础;经验丰富但刚加入公司的人则需要了解治理方式和专有背景。这只是一个例子,并不是我已经实施过的项目。
确定投入规模,同时保留人的参与
组织规模和增长速度影响培训交付方式的选择。Petoff 解释,即使有 AI 辅助,人和人的故事仍然重要。
培训和软件一样,既有“做什么”,也有“怎么做”。内容可能是看得见的部分,但交付机制必须为学员提供一致、可靠且满足需求的体验。
根据组织规模和增长速度决定运营投入。规模小、增长慢的团队可能通过导师制和跟岗就足够了;规模大、增长慢的组织则应为现有员工投入持续教育。
规模小但增长快的组织尤其能从入职培训中受益。规模大且增长快的组织,可能值得建立覆盖入职和持续教育的完整项目。在 Google,我们小规模的全职 SRE 教育团队与许多志愿者合作。
我不建议把全部培训交给 AI。非确定性系统可能出错,而当目标是让人有信心采取正确行动时,这就是个问题。人仍应参与项目的创建和交付。
文档很少是完整无缺的:重要的细节可能只存在于人的头脑中。故事、组织文化和心理安全感也在人与人之间传递,而培训本身建立的关系能让日后合作更顺畅。
让学习目标可观察
描述并检验学员应该能够做到的事。迭代设计和反馈让培训持续符合需求。
从这样的学习目标入手:“学员应该能够”完成某件事。“理解这项服务”过于被动,也难以观察;目标应描述可见或可衡量的行为。
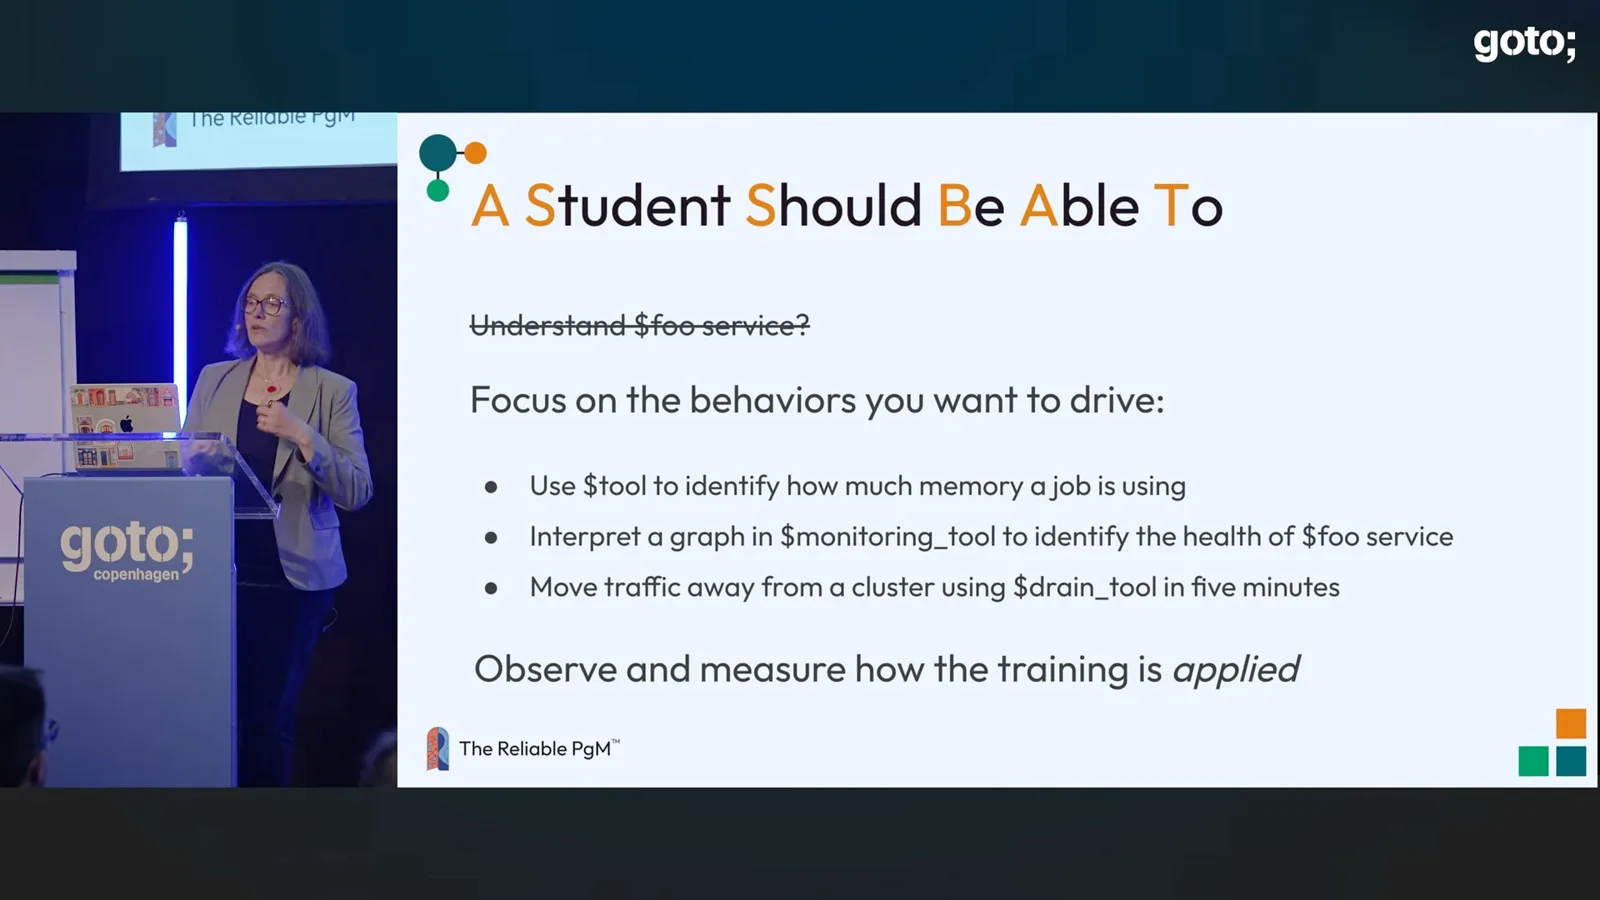
例如,学员可以用工具识别内存使用情况、解读监控图表以判断服务健康状况,或在五分钟内把流量移出集群。我认为,借助 AI 起草和检查这类目标很有用。
教学设计人员使用 ADDIE 模型:分析、设计、开发、实施和评估。先分析组织与学习者的需求,围绕目标设计和交付内容,再利用反馈持续改进。
把可靠性工程应用于培训服务
监控、测试、从失败中学习并将重复工作自动化。Petoff 展示反馈如何改变 Google 的 SRE 入职培训。
我意识到,团队教授的 SRE 原则也能用来改进培训服务本身。服务可靠性层次结构提供了一种思路:从基础实践出发,让项目充分发挥潜力。
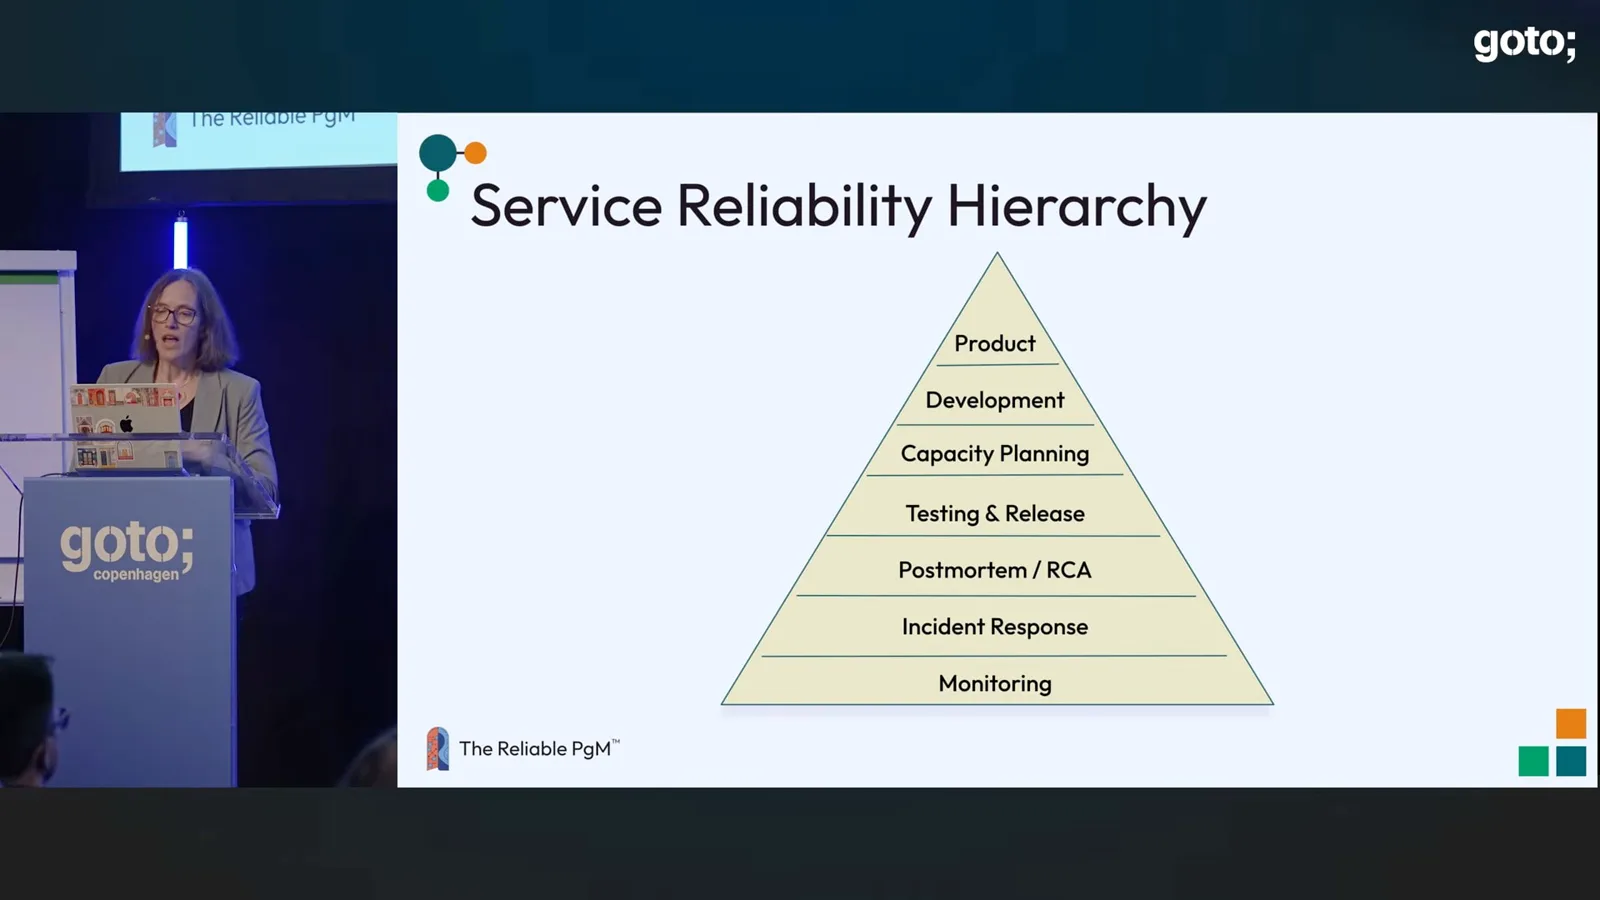
在培训中,监控可以是考勤和问卷反馈。团队处理发现的问题,在适当情况下撰写事后复盘,测试新内容,并将重复工作自动化,让有限的人力发挥更大作用。
投入越多不一定越好。要平衡投入与结果,做到足以满足学习者的需求;对某个部分过度打磨,可能挤占其他需求的资源。
一项 SRE 入职培训推出六到十二个月后,反馈显示学员希望亲自动手,而不是接受大量讲座。团队因此围绕一个专为练习构建的真实系统重新设计课程,让学员排查故障。
学员三人一组,经验最少的人居中操作,同伴提供支持。随着课程推进,引导者逐渐退后,让大家有空间练习并建立信心。
新场景获得了积极反馈。我们做这项分析时还没有大语言模型,阅读开放式文本反馈十分费力。如今 AI 可以帮助找出主题和提出假设,但仍应根据成功标准加以检验。
改进后的项目也让与工作有关的行为变得可观察:学员可以展示如何使用系统图、利用 SRE 工具诊断问题、标注故障、缓解真实的模拟问题并提出解决方案。
扩大实践培训与生产安全培训的规模
自动化和同伴支持提升了模拟练习的吞吐量。自主学习课程让更多人接受了强制性安全培训。
这些动手排障练习使用真实基础设施并模拟生产环境故障,价值很高,但需要讲师和助教参与,因此每年大约只能培训 1,000 人。
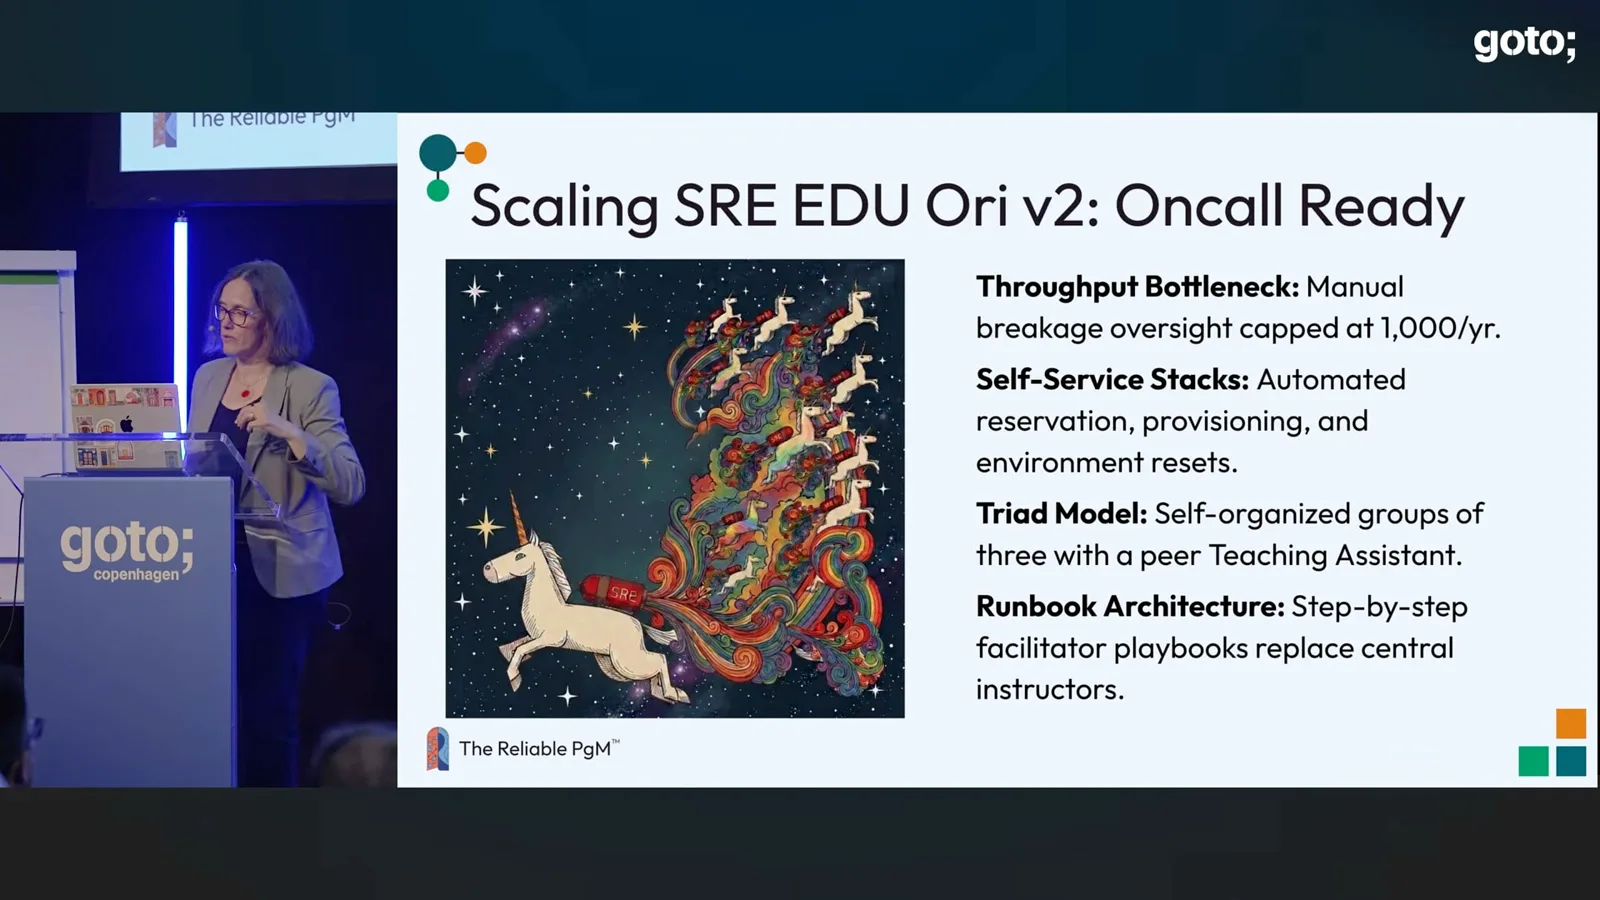
为了扩大规模,团队开发了 On-Call Ready。学员组可以自行预订一套环境,环境创建、故障注入、清理和重置都实现自动化。三人一组时,一名持有讲师手册的同伴负责引导练习。
自动化与同伴支持结合,在实践中使吞吐量提高了 5 到 10 倍。讲师带领的练习可能质量更高,但这种设计展示了需求上升、资源有限时需要作出的取舍。
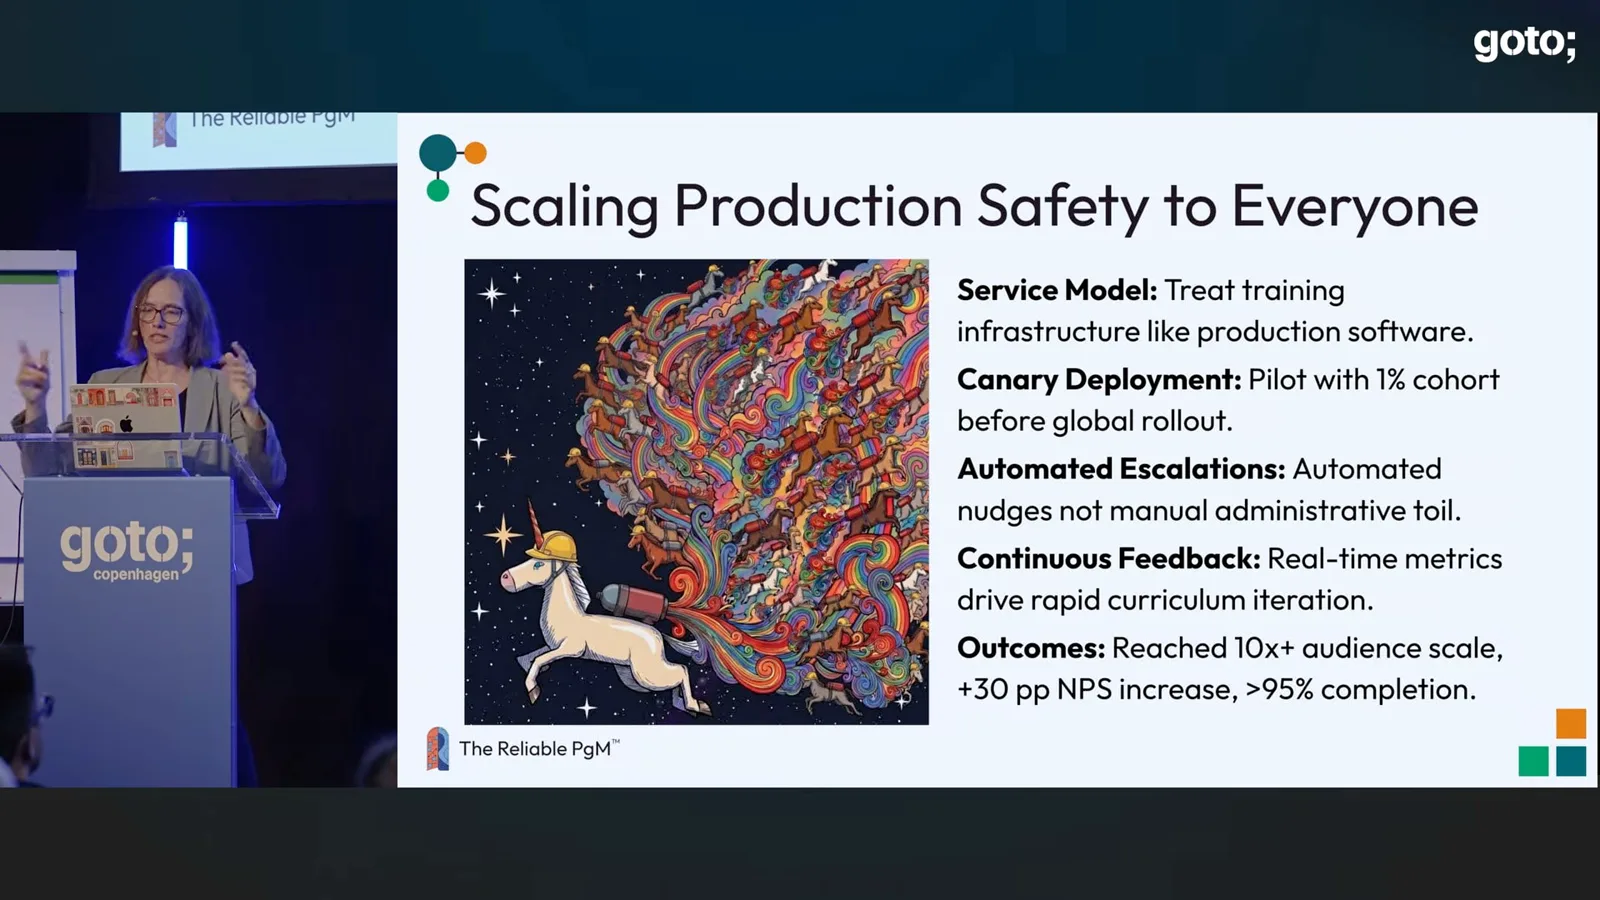
团队最初只负责 SRE 人员。当团队受命为数万名开发者提供强制性生产安全培训时,如果不以不合理的幅度增加人手,就无法开设足够多的线下课程。
团队开发了自主学习课程,并把它当作生产服务来运营:分发、报名和逐级通知都实现自动化。先向 1% 的人群推广,找出容易产生困惑的情况和使用障碍,再迭代课程内容。
这门课程在工程组织内的完成率超过 95%。根据反馈改进后,其净推荐值提高了 30 个百分点,满意度与成本更高的课堂培训相当。
建好培训项目后还要运营它
Petoff 回到学习、信心和组织文化之间的联系。投入水平应与组织需求相匹配。
不要只在第一天建好培训项目,还要计划如何运营和扩大规模。学习建立信心,信心驱动行为,而反复出现的行为塑造文化。合适的投入取决于组织情况,SRE 原则也可以帮助培训项目本身保持可靠。
全面重写的《Site Reliability Engineering》第二版涵盖了 On-Call Ready 和生产安全培训。我还写过第一版制作过程的回顾文章,以及一篇轻松的文章,讲如何把一本多余的书变成折纸花园。
同频道的其他文章
 38:10EN → 简体中文
 GOTO Conferences· 2026年11月16日Andrea Magnorsky:让架构决策透明且责任明确Andrea Magnorsky明确谁来决策,征求受影响者的建议,并通过小型协作练习找出缺失的知识。
 45:33EN → 简体中文GOTO Conferences· 2026年11月12日一座让孩子可以爬进去的“计算机”游乐场Linda LiukasLinda Liukas 将抽象计算概念转化为故事、身体游戏和公共空间,并追问工程师能从玩耍中学到什么。
 41:55EN → 简体中文GOTO Conferences· 2026年11月11日Evan Ratliff 创办了一家 AI 运营的初创公司,智能体编造了进展Evan Ratliff一次让 AI 充当同事的实验,暴露出失控的对话、虚假记忆,以及与真人交接工作的困难。
 38:07EN → 简体中文GOTO Conferences· 2026年11月10日让团队参与设计,组织重组才能更顺畅Joakim Sundén · Better Product WorkJoakim Sundén 将领导层的战略与员工对日常工作的了解结合,再让员工自主选择团队。
 49:56EN → 简体中文GOTO Conferences· 2026年11月9日Barbara Oakley:让 AI 支持学习,而不是替代学习Barbara Oakley · Oakland University她将记忆、练习和好奇心,与判断 AI 生成答案的能力联系起来。
 29:42EN → 简体中文GOTO Conferences· 2026年11月6日Artie Shevchenko 与 Titus Winters:AI 时代的代码健康Titus Winters, Artie Shevchenko · Adobe两位作者讨论复杂性、人工审查、测试,以及为什么接口和状态在 AI 辅助开发中值得关注。