30 秒看懂
Nathan Lambert 介绍 TMax:一个发布终端智能体数据和基于 Qwen 的开放模型的项目。他解释了当强模型的提升难以衡量时,均衡的环境、稳定的强化学习和可复现检查点为何重要。
- 1开放终端智能体TMax 结合模型权重、环境和训练方案。
- 2多样化环境数据流水线旨在均衡覆盖终端技能。
- 3稳定的强化学习数值精度与算法选择有助于解决不稳定问题。
- 4共享检查点中间产物让其他人可以研究训练动态。
要点建议
- TMax 发布约 1.5 万个终端任务强化学习环境和参数规模从 2B 到 27B 的模型。
- 这些模型建立在已经过后训练的 Qwen Instruct 模型之上。
- 训练稳定性需要关注数值精度和强化学习配置。
- 中间检查点和开放数据支持可复现的比较。
按章节阅读整理后的全文
TMax 与训练方案的必要性
Lambert 介绍终端智能体模型,并解释为什么在强基线上取得可复现的提升很难。
TMax 是我在 AI2 任职期间最后参与的论文之一:它开放了参数规模从 2B 到 27B 的模型,以及用于终端智能体的数据和强化学习训练方案。Terminal-Bench 衡量智能体使用计算机终端解决任务的能力。
我认为这项数据工作价值很高。发布的模型以 Qwen Instruct 为基础,在已有后训练之上继续改进。终端智能体任务比上一年广受关注的数学强化学习问题更难,在强模型上取得的增益可能很小。
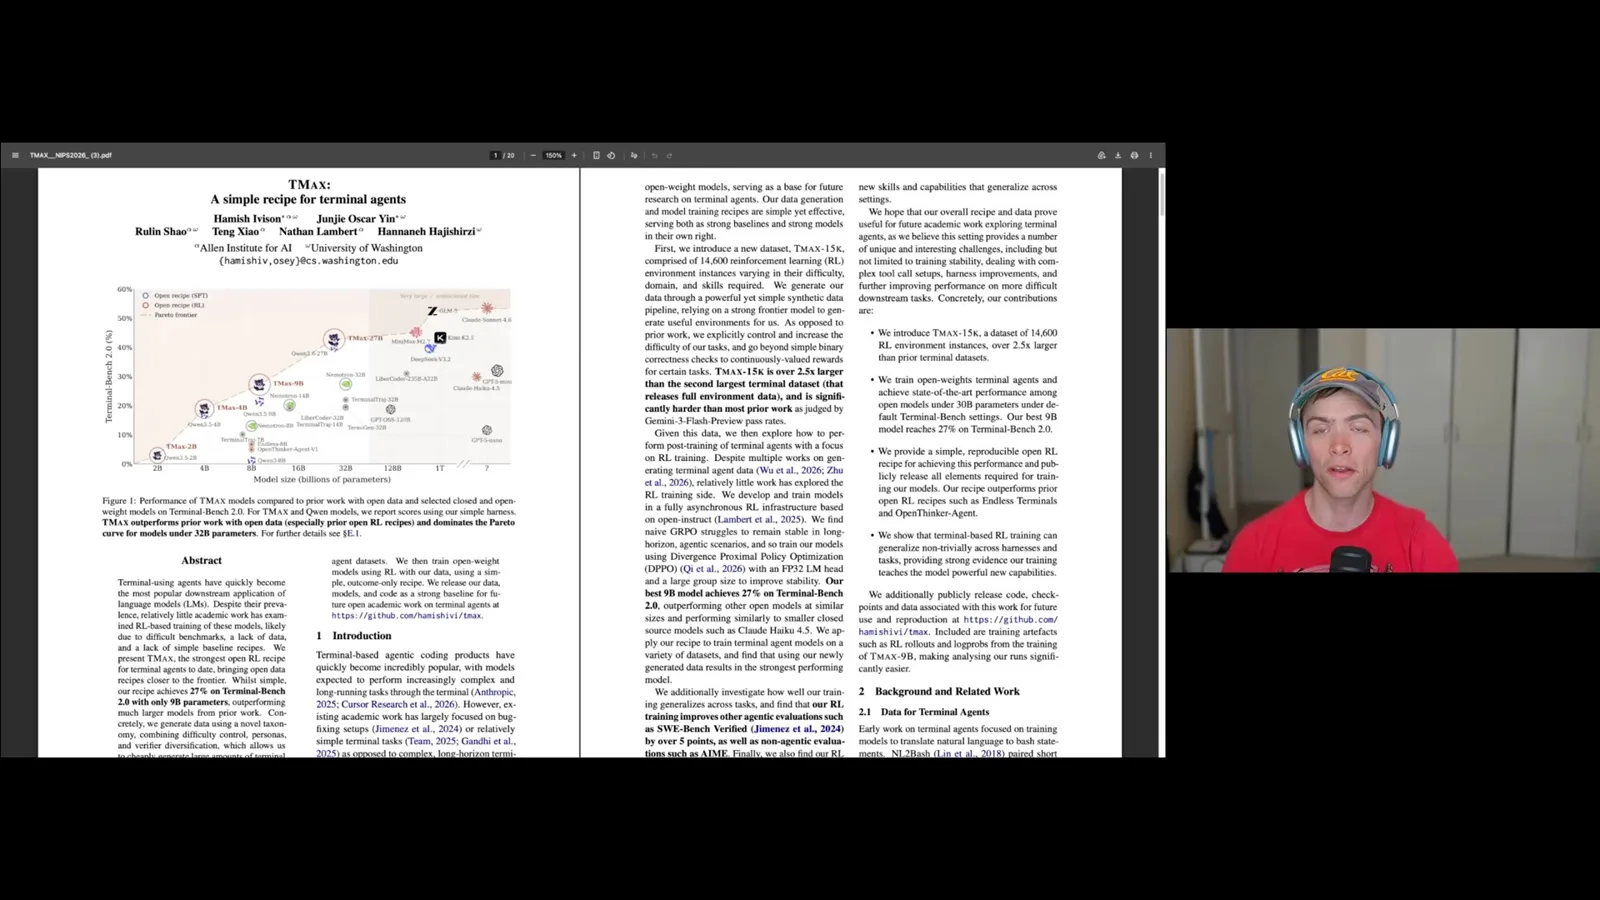
这也是我认为社区需要完整训练方案研究,而不只是孤立算法演示的原因。随着模型进步,细致、可复现的基础设施和逐步改进,对于弄清哪些变化真正有用变得至关重要。
数据与训练稳定性
项目发布多样化环境,并研究实现稳定强化学习所需的基础设施和算法选择。
项目发布约 1.5 万个强化学习环境,以及用于终端技能的监督微调数据。团队设计了多样化的数据流水线,力求均衡覆盖评估中的任务类型。Hamish 和 Oscar 主导了这项工作;我的贡献较小。
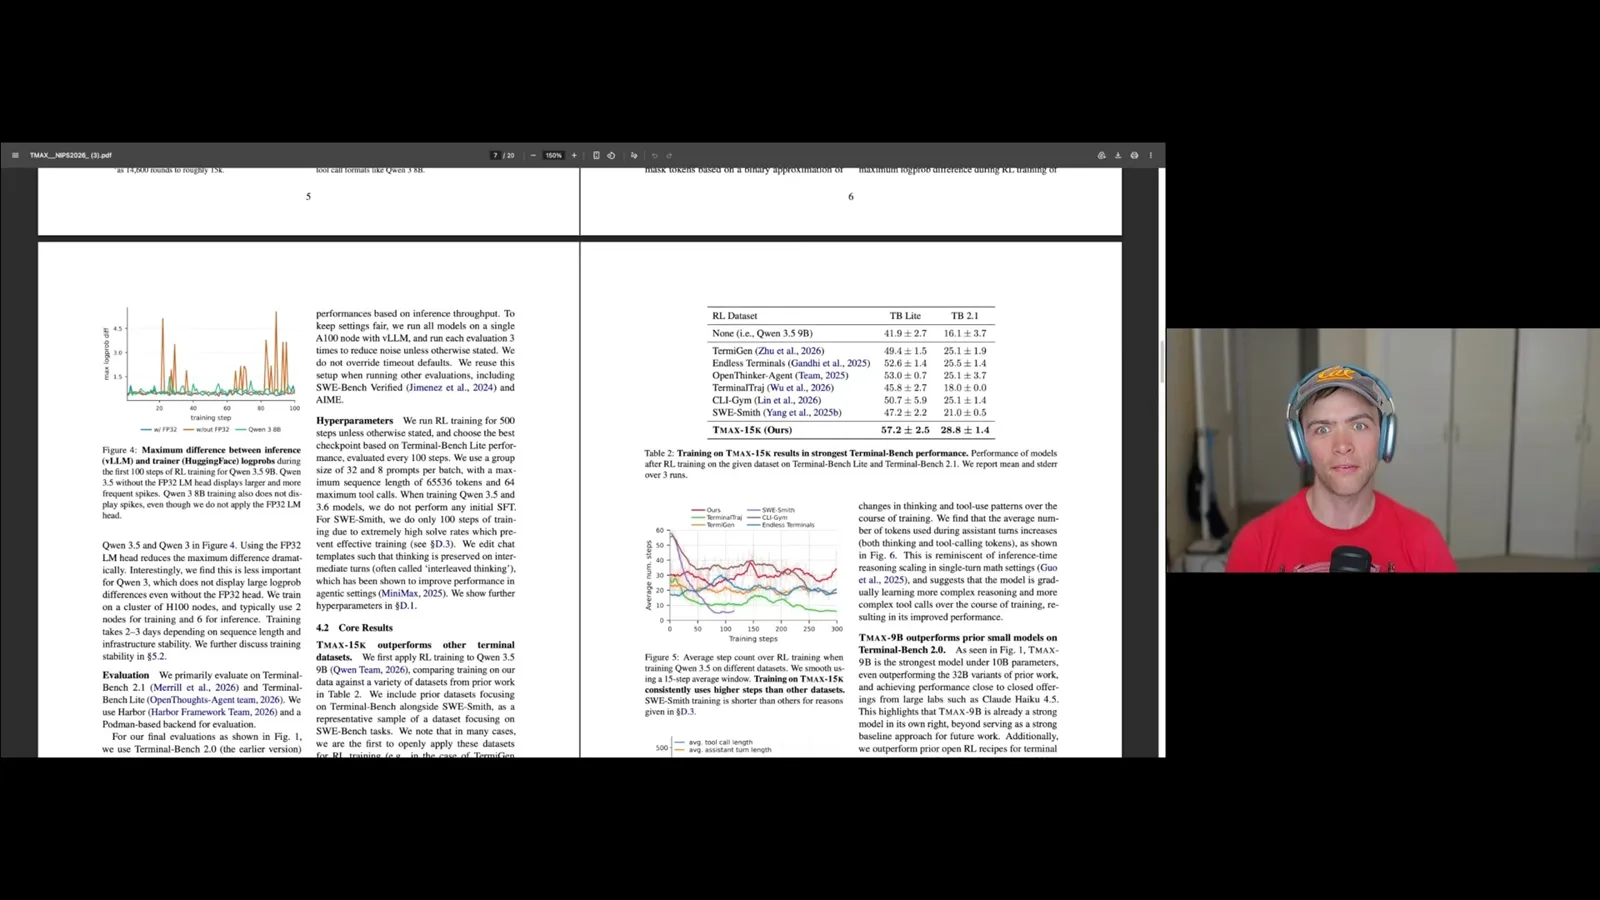
让这套方案发挥作用需要大量基础设施工作。Lambert 指出异步强化学习中的不稳定现象:训练端与生成端的对数概率差异可能出现尖峰。对于 Qwen 3.5,在语言模型头使用更高数值精度有助于稳定训练。
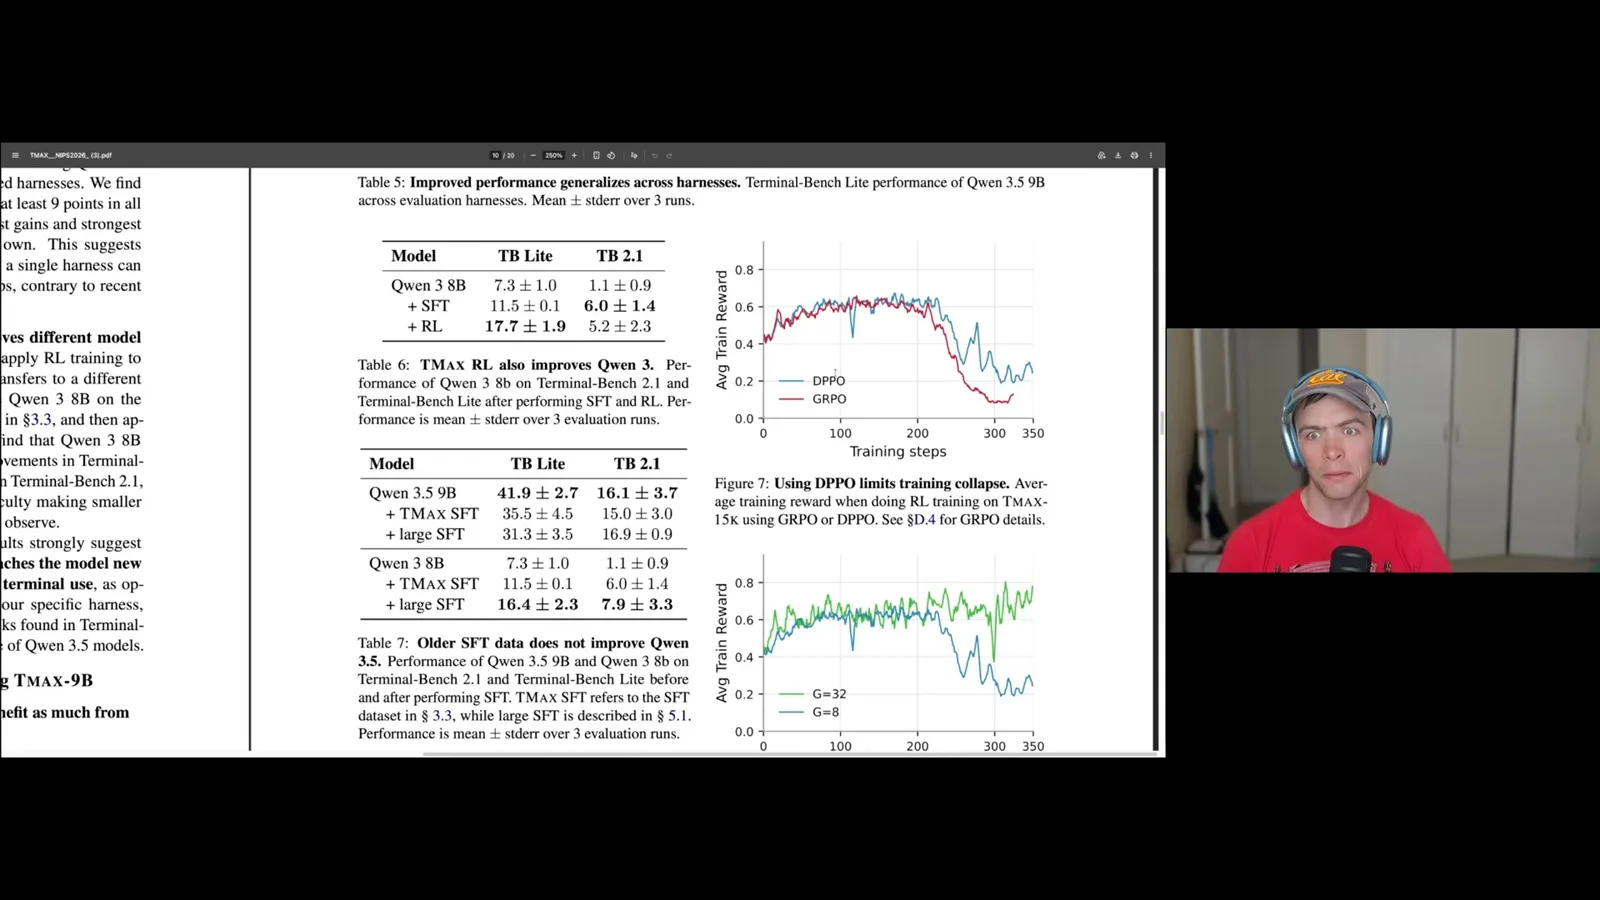
团队还从强化学习算法和采样角度研究训练稳定性。DPPO 改变了 PPO 类方法中的裁剪方式,而更大的 GRPO 组会为每个提示使用更多回答,以改善梯度信号。两者都是论文所述方案的一部分。
开放产物与未来研究
检查点和共享数据让研究者能够比较训练过程,研究微小的基准提升。
项目发布模型、数据、代码和中间检查点,让其他人能够在共享任务上研究训练动态。Lambert 将其与 OLMo 3 RL Zero 发布的清晰起点和检查点联系起来。
强大的开放模型之间,基准差距往往只有几个百分点,因此很难确定哪些进展真正有意义。Lambert 希望共享方案帮助研究者检验智能体强化学习中的持久改进,并开展更多以数据为中心的工作。他感谢主导项目的 Hamish 和 Oscar。
同频道的其他文章
 16:48EN → 简体中文
 Nathan Lambert· 2026年11月2日Nathan Lambert:开放模型如何与前沿实验室竞争Nathan Lambert · Allen Institute for AI开放模型的用量正在增长,能力差距也在缩小,但开发者需要可持续的经济模式和价格之外的优势。
 48:04EN → 简体中文Nathan Lambert· 2026年10月26日Nathan Lambert:开放语言模型的历史、竞争与风险Nathan Lambert · Allen Institute for AI从开放权重、研究基础设施和蒸馏,到采用情况与模型开发者面临的选择。
 46:42EN → 简体中文Nathan Lambert· 2026年10月25日Nathan Lambert 与 Florian Brand 谈 Kimi K3.1、网络风险和 AI 智能体Nathan Lambert, Florian Brand · Allen Institute for AIInterconnects 主持人讨论模型评估的分歧、安全漏洞披露潮,以及个人智能体在日常生活中的作用。
 5:42EN → 简体中文Nathan Lambert· 2026年8月12日修格斯为何成了 AI 后训练的吉祥物Nathan Lambert · Allen Institute for AINathan Lambert 追溯了这种怪物从洛夫克拉夫特小说走向语言模型、微调与 RLHF 视觉隐喻的历程。
 32:56EN → 简体中文Nathan Lambert· 2026年8月6日Nathan Lambert:AI 角色训练入门Nathan Lambert · Allen Institute for AI从 constitution、model spec 到人格实验和激活引导,理解后训练如何塑造模型行为。
 32:11EN → 简体中文Nathan Lambert· 2026年8月5日Nathan Lambert:语言模型评估如何演变Nathan Lambert · Allen Institute for AI从少样本提示与 pass@k,到智能体沙箱、分数噪声和基准污染。