30 秒看懂
Nathan Lambert 考察了开放模型的公开使用数据、研究用途、能力和成本。他认为,分散的生态系统必须找到资助模型开发的方法,同时与垂直整合的前沿实验室竞争。他提出的优势包括更低的推理成本,以及机构能够拥有、适配和私有部署的模型。
- 1用量增长,但数据不完整推理服务商公开的数据表明用量大幅增长。云平台上的部署意味着这些数字只反映了开放模型使用量的一部分。
- 2以月计算的能力差距Lambert 解读能力指数后认为,开放权重模型通常在闭源模型几个月后达到前沿能力门槛。
- 3开放不一定意味着更便宜闭源服务商凭借规模、训练与服务技术栈,在成本与性能的不同组合上也有竞争力。
- 4分散的经济体系模型开发者、推理服务商和适配公司获得价值的环节不同,这让新模型的融资更加复杂。
- 5凭借所有权与适配能力竞争Lambert 呼吁降低推理价格,并提供企业能够拥有、定制和私有运行的模型。
要点建议
- 公开的推理数据表明用量大幅增长,但只涵盖开放模型使用量的一部分。
- 根据 Lambert 讨论的指数,开放权重模型通常在领先闭源模型几个月后达到同一能力门槛。
- 在同等性能水平上,开放模型并不一定更便宜。
- 收入分散在模型开发者、推理服务商和适配公司之间,使前沿训练的再投资更加困难。
- Lambert 认为,低成本推理以及客户可拥有的私有、可适配权重,能让开放模型形成差异化。
按章节阅读整理后的全文
衡量开放模型的使用量
Lambert 比较了公开推理数据和闭源服务商披露的数字,也考察了研究论文中的提及情况,并提醒听众使用数据并不完整。
随着推理市场起飞,我一直在思考:开放模型需要什么经济条件和能力,才能与 OpenAI、Anthropic 区分开来?问题在于,它们如何凭借闭源模型可能无法提供的优势取胜。
先看用量。Together AI、Baseten、Fireworks 和 OpenRouter 都提供开放模型推理服务。对于 OpenRouter,我看的是归属于开放模型的 token 占比;该平台也提供闭源模型。其他公司只偶尔披露数据,通常是在融资前后,而 OpenRouter 会公开数据。
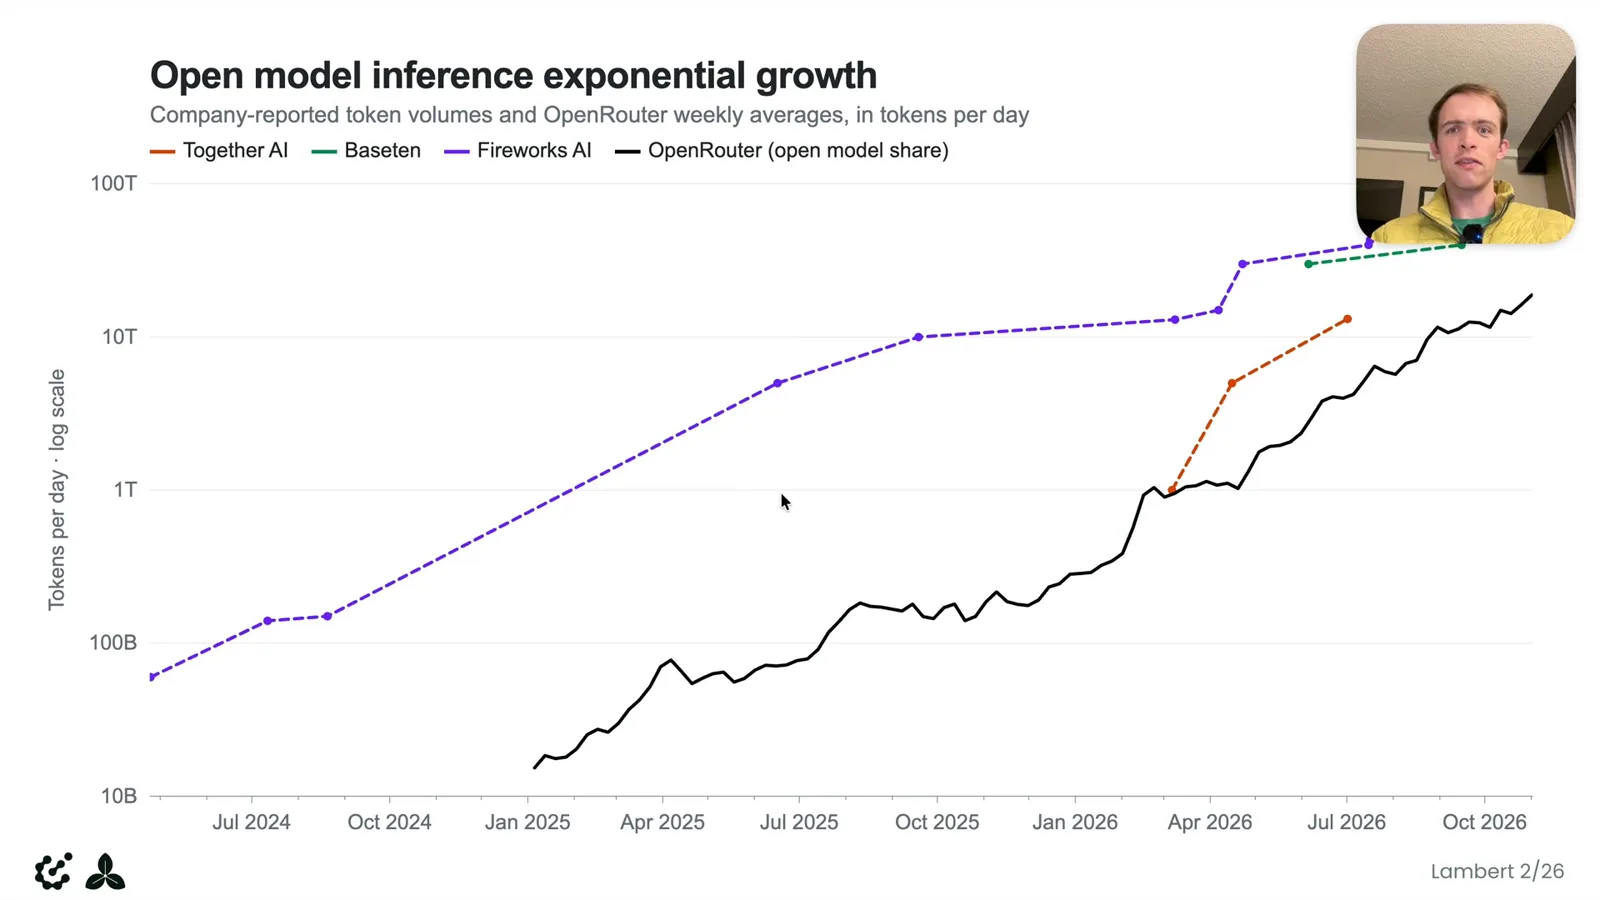
这些数字显示,过去几年用量增长迅速,但由于我们对总用量所知甚少,很难判断它们的整体意义。我猜它们只涵盖了开放模型推理的一小部分:许多模型还通过 Amazon Bedrock、Microsoft Azure 和其他云平台提供服务。不过,这些推理公司仍是有用的信号,因为它们的业务高度集中在这一市场。
Google 会披露其各类产品的推理用量,也会提供 Gemini API 的数据。在我的比较中,Fireworks 和 Baseten 的服务规模似乎与 Gemini API 相当。这表明业务正在形成有意义的规模,但要准确计算市场份额,还需要更多信息。至少,这些数据让我们能够观察:开放模型是否也在随着闭源模型的巨大需求一起增长。
开放模型还是研究的重要基础。我检索了近几年热门机器学习领域的 arXiv 论文,发现提及 Qwen 的论文数量几乎与提及 OpenAI 模型的论文一样多;在这项分析中,Qwen 是研究中最受欢迎的开放模型系列。采用这些模型花了一些时间,但如今,易于获取的模型系列支撑了大量研究和创新。
能力与成本
他讨论的指数显示,开放权重模型落后前沿数月。成本比较也比“开放模型总是更便宜”这一说法复杂。
从能力指标看,开放权重模型落后前沿几个月——这个趋势持续的时间比我预期的更长。Artificial Analysis 的进展指数和 Epoch Capabilities Index 都显示,开放模型最终会跨过某个能力门槛,具体可能晚四个月、六个月或八个月,取决于衡量方式。这仍然是很快的技术扩散;相比不确定能力是否会出现,知道它何时可能出现更有利于规划。
单个模型何时发布仍有不确定性。录制时,我预计 Kimi K3.1 会在几天内发布,但发布日期可能变化。从更广的角度看,稳定的时间差比任何一个模型的发布日期更重要。
成本问题比“开放模型更便宜”的常见说法复杂。闭源实验室拥有先进的训练技术栈、高效的推理和计算规模优势,在成本与性能的各种组合上都有产品。即使在今天开放模型所处的较低性能水平,闭源模型也能与之竞争。这改变了机构大规模采用开放权重模型的理由。
分散生态的经济问题
模型开发者、推理服务商和适配公司分处不同环节。它们的激励和收入流向与垂直整合的实验室不同。
开放模型经济的核心是模型开发者:Moonshot AI、Zhipu AI、DeepSeek、Alibaba、Reflection、Arcee 和 Llama 团队等。问题是谁来资助它们的下一代模型。持续扩大规模需要收入,但目前很多收入流向服务、推理和后训练环节,包括 Fireworks、Baseten 和 Together。
模型开发者与从推理中获益的公司之间存在分离,目前没有显而易见的解决办法。相比之下,OpenAI 和 Anthropic 可以整合产品、模型、计算等环节,降低服务成本并提高利润率。按照当前的结构,开放生态很难直接假定自己能在固定智能水平下做到最低成本。
第三个环节正在出现:一些企业希望自行后训练模型并控制计算资源。Prime Intellect 提供训练基础设施,Applied Compute 和 Mercor 等数据公司则从事适配、评估或训练。模型开发者、服务商和专业公司虽然相互合作,但这样的体系不一定能让收入持续回流,支持下一代模型。
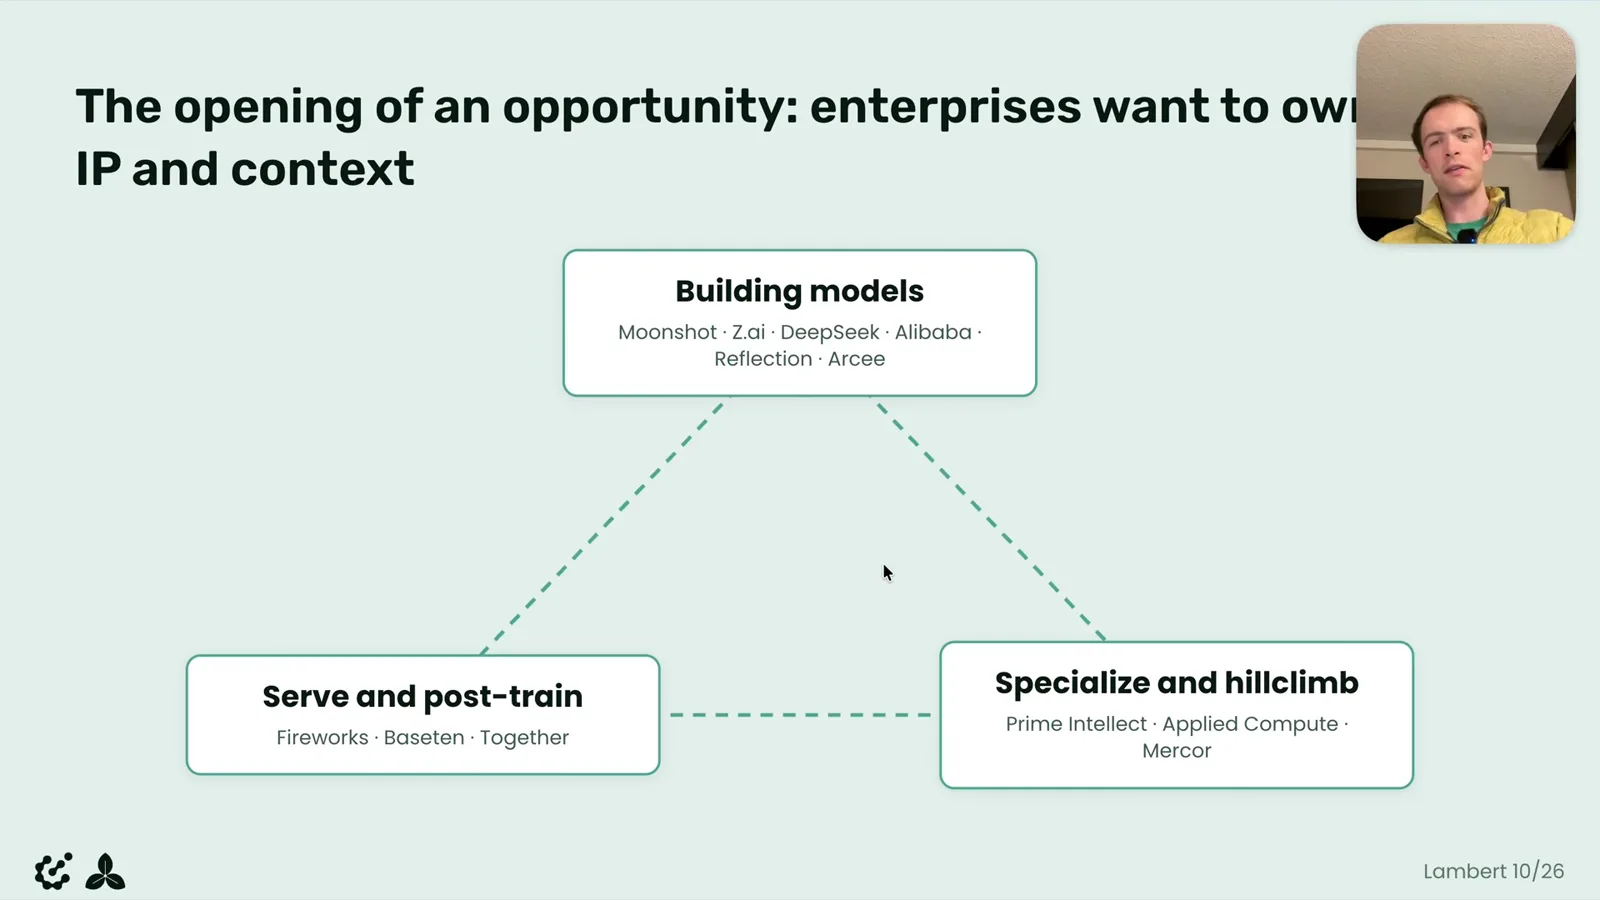
这些公司的商业模式也在趋同。推理需要计算资源,但服务商可以在提供服务时获得收入。训练模型则需要先投入巨额成本,之后才可能获得回报;模型开发者依赖资金从下游服务商流回,包括通过收入分成等方式。这推动开发者向下游扩张,与自己生态中的其他公司竞争。
推理服务、面向高价值领域的模型适配和私有部署都有赚钱机会。然而,开放模型联盟内部的竞争也让大型实验室的融资路径更加模糊。核心的经济问题是:怎样连接这些分散的参与者,让整个系统能够持续创新?
迫切性来自前沿训练成本。黄仁勋曾谈到一个使用数十万枚 Blackwell 芯片训练的 GPT-6 Astra 模型;我估计,前沿模型从构想到执行可能花费数十亿美元,未来甚至可能达到数百亿美元。如果开放实验室无法筹集接近这一规模的资金,能力差距可能扩大。
竞争之路
Lambert 提出以更低的推理成本和私有、可适配的模型形成互补优势。企业专业化应用可能创造价值,支持整个生态。
我认为,目标不只是打造同等智能水平下最便宜的模型,而是打造最便宜、可适配且私有的智能:把权重交给用户,让他们拥有并修改模型。这种所有权提供了一条不同的路径;保留自身权重控制权的闭源服务商无法以同样方式提供它。
自 GLM 5.2 以来,这些经济问题变得更加具体。企业开始讨论微调自己的模型,智能体也开始在实践中发挥作用。模型的能力仍然参差不齐:开放模型可能更适合某种特定需求,比如速度或处理内部代码库。生态需要尽快利用这些差异。
成功的一个条件是让推理价格接近边际成本。虽然有很多服务商参与竞争,但计算需求高、供应有限,使这种竞争压力还没有充分显现。在价格下降之前,开放模型的相对成本和性能可能仍会让闭源方案更具吸引力。开放服务商可能需要从业务规模、专业化或企业协议中寻找回报。
另一个条件是可适配、私有且可控的智能。企业承载着内部专业知识、知识产权和领域经验。一些机构可能不愿将这些信息交给闭源服务商,尤其是在 AI 能力越来越强的时候。我认为,把模型权重交给机构,可以让它们在自己控制的模型中表达和保留这些专业能力;但每个参与者如何从中获利,仍是未解的问题。
Harvey、Mercor、Applied Compute 等公司的早期工作表明,这种机会是真实存在的。我提到 Harvey 把 Kimi K3 适配到一个狭窄的法律任务:据其报告,它以远低于前沿模型的成本取得了更高的准确率。许多专业领域的知识尚未充分公开或数字化,因此专业模型还有很大的发展空间。
如果专业化带来的收入能够回流到模型开发,较低的模型成本就能帮助更多机构拥有和使用智能。开放模型也许能借此扩散到那些不愿放弃信息控制权的领域。我希望推动能够实现这一未来的研究,因为我认为它可能更安全、让更多人受益,同时也承认仍有重大的经济问题需要解决。
同频道的其他文章
 48:04EN → 简体中文
 Nathan Lambert· 2026年10月26日Nathan Lambert:开放语言模型的历史、竞争与风险Nathan Lambert · Allen Institute for AI从开放权重、研究基础设施和蒸馏,到采用情况与模型开发者面临的选择。
 46:42EN → 简体中文Nathan Lambert· 2026年10月25日Nathan Lambert 与 Florian Brand 谈 Kimi K3.1、网络风险和 AI 智能体Nathan Lambert, Florian Brand · Allen Institute for AIInterconnects 主持人讨论模型评估的分歧、安全漏洞披露潮,以及个人智能体在日常生活中的作用。
 5:42EN → 简体中文Nathan Lambert· 2026年8月12日修格斯为何成了 AI 后训练的吉祥物Nathan Lambert · Allen Institute for AINathan Lambert 追溯了这种怪物从洛夫克拉夫特小说走向语言模型、微调与 RLHF 视觉隐喻的历程。
 32:56EN → 简体中文Nathan Lambert· 2026年8月6日Nathan Lambert:AI 角色训练入门Nathan Lambert · Allen Institute for AI从 constitution、model spec 到人格实验和激活引导,理解后训练如何塑造模型行为。
 32:11EN → 简体中文Nathan Lambert· 2026年8月5日Nathan Lambert:语言模型评估如何演变Nathan Lambert · Allen Institute for AI从少样本提示与 pass@k,到智能体沙箱、分数噪声和基准污染。
 13:53EN → 简体中文Nathan Lambert· 2026年8月4日Nathan Lambert 回答后训练配方的六个问题Nathan Lambert · Allen Institute for AI围绕专家模型、KL 惩罚、监督数据、强化学习和业务取舍的实践讨论。